語言模型能理解自然語言,卻不代表回覆能直接交給程式。自由文字可能混入解釋或格式變化,分類、路由和觸發動作前仍要解析與驗證。llm-typesafe 0.1a0 將 TypeSafe AI 的 Jev 模型接進 LLM CLI,以問題型態取得結構化結果。
它目前是早期外掛與整合入口,不是替所有模型加上型別系統的萬用函式庫。公開資料能說明介面,尚不足以證明準確率、穩定性、延遲、成本或長期維護效益。台灣團隊要看的,是輸出能否接上現有流程,以及是否能驗證語意判斷。
一、llm-typesafe 解決的是哪一種 LLM 整合問題
它主要處理語言模型回覆難以穩定交給程式使用的整合問題,透過 Jev 的固定問題型態與結構化答案,減少從長篇文字猜測欄位的工作,但不會保證判斷內容正確。
從自由文字回覆轉向可驗證的輸出介面
一般聊天模型即使被要求回傳 JSON,開發者仍要自行定義 JSON Schema、驗證欄位並處理失敗分流與人工退路。本文不比較兩種做法的實測錯誤率,公開資料也沒有這類對照數據。
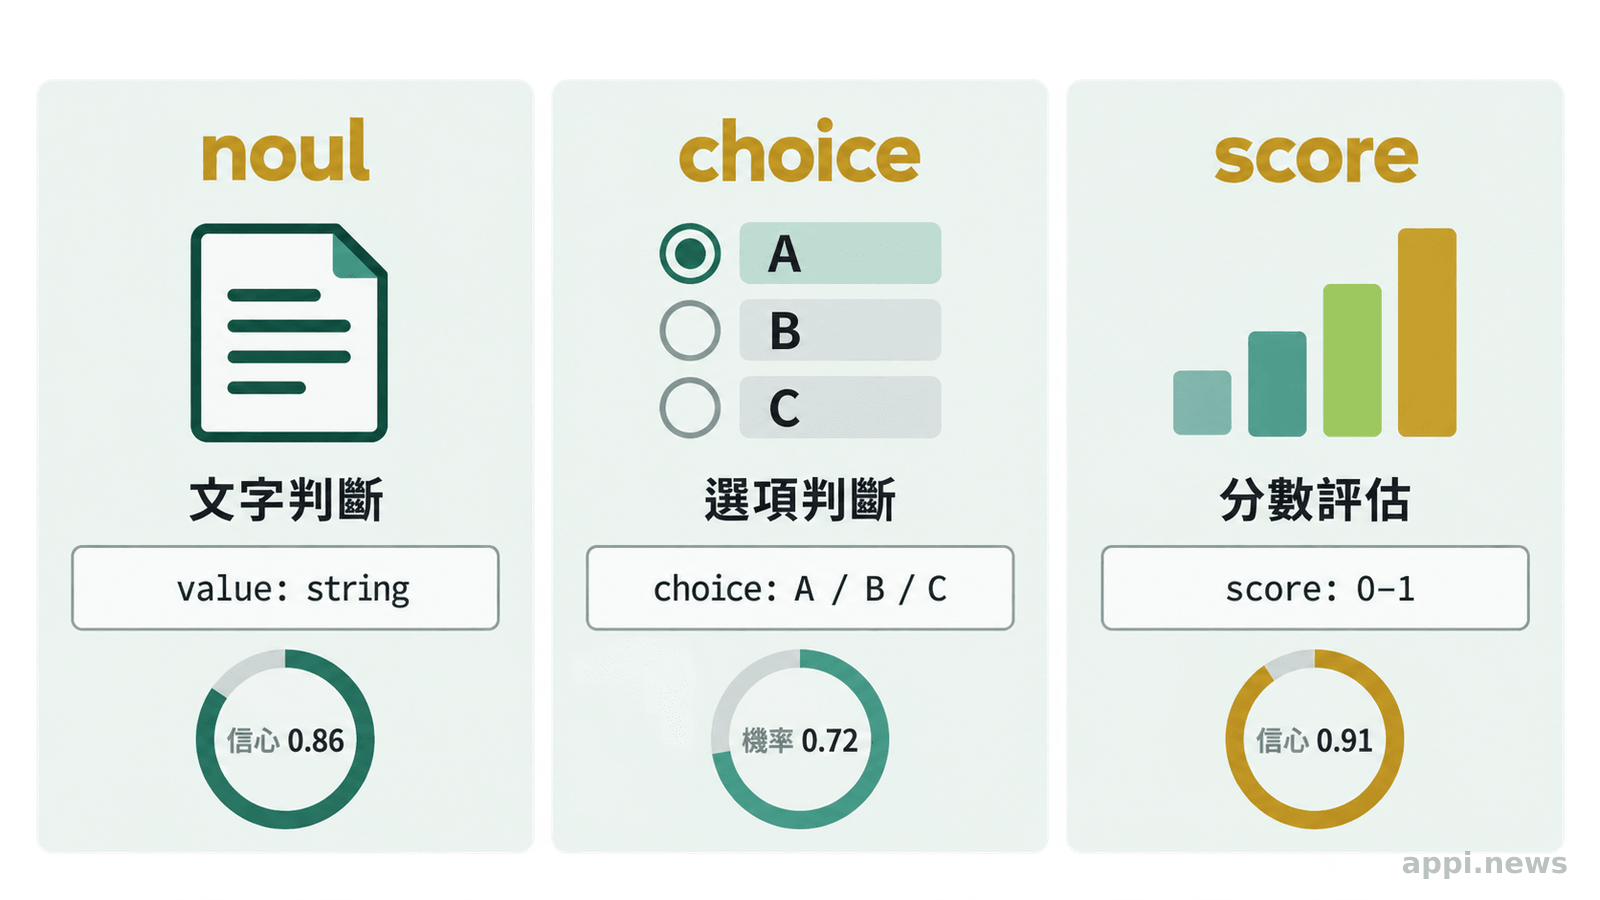
llm-typesafe 的公開示例把輸入稱為 state,並將問題分成 noul 是非判斷、choice 選項分類和 score 有序評分。後續程式可依固定欄位與機率資料分支,少做一層文字切割。
它與一般 JSON structured output 的差異
一般 JSON structured output 是在文字生成模型外加格式約束,開發者指定欄位、型別與可能值。llm-typesafe 則把判斷拆成問題原語,回傳預先定義的答案型態。兩者解決的層次不同,下表是用途對照,不是推薦排序。
| 做法 | 程式接收到的結果 | 開發者仍要負責的事 | 示例情境 |
|---|---|---|---|
| 自由文字回覆 | 可能變動的文字 | 解析、欄位驗證與失敗分流 | 對話、草稿、內容生成 |
| JSON 結構化輸出 | 符合 schema 的物件 | schema 驗證、語意檢查與錯判處理 | 資料抽取、API 交換 |
| llm-typesafe 搭配 Jev | noul、choice、score | 問題定義、門檻與人工覆核 | 分類、路由、評分 |
二、llm-typesafe 的產品設計:把問題轉成可管理的型別
它把「請模型自行組織答案」改成「請模型回答一種已定義的問題」,再讓程式以固定欄位讀取結果。問題定義、答案解讀與後續動作可以分開測試。
是非判斷與信心值
Simon Willison 的公開 CLI 範例中,noul 可詢問客服訊息是否要求退款,回傳 type 與 noul 數值供程式使用;官方文件則把 noul 定義為判斷敘述是否成立、回傳 0 至 1 的數值。0.99 不等於現實正確率 99%,能否作為門檻要用標註資料檢查。
選項分類與評分輸出
choice 適合 billing、technical 或 other 等固定選項;描述必須互相區分,並保留無適用選項的退路。score 適合有順序的評分,分數可能落在兩個等級之間,應保留各級機率、信心值與原始輸入。
「Jev evaluates typed questions against a state and returns structured results directly.」— TypeSafe AI 官方文件
輸出格式如何銜接測試與後續程式邏輯
型別化答案能放進一般程式控制流。客服路由可讀取 choice,再依信心門檻自動分派或送人工;多個單一面向的 score 也可由程式加權,不把加權與分流規則交給模型自行決定。
測試應驗證欄位、邊界值、未知值和人工答案,並比較版本變更後的結果。
三、錯誤處理與維護成本要怎麼評估
型別驗證只能確認答案長相符合介面,不能確認模型理解正確;語意錯判、低信心、服務失敗、版本變更和資料外洩要分開處理。
型別驗證不能消除模型判斷錯誤
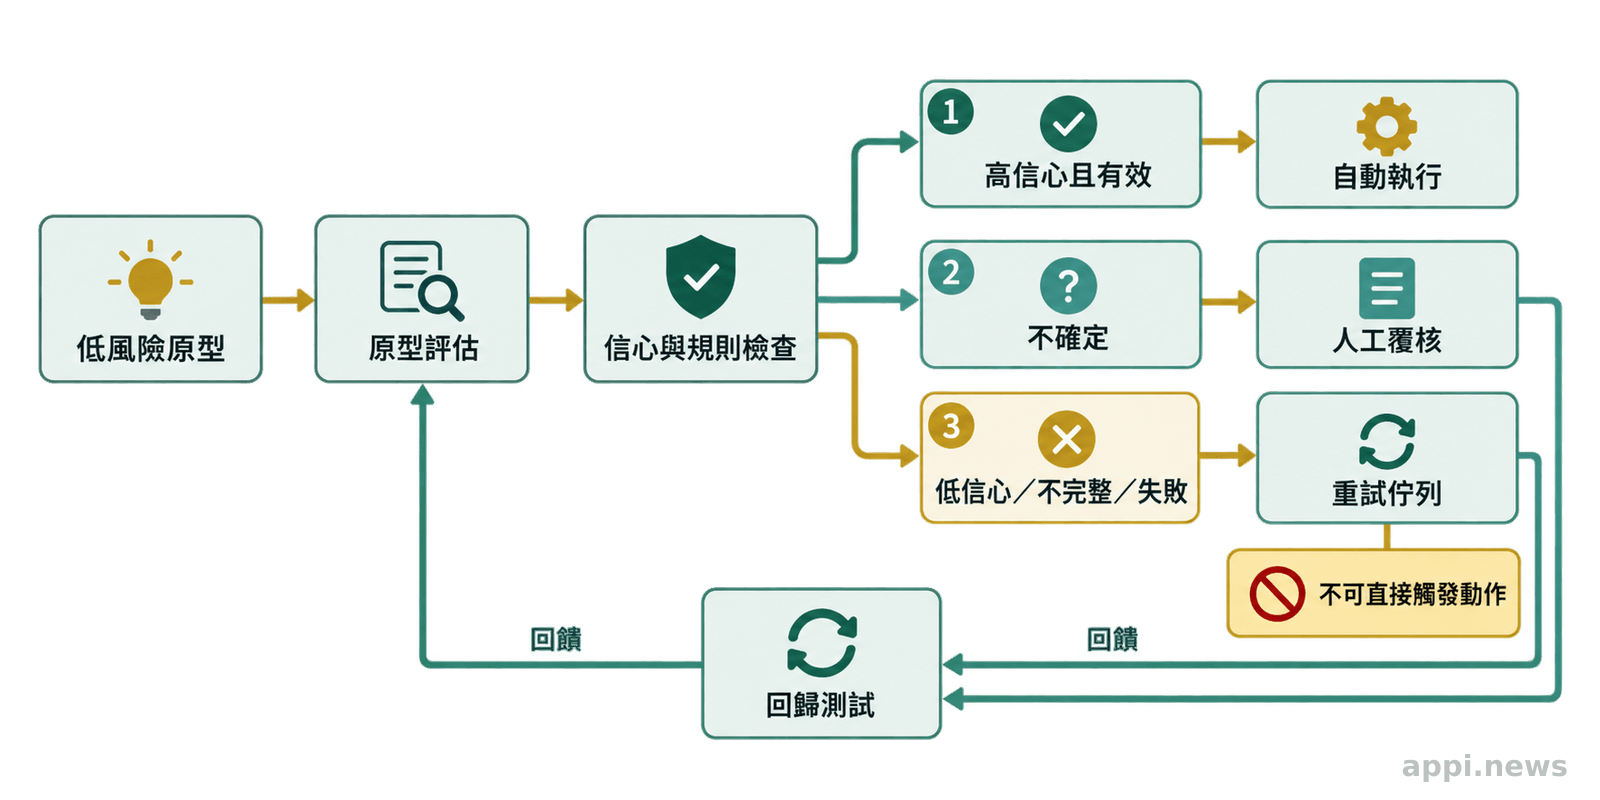
模型回傳 billing、technical 或 other,只代表介面通過,不代表業務判斷通過。可設計三段式處理:高信心且通過規則檢查才自動執行;中間區間送人工;低信心、欄位不完整或 API 失敗進入重試或人工佇列。重試應增加資訊或改變路徑,不能只重送同一請求。
版本、模型、提示詞與資料格式的相容性
0.1a0 的 alpha 標記代表介面可能調整。團隊要記錄外掛、模型、問題、選項、輸入欄位和門檻;只鎖定套件版本,無法控制遠端服務變化。接入前也要確認金鑰、逾時、重試與日誌權限。
如何建立失敗案例、重試與人工覆核流程
失敗案例應保存輸入摘要、問題與版本、輸出分布、程式動作和人工判定,敏感資料先遮罩。測試集要包含邊界、混合意圖、空輸入與無適用選項。
「A score of 1.0 can mean all probability is on level 1, or half is on each of levels 0 and 2.」— TypeSafe AI 官方 Score 文件的機率分布示例(非實測結果)
四、台灣開發團隊的導入情境
先選一條輸入、判斷、後續動作都能回溯的小流程,建立人工標準答案和成本基準,再比較型別化輸出是否減少整合工作;不要一開始放進付款、醫療、法律或其他高影響流程。
適合先做的低風險原型
適合的原型有三個條件:資料已存在、選項能清楚描述、錯判後有人工補救。例如客服信件分流、工單標籤或文件評分。成功標準要包括合法輸出率、人工覆核比例、錯誤類型、延遲、成本與維護時間,不能只看能否跑出 JSON。
與既有 API、CLI、代理框架整合時的檢查項目
整合前要檢查:資料是否可送外部服務;問題與選項是否能表達規則;信心是否保存;逾時、金鑰失效和版本不相容是否有明確狀態;低信心時代理流程是否停下來交給人員。
- 選定一個低風險分類或評分流程,整理至少一批已由人工判定的案例。
- 用
noul、choice或score定義單一面向問題,先避免把多個規則塞進同一題。 - 記錄輸入、版本、輸出分布和人工結果,分別計算合法輸出、錯判與人工覆核比例。
- 針對邊界案例設定自動、人工和重試三種路徑,再評估延遲、成本和維護工作量。
- 只有在回歸測試和資料治理都能持續運作時,才考慮接入更高影響的流程。
五、llm-typesafe 0.1a0 是否值得採用
它值得做小型、可回溯的分類或評分原型,但公開證據不足以支持普遍正式採用;是否納入正式 AI 應用,要看資料、模型可用性、失敗處理和持續測試結果。
可觀察的優點與尚待驗證的限制
可觀察的優點是介面清楚:開發者可選擇是非、選項或有序分數,再接到程式邏輯。尚待驗證的是獨立準確率、穩定性、延遲、成本和長期維護比較;繁體中文與混合意圖資料必須自行測試。
產品也有供應商依賴,答案型態或模型版本改動時,門檻與回歸基準可能要重做;團隊應保留規則或人工分流作為替代路徑。
導入前的測試與評估清單
評估可分四層:介面是否可靠解析;語意是否符合人工答案;低信心與重試是否造成錯誤動作;資料、日誌和版本是否符合治理要求。若把格式失敗換成合法錯誤分類,導入價值就要重算。
這項工具不涉及藥物、保健食品或人體健康用途。若未來把它延伸到金融、醫療、法律或其他高風險決策,應另行加入領域專業審查、人工覆核、權限控管和可追溯紀錄,不能只依賴型別化輸出或信心數值自動執行。
llm-typesafe 0.1a0是接入 Jev 的早期 LLM 外掛,重點在固定問題型態與結構化答案。noul、choice、score能協助分類、判斷和評分接上程式,但合法格式不代表語意正確。- 導入前應建立人工標準答案、失敗案例、版本紀錄、低信心分流和成本基準。
- 適合從可回溯的小型原型開始,暫不宜因介面清楚就推論適合所有生產環境。
常見問題
它不是替代 TypeScript 或 Python 型別檢查器的函式庫,而是透過 LLM 外掛把 Jev 判斷結果以較固定的答案型態交給程式。
常見問題
Q1: llm-typesafe 0.1a0 需要什麼?
公開示例顯示,需要安裝外掛、設定 API 金鑰,再以 Jev 執行問題;可用性仍受 early access 和版本變動影響。
Q2: choice 和 score 怎麼選?
互不排序的固定選項用 choice;有順序的程度用 score;敘述是否成立用 noul。多個面向應拆題,再由程式合併。
Q3: 信心值可以直接當成準確率嗎?
不可以。信心值反映輸出分布的集中程度,必須用自己的標註資料校準,不能單靠高信心值放行高影響動作。
Q4: 它能取代一般 JSON structured output 嗎?
不能直接這樣判斷。llm-typesafe 較適合固定分類、是非判斷和評分;複合資料抽取或長文生成仍可能適合一般 JSON schema。
參考來源
- Simon Willison (2026). Release llm-typesafe 0.1a0 — LLM plugin for accessing Jev and other TypeSafe AI models
- TypeSafe AI (2026). Introduction. TypeSafe AI Developer Documentation
- TypeSafe AI (2026). Choice. TypeSafe AI Developer Documentation
- TypeSafe AI (2026). Score. TypeSafe AI Developer Documentation
- TypeSafe AI (2026). Confidence. TypeSafe AI Developer Documentation