GPT-6 的 prompt caching(提示快取)升級,讓重複使用的共享前綴有機會降低輸入成本,也可能縮短部分請求的首 Token 延遲。快取輸入折扣不能直接推論整體 API 帳單下降。
台灣團隊要先確認,請求是否反覆帶入相同的系統指令、工具定義、知識庫前綴或對話脈絡。如果前段常被改寫,或輸出 Token 與未快取輸入占大宗,換用新模型未必值得重構。判斷應回到日誌、命中率、成本、延遲與品質。
一、GPT-6提示快取升級了什麼?
GPT-6 提供較高的預設快取命中率,並讓符合條件的共享前綴在 30 分鐘視窗內取得快取輸入折扣;同時加入儀表板、診斷工具與明確快取斷點,讓團隊可以觀察和調整快取行為。
OpenAI 公告說明,GPT-6 主要面向會連續發出多次請求的長任務代理。這類應用反覆攜帶系統指令、工具定義和工作脈絡,平台便有機會重用共享上下文。公告以「快取輸入 Token 最多可享 90% 折扣」描述潛在幅度,但這是快取輸入的價格優惠,不能當成所有請求的省幅。
30分鐘共享前綴代表什麼?
提示前綴是請求開頭一段可重複使用的內容。若模型、服務層級、工具與前綴內容相容,後續請求有機會沿用先前結果。30 分鐘是共享前綴可重用時間視窗,不表示資料永久留在快取,也不保證每次命中。
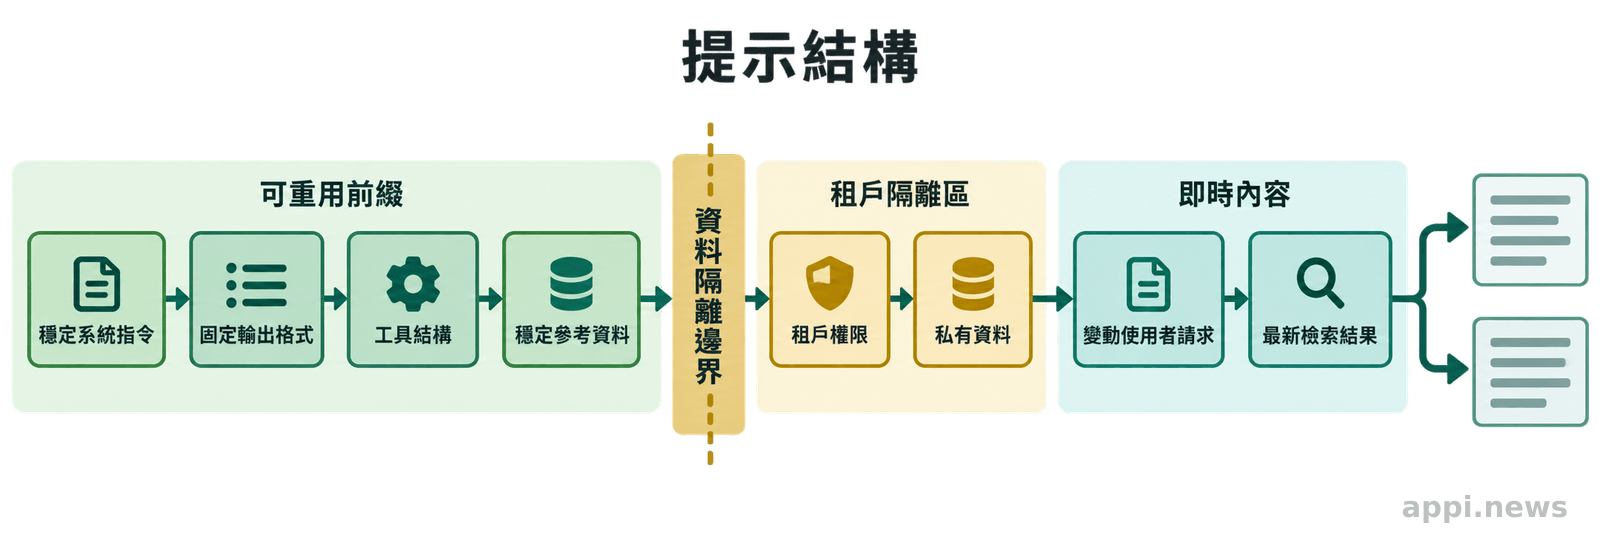
系統指令、固定格式、工具 Schema(工具輸入輸出的結構定義)與穩定參考資料宜放在前段,使用者問題、最新查詢結果與本輪任務等易變內容放在後段,降低前綴被改寫的機率。
儀表板與診斷工具解決哪個問題?
儀表板可追蹤命中率和快取、未快取 Token 組成;診斷工具則以較早回應為基準,比對模型、工具、設定與輸入,找出阻止前綴重用的原因。結果可指出 tools_changed 並估算受影響 Token,讓 cache miss 從成本異常變成可定位的整合問題。
「提示快取在大規模服務中扮演關鍵角色,能讓 AI 應用更快、更有效率。」— GitHub Copilot 產品長 Mario Rodriguez,OpenAI 官方公告引述
二、API成本真的會下降嗎?先拆解帳單組成
快取折扣只降低符合條件的快取輸入 Token 成本;整體帳單仍由未快取輸入、快取輸入、快取寫入、輸出 Token、工具費用與處理模式共同決定,必須用實際請求數據計算。
以 GPT-6 Astra 官方模型頁目前列示的標準文字計價為例,每 100 萬 Token 的輸入是 10 美元、快取輸入是 1 美元、快取寫入是 12.5 美元,輸出是 50 美元。超過 272K 輸入 Token 時,輸入與快取價格按 2 倍、輸出按 1.5 倍計算。
Batch 與 Flex 是標準價格的 50%,Fast mode 是 2 倍;價格與可用性也受模型、服務模式、帳戶和區域條件影響,部署前應查看官方頁。
試算一個量級:每次 100,000 個輸入 Token 中有 70,000 個命中,另產生 20,000 個輸出 Token,單次約 1.37 美元,1,000 次約 1,370 美元;全未命中約 2,000 美元。這未含快取寫入、工具、重試與匯率,應以 usage 紀錄核對。
台灣團隊應先在目標組織確認模型、API 權限、付款、使用層級、速率限制與區域支援,再安排小流量測試。ChatGPT 訂閱不等於 API 有相同模型或額度,尚未開通時需準備回退模型。
為什麼最高折扣不等於最高省幅?
第一個原因是命中率。若 10,000 Token 的提示只有 2,000 Token 命中,剩下內容仍按未快取輸入計算。第二個原因是請求結構,長輸出可能遠高於輸入費用。第三個原因是流量,重複請求不足時,難以攤平快取寫入與重構成本。
第四個原因是快取失效。變更工具順序、模型或前段設定,可能讓後續內容都無法沿用。為了追求命中率而把最新資料、權限資訊或租戶內容放進共享前綴,也會引入隔離與資料治理風險。
| 成本項目 | 典型內容 | 影響成本的關鍵 | 應觀察的指標 |
|---|---|---|---|
| 未快取輸入 | 新問題、最新檢索結果、易變資料 | 每次新增的 Token 數量 | 未快取 Token、輸入占比 |
| 快取輸入 | 穩定指令、工具定義、固定知識前綴 | 前綴是否精確相同、是否在有效視窗內 | cached_tokens、命中率 |
| 快取寫入 | 第一次建立可重用前綴 | 寫入後是否有足夠讀取次數 | cache_write_tokens、讀寫比 |
| 輸出 Token | 回答、工具參數、推理結果 | 回答長度與推理強度 | 輸出 Token、品質、延遲 |
三、哪些長提示與AI工作流適合快取?
重複率高、前段內容穩定、請求間隔落在快取有效時間內,且能清楚分離固定內容與易變內容的工作流,較有機會從 prompt caching 得到成本或延遲改善。
穩定系統指令、工具定義與知識庫前綴
客服代理、內部知識問答、程式碼審查與文件生成,常有固定的角色規則、格式要求、工具清單和參考文件。以同一版本、同一順序放在前段,較容易形成共享前綴。知識庫更新時,應把穩定政策和欄位說明放前段,將本次檢索片段追加到後段,避免重排整份資料。
多輪代理、分支任務與背景工作
多輪代理會連續呼叫模型與工具,重複上下文比單次問答更有快取價值。分支任務可共用穩定規則,再於後段放入差異;背景工作可預熱固定指令與參考資料。
不過,分支越多,權限與租戶隔離越重要。不同客戶的私有資料、存取權限和個人化設定,不能只為了提高命中率而混入同一個共享前綴。若工作流處理健康資料,孕婦、兒童、慢性病患者與長期服藥者的資料可能具有更高敏感性,應先確認資料保留、存取控制與合約責任,再決定是否使用延長或共享快取。
四、哪些變動會造成 cache miss?
cache miss 常見原因包括前綴內容不完全相同、工具定義或排序改變、模型或服務設定變更,以及請求超出可重用時間;診斷時應用基準回應逐項比較,而不是只看單一請求的命中數字。
工具、排序、模型與輸入內容變更
工具定義包含名稱、描述、參數 Schema 和排列順序;移除或重排工具,可能改變後續前綴。OpenAI 的範例把 get_time 改為 get_date,miss 原因為 tools_changed。切換模型、處理模式或重寫系統指令也可能造成前綴無法對齊。
如何用診斷資料定位受影響 Token?
選一個預期共享相同前綴的近期回應作基準,檢查 miss 類型、原因、可重用 Token 與未命中 Token。先比對模型與處理模式,再看工具、系統指令、知識前綴和使用者輸入;成本仍以當前回應的 usage 欄位為準。
「OpenAI’s prompt caching and dashboard helped us improve cache hit rates by a few percentage points, reducing costs by 20%.」— Arian Hanifi,技術長,OpenAI 官方公告引述
五、程式端如何配合GPT-6快取機制?
程式端應固定共享前綴,將易變內容移到後段,依工作流在穩定邊界設定明確快取斷點,並用預熱、穩定工具排序與版本化設定降低不必要的 miss。
第一步是重排請求結構。把角色規則、輸出格式、工具 Schema 和長期參考資料放前面,把租戶、使用者、最新查詢與本輪任務放後面,並由權限層控管資料送出範圍。
第二步是選擇快取控制方式。明確快取斷點可指定重用邊界;採用前應以測試請求驗證斷點、命中量和成本,避免寫入低重複率內容。
第三步是預熱。應用啟動或流量高峰前,可先送出固定指令與參考資料,把部分首次處理時間移出等待階段;流量低時,預熱投入可能大於收益。
第四步是保留推理強度調整的彈性。OpenAI 公告描述的做法,是在 GPT-6 不同回合追加 configuration_update,同時保留 request-level reasoning effort,藉此提高或降低 reasoning effort(推理強度)而不重寫原始提示前綴;品質、延遲與費用仍要分組驗證。
這不代表任意變更推理強度都不影響快取。診斷文件把 reasoning_effort_changed 列為可能造成 miss 的原因,預期共用前綴的請求仍應維持相同設定。
這裡要分清楚快取命中率、輸入 Token 成本、輸出 Token 成本與總帳單。調整推理強度可保留共享上下文,卻不代表總成本下降;工具、模型、設定或輸入變更也可能造成 cache miss。快取輸入折扣不能誤寫成整體 API 請求折扣。
若系統處理健康、財務或其他敏感資料,還需把資料分類、租戶隔離、刪除要求、稽核紀錄與供應商留存條款列入設計,並由法務、資安和產品角色確認個資法與跨境資料責任。
快取邊界若跨越租戶或權限角色可能暴露資料;快取鍵、專案、組織與租戶的對應關係必須可稽核。
重構有一次性工程成本:盤點 Token,為提示、工具 Schema、輸出格式和設定版本化,統一多服務的工具排序與序列化,並補測試與回退。這些工作會佔用開發與上線窗口。
既有代理遷移時,還要並行保留舊模型與舊提示,設定灰度流量、比較回應品質,確認回退不會遺失對話狀態;並用同一批任務檢查成本下降是否伴隨錯誤率、延遲、資料隔離或治理風險,這些都應列入工期與預算。
維運成本也要列入回收期:提示更新可能使前綴失效,預熱增加寫入,診斷需留模型、設定、工具版本和租戶標籤;應監控命中率、成本、延遲並保留告警與回退。
六、重構前後應量測哪些指標?
至少要同時比較快取命中率、每次請求成本、首 Token 延遲、完整回應延遲與輸出品質,並以相同流量和任務分布進行小流量 A/B 測試,才能判斷重構是否真的改善工作流。
只看命中率容易誤判。命中率上升,但輸出變長或工具呼叫增加,總成本仍可能上升;首 Token 變快,完整任務時間也未必縮短。某些請求命中率不高,卻可能因縮短高頻長提示的處理時間而具有價值。
品質量測要和成本綁在一起:客服看正確率與重問率;程式流程看測試通過率;知識問答看引用完整性與資料新鮮度。不能為了命中率移除必要的新資料。
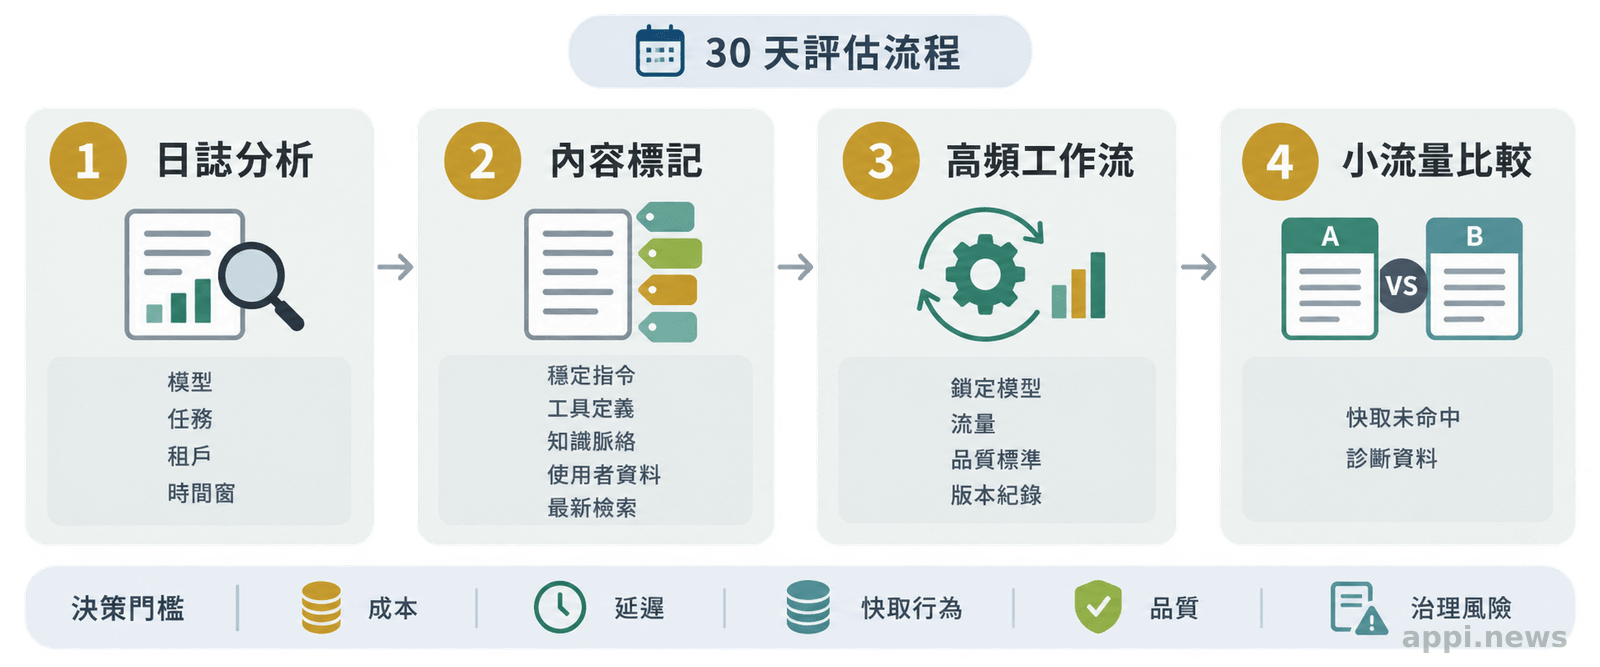
一個可執行的30天評估清單
- 從近 30 天日誌按模型、任務、租戶和時間帶統計輸入、輸出、快取寫入、命中與延遲。
- 標記固定指令、工具定義、知識庫、使用者資料和最新檢索結果,計算可重用前綴比例。
- 選一條高頻工作流重構,固定模型、流量與品質評估方式,記錄前綴、工具和設定版本。
- 以小流量比較成本、命中率、首 Token 延遲、完整延遲和品質,再用診斷工具抽查 miss 原因。
七、結論:先量測,再判斷是否值得重構
GPT-6 prompt caching 較適合長提示重複率高、多輪代理流量穩定、能維持共享前綴一致,且有能力追蹤 Token 與品質指標的團隊;其餘情境應先量測,不必為了名目折扣直接改造整套系統。
OpenAI 的升級把快取帶入可觀察、可診斷、可控制的系統設計,但團隊仍要評估共享邊界、工具變更,以及監控與維護是否值得。
台灣團隊可先盤點近 30 天日誌,計算可重用前綴比例、命中率、未快取 Token、輸出 Token 與總帳單,再以一條高頻工作流做小流量測試。若成本、延遲與品質一起改善,再逐步擴大。
- 30 分鐘共享前綴快取折扣作用於符合條件的快取輸入,不等於整體 API 請求折扣。
- 固定系統指令、工具定義、Schema 與排列順序,把易變資料放在後段,才有較穩定的重用條件。
- 評估時要同時看快取命中率、未快取與輸出 Token、每次請求成本、延遲、品質和資料治理風險。
常見問題
Q1: GPT-6的30分鐘快取會永久保留提示內容嗎?
不會。30 分鐘是共享前綴可重用視窗,仍取決於前綴一致性、請求設定與模型政策。
Q2: 只要把提示寫得很長,就一定比較省嗎?
不一定。提示要有穩定前綴與後續重複請求,才有機會攤平寫入成本;無關內容會增加輸入 Token,頻繁改動也會降低命中率。
Q3: 工具順序改變為什麼會影響快取?
工具定義與排列順序屬於模型看到的提示內容,順序改變可能使前綴不再相同。可用診斷工具比較基準回應,確認是否由工具變更造成 miss。