
Thinking Machines Lab 於 2026 年 11 月 5 日公布 Inkling 2 Small,並開放透過 Tinker 推論與微調。公司表示完整權重待外部安全測試與紅隊測試後,預計以 Apache 2.0 授權釋出。現在能雲端試用,不代表已可下載本地執行。
評估時要分開看能力、取得方式、授權和部署成本。想測程式代理或知識工作,可先用 Tinker;若需內網或本地推論,則要等權重發布後確認格式、框架與硬體需求。
官方已開放 Tinker 試用,完整權重仍待安全測試
目前可透過 Thinking Machines 的 Tinker Playground 試用、進行推論與微調;完整權重尚未釋出,公司預告安全測試完成後再提供下載。
Inkling 2 Small 是 Thinking Machines 的 Inkling 系列新模型。官方稱它採混合專家架構(Mixture of Experts,MoE),總參數 594B、每個 token 啟用 17B,支援圖片輸入與可調整的推理投入程度。這些規格不能直接推成「一張 17B 顯示卡就能部署」。
Tinker 是 Thinking Machines 提供的託管模型服務。官方文件稱 Inkling 是為 Tinker 設計,可寫程式、推理與呼叫工具;文件也示範如何把 Inkling 2 Small 接入 Cookbook。開發者可先測實際任務,但服務端測試不能推斷本地效能、資料路徑或維運成本。
權重與服務是不同的取得狀態。Thinking Machines 在 11 月 5 日的公告中預告,完整權重將在下週完成外部安全測試後採 Apache 2.0 授權釋出;模型卡目前的授權欄則列 Tinker Terms of Use,透過 Tinker 使用時要看的是這份條款。授權預告不等於權重已可下載,也不等於第三方平台都已上架。企業採用前仍應檢查正式模型卡、權重檔、授權全文、使用限制和發布版本,將實際下載到的版本與核准紀錄對上。
如果目前的目標是評估開放權重部署,可先讀Reflection Beam 開放權重模型的部署門檻與企業評估開放權重模型時該檢查的面向,把授權、執行環境和資料控制納入同一份採購或技術評估表。這些條件同樣適用於 Inkling,但該模型的正式權重和條款仍須以發布時文件為準。
程式代理與知識工作是目前值得驗證的能力
官方公布的結果涵蓋程式代理、知識工作、視覺理解與長程任務;其中部分成績有競爭力,但分數各自對應特定基準與測試條件。
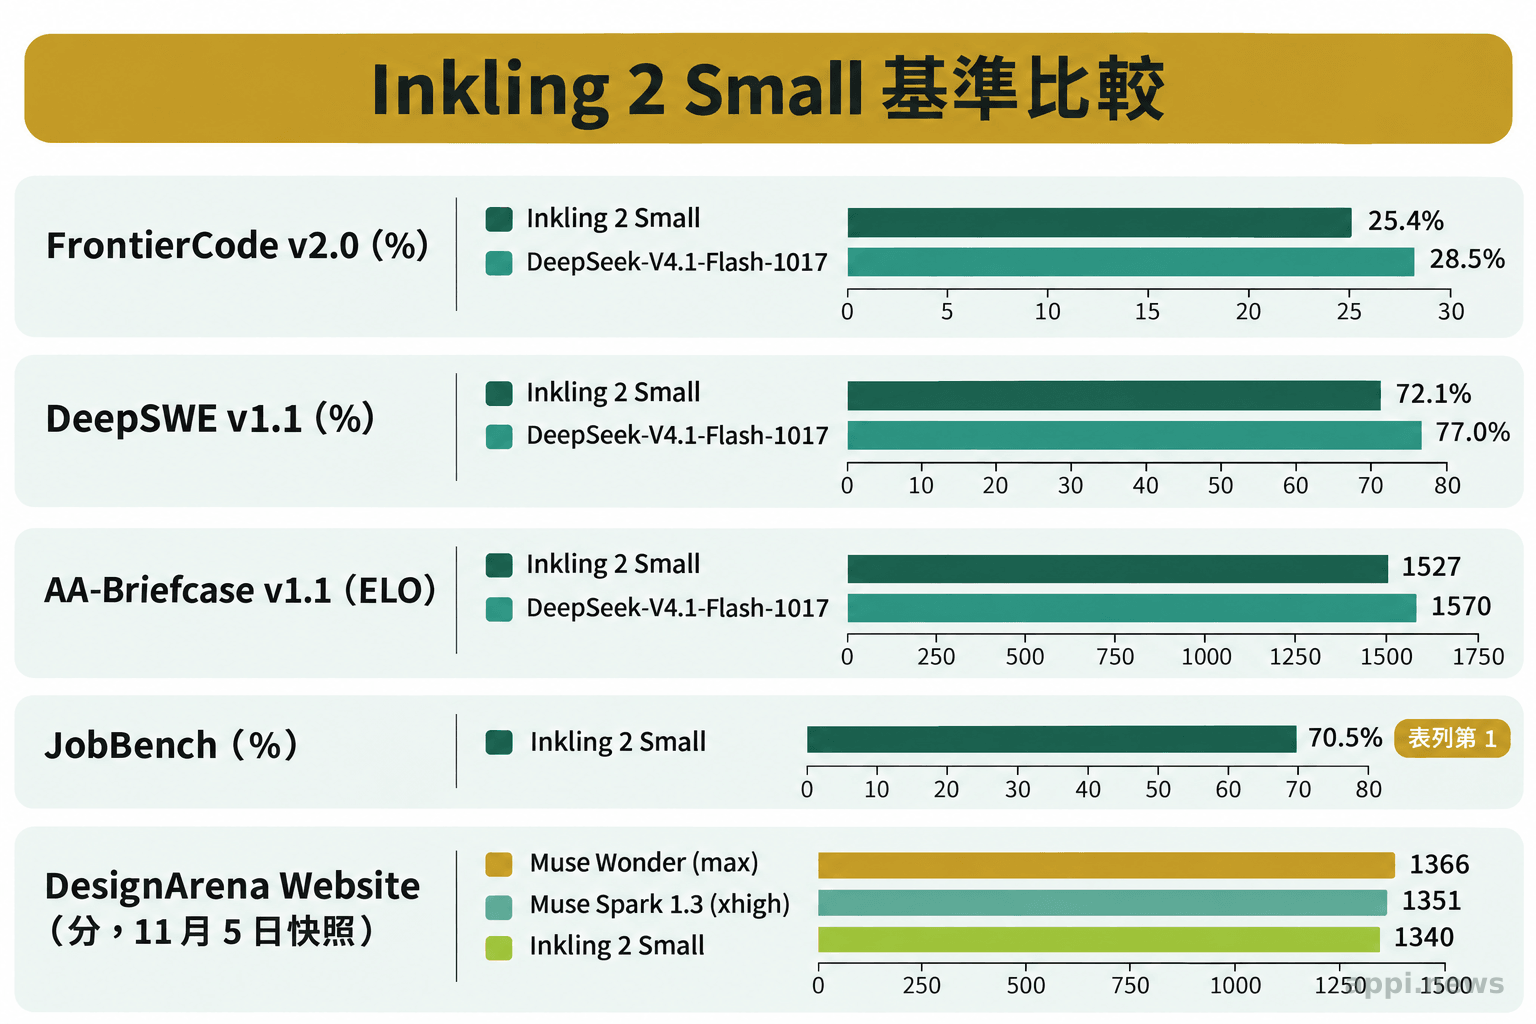
程式代理是發布資料的重點案例。Thinking Machines 報告 Inkling 2 Small 在 FrontierCode v2.0 得 25.4%,DeepSWE v1.1 得 72.1%。
同表 DeepSeek-V4.1-Flash-1017 分別得 28.5% 與 77.0%,兩項都高於 Inkling。這組成績支持把模型列入程式代理測試,不能說它已勝過所有開放權重模型。
第二個案例是端到端知識工作基準 AA-Briefcase v1.1。Thinking Machines 列出的 Inkling 2 Small ELO 為 1527,低於 DeepSeek-V4.1-Flash-1017 的 1570;JobBench 則以 70.5% 位居表中第一。
一種知識工作測試的名次,不能代替另一種流程的評估。
第三個案例是 Thinking Machines 公布的長程自動研究示範。Inkling 2 Small 在 Tinker 上自主訓練 Qwen3.5-4B,預測天氣與維基百科頁面瀏覽量等時間序列。模型自行分析任務、建立評估器、測試訓練方法並除錯。
官方稱這項工作約花 4.5 小時、服務費 426 美元,訓練後分數超過原來兩倍。這是廠商內部示範,並非獨立重複測試,不能保證換資料或目標後有相同結果。
視覺能力也有案例。Thinking Machines 引用 DesignArena Website 11 月 5 日榜單快照,Inkling 2 Small 得 1340 分;官方另稱一場內部盲飲圖片測試中,模型 20 次認對 19 次。
前者是特定設計評測的快照,後者是公司內部測試,樣本和環境有限。需要辨識圖表、表單或介面截圖的團隊,可據此選擇候測任務,再以自己的圖片品質和錯誤容忍度實測。
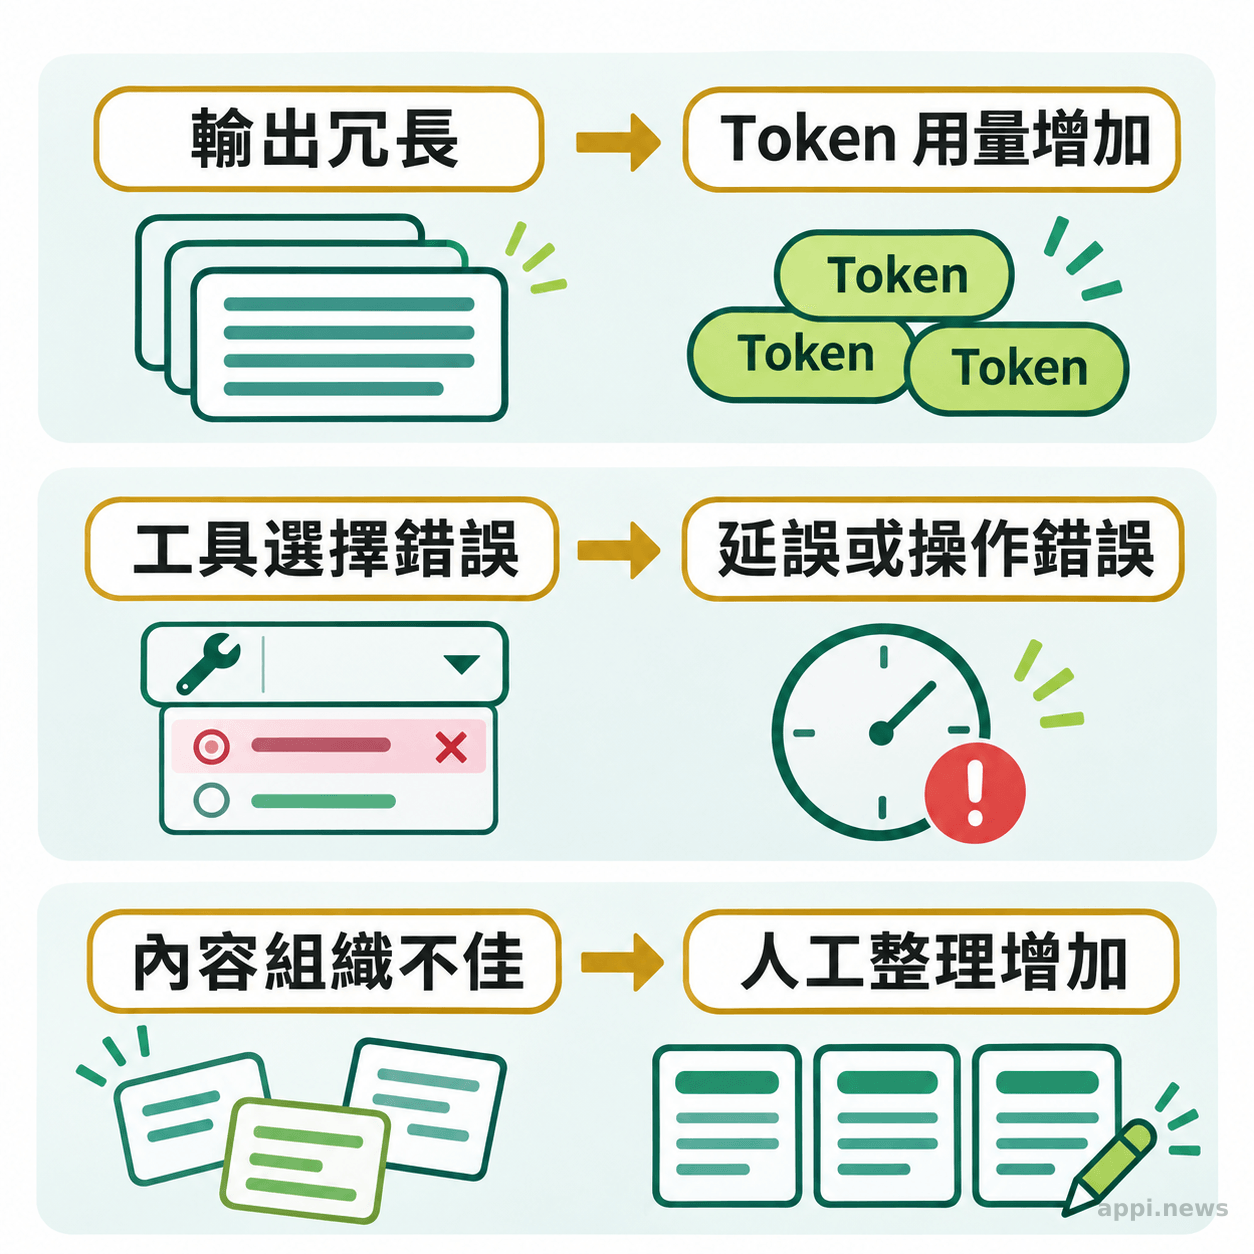
發布公告寫明這款模型支援圖片、不支援音訊;Tinker 文件則寫 Inkling 與 Inkling-Small 可接受音訊,型號名稱相近,需要語音輸入的團隊應先實測確認。Thinking Machines 也坦言,模型表達不夠精簡,在技能繁多的程式碼庫裡未必選對工具,聊天內容的組織仍待改善。
這些限制會影響代理流程:輸出較長會增加 token 用量,工具選錯會延長工作或造成錯誤操作,文字需要整理則增加人工時間。
Thinking Machines 指出,Inkling 2 Small「不一定會為工作選到最合適的工具」,尤其在技能很多的程式碼庫中。測試代理時也要檢查工具選擇。
想把模型的工具能力放進真實流程,可參考開放權重模型本機部署的網路與工具權限檢查。代理能呼叫工具時,除了回答正確率,也要記錄它取得了哪些資料、呼叫了哪些工具、是否遵守權限,並確認失敗時能否停止或交由人員覆核。
領先主張要拆成基準、比較對象與測試設定
官方成績顯示它在若干基準取得較高名次,但不同測試的領先者並不相同;「領先」只能限定在指定基準、比較名單與版本中理解。
Thinking Machines 的發布頁和模型卡列出多個基準,部分分數取自 Artificial Analysis、Datacurve、DesignArena、Scale AI、Surge、Mercor、Thoughtful 與 Vals 等外部評測機構。
公司仍負責整理成績表與比較範圍,閱讀時應確認各列來源,以及版本、提示、工具和推理設定是否一致。
前面提到的程式評測,它都低於 DeepSeek-V4.1-Flash-1017;DesignArena Website 榜單快照則得 1,340 分,公司稱權重釋出後將是該榜最高的開放權重模型,但榜上 Muse Wonder (max) 的 1,366 分與 Muse Spark 1.3 (xhigh) 的 1,351 分仍在它之上。不同基準呈現不同強弱,不能把單一高名次擴寫成全方位第一。
評測設定也會改變比較結果。Thinking Machines 的表格包含不同推理投入程度;第三方評測各有資料集、評分者、工具鏈和版本日期。測試版本或代理框架不同時,分數只適合初篩。
Thinking Machines 將其評測表描述為包含“externally reported evaluations”,並列出多家測試機構;這說明部分結果由外部評測提供,並不代表全部基準均由單一獨立機構統一重跑。
594B 總參數的 MoE 模型,本地部署要先算哪些成本
不能這樣推算。17B 是每次計算啟用的參數量,不等於要下載或載入的完整權重規模;硬體需求須等權重、精度、量化方案和推論框架公布後測量。
MoE 會依輸入選用部分專家網路計算,因此啟用參數與總參數描述不同面向。本地部署還要考量權重儲存、專家如何分散到加速卡、上下文快取、並行請求和載入時間。
本地部署還要看權重格式與量化。量化以較低位元表示參數,可減少儲存或計算需求,也可能影響品質與速度。官方量化版本、社群轉檔結果和推論框架的 MoE 支援,都要等權重發布後確認;目前無法可靠估算記憶體、顯卡數量與成本。
即使框架相容,部署還要評估更新、權限、監控、資料保留與故障回復。使用 Tinker 要看服務可用性、資料條款、API 價格和延遲;本地運行則要計算硬體、維運、備援和尖峰容量。可參照模型 API 與本地部署的成本估算法,將 token、等待與人工修正一起換算。
下載後如何用自己的任務判斷是否值得採用
固定代表性資料、提示、工具與評分方式,讓 Inkling 2 Small 和現行模型完成相同工作,再同時比較品質、延遲、token 成本、人工修正量與部署維運成本。
先選一個可重複的真實任務,例如修復測試失敗、整理文件、讀圖輸出欄位,或呼叫 MCP 工具查資料。準備脫敏或合成案例,涵蓋常見情境、邊界情況和錯誤輸入。公開基準不會完整反映團隊的資料結構、工具權限與交付格式。
固定提示詞、工具版本、模型設定、推理投入和輸出限制,讓每個模型重跑多次,記錄成功率與失敗類型。人工評分應先訂規則,並盡量隱去模型名稱。測試集也要避免混入訓練資料或公開答案,以免高估表現。
成本表至少要包含以下指標:
- 任務品質:完成率、錯誤類型、輸出是否符合格式與安全要求。
- 速度:平均及較慢情況下的回應時間、排隊時間、工具執行時間。
- 模型用量:輸入與輸出 token、重試次數及每個成功任務的服務費。
- 人工工時:檢查、修正、重新執行與交接所花時間。
- 部署條件:權重與框架是否可用、硬體和能源需求、監控與更新負擔。
依任務性質決定門檻。例如程式修改可以要求測試全數通過、人工檢查時間低於現行流程;文件整理可以檢查欄位準確率與返工率。不能只看平均分數,還應保留最差案例與錯誤後果。如果模型能完成大部分工作,但偶爾會錯誤呼叫有寫入權限的工具,需先縮小權限、設置人工確認,再判斷是否適合進入正式流程。
Inkling 2 Small 現階段適合列入測試候選,尤其是需要程式代理、知識工作或圖片理解的團隊。若關鍵條件是離線部署、可審核的授權與自有硬體成本,應等權重實際釋出,確認版本與規格後再做部署驗收。正式權重到手後,先挑一組能代表日常工作的測試集,與現有模型並行跑完,再依成功率、延遲、token、人工修正時間和維運成本決定是否擴大使用。
- Inkling 2 Small 目前可透過 Tinker 推論與微調,完整權重仍待外部安全測試,Apache 2.0 是預告授權。
- 官方結果在不同基準呈現不同名次;程式、知識工作或視覺測試都不能單獨代表全部任務。
- 594B 總參數與 17B 啟用參數無法直接推算本地部署硬體,需等權重與框架發布後驗證。
- 評估採用價值時,將模型品質、速度、token、人工修正與部署維運放在同一張表比較。
Inkling 2 Small 常見問題
先依官方最新發布資料確認權重是否上架及授權是否生效,再把基準視為挑選測試任務的線索,最後以自己的工作流程驗收。
常見問題
Q1:Inkling 2 Small 現在可以下載嗎?
截至 2026 年 11 月 6 日,官方表示可透過 Tinker Playground 推論,也可在 Tinker 抽樣與微調;完整權重待安全測試後提供。下載前應查看模型卡與權重頁是否更新。
Q2:Apache 2.0 授權目前已生效嗎?
官方預告完整權重將採 Apache 2.0 授權。正式使用前應核對權重頁附帶的授權文字、版本與額外條款。
Q3:基準成績高,能代表自己的工作流程也會更快嗎?
不能直接推定。基準的資料、提示、工具和模型版本可能不同,需用相同任務與評分規則並行測試,才能比較成功率、延遲、成本和返工。
Q4:17B 啟用參數代表一般桌機就能執行嗎?
不能。17B 是每次推論啟用的參數數量,不是部署所需的完整權重記憶體。需等權重、量化版本和推論框架公布後實測。


