開放權重模型可以下載與自行部署,是否就代表企業掌握了 AI?Aleph Alpha 發布的 Kolibri 把這個問題帶到企業選型現場:它以德語、英語為主要語言,採混合專家(Mixture of Experts,MoE)架構,總參數約 78.1B,每個 token 啟動約 3.46B 參數,並以歐洲 AI 主權為訴求。對台灣組織來說,規格只是起點;還要確認部署環境、資料與供應鏈控制、繁體中文表現,以及長期維運由誰負責。
一、Kolibri 公開了哪些規格與主張?
Kolibri 是 Aleph Alpha 發布的德英雙語 MoE 模型,權重以 Apache 2.0 授權提供,模型卡列出 78.1B 總參數、每 token 約 3.46B 啟動參數。 這些是廠商公開的規格與設計目標,不能直接推論成特定企業已能低成本部署或符合台灣的語言需求。
參數與長上下文各代表什麼
MoE 是把模型中的多組專家子網路交由路由機制分配工作的架構。Kolibri 每次處理 token 時只啟動部分專家,所以「每 token 啟動參數」描述的是運算時參與工作的參數量;總參數則代表模型整體容量。兩者用途不同,不能只看 3.46B 就把它當成一個約 3B 的小模型。
官方模型卡列出最長 1,048,576 tokens 的上下文,也建議服務部署與複雜任務以不超過 262,144 tokens 為宜。上下文長度是一次請求可處理的文字範圍,不等同於模型可靠記住所有內容;實際效果還受提示設計、輸入文件、推論設定和任務影響。長上下文也會增加記憶體、延遲與吞吐量負擔。
官方評測呈現的是特定測試條件
Aleph Alpha 技術報告比較 Kolibri 與其他模型的英文、德文評測分數及推論吞吐量,並指出測試採用八張 B200 GPU,以及不同階段指定的序列長度。這些結果能呈現廠商選定條件下的比較,不是獨立機構對所有工作負載的驗收,更不能直接預測企業在不同硬體、提示、資料與服務併發量下的表現。
評估時應把模型卡和技術報告當成規格與測試方法的起點,記下基準任務、版本、精度、硬體、序列長度與推論設定。缺少這些條件,單獨引用分數或「效率」容易讓採購者誤判。Kolibri 目前以德語、英語為焦點,繁體中文能力及台灣常見文件、用語與任務仍需另行測試。
二、開放權重為什麼不等於企業已取得 AI 主權?
開放權重讓組織取得模型檔並選擇自行部署,主權仍取決於資料、執行環境、更新、供應鏈與人員是否能由組織管理。 其中任何一環仍依賴外部服務或未明確約定,組織能控制的範圍就會受到限制。
先分清楚權重、程式與營運控制
「權重可取得」回答的是模型參數能否下載與使用;「可自行部署」回答的是是否能在自己選擇的基礎設施上執行;「資料自主」則要看輸入、日誌、備份和輸出資料實際存在哪裡、誰能存取。這幾項彼此相關,卻不是同一件事。
企業即使把模型放在自有伺服器,仍可能依賴特定推論套件、硬體驅動、容器映像、雲端管理平面或供應商支援。若模型更新只能透過單一供應商取得,或部署人員無法自行排除故障,主機位置並不足以說明控制能力。採購文件應列明各元件提供者、版本、替代方案、支援期限與中止服務後的移轉方式。
主權要轉成組織能驗收的控制項
Aleph Alpha 將 Kolibri 定位為主權 AI 模型,並說明模型開發與訓練流程以歐洲監管脈絡為考量。這是廠商的設計主張。企業可以把它拆成具體問題:敏感資料是否離開指定區域?管理者能否限制模型和日誌的存取?模型版本由誰核准更新?出現弱點時誰負責通知與修補?日後更換模型時,提示、評測和知識庫能否攜出?
若這些問題沒有可驗收的答案,「主權」便停留在定位和口號。企業可先界定哪些資料必須由內部控制、哪些服務可外包、哪些供應商依賴可接受,再逐項核對架構、合約及實際操作權限。
「開放權重授權適用於此模型庫發布的權重與設定檔;未包含在庫中的其他成果不在該授權範圍內。」(Aleph Alpha Kolibri 模型卡,中譯)
三、部署成本與模型能力要如何驗證?
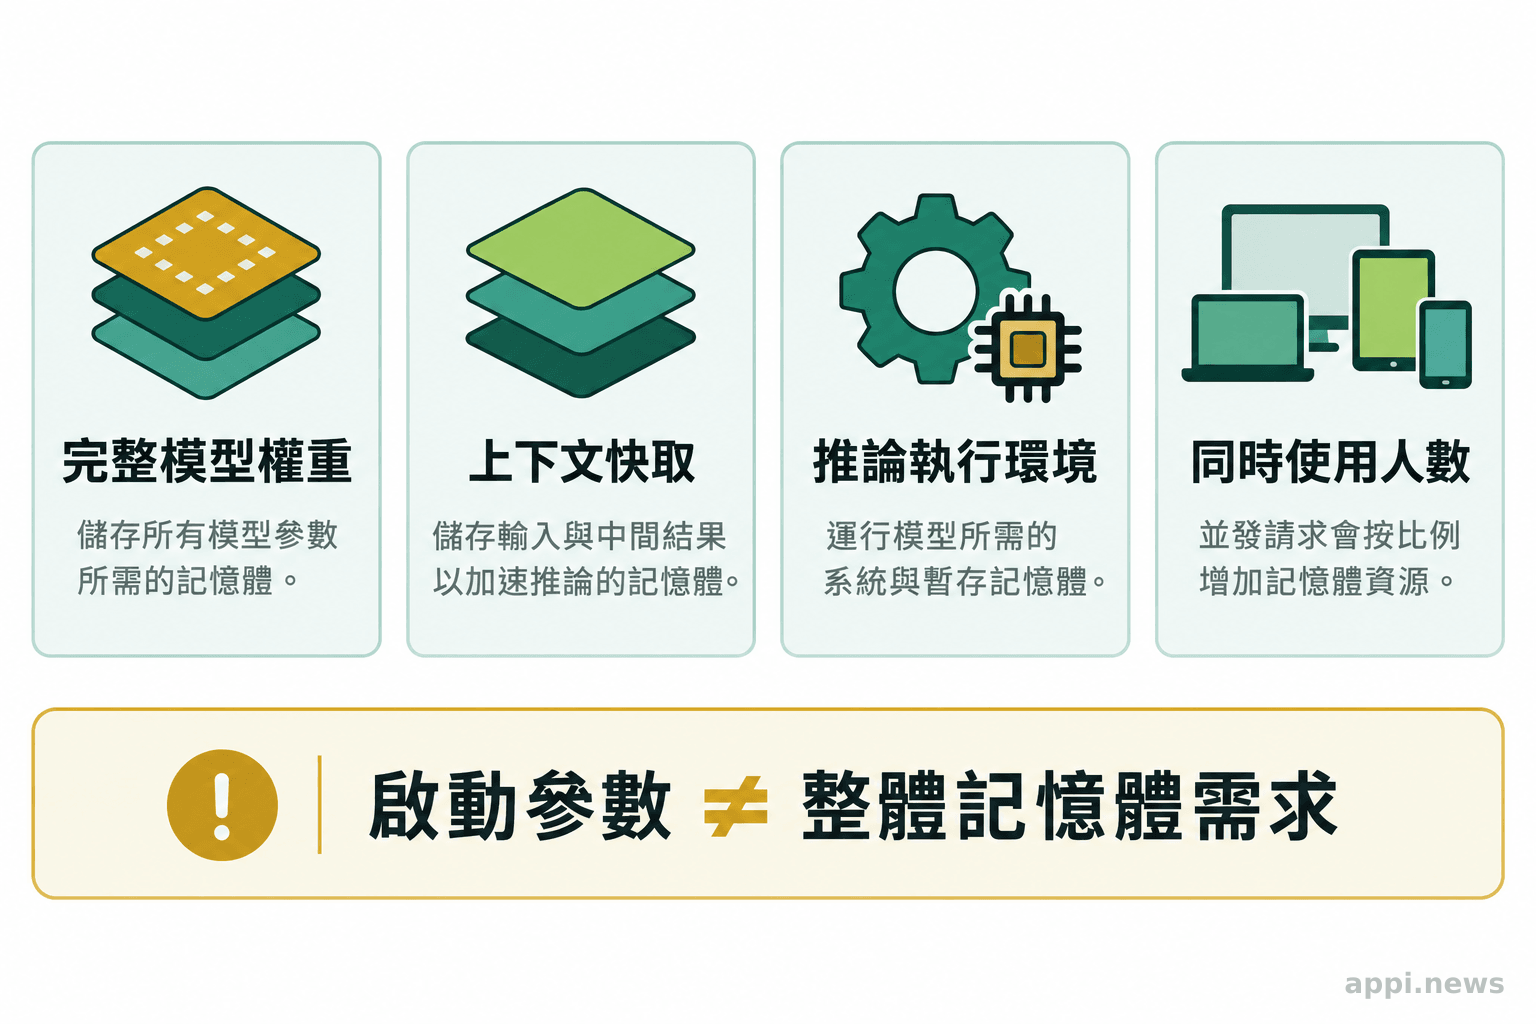
不能只用每 token 啟動參數估算成本;MoE 雖減少每次運算啟動的參數,完整模型權重仍須載入記憶體。 企業還要把上下文、併發、延遲、硬體供應與繁體中文任務納入實測。
先估完整模型記憶體與服務負載
模型卡列出 FP8 權重記憶體約 78 GB,並提供最低與建議硬體配置。這個數字只說明權重所需空間的量級,不能當作整台服務的總記憶體需求。推論時還需考慮 KV cache(保存對話上下文的鍵值快取)、執行框架、暫存、併發請求與作業系統等額外負擔;長上下文尤其會推高快取需求。
所以,硬體評估不要只問「能不能載入」。還要以預期的輸入長度、同時使用人數和輸出速度測量延遲、吞吐量、記憶體峰值與故障恢復。若組織無法穩定取得模型卡建議的加速器,還需確認替代硬體、量化版本與框架相容性;降低精度可能節省資源,也可能改變輸出品質,必須一併驗證。
建立自己的評測集,特別檢查繁體中文
企業工作負載應由實際任務定義,例如內部文件問答、合約欄位抽取、客服草稿或程式協作。先列出可接受錯誤、必須引用來源的比例、人工覆核時間與服務目標,再建立去識別化、具代表性的測試樣本。評分除了答案正確度,也要看引用是否可追溯、拒答是否合理、格式是否穩定,以及錯誤會造成什麼後果。
Kolibri 的模型卡標示語言重點為德語和英語。台灣企業若要處理繁體中文,應用自己的繁體中文文件、混合中英術語、表格與本地用語測試。通過英語或德語 benchmark,不能替代繁體中文驗收;少量示範結果也不足以代表正式環境表現。測試紀錄應保留模型版本、提示、量化精度、推論框架和硬體,未來更新後才能比較差異。
四、授權、資料治理與維運要查哪些條件?
要逐項確認授權覆蓋的檔案、資料處理方式、推論依賴、資安更新、稽核能力與事故責任。 開放權重只處理一部分使用權,不能替代組織對產品整合和部署方式的審查。
Apache 2.0 不代表所有相關成果都同一授權
依 Kolibri 模型卡對該模型庫內容的說明,Apache 2.0 適用於庫內發布的權重與設定檔;模型卡並說明,未包含於該庫的程式與訓練方法不在其所述授權範圍內。實際適用範圍仍應以下載版本附帶的授權與通知文件及各檔案為準,再確認內部使用、修改、再散布、衍生模型及提供服務時的義務;推論引擎、容器和其他相依套件則要分別查授權。
Apache 2.0 的條文提供著作權與專利授權,也包含保留聲明與免責條件。採用者仍需確認實際分發方式是否要附上授權、NOTICE 或修改說明,並交由法務處理與產品情境相關的疑問。模型權重採寬鬆授權,不表示訓練資料中每項內容的權利狀態都已由採用者逐筆確認。
文件可查不等於治理工作已完成
模型卡提供訓練資料概述、預期用途、風險與限制,技術報告則說明訓練和評測方法。Aleph Alpha 也表示開發考量歐盟 AI 法案與通用 AI 行為準則;歐盟執委會指出,該準則是協助通用 AI 模型提供者理解透明度與著作權等義務的自願工具。這些資訊有助於盡職調查,但不能代替企業對自身用途、適用法規和下游系統責任的判斷。
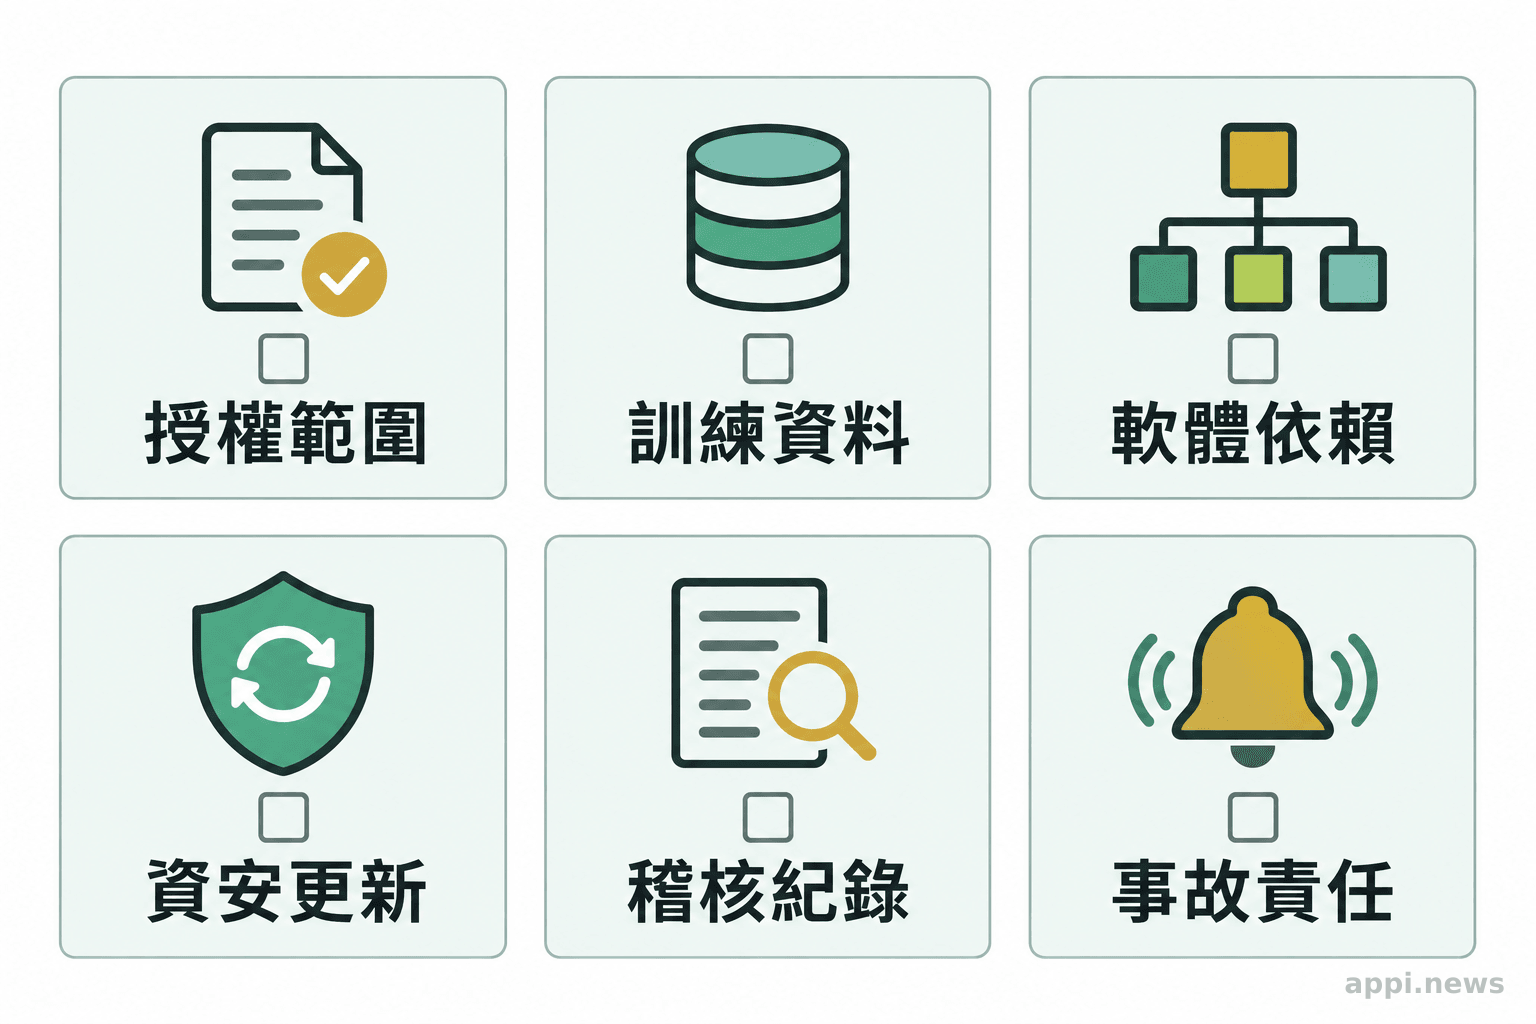
落地前要取得並留存模型版本與變更紀錄、漏洞通報和更新政策、部署相依清單、日誌保留設定、資料刪除方式、支援窗口及事故處理責任。還要確認模型的輸出如何進入既有流程、誰有權採取行動、人工覆核在哪個節點發生。對高影響決策,模型輸出應由具職責的人員檢查,不能把通用模型當成未經監督的自動決策元件。
「通用 AI 模型的規範涵蓋透明度與著作權;具系統性風險的模型提供者還須評估及降低相關風險。」(歐盟執委會通用 AI 行為準則說明,中譯)
五、從小規模測試到正式部署,門檻如何設定?
先用低風險、可衡量的任務驗證語言能力、硬體成本、治理流程與支援條件,再依預先訂好的門檻決定擴大、調整或暫緩。 測試失敗時,應能指出是模型能力、資料品質、整合或責任安排哪一層未達標。
把驗證拆成能比較的階段
第一步先挑選不會直接觸發重大決策的工作,例如內部文件摘要或有來源可核對的檢索問答。以去識別化資料建立測試集,記錄回答品質、來源正確率、繁體中文理解、延遲、單位任務成本和人工修改量。測試也要納入不完整資料、矛盾文件與模型應拒答的案例。
接著在目標硬體與預計推論框架上試跑,加入權限控管、日誌、備份、監控與更新流程。若模型必須搭配特定推論套件才能使用,應把該套件的維護責任和版本相容性納入整體方案。若資源不足,應比較不同硬體、較短上下文或替代模型的測試結果,不要用單次成功啟動取代容量規劃。
- 定義控制邊界:列出不得離開組織的資料、指定部署位置,以及可接受的外部供應商依賴。
- 定義驗收指標:以實際任務設定品質、拒答、來源可追溯、延遲、成本和人工覆核門檻。
- 執行代表性測試:使用繁體中文與真實格式文件,在預計硬體和服務負載下測試並留存版本設定。
- 查清責任與退出方式:取得授權、更新、資安、支援和資料處理文件,確認供應中止時的模型、資料與流程移轉方案。
- 依證據決策:只有在能力、成本、治理和維運均達門檻時才擴大;未達標就縮小場景、補強流程或暫緩採用。
把決策條件寫進採購與營運安排
可先做沙盒測試的組織,通常已有能管理 GPU 或雲端推論環境的人員、可供評測的繁體中文資料,以及明確的人工覆核與資料權限流程。若硬體成本尚未估清、繁體中文品質未驗證、授權範圍不明,或沒有人承擔模型更新與事故處理,就不宜把小規模展示視為正式上線依據。
對企業而言,Kolibri 的價值需要在特定任務和控制要求下證明。開放權重帶來部署選項,主權則要由組織實際掌握哪些資料、系統、決策與責任來界定。向供應商索取模型卡、技術報告、授權清單、更新政策和支援責任文件,再以自有工作負載驗證,才能判斷這個選項是否適合自己的環境。
- 開放權重擴大部署選項,但不會自動帶來資料、供應鏈與維運自主。
- MoE 的啟動參數較少,不代表完整模型記憶體需求低;要依上下文、併發與硬體實測。
- Kolibri 著重德語與英語,繁體中文能力、台灣硬體可得性和總持有成本都應由企業自行驗證。
- 採用前須確認權重授權範圍、推論元件、資安更新、人工覆核和退出安排。
常見問題
Q1:Kolibri 是開源模型嗎?
Kolibri 權重以 Apache 2.0 授權發布。模型卡將授權範圍說明為該模型庫中的權重與設定檔,因此使用「開放權重」較精確;相關推論程式、其他元件與訓練方法須分別確認權利和授權。
Q2:3.46B 啟動參數代表一般顯示卡就能執行嗎?
不能這樣推論。MoE 每個 token 啟動部分參數,但完整模型權重仍需載入記憶體。模型卡列出的 FP8 權重記憶體約 78 GB,實際部署還要加上快取、推論環境和併發所需資源。
Q3:Kolibri 可以直接用於繁體中文工作嗎?
模型卡列出的主要語言是德語與英語,沒有以此保證繁體中文任務表現。若工作流程依賴繁體中文,應用自有文件、用語和任務建立測試集,確認品質後再評估使用。
Q4:官方 benchmark 可以當成企業驗收結果嗎?
不可以直接等同。Benchmark 反映特定資料集、硬體和推論條件下的結果;企業仍須在目標硬體、服務負載與實際任務上測試,並保留模型版本及設定以便重現比較。
參考來源
- Aleph Alpha (2026). *Kolibri: A Sovereign European Model on the Pareto Frontier*. 技術報告
- Aleph Alpha (2026). *Aleph-Alpha/Kolibri-1*. Hugging Face
- Apache Software Foundation (2004). *Apache License, Version 2.0
- European Commission (2026). *Drawing-up a General-Purpose AI Code of Practice*. Shaping Europe’s Digital Future