
WEKA 與 Nebius 的聯合測試呈現一個落差:同樣的 GPU,改變上下文儲存方式後,每 GPU 小時的輸出詞元達到原配置的 3.7 倍。這是 WEKA 於 2026 年 11 月 16 日在 Supercomputing 2026(SC26,超級運算大會)公布的廠商基準結果,適用於該次代理工作負載與配置。測試公告把問題帶回 AI 推論:GPU 使用率高,究竟完成了多少有用工作?
但這裡要先問一個更前面的問題:採購要解決的是晶片閒置,還是使用者等待太久?台灣團隊若把使用率當驗收門檻,可能接受一套忙著重算、卻未達回應目標的系統。先定義完成條件,才能比較部署效益。
SC26 的新框架,想把哪些工作算進成績?
WEKA 與 NAND Research 提出的「推論經濟效益評分卡」,主張以符合服務目標的有效產出衡量基礎設施,並要求比較相同工作負載、完整服務系統及長時間運作結果。
這項發布包含分析機構框架與供應商測試,兩者要分開判讀。NAND Research 報告刊載於 WEKA 官網,內容也分析 WEKA 產品;聯合測試則涉及受益廠商自己的儲存方案。這些數據應保留商業來源歸屬,不能當成獨立驗證或通行標準。
測試採單一 NVIDIA HGX B300 八 GPU 節點,執行 DeepSeek-V4-Pro,從逾 5,000 個真實編程代理工作階段選出 512 個活躍階段,每種配置運行八小時。比較對象是僅用 HBM(高頻寬記憶體),以及加上共享上下文儲存層。
WEKA 公布,預填充重算比例由 60% 降至 6.8%;成功完成的請求中,五秒內收到首個詞元的比例由 44% 升至 97%。後者的分母只涵蓋成功請求,仍須搭配全部請求的失敗率判讀,不能直接視為整體服務達標率。原始公告
WEKA 執行長 Liran Zvibel 表示,GPU 使用率能顯示晶片忙碌,卻無法說明工作是否完成、重複或被丟棄。(發言意譯,見上述公告)
對採購者,先辨明瓶頸再選硬體的思路,也可對照企業加速器與工作負載的評估方式。這次新增的重點,是把「重複運算」從看似健康的忙碌時間裡拆出來。
GPU 忙碌,為什麼使用者仍可能等得久?
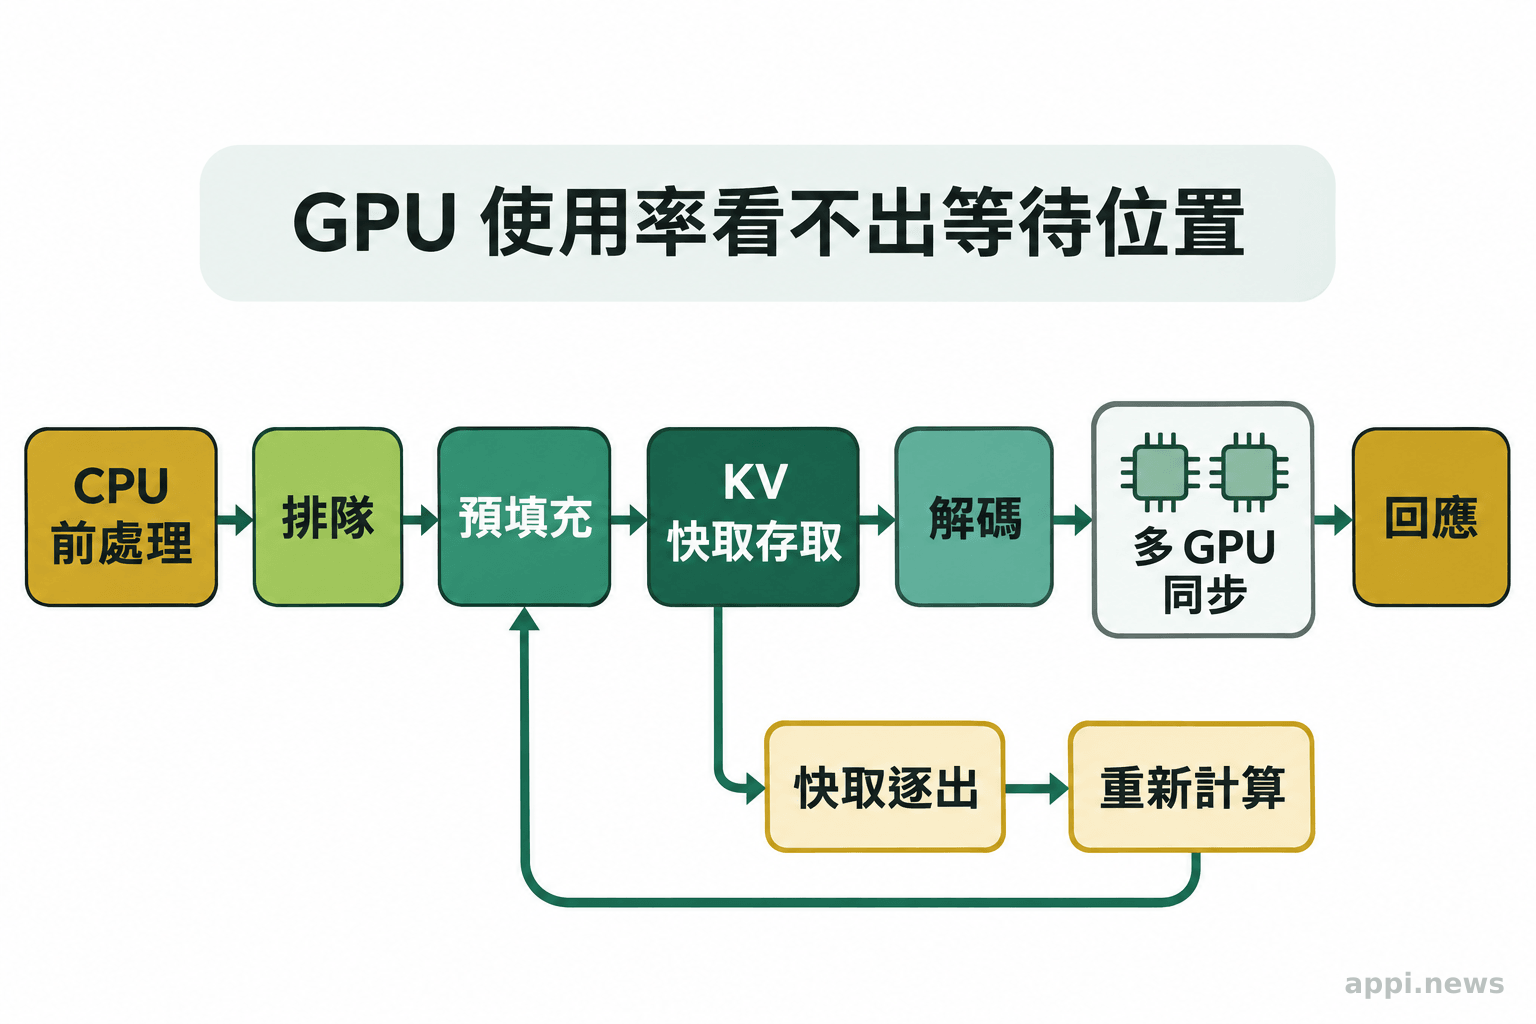
請求還會經過前處理、排隊、讀取記憶體與跨 GPU 通訊;其中任何環節卡住,都可能拉長等待時間。重算和失敗前的運算,也會占用 GPU。
NVIDIA 的 nvidia-smi 文件將 GPU 使用率定義為採樣期間有至少一個運算核心程式執行的時間比例。它沒有直接計算完成請求量,也不等於所有運算單元都發揮峰值能力。報表應先標明指標名稱與工具,避免混用活動時間、記憶體占用和算力利用比例。
以大型語言模型為例,prefill(預填充)先處理輸入;decode(解碼)再逐步產生 token(詞元)。模型會保存 KV cache(鍵值快取),重用先前上下文的中間計算。快取被移出、之後又需要時,便可能重新運算;解碼也可能受限於記憶體資料搬移速度。
第二個案例是 Kwon 等人的 vLLM 研究。團隊發現快取的記憶體碎片與重複配置限制批次大小,於是用 PagedAttention(分頁注意力管理)改善配置。在 A100、OPT 與 LLaMA 等當年測試組合中,相同延遲下的吞吐量約為 FasterTransformer、Orca 的 2–4 倍。這是 2023 年研究的比較,不能作為今日各版本的排名。研究原文
第三個案例 Sarathi-Serve 則處理排程:長輸入的預填充,會干擾正在逐字輸出的請求。Agrawal 等人在 OSDI 2024 發表的研究,把預填充分塊穿插執行;單張 A100、Mistral-7B 的測試,在尾端延遲限制下,服務容量達比較版本 vLLM 的 2.6 倍。這反映排程效益,不能套用到所有模型。研究原文
Sarathi-Serve 研究指出,批次處理能提高吞吐,但預填充與解碼交錯執行,使高吞吐和低延遲難以同時達成。(研究摘要意譯,見上述論文)
還要往系統外圍追:CPU(中央處理器)的輸入處理是否塞車?多 GPU 是否花太多時間同步資料?應逐段量測,才能決定要調排程、快取或通訊配置。
推論效能要補看哪些指標?
先看首詞元時間、完整回應延遲及其高分位數,再看成功吞吐、達標有效吞吐、失敗率、單位成本與耗能。資源監控則用來解釋結果。
TTFT(首詞元時間)回答「多久開始有字」;端到端延遲回答「多久收到完整結果」。P95、P99 是第 95、99 百分位數,能呈現較慢請求的等待情形。量測起點也要一致:客戶端計時包含的網路時間,可能超出引擎內建指標範圍。vLLM 指標文件
| 指標 | 回答的問題 | 比較前要固定什麼 |
|---|---|---|
| GPU 使用率 | 採樣期間忙多久 | 工具、採樣方式 |
| TTFT、端到端 P95/P99 | 慢請求等多久 | 計時邊界、輸入輸出長度 |
| 成功請求吞吐 | 每秒完成幾件 | 成功定義、失敗率 |
| 達標有效吞吐 | 每秒完成幾件合格且準時的工作 | 品質門檻、延遲目標 |
| 每次成功推論成本 | 完成一件花多少 | 同期間完整成本 |
| 每瓦有效產出 | 同功率能完成多少工作 | 整機量測、相同時間窗 |
成功回傳也可能答錯。驗收應另訂內容品質、格式與完整性門檻;逾時、重試、使用者取消的請求,須保留紀錄。每次成功推論成本可用「同期間總成本÷成功請求數」,並另列達標請求成本,避免兩種分母混用。
重試的計數單位也要先約定。建議讓同一筆使用者任務保留原始識別碼,分開記錄首次送出、各次重試與最終完成時間。成本計入所有嘗試,完成量則依原始任務去重;若三次嘗試才取得一份合格答案,驗收表應呈現一件完成任務及三次運算紀錄,避免重試增加帳面產出。
能源比較可用「有效輸出詞元÷總耗電量」,單位標示為詞元/Wh(瓦時);或以有效詞元/秒除以平均瓦數。只寫詞元/瓦卻漏掉時間,無法公平比較。這也延續AI OCR 成本與品質應合併評估的原則:輸出更多,仍要確認能用多少。
台灣團隊如何設計可比較的採購測試?
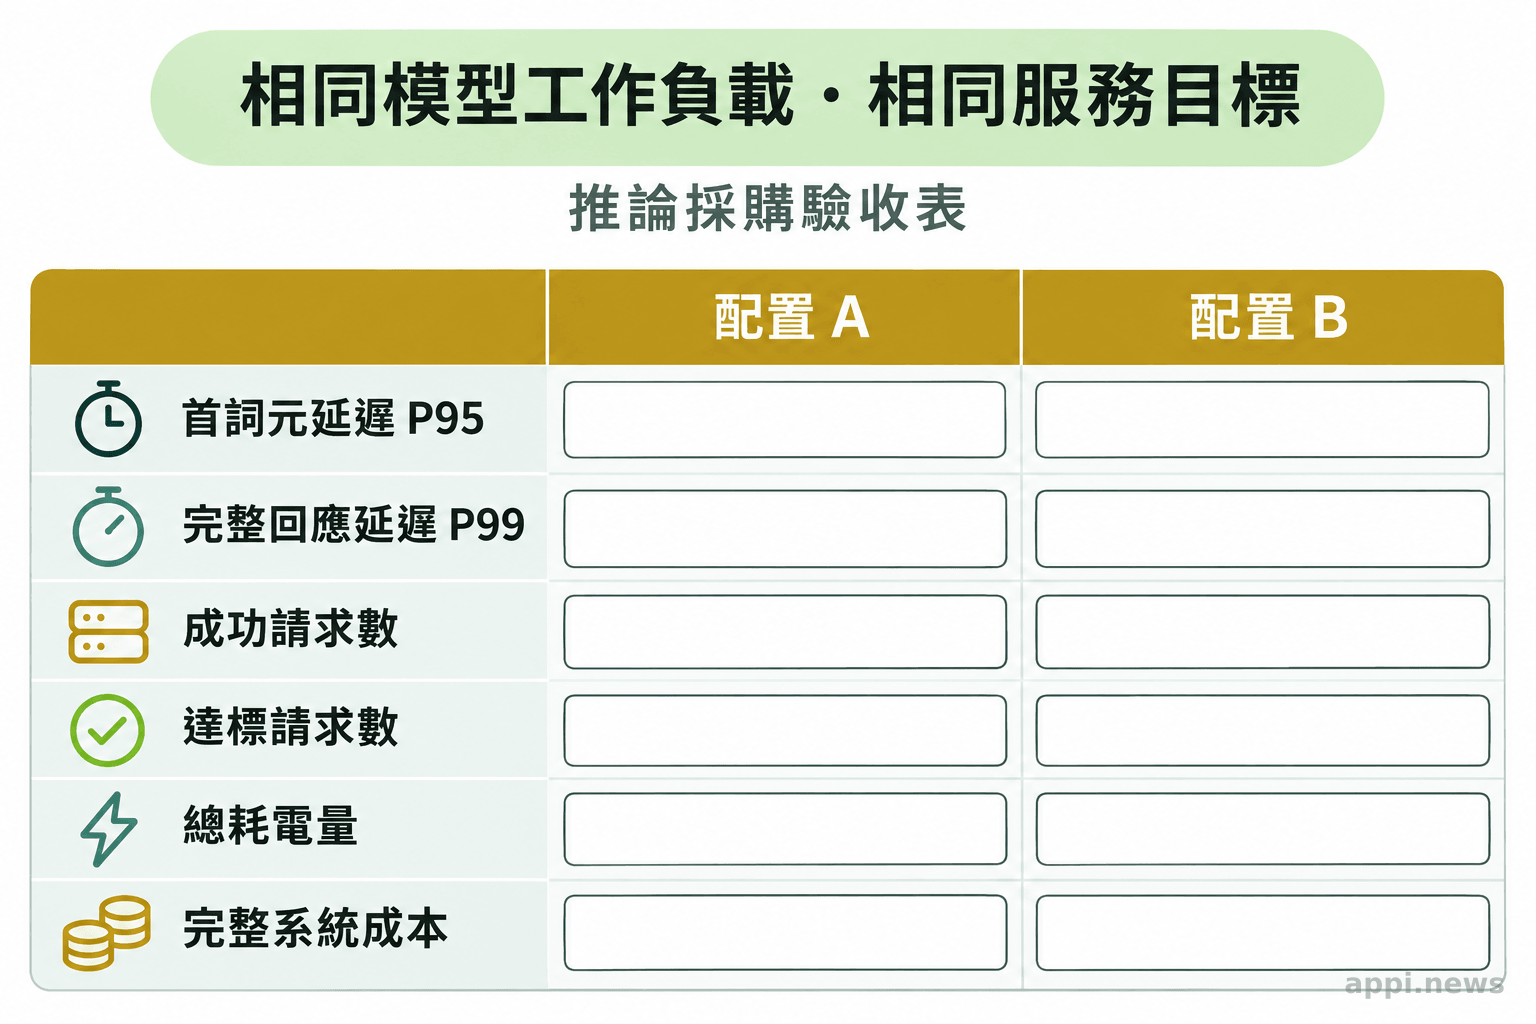
用同一批代表性請求與服務目標,測試不同配置在一般、尖峰及長時間流量下的表現,再以達標產出計算完整成本。
- 寫下驗收條件:指定可接受的首詞元時間、完整回應 P95/P99、失敗率與品質門檻。
- 固定工作負載:保留繁體中文輸入、長短提示比例、輸出長度、併發量及代理多輪停頓。
- 鎖定配置:記錄模型、數值精度、GPU 數量、驅動與服務軟體版本;分測冷快取、熱快取。
- 測完整流程:涵蓋前處理、網路、排隊與尖峰,記錄每次逾時、重試及取消;依評分卡可先做至少八小時測試,再配合業務週期延長。
- 算入完整成本:納入主機折舊或租費、儲存、網路、軟體、電力、冷卻與維運人力,以相同期間的成功及達標請求數分別計價。
準備測試集時,可將客服短問答、長文件摘要與多輪代理任務分組,依實際業務比例回放。除總表外,各組都應各列延遲與達標率,並記錄請求抵達時間。尖峰測試可重現集中抵達的情形,觀察佇列多久消化完;若只等前一筆完成才送下一筆,就無法檢查多人同時使用時的排隊表現。
冷、熱快取的測試條件應寫成可重做的操作:冷快取組先清除可重用的上下文資料,熱快取組先執行指定的暖機請求,再開始計時。兩組分別報告結果,並保存提示內容與執行順序,避免某個方案預先讀過全部測試資料,另一個方案卻從空白狀態起跑。
每輪結束後,應核對送出、完成、失敗、取消及仍在處理的數量;測試截止時未完成的請求也要列出。另保留逐筆延遲紀錄與樣本數,讓團隊能重算分位數。若測試期間更換設定,應另開一輪,讓效能差異能對應到明確的配置變動。
台灣團隊可直接拿實際帳單的幣別、電價與機房邊界重算,避免拿雲端單價和自建裸機價格相比。部署後持續監測相同指標;模型或版本變更時,重跑代表性流量,確認尖峰服務目標仍能達成。
- 先記錄所有失敗,再計算成功與達標產出。
- 同模型、同流量、同服務目標,才有可比較的採購數據。
- 驗收表應同時列出延遲分位數、達標有效吞吐與單位成本。
常見問題
Q1:GPU 使用率多少才理想?
沒有通用百分比。應先確認尖峰延遲、成功率與容量餘裕是否符合服務需求。
Q2:增加批次一定能改善回應速度嗎?
批次可提高吞吐,但等待湊批與排程干擾也可能增加延遲,須以實際流量測量。
Q3:SC26 的八小時測試能取代上線驗收嗎?
八小時是該框架的測試規則。多日任務、週期尖峰與故障恢復,仍須另外驗證。
參考來源
- WEKA(2026)。New Research Challenges GPU Utilization as Measure of Inference Infrastructure。WEKA
- McDowell S(2026)。The Inference Economics Scorecard。NAND Research/WEKA
- NVIDIA(無標示年份)。nvidia-smi — NVIDIA System Management Interface program。NVIDIA Documentation
- Kwon W, et al.(2023)。Efficient Memory Management for Large Language Model Serving with PagedAttention。SOSP ’23
- Agrawal A, et al.(2024)。Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve。OSDI ’24,USENIX
- vLLM contributors(無標示年份)。Metrics。vLLM Documentation


