
Hugging Face 在 2026 年 11 月公布 Harness adapters 測試:Qwen3.8-27B 搭配 pi 程式代理,Terminal-Bench 2.1 的 pass@1(每題嘗試一次的通過率)由約 39% 升至 55%,生成 token(詞元)由 2.9K 降至 1.5K。變動來自加上經過訓練的模型適配器。官方技術文章將這些結果定位於程式任務。
統計口徑要分開看:pi 模型卡把上述 token 數列為「雙方都成功任務的中位數」,非所有任務的平均值。依此計算,減幅約為(2.9−1.5)÷2.9=48%。這也不能直接當成帳單減幅。
這是供應方測試,涵蓋指定模型、框架與設定,並非獨立驗證。對已部署 AI agent(能呼叫工具執行任務的代理)的團隊,值得追問的是:同一個模型,為何還需要學習配合框架?
模型為什麼會受代理框架影響?
代理框架決定模型看到哪些指令、工具與歷史紀錄,也決定何時停止。這些差異會改變模型的下一步選擇。
模型產生文字與工具呼叫;harness(代理執行框架)接收呼叫、執行工具,再把結果送回模型。工具規格、錯誤訊息、上下文保留方式與步數上限,都構成模型實際工作的環境。框架角色可搭配程式代理的品質與成本評估方法理解。
為什麼提示詞相同,結果仍會不同?例如框架保留較多歷史紀錄,模型可能取得更多線索,也可能更快耗盡上下文容量。問題若出在資料遺漏或工具故障,先修整合;問題若是反覆搜尋、錯用工具,才值得測試模型行為適配。
Harness adapter 如何訓練?
Harness adapter 是針對框架與任務訓練的模型適配器。LoRA(低秩適配)以小型矩陣表示權重更新,訓練時凍結基礎模型,只更新新增參數。
Hugging Face 的 PEFT 技術文件說明:LoRA 保持原始權重凍結,訓練較小的更新矩陣,並可將適配權重合併回模型。LoRA 官方說明
載入時也有兩個角色。pi 模型卡的 PEFT(參數高效率微調套件)範例先載入基礎模型,再附加 pi 專用適配權重。因此,取得適配器檔案後,仍須準備對應的基礎模型與執行服務;框架端則要確認實際呼叫的模型已套用該權重,避免測到的仍是原始版本。載入範例
這次方法讓代理在目標框架內實際操作,再以 RL(強化學習,依任務回饋調整行為)訓練 LoRA。先剔除不適合訓練或驗證失敗的題目,再挑基礎模型有時成功、有時失敗的任務。驗證器若接受錯誤答案,模型可能學會取得分數,卻沒有完成工作。這與強化學習環境的相容與評測條件直接相關。
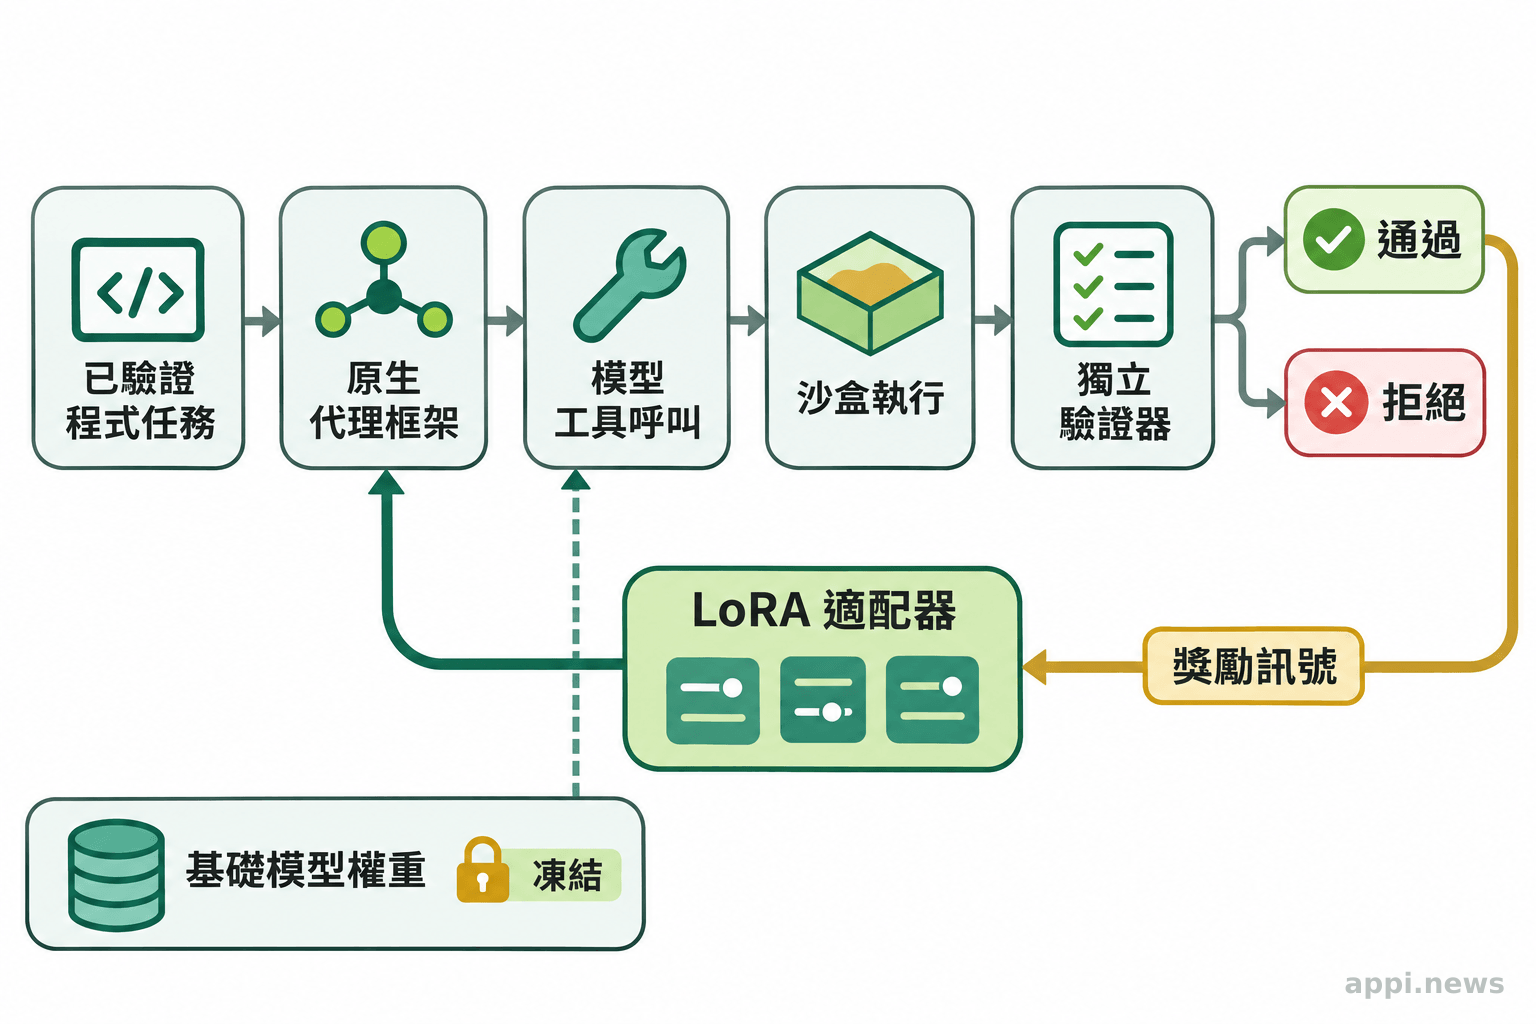
pi、Hermes、OpenCode 的案例改變了哪一步?
三組案例呈現的改善,是減少無效探索並完成可驗證的修正。評估時應同時檢查任務成敗與執行軌跡。
pi 的 Ansible 案例要修正 human_to_bytes 函式。基礎模型持續搜尋與重跑程式片段,碰到 100 步上限;適配版找到函式、修改並測試,以 8 次工具呼叫完成。模型卡附有任務與軌跡。
Hermes Agent 處理 qutebrowser 的網址數字遞增問題時,必須保留百分比編碼。基礎模型反覆探查編碼模式,錯誤修改測試後耗盡預算;適配版修正相關邏輯並檢查情境,以 35 次工具呼叫通過。Hermes 模型卡也列出整體成功與退步的任務數。
OpenCode 的 flipt 案例則要新增設定檔驗證套件。基礎模型困在相依套件並重複命令;適配版完成結構描述、驗證器與測試,修正一處介面錯誤後,以 17 次工具呼叫通過。OpenCode 模型卡記錄了這段過程。
三者在 SWE-bench Pro(軟體修復基準)的 hard 51 子集,同框架、關閉 thinking(額外推理模式)的配對結果如下。
| 框架 | 基礎模型 pass@1 | 專用 adapter pass@1 | 比較範圍 |
|---|---|---|---|
| pi | 39.2% | 64.7% | 同框架的 51 題 |
| Hermes Agent | 29.4% | 43.1% | 同框架的 51 題 |
| OpenCode | 35.3% | 51.0% | 同框架的 51 題 |
來源為上述三張模型卡。每題一次嘗試、最多 100 步;框架處理歷史資訊的方式不同,這張表不能用來排名框架。樣本也小,分數上升仍需檢查失敗型態。
逐題看會多出另一層資訊:同一組軟體修復測試中,pi 新增解出 15 題、失去原本會解的 2 題;Hermes 是新增 10 題、失去 3 題;OpenCode 是新增 11 題、失去 3 題。總分增加仍伴隨部分任務退步。
團隊可依任務用途檢視這些交換:新增成功若集中在低頻工作,退步卻發生在每日必要流程,整體通過率就不足以決定上線。比較時宜保留每題的輸入、修改檔案、工具回應與最終驗收結果,才能判斷改善來自減少重複操作,還是略過了應做的檢查。
harness-hub 在 Hermes 模型卡明確說明:基礎模型與適配器始終使用相同設定;換成其他框架、推理強度或步數預算的成績,不能直接相比。
專用 adapter 與 super-adapter 怎麼選?
官方另把三個適配器合併為 super-adapter(跨框架合併適配器)。在合併評估中,pi 的 SWE-bench Pro 成績為專用版 64.0%、合併版 46.0%;Hermes 則為 43.1%、47.1%。合併版沒有在每種框架勝出。
這組比較只納入各次執行均完成評分的共同任務,所以 pi 的數字與上表略有差異。合併權重也曾用 Terminal-Bench 2.1 選擇,該基準帶有選擇偏差。只部署一種框架且關閉推理時,可先測專用版;多框架共用模型時,再衡量合併版是否值得。
token 變少,推論成本會降多少?
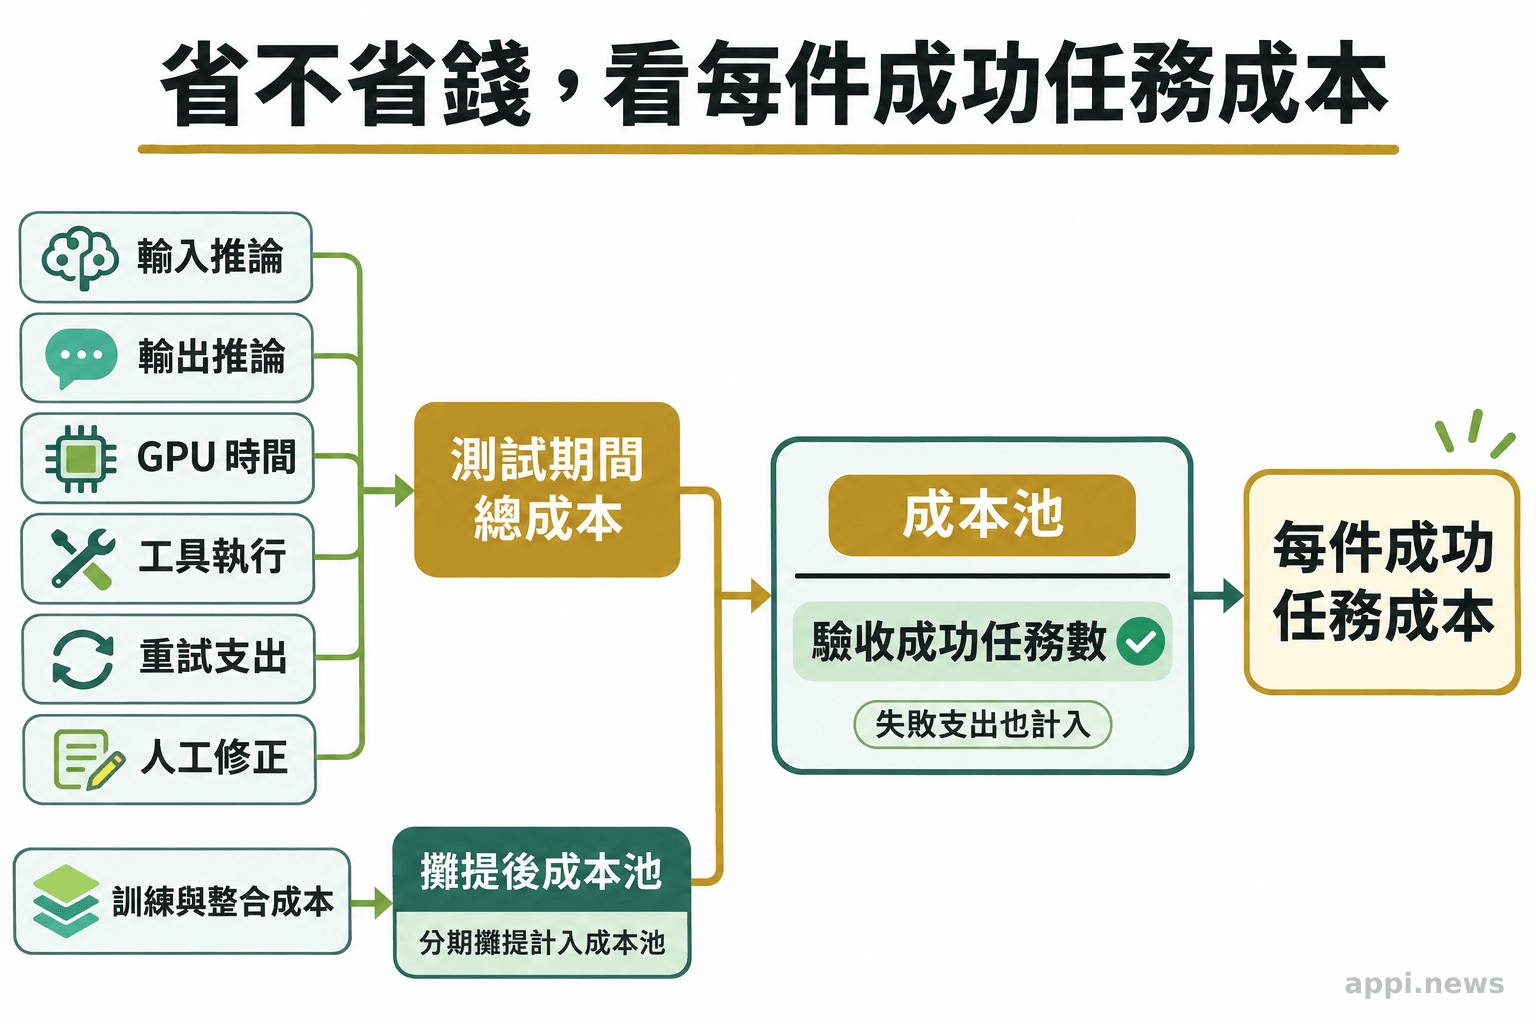
實際節省取決於計費方式、失敗重試與執行資源。應比較每件成功任務的總成本。
按 token 計費時,要分開算輸入、輸出與快取;模型生成較短,仍可能讀入很長的工具結果。自架服務則須記錄 GPU(圖形處理器)使用時間、等待時間與併發量。少呼叫幾次工具,也可能被一次昂貴的建置抵銷。
可用的核算式是:每件成功任務成本=測試期間全部推論、工具、重試與人工修正費用÷通過驗收件數。訓練與整合費另列,再依預期使用量攤提。失敗任務的支出必須留在分子。
台灣團隊還應檢查繁體中文需求、內部程式庫與權限限制。英文公開程式任務的改善,不能保證在公司環境重現。既有服務若無法載入自訂權重,導入就涉及推論服務遷移,需重新估算維運與供應商依賴。
部署前,如何判斷值得投入?
先挑高頻、可驗證的任務,固定環境做配對測試。驗收標準須在測試前定好。
驗證器可先用故意做錯的成果測試。例如設定檔驗證工作,準備缺必要欄位、欄位型別錯誤與合法設定三類輸入,確認前兩類被拒絕、最後一類可通過。程式修復則應檢查原有功能是否仍正常;代理若刪掉測試或修改通過條件,也要能被獨立驗收發現。這些是部署前可採用的檢查方法。
執行環境故障也要另記原因。Hermes 模型卡說明,終端基準有四題因環境建置失敗或驗證器逾時,未納入雙方比較。自有測試遇到類似情況,應保留排除紀錄並修復後重跑,讓兩個版本比較同一批可評分任務。評分範圍說明
整合驗收還可沿一件任務逐步追蹤:請求送到哪個服務、服務載入哪組權重、工具回應有無截斷,以及停止訊號是否被框架接受。模型已產生正確呼叫,框架卻解析失敗時,應先修正介面;否則重新訓練會把整合缺陷混進模型評估,也無法確認新增成本花在哪個環節。
- 留出任務集:選代表性工作,保留未參與訓練或選版的測試題,排除機密與個資外流。
- 固定基線:記錄模型、框架、工具版本、推理模式、步數、硬體與併發設定。
- 檢查驗證器:正確解應通過;空白、錯誤與不完整答案應失敗,避免錯誤回饋。
- 對照結果與費用:並列成功率、token、工具呼叫、延遲與帳單,逐件追查新增失敗。
- 保留回退版本:核對基礎模型與 adapter 授權、工具權限及服務支援,品質或總成本未改善就回退。
- 先修資料、工具與流程缺陷,再判斷是否需要模型適配。
- 模型、adapter 與框架版本要一起管理,升級後重新驗收。
- 擴大部署的依據是自有任務通過驗收,且總成本符合預算。
常見問題
Q1:Harness adapters 可以直接裝到任何模型嗎?
不行。這次發布的權重針對 Qwen3.8-27B;其他模型須確認架構與權重相容,不能只憑名稱載入。
Q2:使用前一定要重新訓練嗎?
符合模型與框架條件時,可先測已發布版本。自有任務差異大、測試效果不足時,再評估蒐集任務與訓練成本。
Q3:基準測試提高,能保證正式部署也提高嗎?
不能。正式環境的任務、工具與驗收要求不同。先在隔離環境跑同一批真實工作,確認新增成功沒有伴隨不可接受的錯誤。
參考來源
- Hugging Face(2026)。Introducing harness adapters: adapt your favorite model to your harness to improve performance and cost。Hugging Face Blog
- harness-hub(2026)。Qwen3.8-27B-pi-adapted。Hugging Face
- harness-hub(2026)。Qwen3.8-27B-hermes-adapted。Hugging Face
- harness-hub(2026)。Qwen3.8-27B-opencode-adapted。Hugging Face
- Hugging Face(無日期)。LoRA。PEFT Documentation


