
Daniel van Strien 的2026年11月 AI OCR 實測,用同一張 GPU(圖形處理器)測八種開放模型、850頁文件:RolmOCR 每千頁約0.51美元,LightOnOCR-3-0.8B 約0.095美元。便宜的推論,能讓掃描文件便宜地變成可用資料嗎?
OCR 是光學字元辨識,將頁面影像轉成文字。對有大量舊檔案、合約或掃描表單的團隊,真正要決定的是:轉出的內容能否搜尋、能否匯入系統,還要花多少時間修正。
百萬頁65至130美元,算了哪些費用?
這是特定設定下的 GPU 租用費估算,未包含人工校對、系統整合、儲存與治理,也未計入工作啟動的幾分鐘。
測試包含350頁自然史書籍、250頁1771年《大英百科全書》與250頁檔案文件;硬體為 Nvidia RTX PRO 6000,研究者採用每小時2.75美元的租價。影像先縮放至最長邊2048像素,再由各模型處理。
850頁來自三組來源,不能代表繁體中文、直排、手寫、表格或低品質掃描的各種組合;部分模型也未使用原本的完整版面處理流程。這是一位研究者的有限樣本比較,適合用來規劃試跑,尚不足以推算各企業的固定報價。
以公布的每千頁費用計算,0.095÷0.51約為18.6%,即降至約五分之一;這比較的是兩個模型與同一影像尺寸。65至130美元的區間則反映文件類型差異,兩者不能當成同一個精確單價。
台灣團隊拿這個數字估繁體中文文件前,應先留一批自家掃描頁做比對。若需求包括欄位匯入,可搭配文件抽取與流程成本的評估方式,先寫出交付物的驗收條件。
為什麼同一模型也能變便宜?
執行方式也會改變每頁成本:同時處理的頁數、影像尺寸、推論軟體與 GPU 選擇,都會影響硬體等待時間及完成速度。
研究者把 GLM-OCR 處理密集百科頁面的方式改良後,每千頁費用從1.57降至0.40美元,再換成新模型才降至0.13美元。第一步同時改了多個條件,不能把降幅全算在某一項優化上。
Daniel van Strien 的實測結論指出,改善模型的執行方式,帶來的節省超過後續更換模型的節省。(意譯,來源:上述成本實測)
根因是 GPU 是否持續有工作可做。固定一批跑完才送下一批,可能讓硬體等待;vLLM(模型推論服務軟體)配合持續送入頁面,能減少這類空檔。估價時因此要記錄整批完成時間,不能只量最快的一頁。
影像放大也有代價。實測中,原尺寸影像增加費用,卻未改善受測書頁的辨識品質;縮得太小又可能傷害密集文字。應保留原圖,另產生測試用影像,並固定尺寸後再比較模型。
辨識分數高,為何文件仍可能不能用?
整體分數可能掩蓋少數失敗頁與關鍵欄位錯誤,應另外檢查漏字、閱讀順序、表格對應、重複文字,以及空白頁是否憑空產生內容。
成本實測的人工基準只涵蓋282頁書頁,不能把字元準確度套到全部850頁;中位數也無法代表每頁品質。空白頁虛構文字、表單重複輸出,都需要另外攔下。
密集雙欄舊書可另設閱讀順序檢核:先由人工標出左欄、右欄與跨欄標題的順序,再逐段對照輸出。即使每個字都辨識正確,若左右欄交錯拼接,搜尋結果的上下文仍可能失去原意。試跑時應把字元錯誤與段落順序分開記錄,並保留原頁編號,讓校對者能回到影像定位。
錯誤攔截可以從輸入與輸出是否對得上開始。建議逐頁記錄處理狀態,核對送入頁數與回傳結果,將空白頁出現長文、相同段落反覆出現、必要欄位缺漏等情況送人工複查。這些規則只能篩出疑似異常,不能證明其餘頁面正確;複查時也要分辨原稿本來就有重複內容,避免把真實文字刪掉。
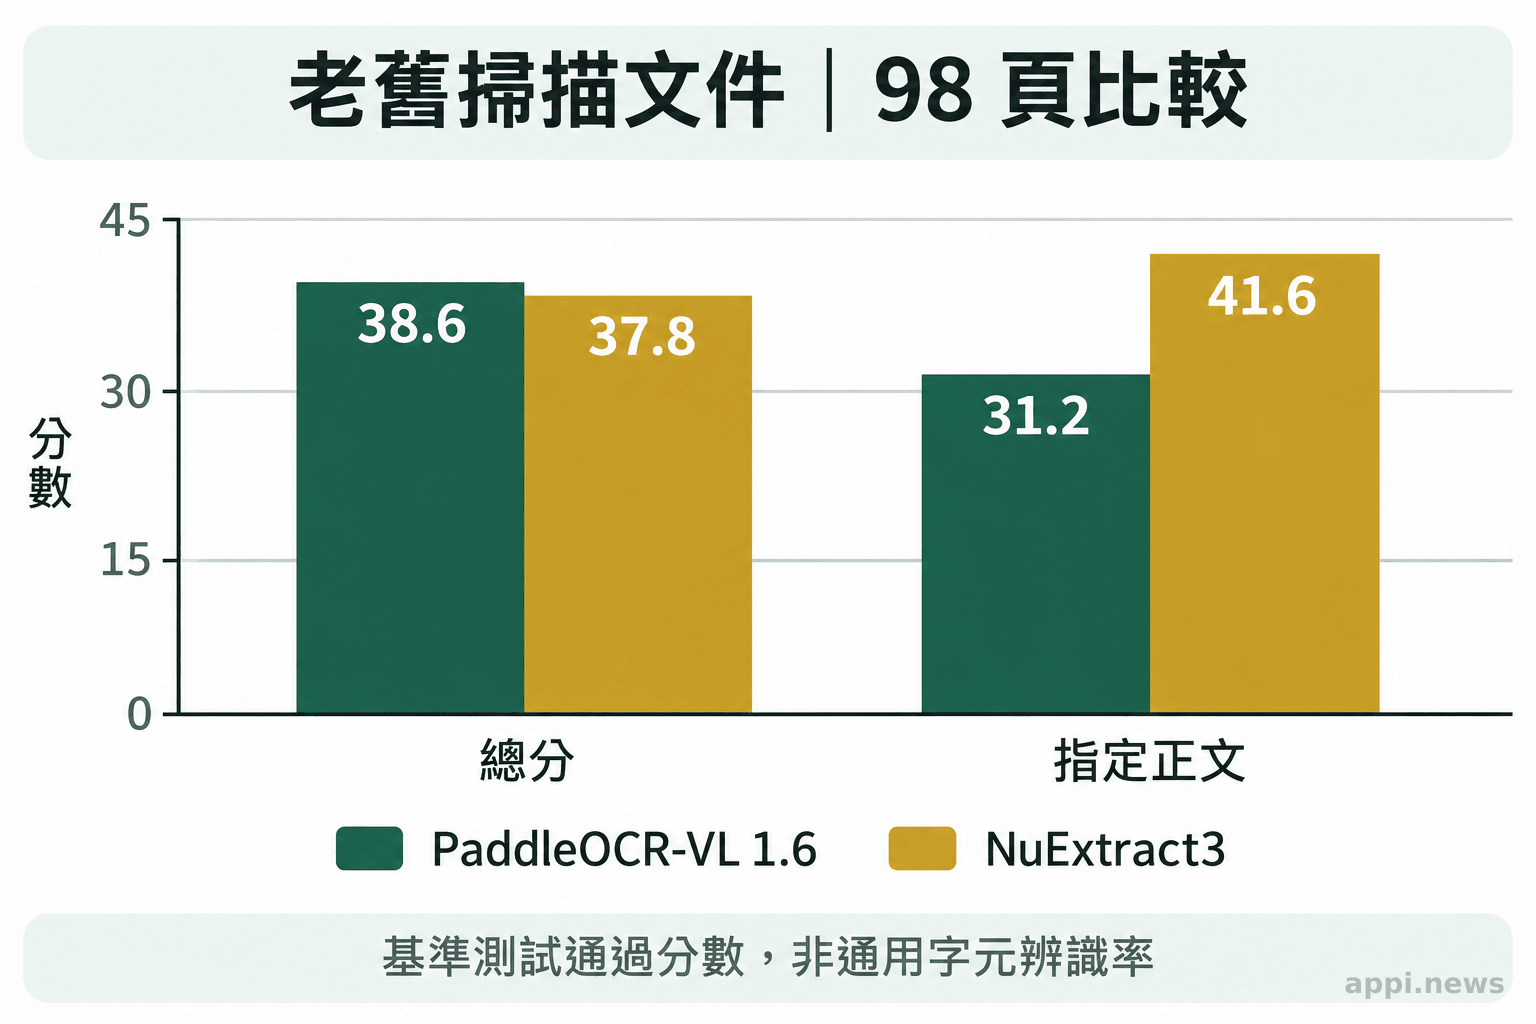
另一個案例更直接顯示「分數在獎勵什麼」。van Strien 在98頁老舊掃描文件的比較中,測試十種模型。PaddleOCR-VL 1.6 的總分38.6略高於 NuExtract3 的37.8;只看指定正文是否被讀出,則是31.2對41.6,順序反轉。
原因是總分也獎勵刪掉信頭、印章等內容。這對製作乾淨的訓練文字可能合理,但保存檔案的人可能正需要這些資訊。這些是測試通過比例,不能讀成一般文件的字元準確率。
Daniel van Strien 在老舊掃描評測中提醒,選哪種排名,取決於後續打算怎麼使用文字。(意譯,來源:上述老舊掃描比較)
| 使用目的 | 驗收時優先看什麼 | 需另外攔下的錯誤 |
|---|---|---|
| 全文搜尋 | 名稱、正文與頁碼能否回查 | 漏頁、漏段、關鍵詞誤讀 |
| 歷史檔案保存 | 信頭、印章、旁註是否保留 | 自動刪除或改寫原文 |
| 表單資料匯入 | 欄位值與來源位置是否對應 | 金額、小數點、欄列錯置 |
文件數位化要算每份可用資料的成本
把處理、校對與交付所需費用加總,再除以驗收合格的文件數,才能比較不同做法是否真的節省。
第三個案例是 van Strien 處理波士頓公共圖書館目錄卡的紀錄:453,000張卡片的重新辨識費用為39美元,但可搜尋的文字仍未補上圖書館需要的作者、書名與索書號等結構。他接著示範以 NuExtract3 輸出 JSON(可供系統讀取的結構化資料格式)。
「辨識完成」與「資料可以匯入」是兩個交付階段。先確認文件轉成 JSON 的欄位需求,再決定額外抽取與驗證工作。
建議採用這個計算式:每份可用文件成本=(影像整理+推論與重試+校對+整合+儲存與維護費用)÷驗收合格文件數。多頁文件要以整份驗收,避免只挑成功頁降低分母。
校對工時需實際計時,並分開記錄一般錯字與關鍵錯誤。姓名、金額或日期一旦錯誤,後續更正與追查可能比改一個標點費時;無法可靠估價時,先列成禁止自動通過的項目。
可把每份文件的校對時間拆成開啟原圖、定位問題、修改內容與再次驗收,再依團隊實際人力成本換算費用。即使文件最後沒有通過,已花掉的檢查與重跑時間仍應留在成本分子。比較模型時,建議使用同一批文件與相同驗收條件,避免較寬鬆的判定讓某個方案看起來較便宜。
估算整批預算時,可先分別計算單欄文字、雙欄舊書、表格與模糊掃描的合格率及平均校對時間,再按實際庫存的類型占比加權。少量難頁可能需要較長工時,應另列處理方式與費用,不能只用容易辨識的頁面外推。若決定暫不處理某類文件,也應列出未完成的數量與用途,避免把縮小交付範圍誤算為效率提升。
導入前怎麼用小樣本驗證?
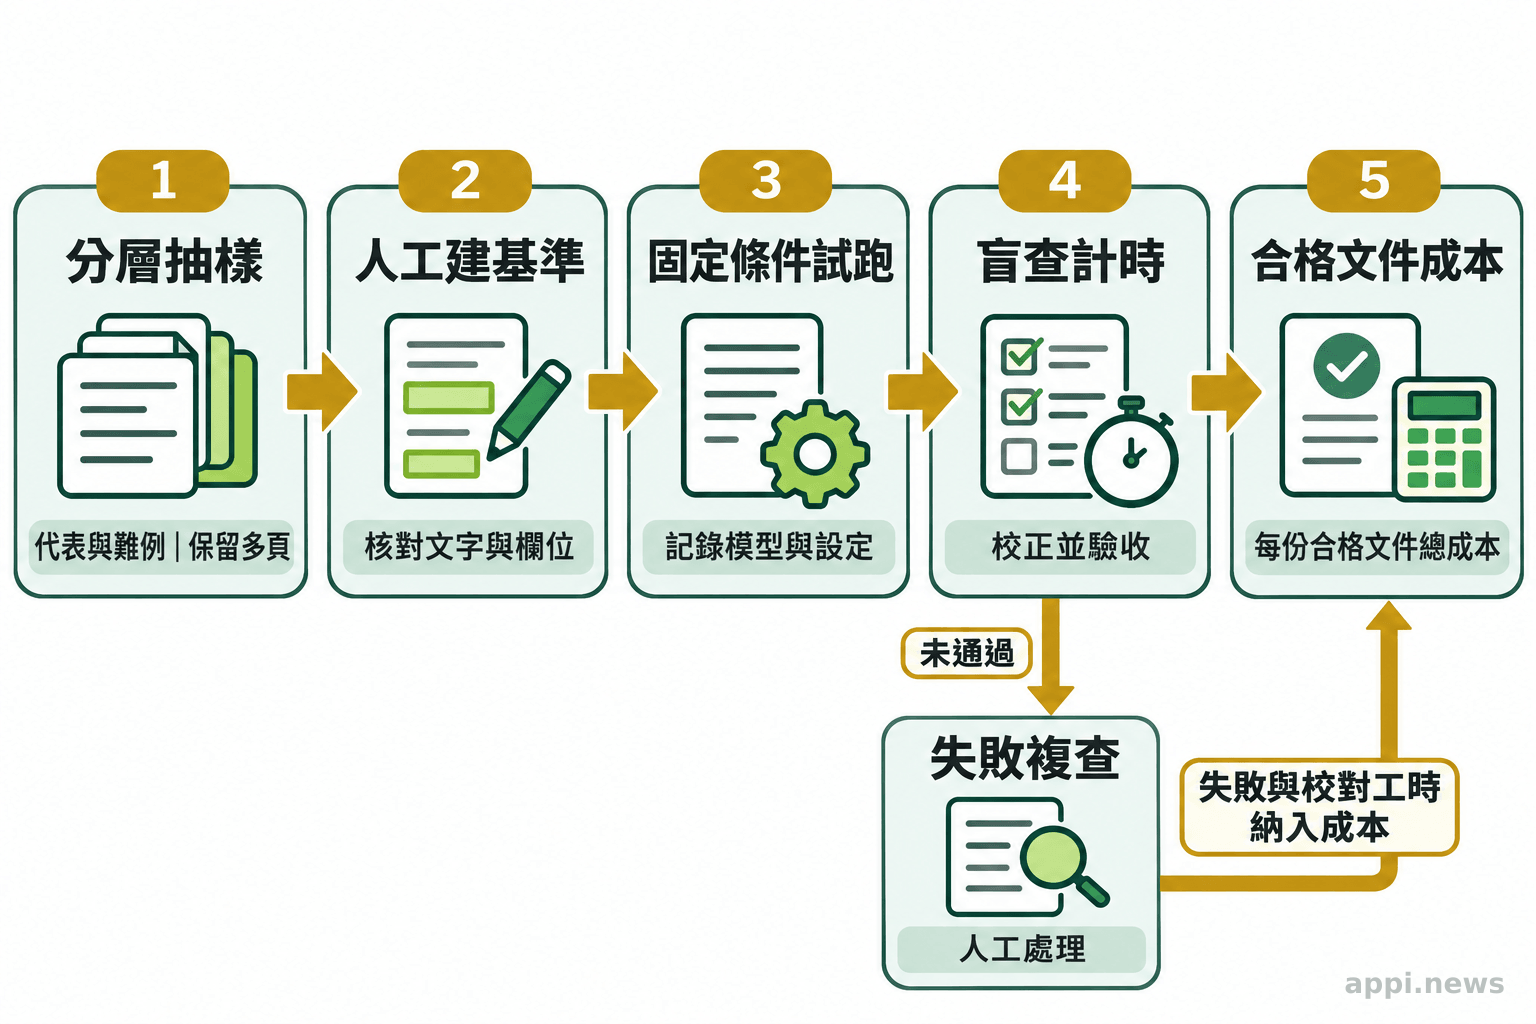
先抽取涵蓋常見與困難情況的文件,建立人工基準,再比較少數模型及設定,同時記錄合格率、費用與校對工時。
- 分層抽樣:涵蓋繁體中文、外文、直排、表格、模糊與空白頁;多頁文件保持完整。
- 建立基準:人工確認文字與必填欄位,約定哪些內容必須保留、哪些錯誤不能通過。
- 固定條件試跑:記錄模型版本、影像尺寸、硬體、軟體、提示設定及重試次數。
- 盲查與計時:對照原稿,記下修正分鐘數、漏頁率及關鍵欄位正確率,另列失敗樣本。
- 計算後再擴大:以合格文件估算總成本,保留一批未參與調整的文件做最後驗收。
部署也要列入試跑。LightOn 的模型說明標示 Apache 2.0 授權,可供研究與商用;免費取得權重仍需負擔運算與維護。外部服務與自有環境應分別確認資料傳輸、留存期限、存取權限、稽核及刪除方式。
若文件涉及孕婦、兒童、慢性病患者或長期服藥者等個人的健康紀錄,應先確認使用權限與去識別化需求。含個資、商業機密或受管制資訊的頁面,先完成資料處理安排,再送入測試。
- 百萬頁65至130美元是受測設定的 GPU 估算,完整預算需另計校對與整合。
- 驗收指標要對準交付目的,保留失敗頁,別只看總分。
- 先以自有文件量出合格率與修正工時,再決定處理規模。
常見問題
Q1:免費 AI OCR 模型可以直接商用嗎?
先查各模型授權。LightOnOCR-3-0.8B 標示 Apache 2.0,其他模型仍需個別確認,部署與資料使用條件也要一起評估。
Q2:每百萬頁低於130美元,能套到繁體中文嗎?
不能直接套用。原測試未建立繁體中文各種版面的代表性基準,應先以自家文件測量速度、錯誤及校對工時。
Q3:可以只抽查幾頁就讓整批文字自動匯入嗎?
抽查只能估計品質。應另設漏頁、重複輸出與關鍵欄位檢核,未通過的文件轉人工處理,並保留原稿供回查。
參考來源
- van Strien D.(2026). OCR with open models got about 5× cheaper in 18 months. Daniel van Strien
- van Strien D.(2026). Benchmarking OCR fairly is harder than it looks. Daniel van Strien
- van Strien D.(2026). How to turn catalogue card images into structured JSON with a 4B open model. Daniel van Strien
- LightOn AI.(2026). LightOnOCR-3-0.8B. Hugging Face


