
OpenAI 在官方工程文章指出,程式代理 Codex 帶動並行開發後,舊有大型程式碼儲存庫(monorepo)後端可靠度曾低於 90%,推送與抓取都承受壓力。團隊打造 Git 後端 Pando,稱中位數推送延遲降低近 80%。此為 OpenAI 自家經驗;但這裡要先問一個更前面的問題:瓶頸在物件傳輸、分支參照(ref)更新,還是持續整合(CI)抓取?
程式代理增加 Git 與 CI 負載。Pando 效能限於 OpenAI 自家規模;可參考Codex 雲端環境和安全掃描整合的流程設計。
OpenAI 為什麼重做 Git 後端:Codex 並行工作暴露了什麼瓶頸
Codex 帶來更多並行分支、推送、合併與持續整合(CI)抓取,令原有 Git 服務面臨寫入競爭和讀取尖峰。
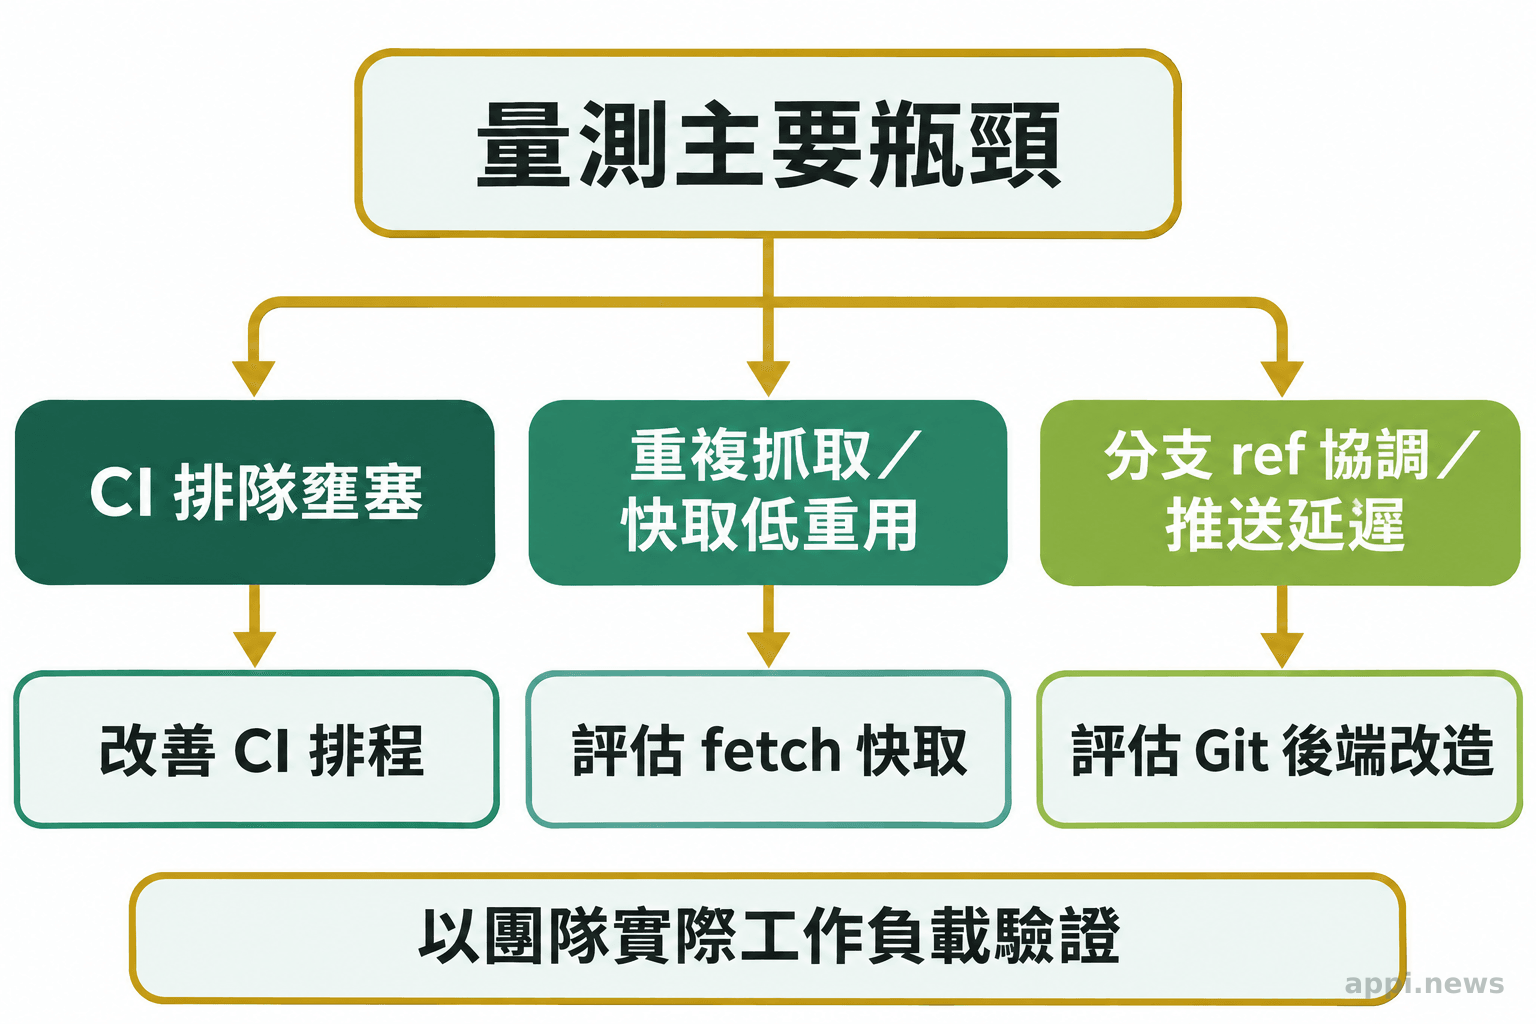
多個變更可能同時觸發 CI 抓取,分支共用協調點會造成寫入等待,重算封裝也增加負載。若瓶頸在 CI 排隊,換後端未必縮短交付時間。
Git 推送慢,問題可能出在分支參照(ref)、物件傳輸與讀取負載
commit 記錄版本,ref 指向分支或標籤,packfile 壓縮 Git 物件。
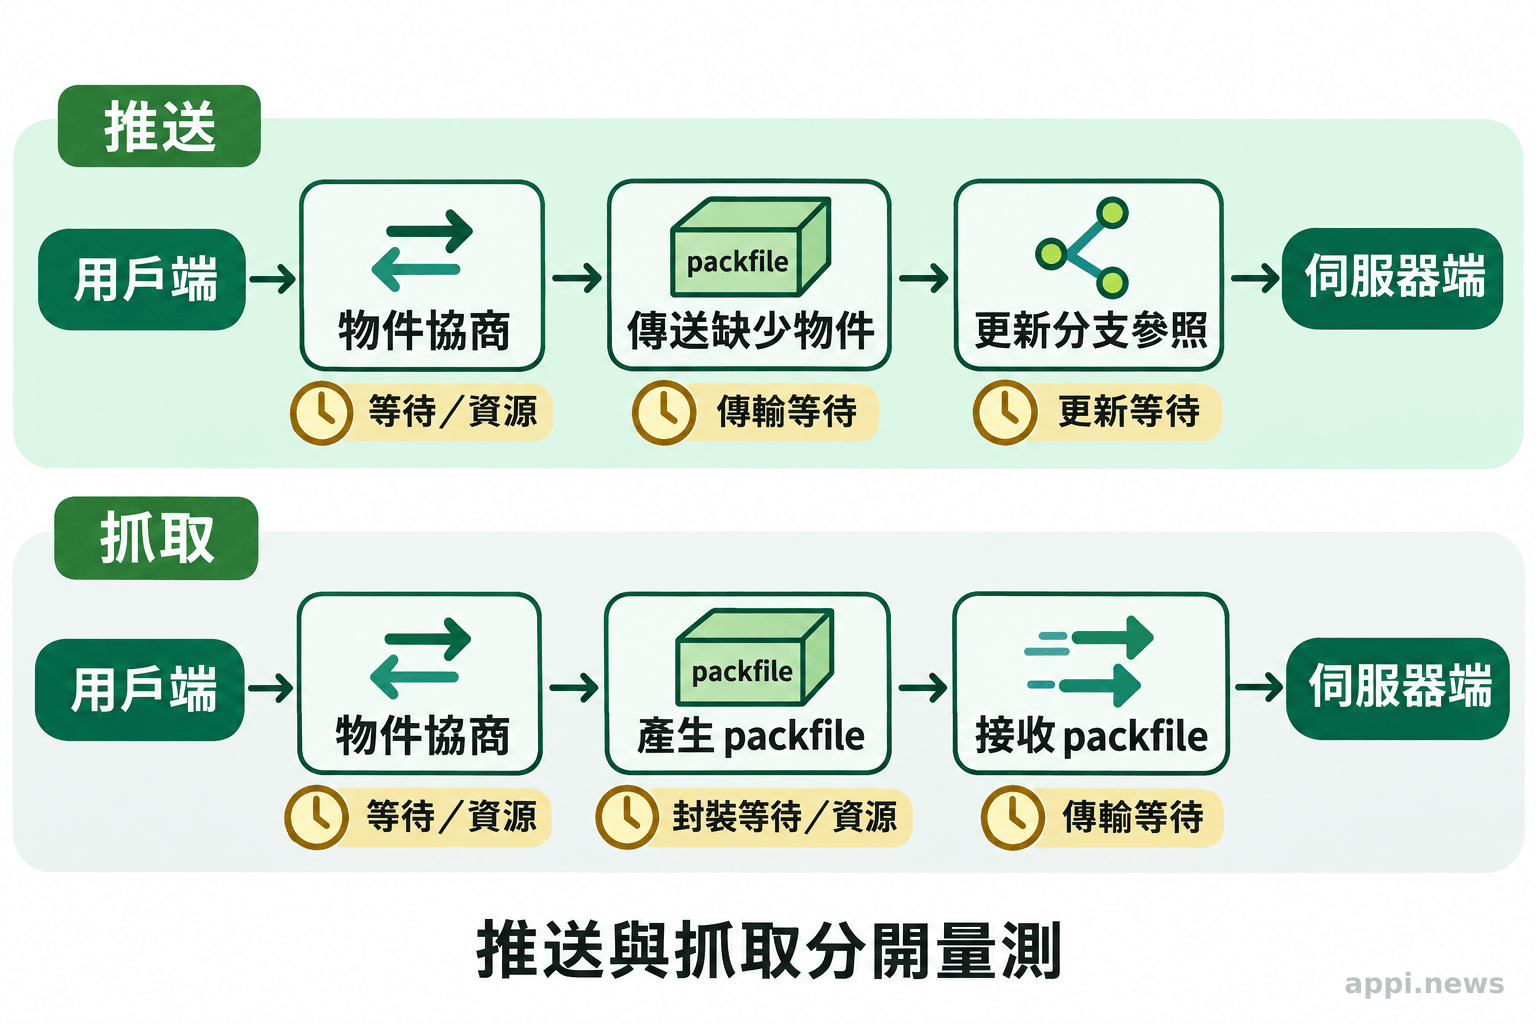
推送傳送物件並更新分支;fetch 取得用戶端缺少的資料,臨時生成 packfile 會耗用資源。Git pack 協定與封裝文件介紹傳輸與建立方式。分別記錄傳輸、分支等待和重複抓取時間。
GitHub 的大型 monorepo 案例記錄 Project Cyclops 改善推送。GitHub 自家 github/github 錯誤近零、處理能力增逾十倍;一名客戶取消重建計畫。不能視為通用基準。
Pando 怎麼讓不同分支並行更新,又重用讀取資料
Pando 分開協調各 ref 更新,並重用推送收到的 packfile,減少寫入競爭與重複封裝。
下表為 OpenAI 文章比較的模型;共享 manifest/WAL 僅是模擬設計。
| OpenAI 文中比較模型 | 寫入協調 | 讀取與一致性取捨 |
|---|---|---|
| 複本+多階段提交 | 多節點確認 ref 更新 | 保留複本狀態,需處理複寫與協調延遲 |
| OpenAI 模擬的共享 manifest/WAL | 更新透過共用 manifest 排序 | manifest 更新會競爭;複本若追讀不及,讀取可能延遲 |
| Pando | 不同 ref 分開更新 | 重用 packfile;跨 ref 不保證同一時間點快照 |
該模型以比較並交換(CAS)更新 manifest;並行修改時須重讀重試,索引落後會拖慢讀取。
Pando 保留推送產生的 packfile,讓 fetch 透過 packfile-uri 重用,並搭配快取與背景合併。OpenAI 稱快取命中率逾 99%;雲端 VM 測試可填滿 10 Gbps 網路,僅限該條件。
GitLab 的 Gitaly 團隊在自家 gitlab-org/gitlab 儲存庫,以 20 個並行淺層複製模擬 CI。快取基準快 3.6 倍,CPU 使用率由 100% 降至 40%,屬受控測試。
程式代理的另一種版本控制設計見Anthropic Scion 架構。
Pando 採因果一致性,但多分支讀取不保證同一時間點快照。依賴全庫快照的 CI 或發布工具須確認假設;OpenAI 以讀寫代理同步舊系統,再分批切流。
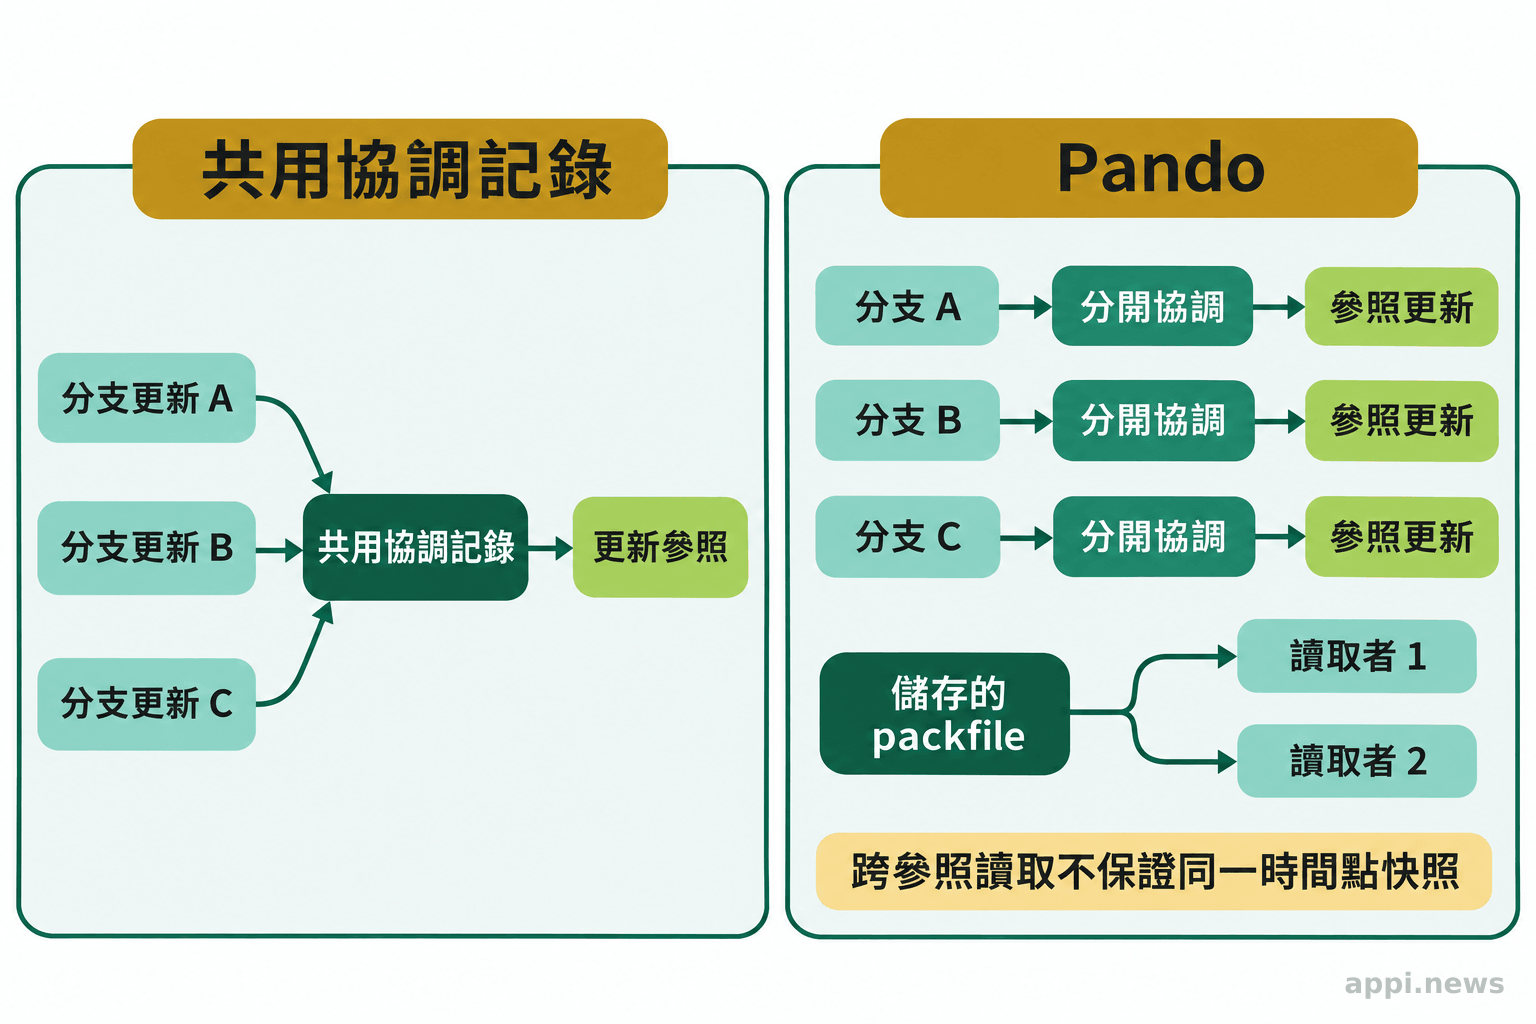
“Pando coordinates updates to each branch independently.”(Pando 分別協調各分支的更新。)(OpenAI 工程文章)
近 5 倍推送改善代表什麼,哪些結果不能直接外推
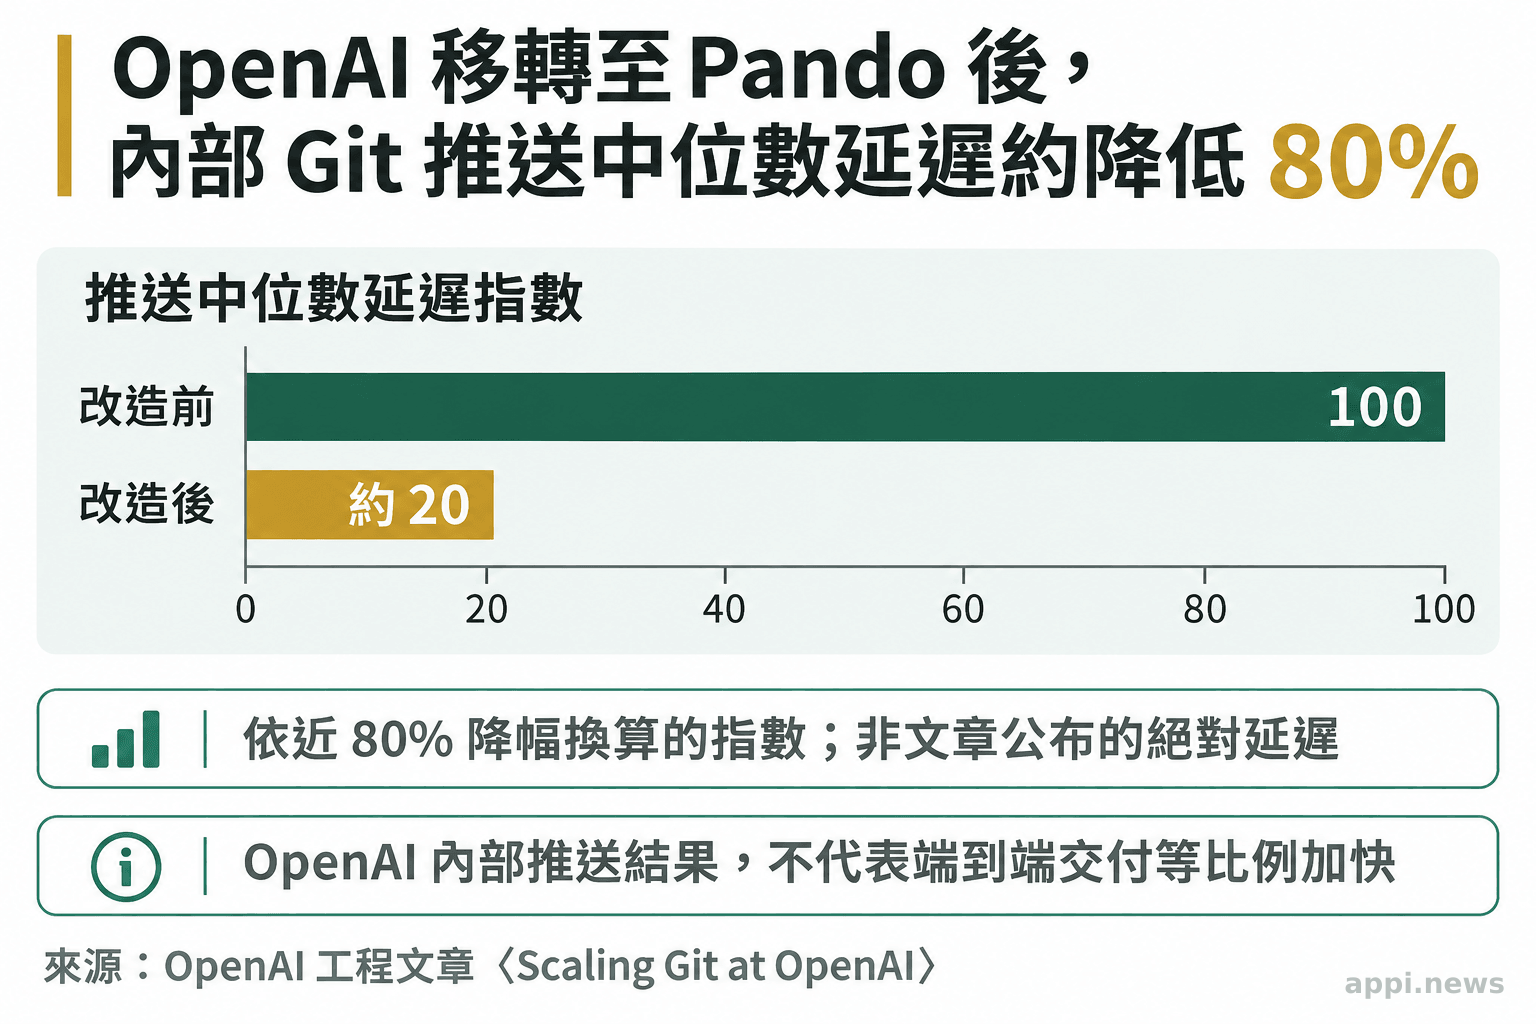
OpenAI 稱自家 monorepo 推送中位數延遲降近 80%、合併可靠度提高,每日服務近 1 PB,單小時傳送量曾逾 57 TB。這些是不同尺度的內部數據,中位數也不代表每次推送都快五倍。
OpenAI 以雲端虛擬機(VM)與 blob storage 模擬 1,000 個用戶端推送,並稱這是合成模型;團隊須以自家負載驗證。
OpenAI 以讀寫代理同步新舊服務後分批切流。團隊應盤點客戶端、API、webhook、程式庫下載、權限與憑證,設定推送成功率、抓取可見時間、CI 重跑率及回退演練等驗收條件;回切時也要核對新增提交是否同步完整。
“Switching to Pando improved merge reliability and reduced the latency of the median push by nearly 80%.”(切換至 Pando 後,合併可靠度提升,中位數推送延遲降低近 80%。)(OpenAI 工程文章) 推送變快不等於交付等比例加速,CI 排隊、測試與審查仍可能是主因。比較前後結果時,固定高峰工作量、提交大小和抓取頻率,分開記錄延遲、重試和排隊時間。
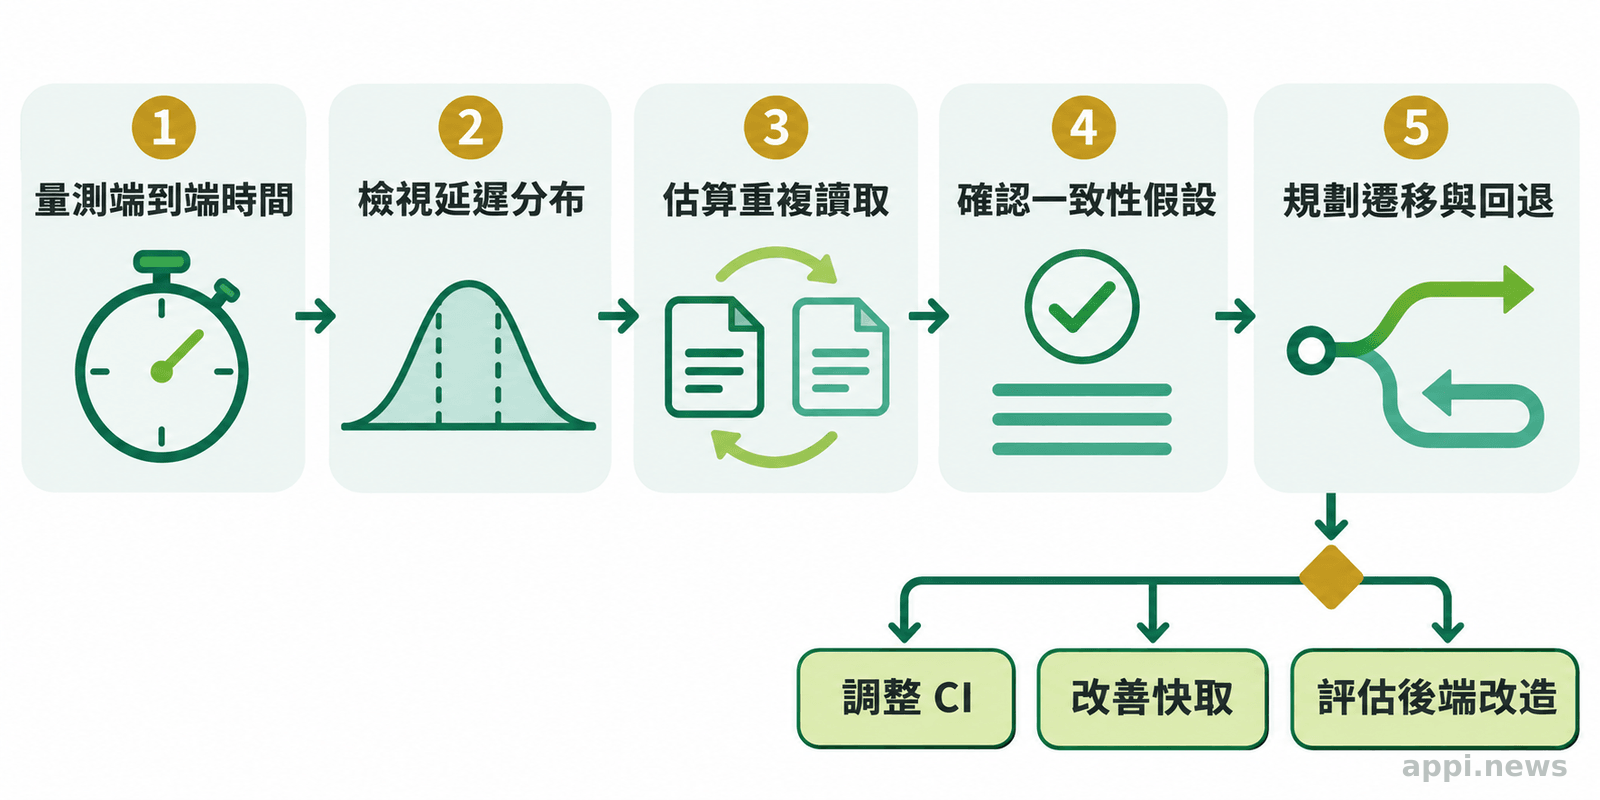
團隊評估 Git 後端時,先查這五項
以高峰工作負載定位瓶頸,再核對延遲、一致性、復原與遷移成本。
-
量端到端時間。 拆分推送至 CI 通過的伺服器、傳輸、排隊與測試時間。
-
看延遲分布。 記錄 push、fetch、clone 中位數與高百分位數。
-
估重複讀取。 查 CI、開發環境、代理的重抓次數及快取命中率。
-
盤點一致性。 確認建置、發布是否要求多分支快照,並演練併發更新。
-
算遷移成本。 清點客戶端、憑證、webhook、API、鏡像與回退條件。
用近期高峰流程記錄資料,再決定擴充 CI、改善快取或評估改造。
- Pando 透過分支 ref 分開更新、重用 packfile,降低 OpenAI 自家並行工作下的寫入競爭與讀取成本。
- 多分支讀取不保證全庫同一時間點快照,先核對 CI、發布與自動化工具的假設。
- 近 5 倍改善、近 PB 日傳輸量與 10 Gbps 均是 OpenAI 內部結果,採用前應以自家負載量測。
常見問題:Pando 是否能直接部署?一般 Git 用戶需要更換客戶端嗎?
OpenAI 公開的是架構與內部部署經驗,未提供一般企業可直接下載的 Pando。團隊宜先量測現況:CI 排隊就調整排程,重複抓取就測試快取,確認推送受分支協調限制後再評估改造。
常見問題
Q1:Pando 是 Git 的替代品嗎?
Pando 是新的 Git 儲存庫後端,保留 Git 協定相容性,改造服務端處理推送、讀取與封裝的方式。
Q2:導入 Pando 一定要換 Git 用戶端嗎?
OpenAI 稱可沿用既有流程,但仍部署自家 Git 發行版並分階段遷移。
Q3:小型團隊需要重做 Git 後端嗎?
不一定。先查推送延遲與 CI 抓取;測試排隊就先調整排程。
參考來源
- Friel A, Blau T, Nyman T. (2026). Scaling Git at OpenAI. *OpenAI Engineering
- Git Project. (2026). gitprotocol-pack Documentation. *Git Reference Manual
- Git Project. (2026). git-pack-objects Documentation. *Git Reference Manual
- Arbeit S. (2021). Improving large monorepo performance on GitHub. *The GitHub Blog
- Vosmaer J. (2022). How we made Git fetch performance improvements in 2021, part 1. *GitLab Blog


