
OpenAI 報告了 Linux 核心研究的兩個階段數字:動態重現 1,724 個候選發現;在後續利用評估中,經變體分析後,948 個不同的本機權限提升漏洞有可工作的利用。這是 OpenAI 公布的研究結果,候選修補仍須審查,不能視為維護者已接受的正式版本。Linux 研究說明
候選發現、已重現漏洞、可利用性判定與可合併修補是不同狀態,團隊須逐階段檢查證據與責任人。
對已把掃描接上修補流程的團隊,VulnOps 管理模式如何分派告警與修補責任可作背景;本篇聚焦模型增加前端發現、重現和修補草案產量後,證據與操作邊界如何管理。
一、Linux 核心研究如何驗證 948 個本機權限提升漏洞?
流程先縮小稽核範圍,再以動態重現和人工檢查逐階段篩選。研究團隊先動態重現 1,724 個候選發現;後續利用評估經變體分析後,為 948 個不同的本機權限提升漏洞產生可工作的利用。
先選稽核目標,再提出候選
Linux 核心程式碼龐大,研究團隊先由 Scout 代理挑出低權限使用者可達且安全相關的區域,共 5,034 個稽核目標、約 280 萬行程式碼;Analyst 代理再分析並去重,產生 2,308 個候選發現。候選仍可能需要其他條件才能重現。
代理提出可能缺陷,仍未證明輸入可觸發或界定影響。每筆回報應保留程式位置、觸發前提、理由和驗證狀態,不能只依模型標示的嚴重度派工。
隔離重現,分開確認漏洞與可利用性
接著,代理在隔離虛擬機中執行最小重現測試。OpenAI 表示,測試使用 KASAN(Kernel Address Sanitizer,Linux 核心記憶體錯誤檢查工具),並依程式輸出和系統訊息反覆調整,直到重現或停止。1,724 個候選在此流程重現,約占四分之三;其他結果有些需要更高權限,或受競爭條件與時間限制。
重現只回答問題是否在指定條件下出現,還要評估它是否造成資訊洩漏或本機權限提升。後者是低權限使用者取得更高系統權限,與遠端免登入入侵不同。團隊在具標準發行版防護的虛擬機測試,並以變體分析合併重複結果;948 是不同漏洞數,不是成功利用嘗試總數。
候選修補仍要研究人員與維護者處理
OpenAI 描述的輸出包含根因分析、最小重現程式、候選修補和利用證明,研究人員還要檢查利用是否走對指定漏洞、修補是否完整,再依維護者流程回報。候選修補不是已被 Linux 維護者接受或部署的正式版本。OpenAI 也提到,早期測試曾有 20 個看似成功的利用實際上借用了另一個漏洞,後來才加入獨立檢查確認攻擊路徑。這說明「結果成功」與「按原假設成功」也要分開驗收。
「候選發現不等於已驗證漏洞。」(OpenAI Linux 研究說明(意譯))
二、AI 漏洞掃描結果,哪些能進入實際資安流程?
能進流程的結果,至少要有可重現證據、清楚的影響範圍和可審查的修補差異。模型分數或候選數量只能描述指定測試,不足以證明日常程式碼審查能達到相同成效。
Linux、Firefox 與工控研究各自說明什麼
Linux 案例由 OpenAI 研究人員執行:GPT-6 Cyber 分析候選、重現漏洞並開發利用。OpenAI 表示,研究團隊依 Linux 社群指引,已將 304 項關鍵發現及候選修補送交維護者,其餘仍在處理。這是廠商公布的特定研究結果,不能推成一般團隊的預期產量。
Firefox 案例同樣由 OpenAI 研究人員使用 GPT-6 Cyber。OpenAI 表示模型找出 81 個經 Mozilla 分類為高嚴重度的新漏洞,並提供重現測試和候選修補;Mozilla 收到通報後開始釋出修正。公告另稱,模型指出 30 個已知問題的嚴重程度高於原先評估,這是另一項結果,並非前述 81 個新漏洞的分類。GPT-6 Cyber 公告
Dragos 在 2026 年夏末受 OpenAI 委託,以 GPT-5.5 Cyber 與 GPT-5.6 Sol 進行七項探索性評估。報告記錄模型在電力工程軟體找到兩個未知漏洞;在模擬水管線網路測試中,評估者提供子網與網路存取,模型動態測試後使 MicroLogix PLC 停止回應。另一項 HMI 測試也造成 FTP 服務中斷。這些是特定測試環境下的結果,報告未提供基準比較或整體誤報率,不能視為 GPT-6 Cyber 或所有工控系統的效能數據。Dragos 工控研究報告 PDF
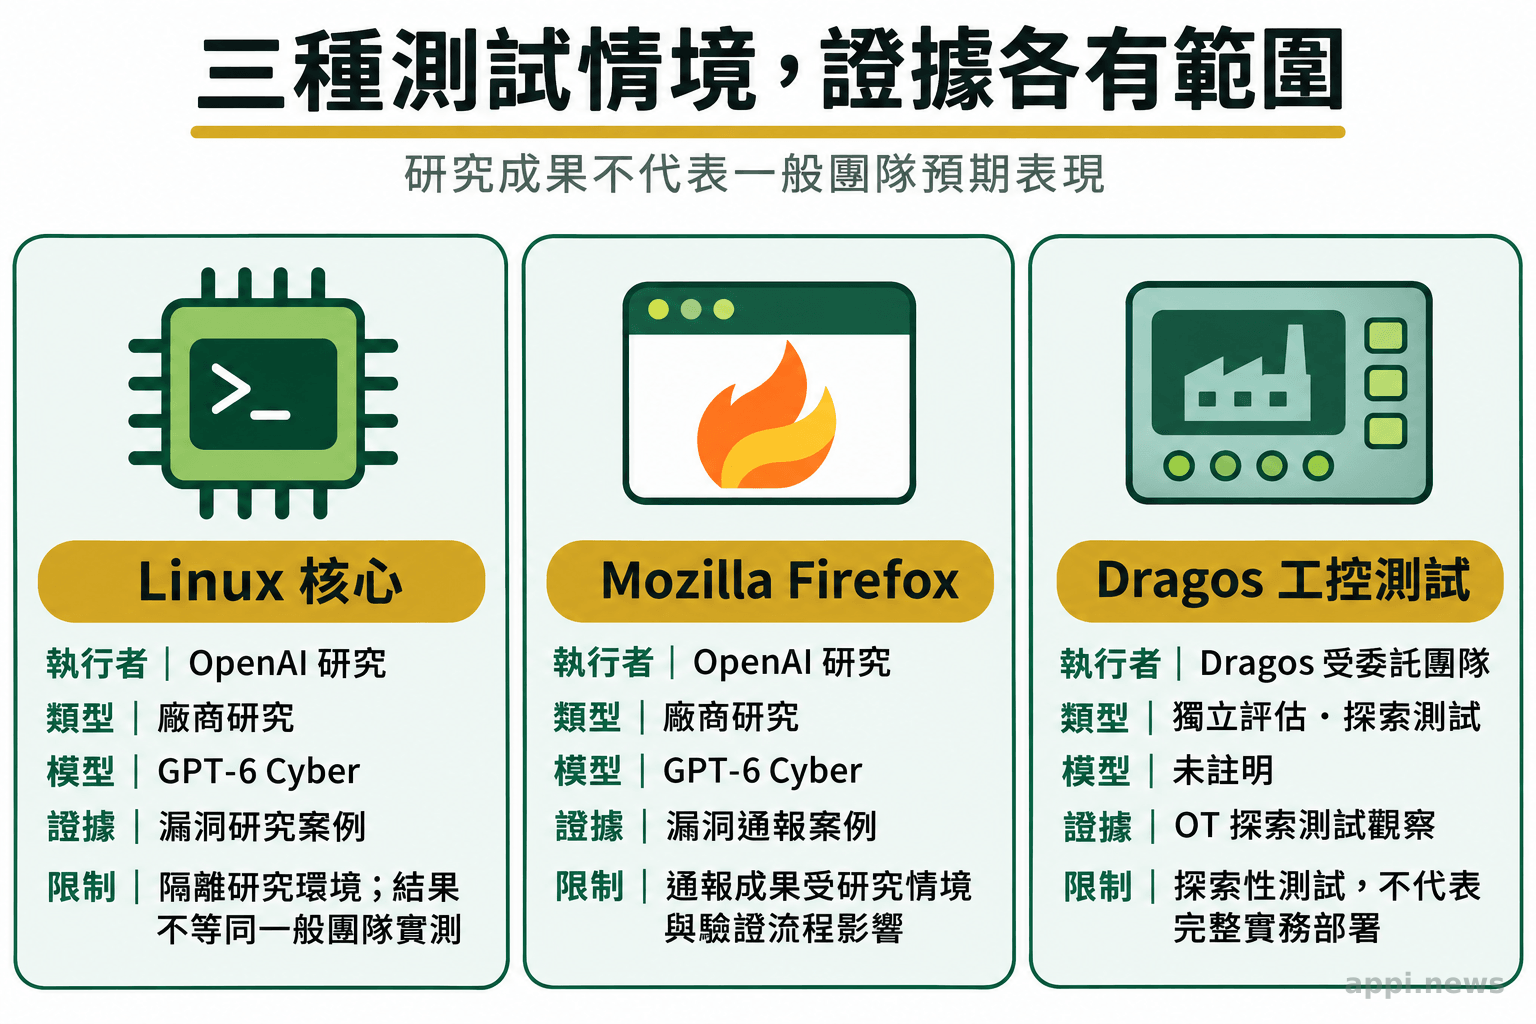
Linux 與 Firefox 是 OpenAI 公布的研究成果,Dragos 則是受委託的工控探索性評估。研究證據與產品取得是兩個問題。OpenAI 說明 GPT-6 Cyber 僅開放給獲准的 Daybreak Red 組織;台灣團隊應透過官方 Daybreak 申請與存取說明確認資格及模型核准流程。營運技術(OT)案例不能直接外推到一般軟體。
基準測試、研究展示與日常檢查不是同一件事
GPT-6 Cyber 公告稱,它在 ExploitGym 特定測試得分 48.5%,GPT-5.6 Cyber 為 32.1%;範圍遵循測試中,未加部署提示時有 99.93% 未利用範圍外服務,加提示後為 100%。這些是 OpenAI 指定條件的結果,不能證明模型在所有工作環境都遵守授權。團隊應先核對任務定義、隔離方式、工具和網路權限,再判斷分數是否適用。
成本也不能直接移植。Linux 研究花費約 121 萬美元,OpenAI 說明成本受模型、目標設定與工作流程影響,研究重點也非成本測量。這不是固定報價;企業估算還要納入程式庫準備、環境維護、人員審查、重掃和修補回歸測試。
三、如何限制 GPT-6 Cyber 的操作範圍與權限?
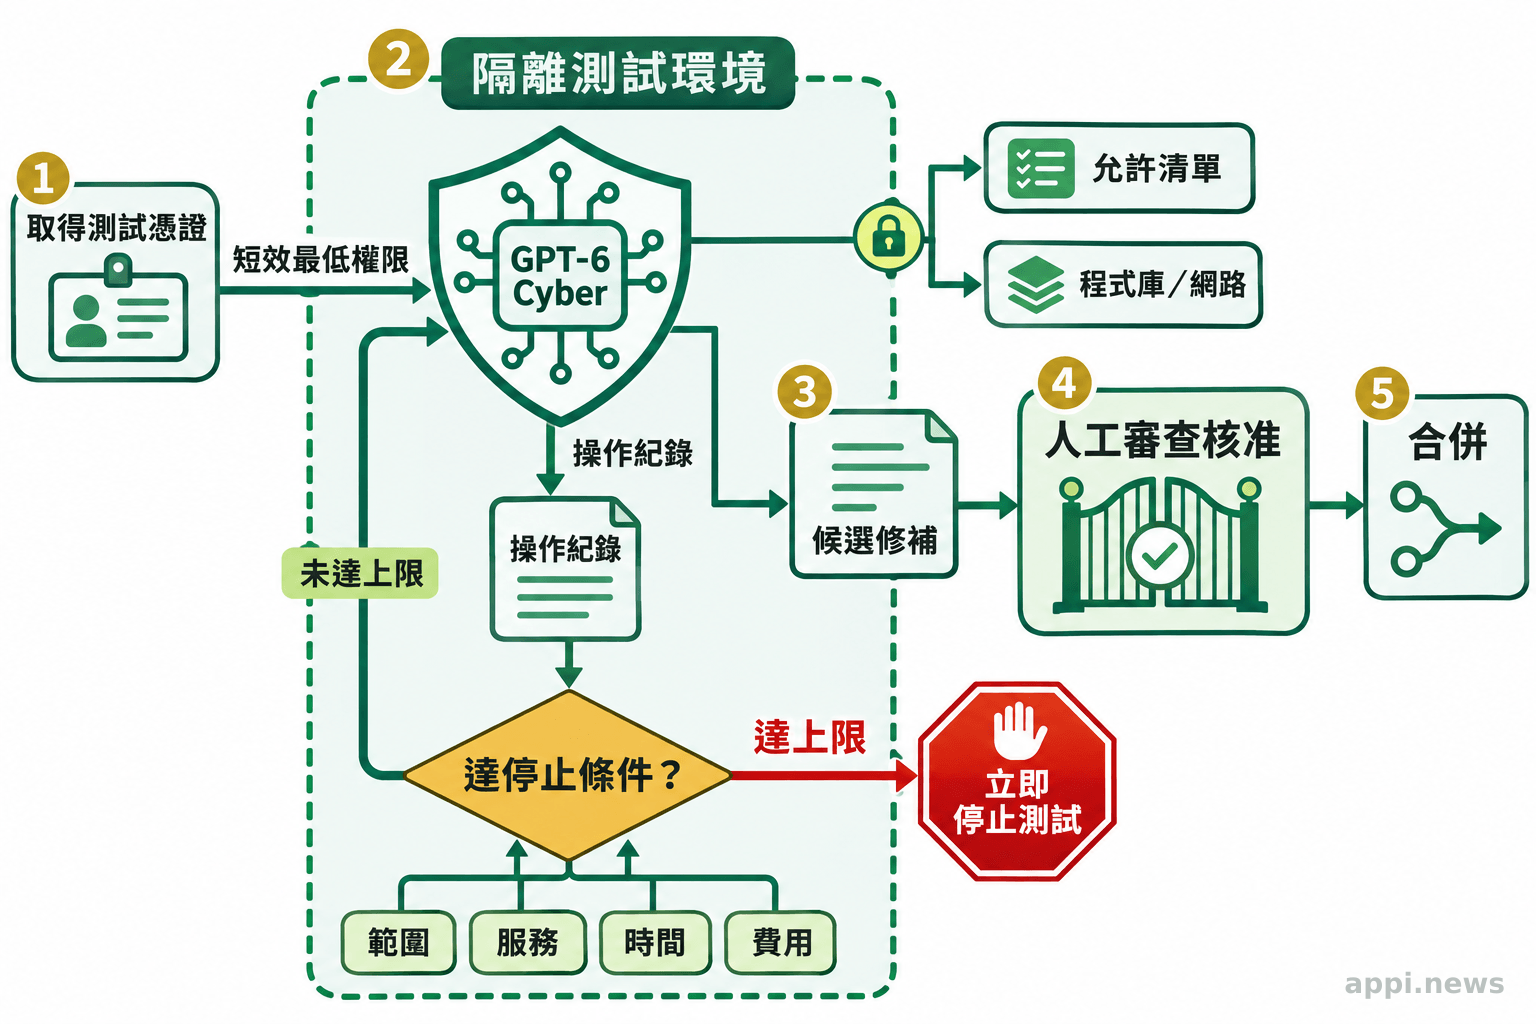
把授權寫成可執行的邊界,再用基礎設施限制模型能碰到的資源。提示詞可以說明目標,網路規則、容器或虛擬機、憑證與人工核准才負責限制實際影響範圍。
先限定目標、網路、憑證與動作
每次測試列明核准的程式庫、分支、測試網域與時段,排除正式服務、第三方和未授權資產。分開設定程式碼讀取與修補提交權限;初期可限只讀及一次性分支,不提供正式部署憑證。網路出口採允許清單,封鎖其他主機與服務。
設定停止條件:無進展、觸及範圍外資產、可能影響服務或達成本上限時即停止。保存提示、工具呼叫、檔案差異、測試輸出與核准紀錄,以便追查操作。OpenAI 也建議高風險工作採沙箱、操作審查與人工監督;範圍遵循測試不能取代這些控制。
用隔離和審查閘門處理錯誤
隔離環境使用可還原快照、測試資料和非正式憑證。核心、瀏覽器或韌體等高風險目標應在不連接正式系統的環境重現。修補差異經程式碼審查、原有測試、變體檢查與回歸測試後,再由指定人員核准合併;涉及權限、輸入或資源管理的修改,也要檢查其他路徑和相鄰功能。
Dragos 的 PLC 測試在模擬水管線網路中進行,評估者提供子網與網路存取;動態測試後 PLC 停止回應,報告另記錄 HMI 的 FTP 服務中斷。工控、醫療或生產系統應先用模擬器或離線複本測試,再由系統負責人核准連到實體設備的動作。
「模型仍需要專家檢查與修正。」(Dragos《What Frontier AI Models Can Actually Do in an xOT Environment》(意譯))
四、技術團隊如何開始測試並驗收修補?
從一個範圍清楚、可還原的非正式程式庫開始,先量測整條驗證與審查流程,再決定是否擴大。不要以找到多少候選漏洞作為唯一成功指標。
設定小規模試行與驗收表
先選熟悉、可建立測試環境且不含敏感正式資料的程式庫。以人工確認的漏洞或既有測試作基準,記錄重現證據、誤報排除方式和各階段成本。固定程式碼、模型輸入、執行環境與輸出版本,讓批次間可比較。
試行前逐項確認:
- 範圍:核准的程式庫、版本、測試環境與時段是否寫明?
- 權限:代理能讀寫哪些路徑?是否使用短效、最小權限憑證?
- 網路:允許連線的主機是否列成清單,其他出口是否封鎖?
- 停止與留痕:是否有時間、成本、異常行為的停止條件,並保存操作紀錄?
- 結果驗收:每筆漏洞是否附重現測試、影響範圍和根因?候選修補是否通過人工審查、回歸測試及變體檢查?
- 流程責任:誰負責分級、回報維護者、排程修補與核准合併,服務中斷時由誰處置?
只有當團隊能回答「哪些發現可重現、哪些修補可合併、成本落在哪裡、錯誤如何回復」,才有資料評估擴大範圍。若工具只增加大量回報,卻沒有足夠人力驗證、維護者回覆管道或修補驗收流程,瓶頸只會從發現轉移到分流。
這和逐條驗證 AI 漏洞回報相連:團隊須能重現問題,並把修補與責任人接入流程。SBOM 修補流程則補上軟體元件盤點。
常見問題
Q1:候選漏洞等於已確認漏洞嗎?
不等於。候選代表程式分析指出一個可能問題,還要確認觸發條件、在受控環境中重現,並判定影響。若無法重現,應保留未確認狀態,不能以模型的信心分數代替證據。
Q2:AI 自動產生的修補程式能直接部署嗎?
不能只憑模型輸出部署。修補是候選差異,需經程式碼審查、測試、變體分析、回歸驗證及變更核准;確認沒有破壞相鄰功能後,再依團隊既有發布程序處理。
Q3:GPT-6 Cyber 現在任何團隊都能直接使用嗎?
GPT-6 Cyber 僅提供給獲准的 Daybreak Red 組織,且模型另須核准,申請不代表自動取得。台灣團隊可透過OpenAI Daybreak 官方說明查看資格,再向 OpenAI 確認地區與服務條件;取得核准後,依組織設定在 API 或 Codex 啟用。
- 把候選、重現、可利用性和候選修補分開記錄,避免把模型輸出直接當成漏洞定案。
- 用隔離環境、允許清單、最小權限、停止條件與人工審查限制代理的操作範圍。
- 小規模試行要同時計算驗證成本、錯誤處理時間、修補驗收與流程整合,不只看發現數量。
參考來源
- OpenAI (2026). *A thousand fewer paths to root
- OpenAI (2026). *GPT-6 Cyber: Advancing the frontier of aligned cybersecurity agents
- Hanson S, Jauhar S, Michaud-Soucy D. (2026). *What Frontier AI Models Can Actually Do in an xOT Environment: Analytical Findings from an ICS/OT Cybersecurity Exploration of GPT5.5-Cyber & GPT5.6 Sol*. Dragos, Inc


