
百度於 2026 年 11 月 5 日發布 ERNIE 5.5 Flash Base,提供 280B 總參數的 MoE 基座模型,每個 token 啟動 14B 參數。模型卡列有 FP8、BF16 權重,以及 SGLang、vLLM 部署範例。這些規格讓團隊能初步判斷工具鏈是否相容,但無法單靠啟動參數推估完整權重所需記憶體。
部署前還要核對 GPU 數量與記憶體、精度、模型分片、推論引擎版本,以及上下文長度和同時請求數。這些條件會影響載入方式、成本與服務表現,仍須以代表性工作負載實測。
ERNIE 5.5 Flash Base 是尚未經中後訓練的基座模型,須經調整與測試才能符合對話、工具呼叫及安全需求。
百度釋出 ERNIE 5.5 Flash Base,開放權重改變了什麼?
它提供預訓練權重供開發與部署;商用仍須依百度授權條款判斷。
開放權重只代表參數可取得。下載前須確認授權對商用、再散布與衍生模型的限制;若處理內部資料,也要設定輸入、日誌與微調資料的權限及保存期限。
可參照權限檢查清單盤點下載、端點與日誌權限;私有部署仍須管理資料生命週期。
基座模型不是完成指令微調的聊天產品
Base 尚未經中訓練或後訓練。若要固定格式、繁體中文術語、拒答或工具呼叫,須設計控制方式並以自家任務測試,載入成功不等於品質合格。
280B 總參數、14B 啟動參數,硬體需求怎麼估?
不代表。14B 是每個 token 啟動的參數;280B 完整權重仍須載入或分散,並預留執行記憶體。
ERNIE 採 MoE(混合專家)架構,每個 token 僅選部分專家計算,但完整權重仍需存放於一張或多張 GPU,另須預留框架、暫存及併發空間。
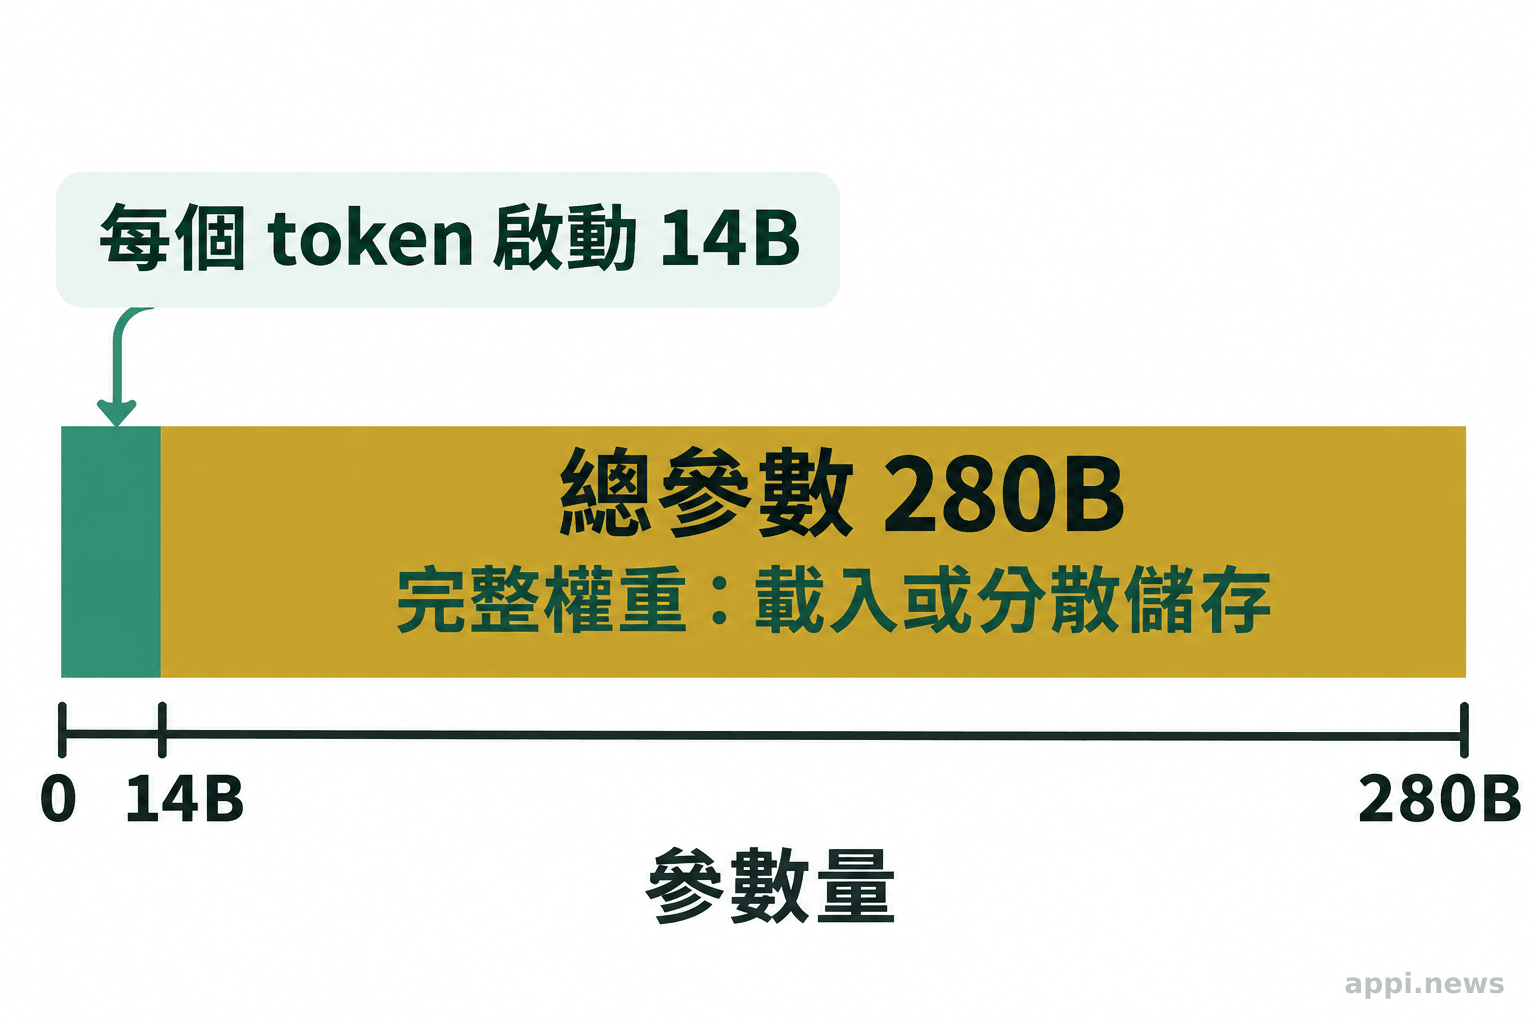
FP8 與 BF16 影響權重大小及運算支援,實際占用也受分片與上下文影響。模型卡列訓練最高 128K、微調及推論最高 1M token;硬體仍須實測。
KV cache(鍵值快取)也會隨上下文與併發增加。逐步加載並記錄 GPU、精度、平行配置、延遲、吞吐及記憶體峰值;成本可依資源拆解方法代入實測值。
ERNIE 5.5 Flash Base 可用哪些推論工具部署?
模型卡列出 Transformers、SGLang 與 vLLM 路徑,部署須核對版本與參數。
Transformers 可驗證載入與生成;SGLang、vLLM 可評估服務部署。按模型卡核對外掛、工具、驅動及 CUDA 版本,並確認各節點可讀取分片。
| 選項 | 適用檢查點 | 主要限制 |
|---|---|---|
| FP8 權重 | 確認硬體與推論框架支援 | 實際占用及輸出表現須測量 |
| BF16 權重 | 確認 GPU 記憶體與運算支援 | 權重容量較高,仍須預留快取空間 |
| Transformers | 權重載入與基本生成驗證 | 服務化與併發能力另行評估 |
| SGLang/vLLM | 服務部署、吞吐與併發測試 | 需核對 ERNIE 外掛、版本與啟動參數 |
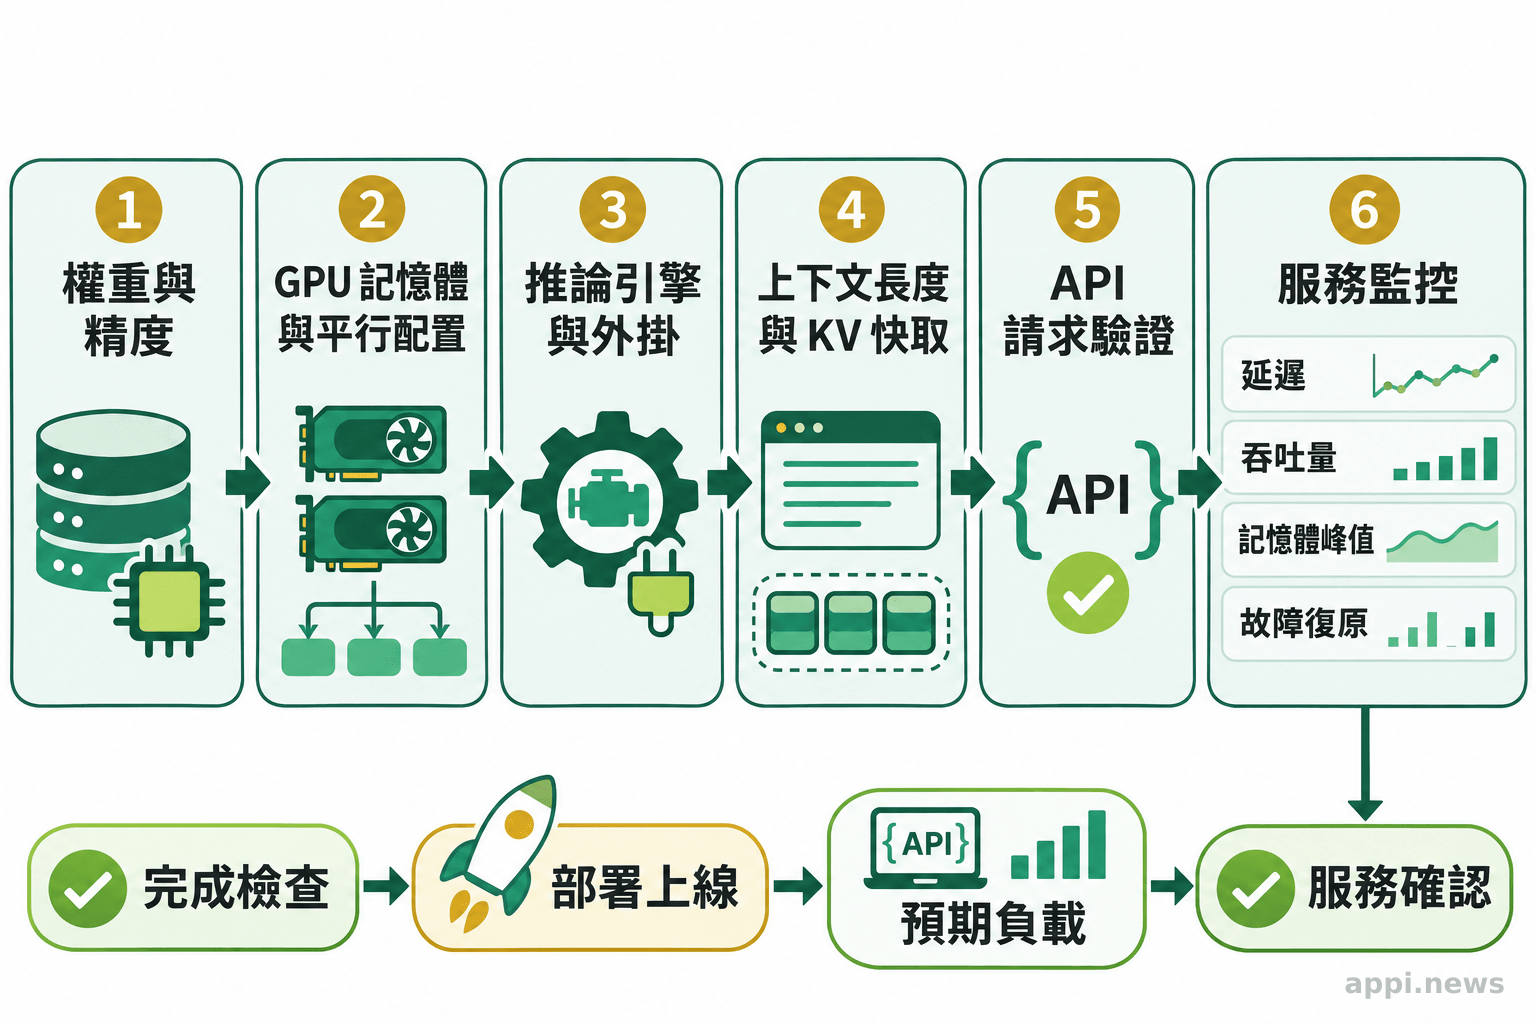
啟動後以 completions API 測試格式、錯誤與延遲,再增加上下文和併發;上線前記錄吞吐、記憶體峰值、復原及成本。
Impel 與 Indeed 的部署案例能提供哪些線索?
不能直接預測。案例的模型與架構不同,只能參考其微調、流量及服務設計,ERNIE 仍須另測。
Impel 以匿名互動資料透過 LoRA 微調 Meta Llama,並採用自動擴縮。AWS 記載人工評估中,個人化回覆由 73% 升至 86%、摘要由 70% 升至 83%、後續訊息由 59% 升至 92%。
Indeed Core AI 以 SageMaker 推論元件管理多模型。AWS 記載團隊一個月試驗逾 20 個模型,每日最多處理 300 萬次請求,正式服務累積逾 650 萬次。
兩案採用的模型及架構都不同,只能參考其微調、流量及服務設計,不能據此推定 ERNIE 在特定硬體與工作負載下的品質或成本。
「ERNIE-5.5-Flash-Base 位於預訓練結束點,可作為領域調整、指令微調與強化學習研究的起點。」(百度模型卡)
「Indeed 的推論元件讓團隊能在同一執行個體配置不同模型,並依需求調整模型副本。」(AWS 案例對 Indeed Core AI 架構的說明)
哪些團隊適合進一步測試,哪些條件要先補齊?
先盤點用途、可用 GPU 記憶體、推論工具鏈、授權與資料限制,再用代表性任務測試品質、延遲和成本;其中一項無法滿足,就先調整方案或暫緩導入。
ERNIE 5.5 Flash Base 適合有模型服務或微調能力、可安排多 GPU,且需自行控制資料流程的團隊。若只需要聊天助理,還須補上訓練與行為控制;資源不足可先在可控雲端驗證資料邊界。
- 寫下模型要處理的任務、輸入資料類型、必要輸出格式和不能接受的結果。
- 核對授權全文、GPU 記憶體、卡數、精度、工具版本及其模型支援說明。
- 以短上下文、低併發載入權重,確認模型可生成,再測長上下文與預期尖峰流量。
- 用一組代表性任務比較品質、首 token 延遲、吞吐、記憶體峰值、每次請求成本與維運負擔。
- 檢查輸入、日誌及微調資料權限;結果達到自訂門檻後,再評估微調或進入正式服務。
-
280B 是總參數規模,14B 是每 token 啟動參數,不能把它當成權重記憶體需求。
-
ERNIE 5.5 Flash Base 尚未經中後訓練,產品化前需評估指令微調、行為控制與安全測試。
-
SGLang、vLLM、精度、平行配置、上下文和 KV cache 都會影響實際部署表現。
-
Impel、Indeed 案例可供服務設計參考,不能代替 ERNIE 實測。
-
開放權重不代表無條件商用;正式使用前核對授權、資料存取與保存方式。
常見問題
Q1:ERNIE 5.5 Flash Base 是開源模型嗎?
百度提供權重及專屬授權,是否符合開源定義或可商用,須看授權全文。
Q2:14B 啟動參數需要多少 GPU 記憶體?
14B 是每 token 啟動參數,記憶體還取決於 280B 權重精度、分片、KV cache、上下文與併發。
Q3:ERNIE 5.5 Flash Base 可以直接當聊天機器人使用嗎?
它尚未經中訓練或後訓練,對話、工具呼叫與安全政策須另行調整及測試。
Q4:百度模型卡列出的部署指令能直接用在所有 GPU 嗎?
不能。須按工具版本、外掛、GPU 與參數配置,並在自家負載下測試。
參考來源
- Baidu ERNIE Team (2026). baidu/ERNIE-5.5-Flash-Base-BF16 · Hugging Face
- Nicholas Scozzafava, et al. (2025). Impel enhances automotive dealership customer experience with fine-tuned LLMs on Amazon SageMaker. *AWS Machine Learning Blog
- Ethan Handel, et al. (2024). How Indeed builds and deploys fine-tuned LLMs on Amazon SageMaker. *AWS Machine Learning Blog


