
2025 年,喬治亞州上訴法院在 Shahid v. Esaam 一案中,因原審命令引用虛構判例而撤銷命令、發回重開聽證,並對律師處以 2,500 美元罰款;法院未認定原審命令由誰撰寫。判決也指出律師提交的上訴書狀有多筆引文錯誤。這起案件顯示,格式完整的引文仍可能帶入錯誤。
對使用生成式 AI 的律師與組織來說,難點是來源能否找到、內容是否吻合、引用是否支持主張。CiteProof 主打把文件引用與公開紀錄對照,實際查核範圍仍待確認。
法院文件為什麼會漏掉虛構或錯誤引文?
校對拼字格式無法代替核對判例與法律命題。虛構案件、錯誤引文和不支持主張,屬不同問題。
案例顯示錯誤可以發生在不同位置
喬治亞州上訴法院在 Shahid v. Esaam 意見中指出,原審命令引用了兩個虛構判例;法院未認定由誰放入命令,並指出上訴書狀另有 11 筆引文被認為是虛構或與所述命題無關。法院撤銷原審命令、發回重開聽證,並對該律師處以 2,500 美元罰款。上訴法院意見書呈現的是多筆引文錯誤與裁判處置,不能推論單一假判例造成全部結果。
紐約南區聯邦法院 Mata v. Avianca 案中,律師提交 ChatGPT 生成的不存在判例和判決內容。法院裁定 5,000 美元罰款,並要求律師通知被錯誤指稱為作者的法官。外觀正式不能證明來源真實。法院制裁命令。
另有來源存在、作者與標題卻錯置的狀況。2025 年 Anthropic 訴訟的一份法院命令記載,Anthropic 專家 Ms. Chen 的聲明中有一條引註出現虛構標題與錯誤作者;Anthropic 律師表示,Claude.ai 曾協助格式化至少三條引註。法院認為人工查核未發現錯誤,並部分撤銷該專家聲明。法院命令。
為什麼人工逐筆查核容易留下缺口?
法律引文包含案名、法院、年份、頁碼與引用內容。校稿者可能確認案名卻漏看頁碼,也可能打開判決卻沒對照文件引文。文件愈長、引用愈分散,愈容易漏掉「來源是否支持主張」這一步。
自動查核可處理重複查找,讓法律工作者聚焦異常與法律判斷,簽署者仍須審閱。美國律師協會(ABA)Formal Opinion 512 指出,提交法院前應檢查 AI 分析與引用並修正錯誤,具體義務視適用規則而定。ABA 指引提供責任框架;AI 答案引用的來源核對則說明自動比對與人工把關。
CiteProof 如何查找法律文件中的引用?
依《The Register》報導,CiteProof 會從文件擷取判例或法條引文,再以公開法院紀錄進行直接查找,並把需要檢查的引用整理出來。這是媒體轉述產品方的功能說明,目前沒有獨立效能測試可量化其辨識率。
從文件辨識到來源查找
報導描述的流程是先辨識文件中的判例或法條,再以擷取的引用查詢公開紀錄。產品方表示,查核不使用大型語言模型,而採確定性查詢,讓結果回到可檢視的紀錄。
產品方稱引文會交由 CourtListener 查詢,只有抽出的引用字串離開其伺服器。這仍是公司自述,不能取代服務條款、保存政策與實際設定的確認;支援功能和費用應以採購時的書面資料為準。
查核結果至少要分出幾種狀態
組織可將以下狀態作為採購驗收的建議分類,確認工具能否區分「找到紀錄」、「查無結果」、「書目或引文不一致」與「無法確認」;這不是 CiteProof 已證實提供的輸出格式或分類能力。查無結果可能是資料未收錄、格式無法解析或拼字有誤,不能直接標成虛構判例。
《The Register》引述 CiteProof 發言人:「不能可靠地靠更多 AI 猜測來抓出 AI 幻覺。」這是產品方說法,不能代表各司法管轄區和引用格式均經獨立測試。功能與資料處理仍應核對報導及現行產品文件。
找到判例後,還有哪些法律問題要另行判斷?
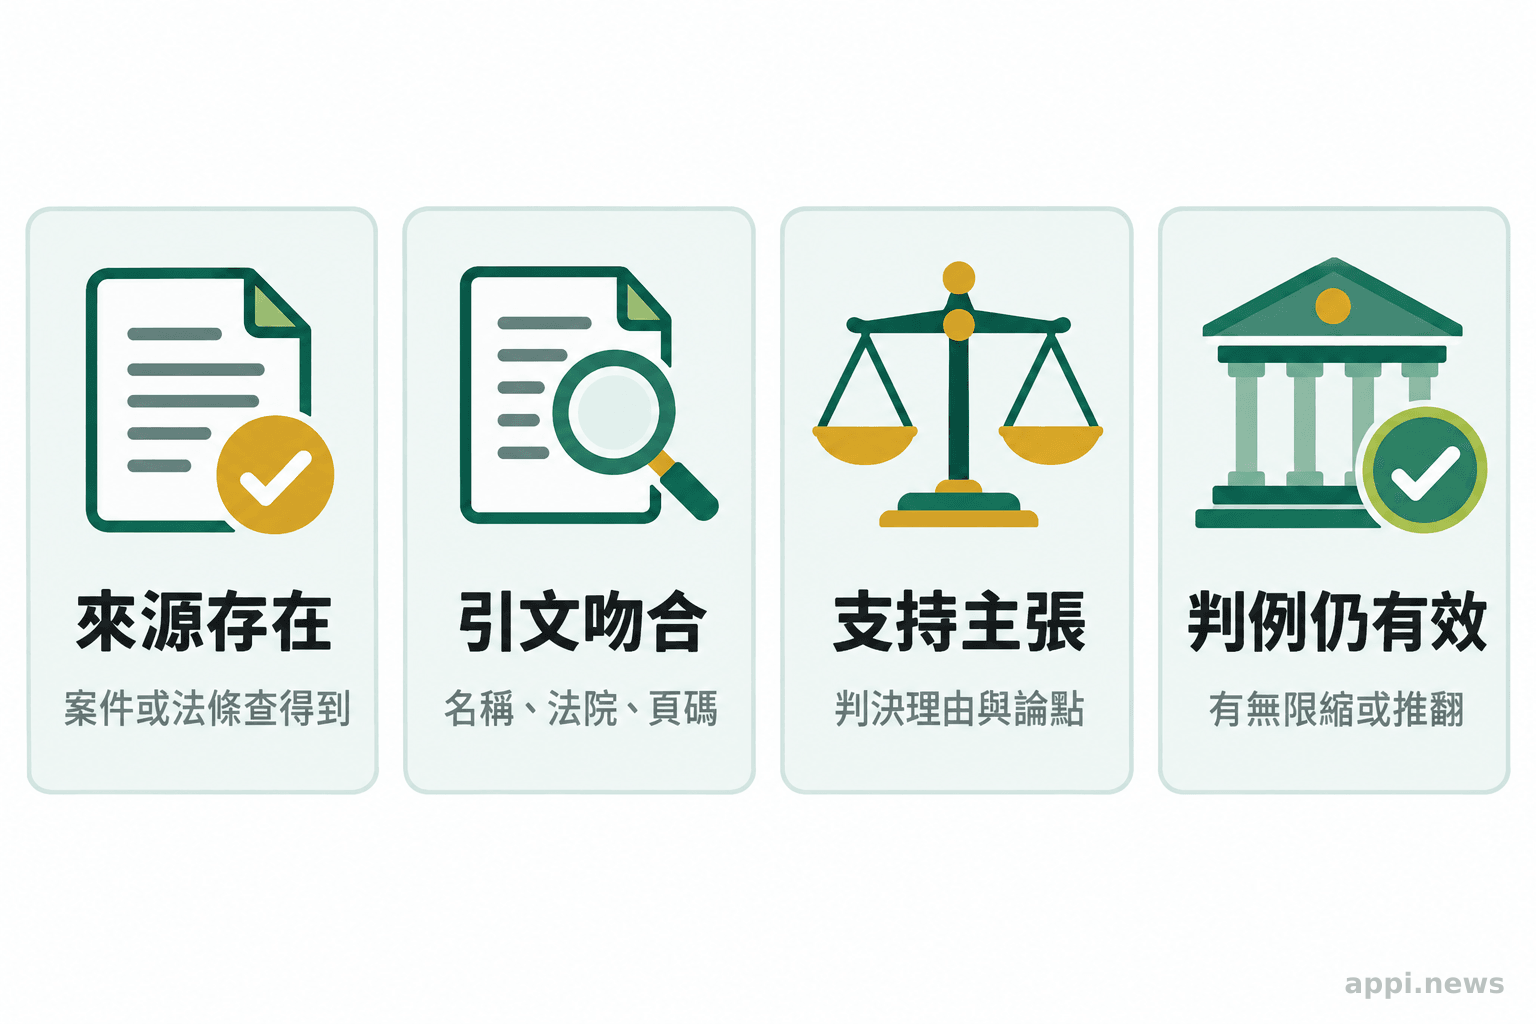
不代表。查到紀錄只支持「有一筆可能相符的來源」,不能單獨證明文件引文準確、判例支持該法律主張,或判例目前仍有效。
存在、對應、支持與效力是四個不同問題
查核可分四層:案件或法條是否存在;案名、法院和頁碼是否對應;判決是否支持主張;判例是否被後續裁判推翻或限縮。前兩層較易標準化,後兩層需要法律判斷。
工具回報「引用存在」後,仍應打開原判決,核對引用上下文、法院層級及文件主張。
公開資料庫的涵蓋範圍會影響「查無結果」
依報導,CiteProof 使用 CourtListener 等公開紀錄。資料庫的法院、年代、文件種類與更新時差都會影響結果;未公開、未索引或非美國裁判未必能找到。引用解析也可能受格式、OCR(光學字元辨識)錯誤和文件品質影響。
未找到時,先檢查擷取文字,再用法院網站或授權資料庫查找;「這次未取得紀錄」不能直接等同「案件不存在」。文件抽取工具也應評估錯誤回報和人工接手方式:可參考文件抽取工具導入前的準確度與流程成本評估,先確認抽取錯誤如何回報與人工接手。
如何將引用查核放進文件驗證流程?
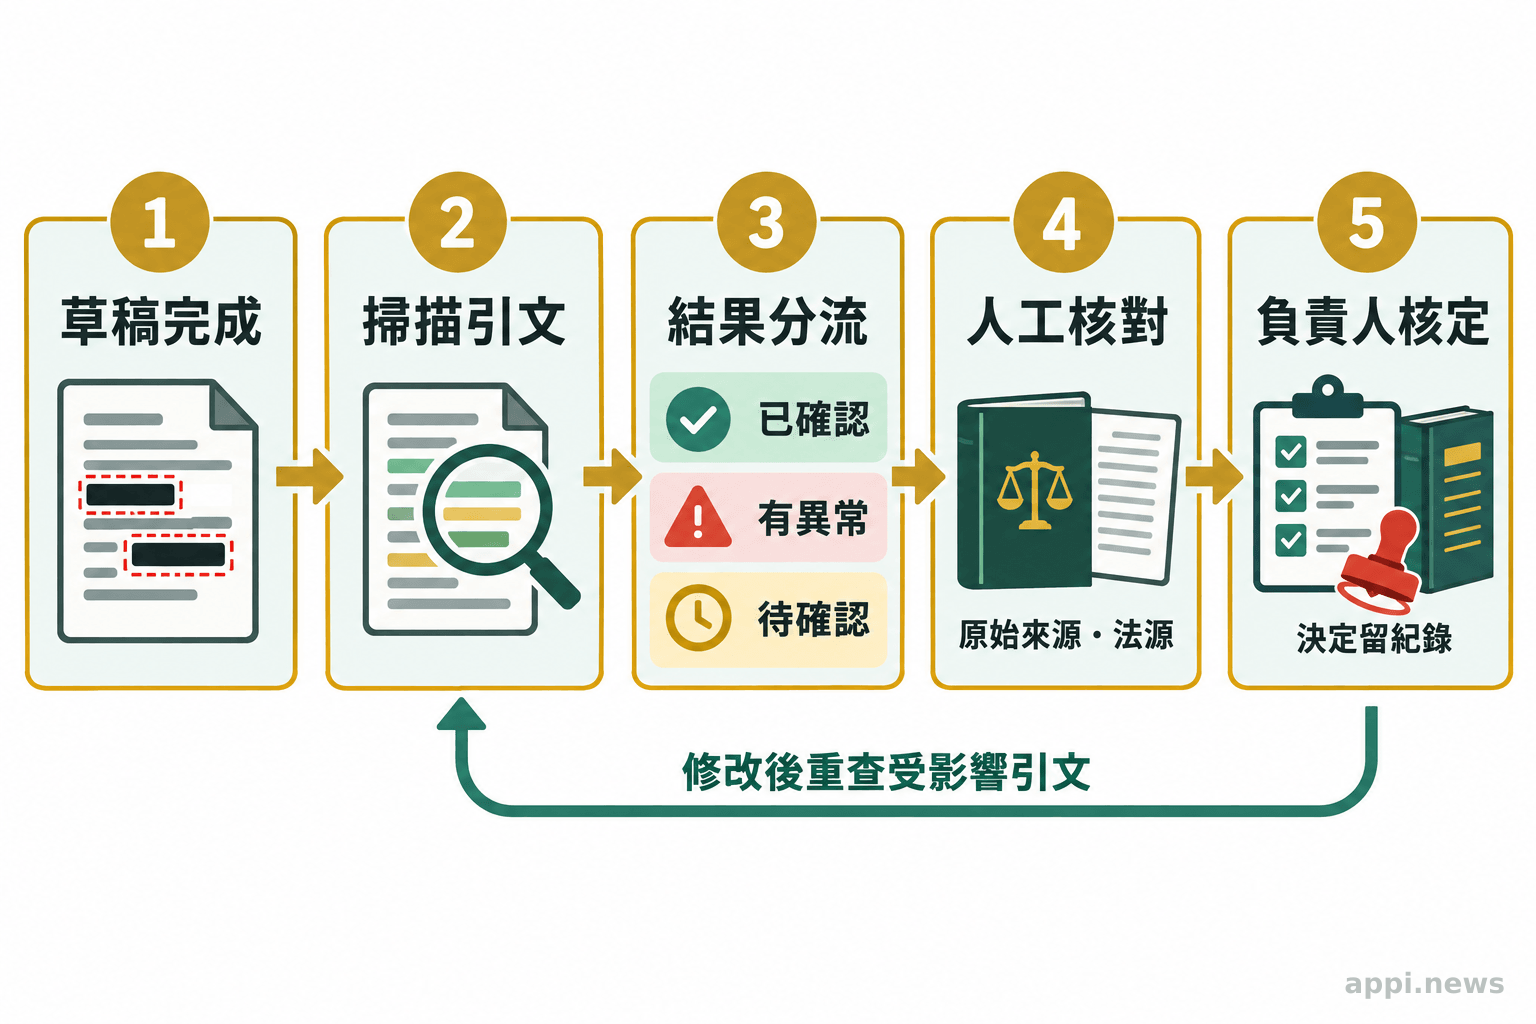
可在草稿完成後、主管核定或正式提交前執行掃描,將可確認引用、異常引用和未確認項目分流,再由指定法律工作者完成來源與主張覆核,保留處理紀錄。
讓結果可以追溯,而不是只留下紅黃燈
每筆異常應留存文件位置、擷取引文、查詢來源、工具結果、人工處理和核定者。審查者要能開啟原始紀錄核對來源與主張;發生誤判時,也能追查是抽取、資料涵蓋或法律判讀的問題。
流程可分為掃描、分流異常、人工核對來源與效力、負責人核定留檔。若掃描後修改文件,應重查受影響的引文,確保提交版本與查核版本一致。
保密、權限與成本也屬於驗證設計
法律文件可能含個資、商業秘密或未公開策略。上傳前確認傳輸內容、保存期限、存取權限、刪除方式、資料再利用和跨境位置。即使服務方稱只傳引文片段,也應核對設定與合約。
效率不只看掃描速度,也要計入擷取失敗、誤報覆核、漏報抽樣、整合、訓練和維護。ABA Formal Opinion 512 說明,律師使用生成式 AI 時仍須遵守保密義務,並評估客戶資料暴露或遭未授權存取的風險,以及供應商的安全政策、資料留存和可靠性。法律工作者與使用法律文件生成、審閱流程的組織,都應納入這些條件。
導入 CiteProof 前,先用哪些問題做小規模評估?
先以可去識別化的既有文件樣本,檢查司法管轄區和來源涵蓋、引用擷取品質、結果分類、人工覆核時間、資料處理方式與錯誤追溯能力,再決定是否擴大使用。
-
確認範圍:列出司法管轄區、法院、判例類型和引用格式,確認支援範圍。
-
準備測試樣本:以去識別化文件涵蓋正常引用、格式變體、錯誤頁碼和資料庫可能未收錄的來源,先建立人工核對結果。
-
分開記錯誤:記錄漏報、誤報、抽取失敗和無法確認,不用單一準確率掩蓋差異。
-
量測總工時:比較原流程與掃描加覆核,納入例外處理、重跑、整合和管理成本。
-
審查資料條款:確認傳輸、保存、刪除、權限、再利用和資料所在地。
-
指定核定人:規定誰核對原判決、法律命題與判例效力,並保留處理紀錄。
目前未見 CiteProof 獨立準確率或省時測試。小規模試用只能回答自身文件是否適用。台灣團隊還要確認本地裁判、法規與中文引用格式是否支援,不能從美國資料的報導推定台灣法源已涵蓋。
- CiteProof 的公開報導描述的是從文件擷取引文,再查找公開法律紀錄;獨立效能數據尚未公布。
- 找到判例不等於證明引文、法律主張或判例效力都正確;未找到也不必然代表判例不存在。
- 導入評估要同時量測資料涵蓋、抽取與分類錯誤、人工覆核、文件隱私和責任紀錄。
常見問題:CiteProof 能取代律師逐筆查核嗎?
不能據現有公開資料如此判定。它可協助查找及標記引用,仍需法律工作者核對來源內容、適用性、法律主張和判例效力。
常見問題
Q1:CiteProof 能確認判例支持文件中的法律主張嗎?
目前報導描述的重點是查找判例或法條引用。判例是否支持特定命題,仍要閱讀判決原文及其上下文,不能由查到相同案名推定。
Q2:工具顯示查無判例,就代表引用是 AI 虛構嗎?
不一定。可能是資料庫涵蓋不足、格式無法辨識、拼寫或頁碼有誤,也可能是來源確實不存在。應先確認擷取內容,再查法院官方紀錄或其他授權資料庫。
Q3:可以直接上傳含客戶資料的文件嗎?
先確認服務的資料傳輸、保存、刪除、存取權限與再利用政策。若文件含機密、個資或未公開訴訟內容,應依組織規範和適用的保密義務處理。
Q4:怎麼判斷工具是否真的降低人工成本?
用代表性文件比較原流程與「自動掃描加人工覆核」的總工時,同時記錄漏報、誤報、無法確認和資料整理時間。單看掃描速度不足以代表整體成本下降。
參考來源
- Brandon Vigliarolo. (2026). New online tool will check lawyers' sloppy AI-written briefs since they can't seem to be bothered. *The Register
- Court of Appeals of Georgia. (2025). *Shahid v. Esaam
- United States District Court, Southern District of New York. (2023). *Mata v. Avianca, Inc.*, Opinion and Order on Sanctions, 1:22-cv-01461-PKC, Document 54
- American Bar Association, Standing Committee on Ethics and Professional Responsibility. (2024). *Formal Opinion 512: Generative Artificial Intelligence Tools
- United States District Court, Northern District of California. (2025). *Concord Music Group, Inc. v. Anthropic PBC*, Order Resolving Discovery Submissions, Case No. 5:24-cv-03811, Document 377


