
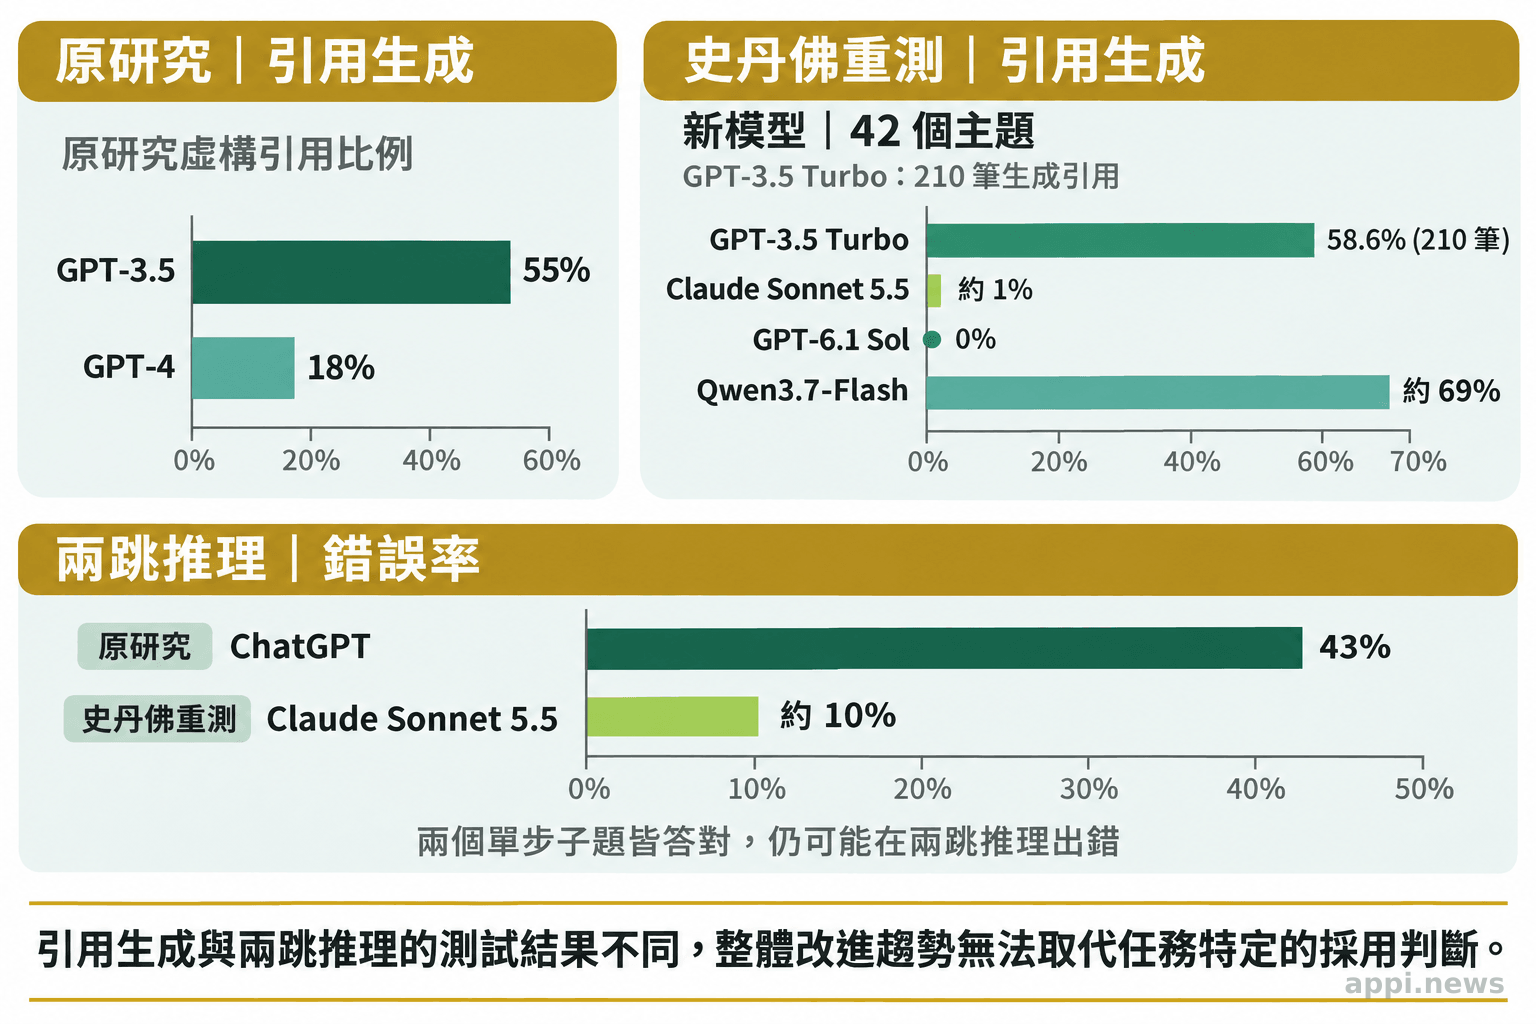
Walters 與 Wilder 在 2023 年測試 ChatGPT 生成文獻引用,發現 GPT-3.5 生成的引用有 55% 虛構。史丹佛研究團隊沿用相同提示重測 GPT-3.5 Turbo,結果仍約六成,模型更新並未讓這項測試中的錯誤明顯消失。原始結果來自 Walters 與 Wilder 發表於 Scientific Reports 的研究,重測結果見史丹佛研究頁面。
模型從 GPT-3.5 換到 GPT-4,引用錯誤曾大幅下降;重測 GPT-3.5 Turbo 卻仍接近原先的錯誤比例。模型更新後,舊評測還能不能用來決定採購或上線?史丹佛團隊也用 20 個不同發布時間的模型重測 50 項大型語言模型(LLM)研究主張,發現研究觀察到的行為會隨版本改變。導入者可先比對舊研究的模型、任務與設定,再以真實工作案例複驗;評估流程可參考AI評測完整指南:預測、測試與採購更新。
史丹佛團隊另以 42 個主題測試新模型,生成引用中 Claude Sonnet 5.5 約 1% 虛構、GPT-6.1 Sol 為 0%,Qwen3.7-Flash 則約 69%。這些比例只說明特定提示與引用生成任務的結果,不代表模型在其他工作上的表現。
史丹佛重測 50 項 LLM 主張,44% 被歸為效果已消退
研究團隊在 50 項主張中,將 22 項列為效果已消退、17 項列為減弱,8 項持續、3 項增強;這些比例描述研究所選的主張和模型面板,不能當成所有 LLM 論文的失效率。
研究面板涵蓋 8 家開發者、2024 年 7 月至 2026 年 9 月發布的不同規模及開放、閉源模型。研究者沿用原論文核心指標重測,並將效果量(衡量觀察差異幅度的統計指標)換算至共同尺度:1 代表與原研究相當,0 代表效果消失。這種換算讓不同研究可以放在同一尺度比較,但仍依賴原論文的指標與重測任務,不能直接當成模型整體能力分數。
研究團隊將效果量降至原研究五分之一以下且維持至觀察期末定義為「消退」;「減弱」指效果仍在但較弱,「持續」與「增強」則接近或高於原幅度。消退不代表每個新模型都不再出現該錯誤。
研究團隊依模型發布趨勢擬合估計,22 項已有消退日期的主張,從論文公開到估計消退平均約 15.7 個月、中位數約 14.7 個月。這是趨勢估值,不是實際觀察到的失效時間;論文公開也晚於原始實驗。
「效果消退日期是估計值,不是精確觀察到的失效時間。」研究團隊說明,發布時間與趨勢估計都會影響這個期間的解讀。來源:史丹佛研究頁面
結果限於這 50 項主張、20 個模型及各供應商預設 API(應用程式介面,讓軟體向模型服務傳送請求的連接方式)設定,不能外推至所有論文或部署環境。推理模式(模型額外投入運算逐步處理問題的設定)與預算未統一,部分原模型以近似替代模型重現,且每項主張採單一精簡測試。因此 44% 是研究面板的分類比例,不是模型失效率。
這 50 項 LLM 主張呈現哪些差異?
在這 50 項主張中,推理與可評分能力缺陷多數消退或減弱;偏好、評審及迎合傾向則呈現不同結果,不能據此推論問題類型必然如何變化。
該研究面板的 9 項推理主張中,5 項消退、4 項減弱。2023 年的 Lost in the Middle 研究指出,答案線索位於長文本中段時,模型表現會下降;史丹佛團隊重測後,這項效應在其模型面板中減弱。字母計數與特定進位算術也列為消退案例。研究者提出,可評分的錯誤較容易納入訓練,但未證明訓練措施造成了變化。
該研究中,模型評審偏好較長答案的效應減弱,約保留原效果量的 65%;信賴區間(估計值可能落入的範圍)仍涵蓋原效果,表示資料尚不能清楚區分這項偏好是否真的變弱。偏好自家答案、迎合使用者及隨機數輸出不均等現象則被列為增強。這些結果只描述受測主張,也提醒導入者應分項追蹤指標,不能只看總分。
「偏好與判斷傾向較難被察覺,也可能較難由開發者訓練消除。」史丹佛研究團隊以此解釋部分傾向為何仍留在較新模型中。來源:研究團隊的結果與討論
導入評估宜分別量測關心的錯誤類型;單一總分無法呈現迎合、拒答或偏差等不同風險。
同一項評測在不同新模型上仍有落差
不會。即使使用同一項測試,模型間的結果仍可能相差很大;研究的整體趨勢不能代替個別供應商和版本的驗收。
Walters 與 Wilder 的研究先比較 GPT-3.5 和 GPT-4 生成的文獻引用,虛構比例分別為 55% 與 18%。史丹佛團隊用相同提示重測 GPT-3.5 Turbo,210 筆生成引用中有 58.6% 虛構;再以 42 個主題測新模型,Claude Sonnet 5.5 約 1%、GPT-6.1 Sol 為 0%、Qwen3.7-Flash 約 69%。前一組比較跨越不同模型版本,後一組則是特定重測中的模型差異,兩者都只涵蓋引用生成,不能視為一般錯誤率。來源:原始引用研究與史丹佛團隊重測。
另一個案例是兩跳推理,也就是模型必須先找出一項事實,再把它和第二項事實連起來作答。原研究對 ChatGPT 的兩跳題錯誤率為 43%;史丹佛團隊測試 Claude Sonnet 5.5 時,即使模型答對兩個單步子問題,仍有約 10% 的兩跳題答錯。這表示單題能力改善,未必代表多步驟流程同幅度進步;工作流若依賴串接資訊,驗收案例也要保留完整步驟。數據來源為史丹佛團隊重測。
評審順序偏差是第三種情境:研究者只調換兩個候選答案的呈現順序,觀察模型評審是否因此改變勝負判斷。史丹佛團隊測得 62.5% 的判斷翻轉,原論文為 46.3%。即使兩次測試都發現順序會影響結果,幅度差異仍可能來自提示、模型或判分設計;企業若用模型排名供應商或答案品質,應固定候選內容與呈現方式再重測。數據來源為史丹佛團隊重測。
研究整體分類依模型發布日期的趨勢擬合,個別模型則按該模型的測試效果量判定。較晚發布不保證失敗較少:2026 年 7 至 9 月模型的消退主張數,從 DeepSeek V4 Pro 的 11 項到 GPT-6.1 Sol 的 30 項不等;這不是總體能力分數。引用生成、兩跳推理與評審順序三個案例也各自測量不同能力,不能把其中一項改善拿來預測另一項。採購評估若只選模型最擅長的示範題,就可能看不到真實任務中的資訊遺漏或判斷偏差。
模型更新後的驗收方式,也可參考開放模型更新的部署驗收重點。
模型版本、任務和評分方式共同影響評測結果
研究比較會受模型版本、提示、資料與評分設計影響;實際部署另有任務、工具與資料情境。這些因素改變的是「測量到什麼」:換了版本,輸出能力可能不同;改了提示或資料,題目難度與可用線索也不同;評分標準若只看答案長度,則可能把冗長誤認成品質。前後測須記錄並盡量固定條件,才能把分數變化連回可能原因。
模型產品名稱未必能識別版本,API 也可能在名稱不變時切換底層模型。評測應留存模型 ID、版本、日期與 API 參數,並記錄供應商更新。同一名稱下的服務若已換版,舊分數就不一定描述目前實際使用的模型;保留請求與輸出,才能在差異出現時追查是否源自版本變動。
同樣是摘要,客服可能要保留退款條件,研究摘要須呈現方法限制。基準題若只評流暢度,會漏掉資訊遺漏;可量測正確率、引用可查證率、欄位完整率、拒答、人工修正時間及成本。
提示、上下文(模型回答時可讀取的前文)、推理模式、工具權限、檢索資料與評分者都會影響輸出。任務若提供更多背景或可查資料,答對率可能提高;工具權限也會讓原本要靠模型記憶的題目變成查詢題。評分者若不知道答案順序已改變,也可能把順序偏差當成模型能力差異。史丹佛研究採供應商預設 API 設定,未統一推理模式與預算,因此不能回答各模型在相同預算下的表現。導入團隊應固定任務材料、工具與判分方式,若無法固定,至少把差異記錄下來,避免將設定變動誤認成模型進步或退步。
AI 導入者如何重新驗證舊評測?
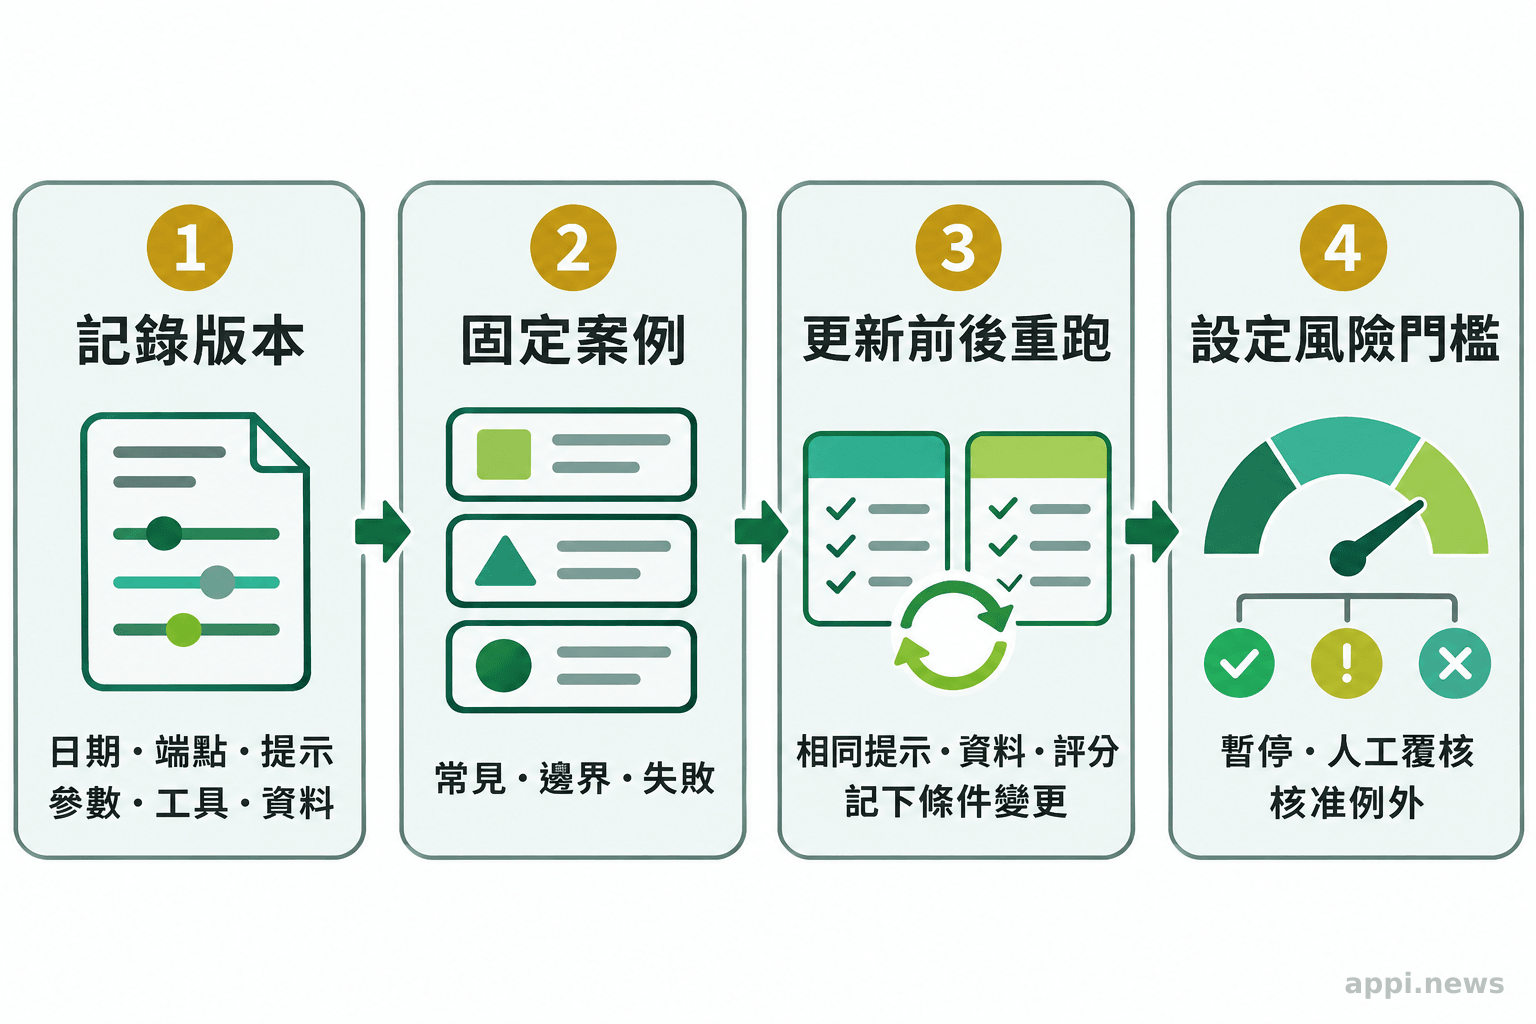
固定模型版本、任務案例與判分條件,更新前後重跑並依風險設定上線門檻。
- 記錄版本與環境。 保存模型 ID、日期、端點、提示、參數、工具及資料;留存請求與輸出。
- 建立真實案例集。 納入常見、邊界及曾出錯案例,訂出答案或評分規準。
- 更新前後重跑。 固定提示、資料與判分方式,記錄指標及抽查結果;條件變動須註明。
- 設定風險門檻。 定義暫停上線、人工覆核與例外核准條件,高風險流程先測再切換。
- 50 項主張中有 22 項消退、17 項減弱,比例只適用於研究測試的主張與模型面板。
- 新模型的整體趨勢不代表每個供應商、版本或任務都以同樣幅度改善。
- 導入團隊應保存版本與測試條件,用固定案例集在更新前後重跑關鍵指標。
舊研究可用來找待驗證的失敗模式;更新時應比對任務情境,以固定案例重跑並記錄設定。
常見問題
Q1:史丹佛研究說 LLM 研究結論只能維持 15.7 個月嗎?
不是。15.7 個月是 22 項已有估計消退日期的主張,其發表至估計消退時間的平均值。研究沒有得出所有 LLM 研究都有固定期限的結論。
Q2:一項主張被列為「效果已消退」,代表新模型不會再出現這種錯誤嗎?
不代表。這個標籤描述研究面板的趨勢或多數新模型測試結果,特定模型仍可能在該測試中頻繁出錯,例如引用生成測試中的 Qwen3.7-Flash。
Q3:模型更新後,最少要重新測什麼?
先測與自己工作流程直接相關的案例,包含正確性、關鍵資訊遺漏、拒答、引用或格式等核心指標。維持相同提示、資料與判分條件,並記下模型版本和測試日期。
參考來源
- Queen O, Zou J. (2026). *The shelf life of LLM findings*. Stanford University
- Walters WH, Wilder EI. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. *Scientific Reports*, 13, 14045
- Liu N, et al. (2023). Lost in the Middle: How Language Models Use Long Contexts. arXiv


