
2026 年 10 月 28 日,Google DeepMind 公布 Gemini 4 Carbon,列出漏洞發現、利用驗證與修補三項資安基準成績。同一份發布公告說明,模型首波只提供給部分資安防禦者,再透過 Fairwind 計畫逐步擴大合作對象。
公告將後續開放描述為「as soon as possible」,沒有列出確切日期。因此,測試結果雖已公開,一般開發者與企業仍不能直接取得模型。
如果團隊正評估模型升級,第一個問題不該只是「分數高不高」,還要問:現在能否取得、測試任務和工作現場是否相似、模型有權讀寫哪些資源,以及錯誤由誰攔下。此前 appi.news 整理過Gemini 4 Argon 的任務與成本評估方式,Carbon 的新訊息則多了資安基準與受限開放條件,兩者都要放回實際流程檢視。
Gemini 4 Carbon 已公布成績,現在為什麼多數團隊還不能試?
截至 2026 年 10 月 28 日,Carbon 正由 Google 分階段提供給資安防禦者與可信合作夥伴,尚未對一般開發者、企業或消費者開放。 有公告、有價格資訊或參與候補,都不等同已有可呼叫的 API 或正式產品入口。
Google 表示,初期會先讓一部分資安防禦者使用,透過 Fairwind 逐步納入更多可信夥伴,收集回饋並調整防護措施後,再擴及開發者、企業與消費者。公告提到 API 導入價格,但未公布一般開放日期,價格資訊不能用來推斷 API 已可申請。
Ars Technica 也指出,Google 沒有承諾普遍開放的時間表。該報導可作為外部參照,實際資格與入口仍應以官方公告為準。
對台灣團隊來說,能否列入現在的整合計畫,取決於是否已收到正式邀請或取得官方端點。若尚未取得,就無法用 Carbon 直接跑自己的工作流,也不能把別人公布的基準當成內部驗收結果。此時可以先準備測試資料、判分方式與權限隔離環境,等取得模型後用同一套流程比較。
三項資安基準各測什麼,分數能回答哪些問題?
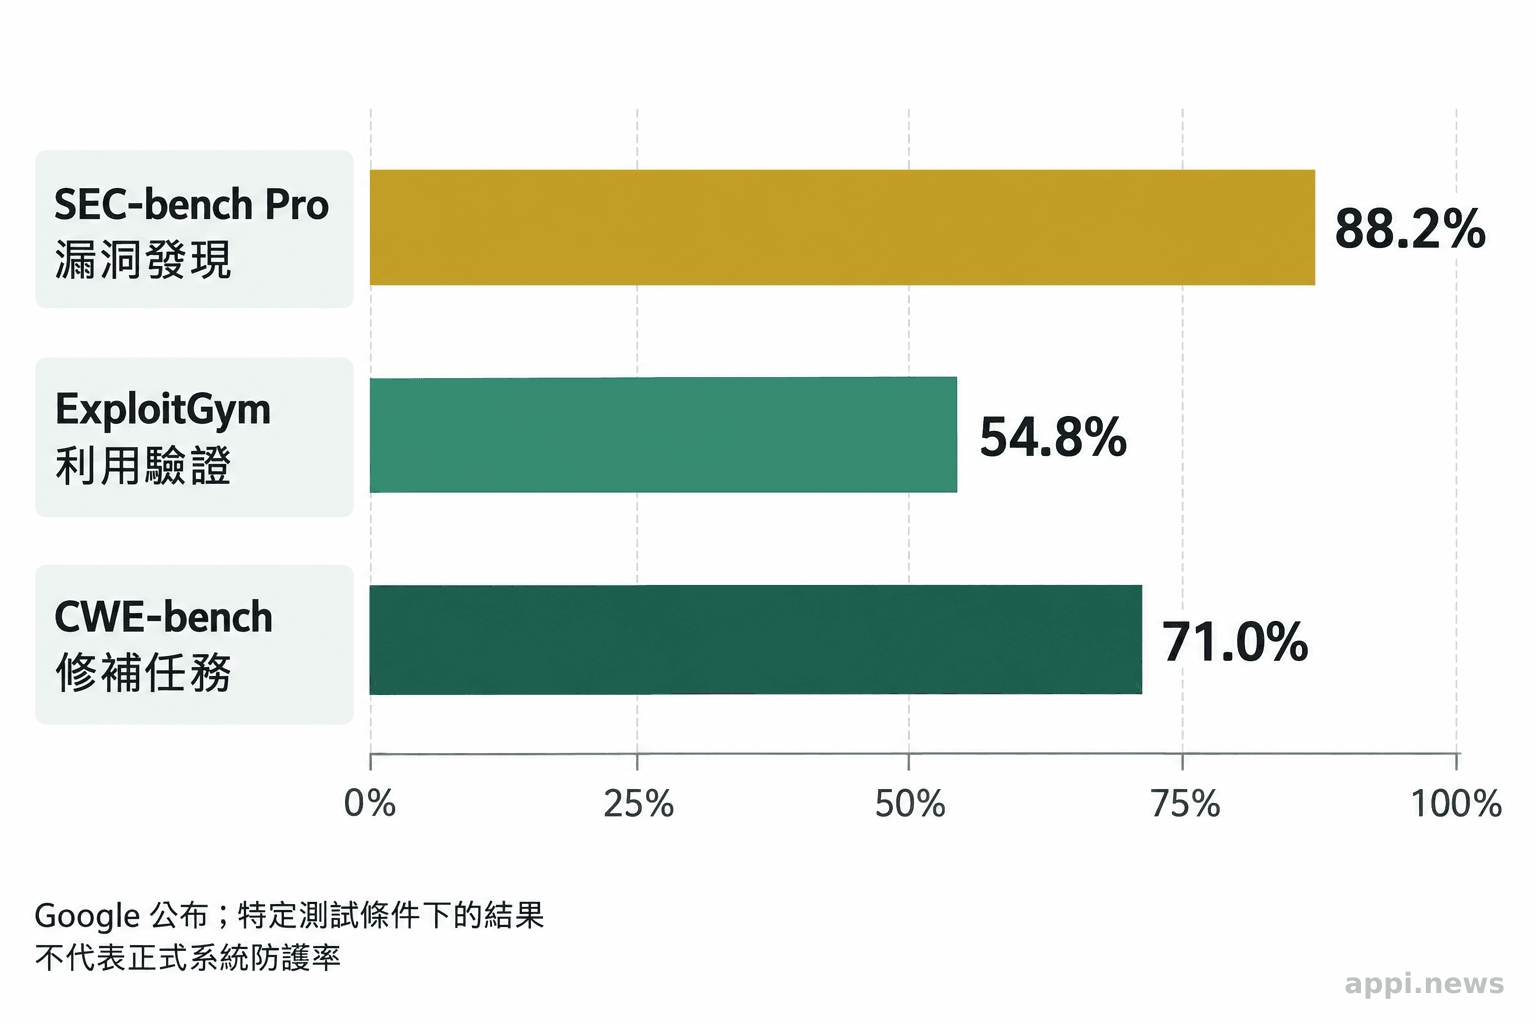
Google 公布的 88.2%、54.8% 與 71.0%,分別對應漏洞發現、漏洞利用驗證與修補任務;它們是特定測試設定下的成績,不是正式系統防護率。 分數應先和任務定義、執行時間、代理工具及評分方法一起讀。
三項基準各自處理不同任務:SEC-bench Pro 找出程式碼或系統弱點,ExploitGym 檢驗代理能否把已知漏洞轉成可運作的利用方式,CWE-bench 則要求模型稽核程式庫、定位弱點並提出修補。Google DeepMind 將 Carbon 放入這些測試,公布三項成績;這是廠商公告中的案例,顯示模型在指定任務上的表現,不代表正式環境防護率。
| 基準 | 測量任務 | Carbon 公布成績 | 可以解讀什麼 | 限制 |
|---|---|---|---|---|
| SEC-bench Pro | 找出程式碼或系統弱點 | 88.2% | 指定測試中的漏洞發現表現 | 不等於實際系統的漏洞檢出率 |
| ExploitGym | 將已知漏洞轉成可運作的利用方式 | 54.8% | 指定漏洞與執行環境中的利用任務表現 | The Decoder 指出執行上限為十小時;條件不同不可直接排名 |
| CWE-bench | 稽核程式庫、定位弱點並提出修補 | 71.0% | 指定測試中的弱點修補表現 | 公告未提供足以和論文完整對齊的設定 |
The Decoder 報導補充,Carbon 在 ExploitGym 的 54.8% 是以十小時執行上限測得,報導列出這項測試條件。提示、工具、時間與推理設定不同,就不能直接拿另一個數字排高下。
ExploitGym 研究團隊以 898 個真實漏洞案例建立可重現的容器化環境,讓代理從觸發漏洞的輸入開始,逐步產生可造成實際影響的 exploit。這項研究案例呈現的是測試環境內的利用任務。
Carbon 的 54.8% 只適用於指定漏洞集合與執行條件,不代表模型能在任意企業網路成功入侵,也不代表防禦系統的安全程度。ExploitGym 論文說明了資料集與測試方式。
CWE-bench 的任務是防禦端稽核與修補。研究團隊建立 120 個保留測試案例,涵蓋 73 種弱點類型與 8 種程式語言;模型不知道漏洞位置或數量,修補必須擋住 exploit,同時維持原功能。論文中的案例測試了代理修補未知弱點的能力,當時最佳代理 pass@1 為 68%。
pass@1 指每題只給一次生成或嘗試機會時的通過率。Google 公告列出 Carbon 71.0%,但公告沒有交代足以和論文完整對齊的執行設定,因此不能據此斷言 Carbon 在同一流程中勝出。CWE-bench 論文也指出,代理排名會因語言與弱點類別而變動,沒有單一代理在所有分類都領先。
「代理表現會隨程式語言與弱點類別改變,沒有單一代理在所有分類都領先。」(意譯)(CWE-bench 研究團隊,論文摘要)
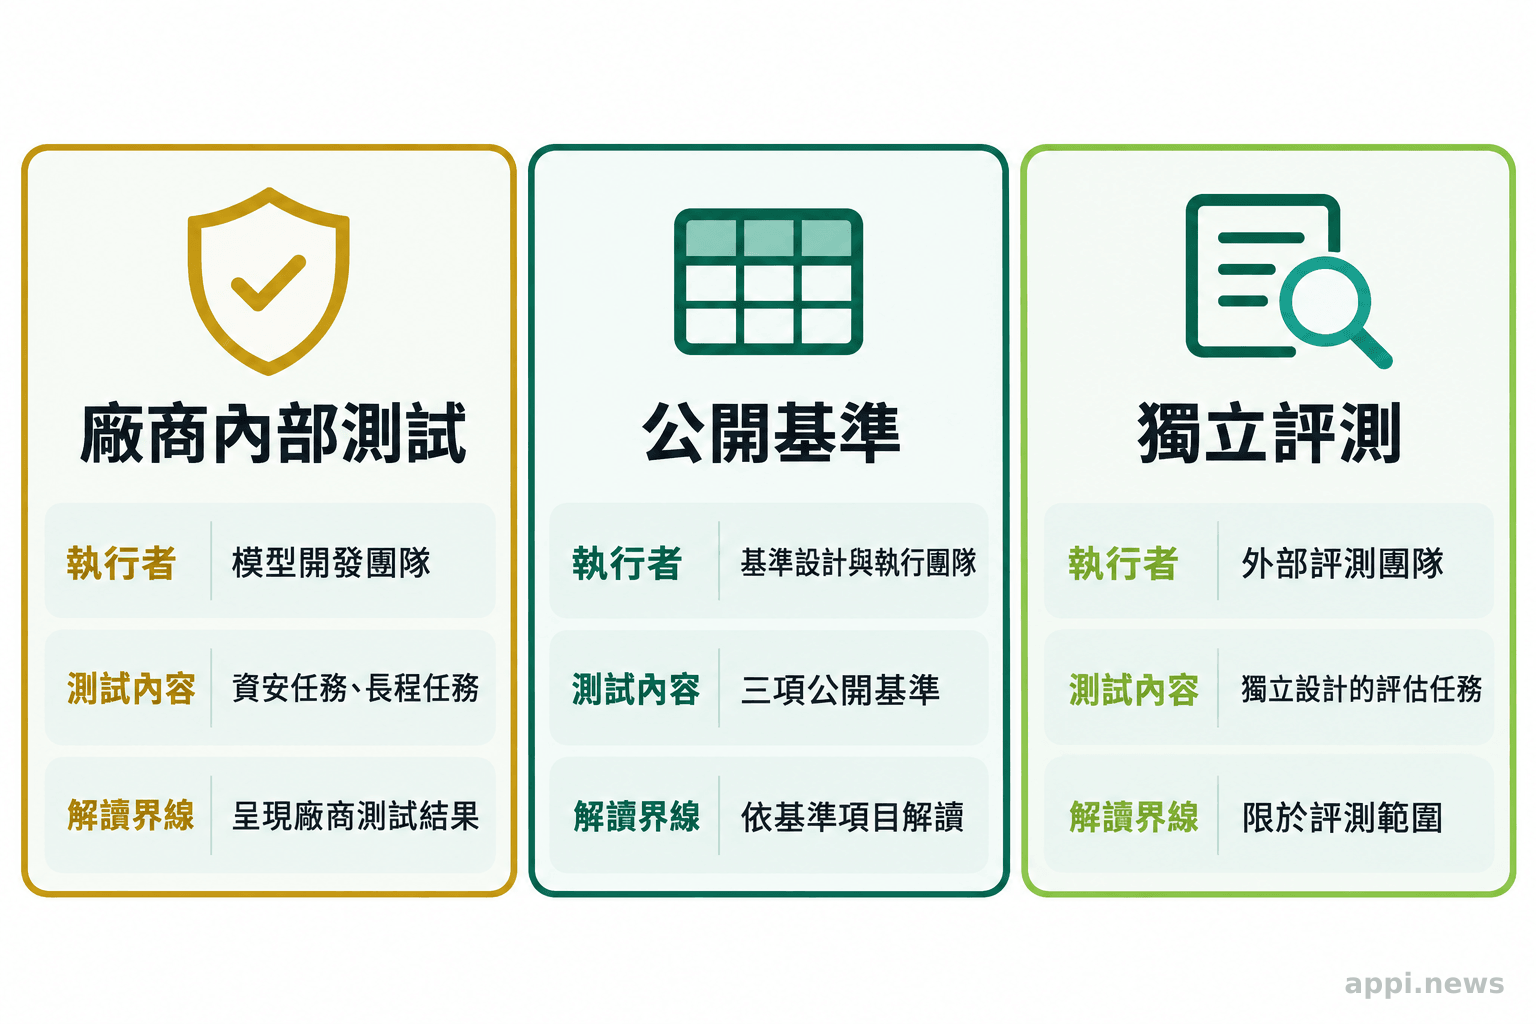
Google 也把安全程式碼生成的提升及內部團隊長時間執行任務的結果列為內部測試。讀取這些數據時,應與公開基準分開看;兩者的執行者與可重現條件不同,不能合成單一「安全分數」。
獨立評測與 Argon 比較,還有哪些差距要看?
外部評測能補上不同任務的比較,但結果仍受推理層級、工具代理、測試集、成本和計時方式影響;目前資料不足以支持 Carbon 在所有工作上都勝過 Argon 或其他模型。
The Decoder 引述 Artificial Analysis Intelligence Index v5 的資料,Carbon 得 59 分,Argon 為 50 分。Coding Agent Index 的工具組合測試中,Antigravity CLI 搭配 Carbon(high)為 59 分,Claude Code 搭配 Opus 5.5(max)為 62 分,工具與推理層級不同。
這項獨立評測案例比較的是指定索引和工具組合,不能直接延伸為企業內部程式碼審查、漏洞修補或維運工作的效能排名。
CWE-bench 論文也提供一個具體對照:研究中的 Gemini 4 Argon 在 pass@1 為 68%,與另外兩個代理並列領先;相同通過率仍可能伴隨不同的重試收益與成本。Carbon 公布的 71% 不能單獨回答這些成本問題,團隊還要記錄重試數、人工修訂量、執行時間和失敗後果。
「Carbon 是我們在資安與長程能力上的旗艦模型。」(Google DeepMind 主管 Koray Kavukcuoglu,官方發布公告) 這句話是 Google 對產品定位的說明,不是獨立認證。Google 也稱 Carbon 在內部測試中改善安全程式碼生成,並在自家長時間編碼環境中處理跨多日的工程任務;公開公告沒有提供可讓外部團隊完整重現的任務集、全部代理設定與人工介入細節。閱讀報導時要辨識每個數據的來源,尤其不要把公司自述改寫成第三方實測。
尚未取得模型時,團隊可以先做哪些準備?
先建立自己的任務測試集與安全執行邊界,等取得 Carbon 後再用相同輸入、工具和判準做比較。 這能讓團隊先驗證需求與流程,避免只因模型分數而投入整合。
測試集不必從大量任務開始。可以先挑一種真實且可回復的工作,例如在隔離複本中找出已知弱點、提出補丁,再由工程人員檢查弱點是否封住、原功能是否保留。記下任務成功條件、允許的工具、模型可讀寫目錄、人工修改時間與計算成本,才能分辨改善來自模型本身,還是測試流程改變。
資安團隊與系統維運者應在隔離環境測試,採最小權限,避免未驗證輸出接觸正式程式碼庫、部署金鑰或敏感資料。模型能力會與外部工具、代理權限、測試資料、提示注入防護和人工覆核流程互相影響;若要接入程式碼庫、漏洞掃描或修補流程,先定義讀寫範圍、核准責任與回復方式。
雲端服務的資料處理、保留及區域條件,也應依正式服務條款確認,不要假設尚未公布的企業控制項已經提供。
這些治理條件同樣適用於其他代理工作流;例如企業導入 Gemini 代理前的權限與成本驗收也需先界定哪些工具可以執行、哪些動作必須由人核准。Carbon 尚未普遍開放時,最實際的準備是先把這些條件變成可檢查的測試規格。
團隊現在該觀察、試測或等待?
依可取得性、任務代表性、驗證成本與治理條件決定:缺少官方端點先觀察,條件齊備且任務可控才試測,資料或權限風險無法界定就等待。
四項檢查可把決策落到具體條件:
- 可取得性:確認團隊是否有官方邀請與可用端點;沒有就先列為觀察或離線準備。
- 任務代表性:選一項重複發生、可安全重現的實際工作,確認它和公開基準測的任務相似到什麼程度。
- 驗證成本:訂出成功標準,記錄重試、人工修正、時間、token 與錯誤嚴重度,不只看一次答對率。
- 資料治理:用隔離副本和最小權限測試,確認資料可否送往雲端、輸出如何審核、誰有核准與回復責任。
若尚無官方邀請或端點,先觀察公告並完成離線準備;若已能取得模型、任務能代表實際工作、驗證成本可接受,且資料與權限邊界已核准,可在隔離環境試測。任何一項治理條件未釐清,或失敗後果無法控制,就先等待,補齊條件後再評估。
- Carbon 公布了漏洞發現、利用驗證與修補成績,但首波使用對象有限,普遍開放時間未定。
- 官方基準、內部測試和獨立評測回答不同問題;分數不能直接換算成正式環境安全保證。
- 尚未取得模型時,可先建任務測試集、覆核標準與權限邊界,待開放後再同條件驗收。
Gemini 4 Carbon 常見問題
截至 2026 年 10 月 28 日,Google 公告的對象是部分資安防禦者及後續可信夥伴,沒有宣布一般開發者 API 的普遍開放日期。 請以官方產品入口與公告更新確認資格。
常見問題
Q1:官方資安基準高分代表系統更安全嗎?
不代表。分數反映模型在指定資料集、工具與時間條件下完成任務的比例;實際安全還取決於程式架構、權限、部署流程、資料品質和人工審核。
Q2:SEC-bench Pro、ExploitGym 與 CWE-bench 可以直接互相比較嗎?
不宜直接比較。三者測量的任務不同,分別偏向漏洞發現、漏洞利用與防禦修補;即使同名基準,測試版本、模型推理設定、工具代理和時間上限不同,結果也可能不同。
Q3:還沒取得模型,現在可以開始評估嗎?
可以先做離線準備:選定代表性任務、整理不含敏感資料的測試輸入、定義可驗證的成功標準,並設計隔離環境、最小權限及人工覆核。待取得端點後,再用相同條件測試。
參考來源
- Google. (2026). Introducing Gemini 4 Carbon. *Google
- Whitwam R. (2026). Google announces Gemini 4 Carbon, its latest frontier AI model that you can't use. *Ars Technica
- Bastian M. (2026). Google Deepmind releases Gemini 4 Carbon just two weeks after Argon with gains across the board. *The Decoder
- Wang Z, et al. (2026). ExploitGym: Can AI Agents Turn Security Vulnerabilities into Real Attacks? *arXiv
- Gonzalez-Pumariega G, et al. (2026). CWE-bench: Refocusing Agentic Security from Exploitation to Defense. *arXiv


