
生成式 AI 在特定會計評測中完成速度較快、評分較高,但這不代表它已能自動處理企業結帳。
Mercor 的人類基準比較發現,Claude Opus 5 在四項簡化月結任務中完成較快、評分較高。任務由 APEX-Accounting 改編,不能代表模型已能接手整月關帳;企業仍須檢查任務範圍、重複結果、錯誤後果與人工確認節點。
一、會計自動化評測比較了哪些工作?
直接比較的是 Claude Opus 5 與會計人員完成四項簡化月結任務的速度和評分,不是 AI 與會計師完成完整企業結帳的對照。這個範圍差異決定了結果可以支持哪些導入判斷。
Mercor 於 2026 年 10 月初發布的人類基準研究,報告稱參與者都有有效的美國 CPA 執照,平均會計工作經驗約 5.4 年。研究採用 APEX-Accounting 的簡化任務,要求參與者從模擬公司檔案找數字、依規則計算並整理表格,題目涵蓋預算差異、收入調節、活動營收分析與租賃攤銷。
研究有 12 位會計人員參與。無 AI 組共提交 23 次作答,Claude Opus 5 執行 20 次;模型每次都達成評分表的全部條件,且在 10 分鐘內完成,會計人員多數作答超過 30 分鐘。結果僅適用於這些任務與樣本,未涵蓋企業完整關帳。
人類基準研究比較簡化任務上的模型與人員作答;APEX-Accounting 是 Mercor 與 Ramp 建立的會計工作基準,涵蓋 10 個模擬公司環境、160 項封閉測試任務,測試對帳、費用應計、交易過帳與報表等工作,每個模型每項任務執行八次。兩者測量範圍不同。
報告以「junior accountants」描述比較對象,但附錄所列職級也包括資深會計、查核人員與經理。報告另稱 12 位參與者持有 CPA 執照;職級與資格是不同資訊。樣本數小且組成多元,不能代表整體會計人員。
Mercor 報告指出,四項任務只涵蓋一小部分技能,包括檢視資料、搜尋檔案與遵循明確指示;這些恰是模型較擅長的工作。[2]
二、單項高分為什麼還不等於能獨立結帳?
不能。單項任務的高分說明模型能在指定條件下完成某些工作;完整關帳還要求跨資料核對、沿用公司判斷、處理例外並維持每一步的結果一致。
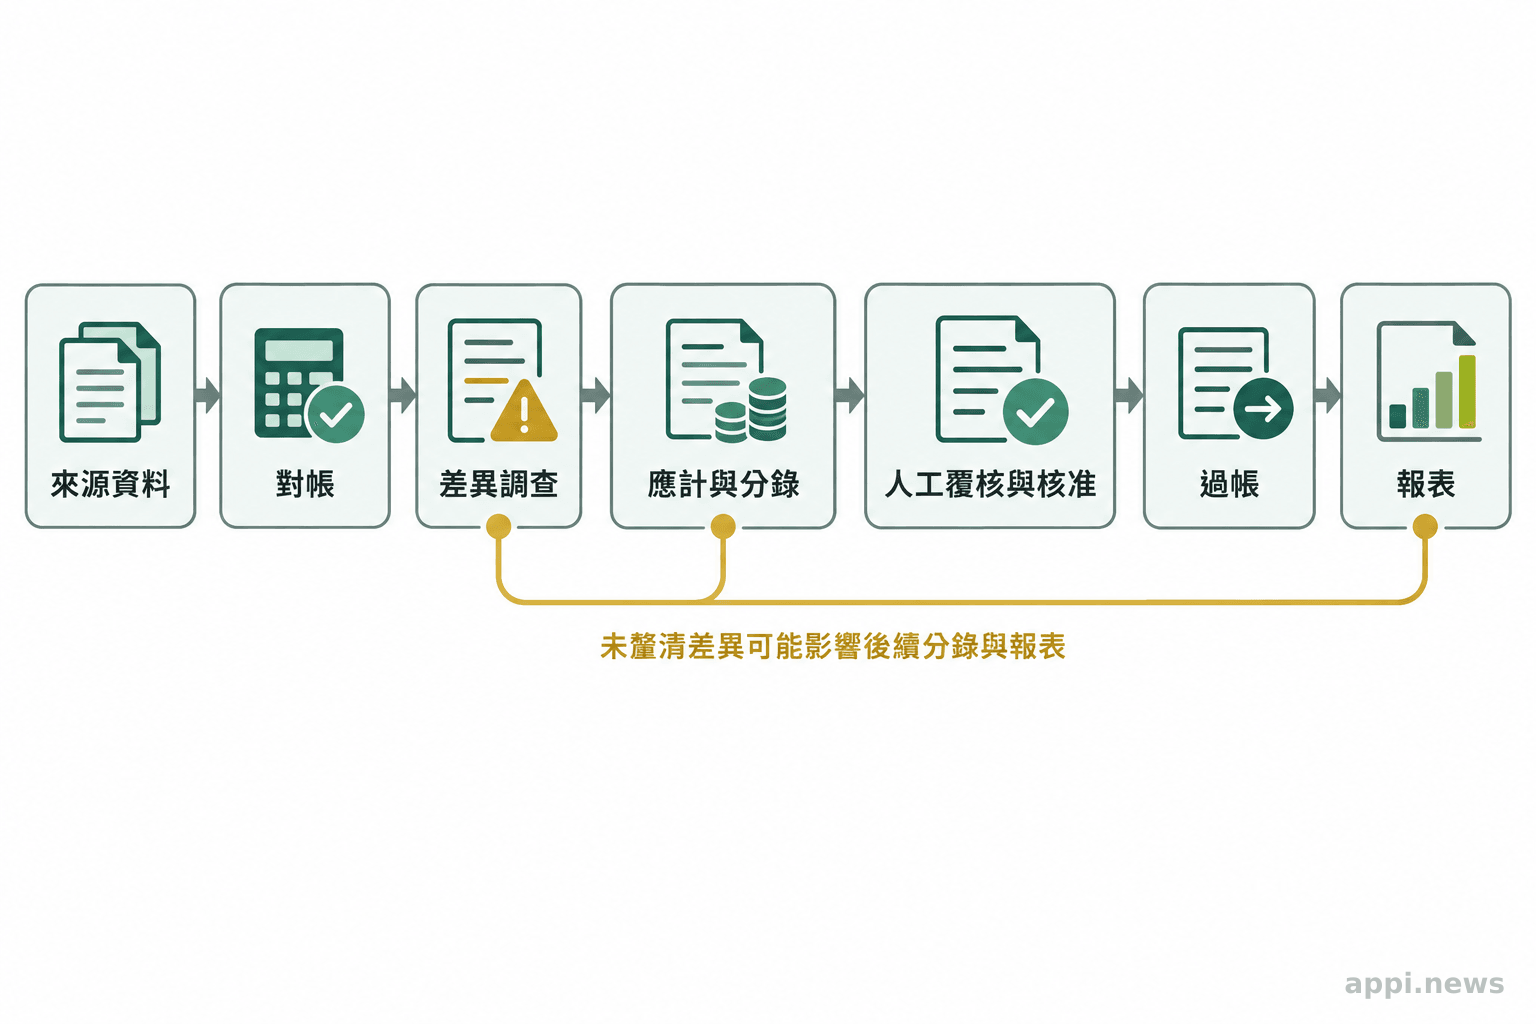
月結從來源資料、對帳與差異調查,延伸到應計、調整分錄、覆核和報表。以期末出貨為例,收入是否跨期須依交貨條件、交易事實與公司政策判斷;即使系統標出疑似截止差異,仍要確認原始入帳、評估是否需要調整,再把核准結果帶入報表。單靠找到一筆交易,不能推定應採哪種會計處理。
APEX-Accounting 顯示單次部分得分與重複完整作答的差距:以 160 項任務為分母,對任何模型而言,能在同一任務八次執行都完全正確的任務比例最高僅 2.6%。另有 58% 任務在所有模型的所有執行中都未獲完整解答。這些可靠度指標不同於通過部分評分條件的比例。
APEX-Accounting 為每項任務設定多個條件。企業判讀時要分辨格式瑕疵與錯列期間、漏掉重大差異等高影響錯誤,不能只看總分。
APEX-Accounting 使用模擬公司與封閉測試資料,未評估稅務、查核、合併、多幣別及對外報告。不同公司的科目設定、關帳日程、權責分工與系統介接也會改變任務難度,因此企業須以自身流程驗證。
三、依錯誤後果安排人工覆核與交接
先讓 AI 處理可逆、可核對的整理工作;涉及會改變帳簿、重大估計或例外判斷時,應設定具名人員覆核與核准。覆核層級應跟錯誤可能造成的影響相配。
可先試行輸入明確、結果可重算的工作,例如擷取發票欄位、依既定規則分類交易、列出對帳差異或待補憑證。輸出應附來源與不確定項目,供會計人員核對。
調整分錄、期間判斷、資產估值、應計估計與正式過帳會影響帳簿或財報,應設較高覆核門檻。缺資料、來源矛盾、金額超標、科目未核准或依據不明時,停止自動執行並交由指定人員;紀錄修改內容、依據與核准者。
| 工作階段 | AI 可先處理的部分 | 人員確認的控制點 |
|---|---|---|
| 資料整理 | 擷取欄位、分類、彙總及列出缺件 | 抽核來源與欄位對應,確認資料完整 |
| 對帳與差異 | 比對帳表、標出差額、提出可能原因 | 核實差異是否合理,確認是否需追問或調整 |
| 分錄與過帳 | 按核准規則草擬分錄、檢查借貸平衡 | 核准期間、科目、金額與憑證後再過帳 |
| 例外情況 | 彙整衝突資料和待決問題 | 指派責任人判斷,記錄退回或升級原因 |
低風險欄位整理可抽查或核對總額;可能造成重大錯報的工作應逐筆核准,並將草稿權限與過帳權限分開。
COSO、Crowe 與 CommonSpirit Health 的醫療機構實施指南建議,流程文件記錄交易流向、控制執行與覆核人員,以及手動或自動化的職務分工。一般企業可據此設計交接紀錄,並分開設定模型讀取資料、草擬分錄與核准分錄的權限。
四、企業如何把評測結果轉成導入驗收?
以自有資料設定正確條件、重大錯誤、拒答與退回規則,再用多次執行及操作紀錄決定自動化範圍。驗收門檻須符合企業流程與風險,不能照搬外部基準分數。
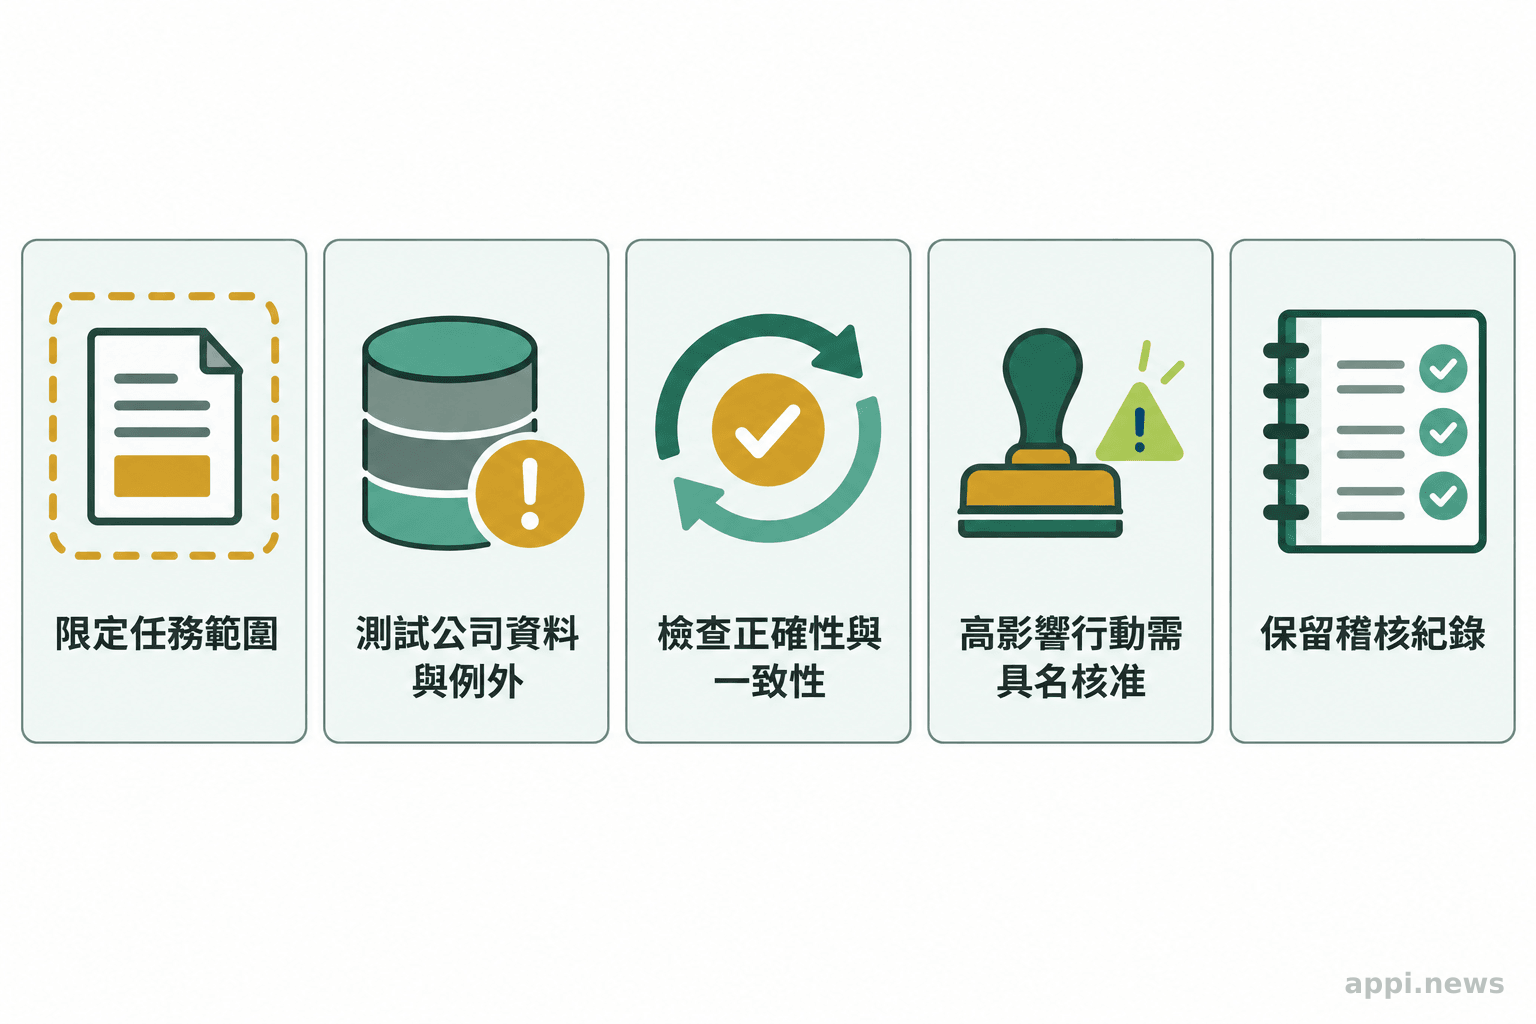
1. 限定任務範圍。選定一項工作,例如銀行月末對帳,列出輸入、規則與輸出,並納入格式異常、重複、跨期及缺漏案例。
2. 確認來源可追溯。核對數字、來源與計算步驟。3. 檢查重複執行的一致性。以相同輸入多次測試,設定不一致時停止及高影響任務不得自動執行的條件。
4. 攔截重大錯誤並留存紀錄。輸出附來源、模型版本、執行時間與覆核結果;資料不足或來源矛盾時,指出待補欄位,不自行補值。
5. 指定核准人並先行影子測試。讓 AI 先產出建議、不寫入正式帳簿,再與原流程比較。差異可解釋、重大錯誤能攔截且例外可交接後,再擴大範圍;模型、設定、資料來源或系統變動後重新測試。
五、會計自動化與月結關帳:先從可驗證的流程開始
現有研究不足以支持取消人工覆核。企業可先以自有資料驗證特定工作的正確性、一致性和交接能力,再按風險調整權限。
企業應依自身會計政策與內控責任,明確指定分錄核准與財報簽核人員,並界定模型必須停止的情況;外部評測無法確認內控已有效運作。
五項判準是任務範圍明確、資料可追溯、結果可重複、重大錯誤可攔截,以及由有權限者核准輸出。
- 人類基準研究的優勢只適用於四項簡化月結任務與該研究的測試條件。
- APEX-Accounting 顯示部分任務得分和反覆完整作答仍有落差,兩者不能混為同一種能力。
- 導入驗收應使用企業自有資料,依錯誤後果設定覆核、退回、核准和紀錄要求。
常見問題
Q1: AI 在評測中比受測會計人員完成較快、評分較高,可以直接取消覆核嗎?
不宜如此推論。人類基準研究比較的是四項簡化情境中的 23 次會計人員作答與 20 次 Claude Opus 5 作答,不是企業整體關帳;APEX-Accounting 的重複測試也顯示,完整解題的穩定性仍有限。是否能減少某一環節的覆核,需以該企業的資料和錯誤後果驗證。
Q2: 導入前最先應測哪種工作?
可從輸入來源固定、規則清楚、輸出容易重算,而且不會直接改動正式帳簿的任務開始,例如資料彙整、交易分類或對帳差異清單。測試集要包含缺漏、重複、跨期與異常格式等案例。
Q3: 哪些結果應交由人員逐筆確認?
會改變帳簿的調整分錄與正式過帳、重大金額或估計判斷、來源互相衝突,以及超出核准規則的例外,都應有具名覆核或核准。系統若無法提出依據,也應停止並轉交處理。
參考來源
- Julien Benchek, Austin Bennett, Jasmin Kern, Ryan Stevens, René Sultan, Charis Ching, Hayley Popiel, Vaibhav Mittal, Felix Mercier, Brendan Foody, Bertie Vidgen. (2026). *APEX-Accounting*. arXiv
- Aden Barton. (2026). *Human Baselines for Benchmarks: AI Now Outperforms Junior Accountants*. Mercor Economics Research Paper
- Committee of Sponsoring Organizations of the Treadway Commission (COSO), Crowe, and CommonSpirit Health. (2019). *COSO Internal Control—Integrated Framework: An Implementation Guide for the Healthcare Provider Industry


