
Meta 在 2026 年 10 月 15 日發布 Muse Spark Open,開放模型權重供下載,也展示以兩台 Mac Studio 執行模型的方式。消息很容易讓人把焦點放在「模型能不能跑在 Mac 上」,但團隊真正要先確認的是:新聞展示的硬體規格是否符合自己的預算,模型授權是否容許預定用途,以及它在實際工作裡能否穩定完成任務。這三件事沒有答案,參數量或展示影片都不足以支持採購與上線決策。
Muse Spark Open 延續 Meta 的 Muse Spark 系列,這裡只需掌握一個背景:Meta 將它定位為支援長流程代理與程式工作的多模態模型。這次新增的重點,是可取得的開放權重版本,以及特定 Apple Silicon 組合的執行示範。以下從模型規格、硬體、授權與導入路徑拆解,讓評估回到可驗證的工作情境。
Muse Spark Open 的 816B 與 42B 分別代表什麼?
816B 是模型總參數,42B 是每個 token 推論時會啟用的參數量。 它採用稀疏混合專家架構(Mixture of Experts,MoE),計算量可依啟用的專家減少,但部署仍須載入完整權重。
Meta 開發者文件列出 Muse Spark Open 有 816B 總參數、42B 啟用參數,輸入支援文字、圖片、音訊和影片,輸出為文字,推論情境下的上下文長度為 1,048,576 tokens。上下文長度表示一次互動可納入模型處理的文字或多模態資訊規模上限;它不代表每次請求都會使用完整長度,也不表示長上下文沒有記憶體與延遲成本。
Meta 開發者文件將它描述為稀疏混合專家 Transformer,並指出每個 token 只會路由到部分專家。這個架構能把運算集中在少數專家,但團隊仍需用實際請求測試整體回應時間。一次請求的上下文越長,快取記憶體占用通常越高;若系統同時處理多個使用者,容量還需按並發量估算。單看模型規格裡的最大上下文,無法預測服務能承受多少同時請求。
這裡常見的誤讀,是把「42B 啟用」理解成只需要容納 42B 參數。啟用參數影響單次運算會動用多少模型計算,記憶體容量則要看整套權重及執行時額外空間。Meta 文件明確指出,服務模型時仍會載入完整 816B 權重。這是估算硬體時應採用的前提;不能從 MoE 的計算特性推論模型可裝進普通桌機或一般筆電。
多模態能力也要拆成輸入格式與實際任務。 模型卡列出文字、圖片、影片與音訊輸入,並以文字作為輸出。理論上可拿來試文件與畫面理解、影音摘要或程式代理流程,但每種任務都受格式、解析度、語言、上下文長度與工作流程影響。
模型卡提醒,模型仍可能在多步推理或陌生情境出錯,量化推論也可能在部分案例出現品質差異。Hugging Face 模型卡提供的是 Meta 發布的規格與限制,不等於獨立測試已證明它適合所有團隊。多模態輸入也不等於能直接讀懂所有檔案:文件可能要先轉成圖片或文字,影片可能受片長與畫面清晰度限制,音訊也可能需要轉錄或切段。流程前處理若不穩定,模型無法補回缺失或失真的資訊。
Meta 開發者文件指出:「推論服務仍須載入完整 816B 權重,硬體容量因此由整套權重決定。」
「能在 Mac 上跑」需要哪些硬體條件?
Meta 展示的 Mac 執行方式需要兩台配備 M5 Ultra 的 Mac Studio,並使用 MLX。 這不表示一般 Mac、單台 Mac Studio 或較舊機型都能以相同性能執行。
Meta 發布文章說明,兩台 M5 Ultra Mac Studio 透過 MLX 協同運作,每台最高可提供 512GB 統一記憶體,合計約 1TB;文章稱這種組合可容納完整模型。這是指定機型、記憶體配置與軟體框架下的案例,不是「Mac 都能跑」的通用規格。Apple 晶片將 CPU 與 GPU 共用統一記憶體,MLX 則是針對 Apple 晶片設計的機器學習框架;多機協作、網路連線、版本相容與服務管理仍要納入部署工程。Meta 發布說明
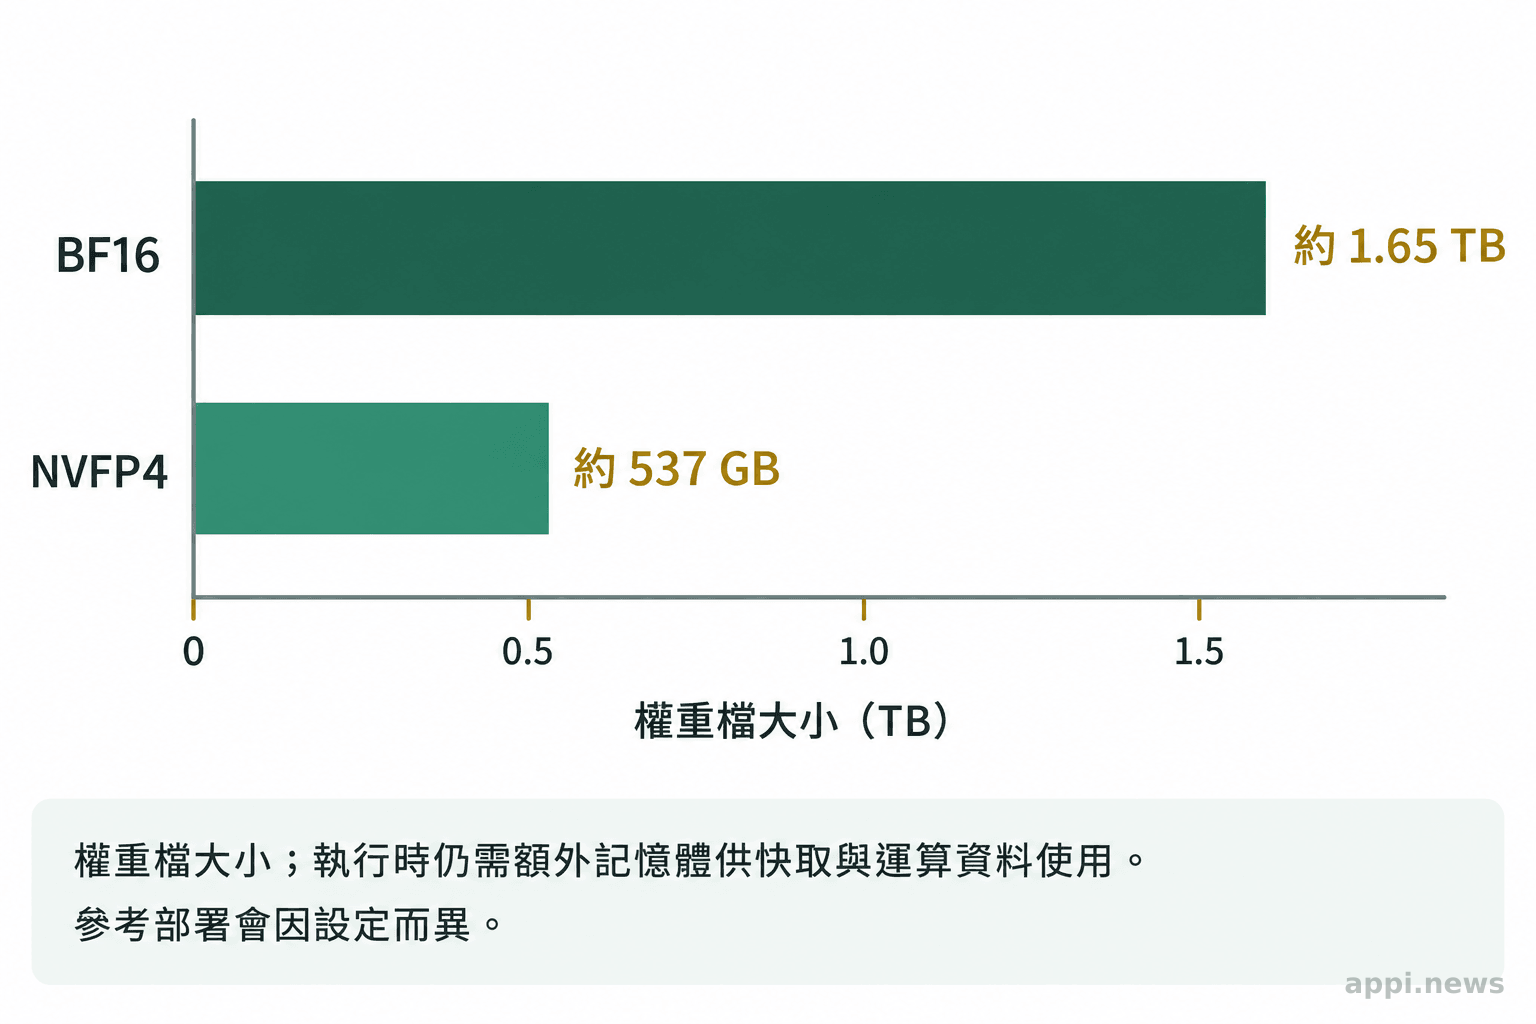
團隊也應把「權重檔案大小」與「服務所需記憶體」分開計算。Meta 開發者文件列出的 BF16 參考權重約 1.65TB,NVFP4 權重約 537GB。BF16 是較高精度的浮點格式;NVFP4 是以 4-bit 為主的低位元量化格式,能縮小權重檔案。
執行時還要留空間給 KV cache(儲存上下文鍵值的快取)、中間運算資料與推論框架,因此可用容量必須高於單純檔案大小。Meta 模型規格列出的 BF16 部署參考配置需要八張 GPU,例如 8 張 B300;NVFP4 則以單台四 GPU NVIDIA Blackwell 節點為例。這些是特定硬體環境的參考,不是所有團隊都能直接複製的最低採購清單。
量化能降低記憶體負擔,卻會引入品質與速度的取捨,且實際結果依量化版本、上下文與任務而異。模型卡將 NVFP4 與 BF16 列為可取得的權重格式,同時提醒量化推論在少數情境可能與全精度結果不同。評估者應以自己的輸入資料量測正確率、回應延遲、吞吐量與錯誤恢復情形,不宜拿某一個核心或理論運算數據替代整體服務體驗。
開放權重不等於沒有使用限制
Muse Spark Open 採用 Muse Model License,使用者仍須遵守授權和可接受使用政策。 取得權重、微調或自行部署的可能性,不等於模型是沒有條件的公有領域軟體。
模型卡和 Meta 發布文章都列出 Muse Model License。授權條款要求在模型或衍生版本的副本中保留授權與使用政策,並要求在使用模型的產品介面或隨附文件、網站、設定頁等位置,顯著標示「Built with Muse Spark Open」。條款另規定,若公司或其關係企業透過 API 等形式提供模型服務,且連續十二個月期間的合併總營收超過 2,000 萬美元,須先通知 Meta,並在提供該服務前另行簽署書面協議。
這些條文會影響產品介面、商業模式和法務審核,導入前應直接閱讀完整版本,而非只看模型卡上的授權名稱。若組織透過子公司或關係企業共同經營服務,也要確認營收計算方式和誰負責與授權方聯繫。若產品會把模型微調成果提供給客戶,還應確認衍生模型定義如何適用於這個交付方式,並把版本、授權文件與模型來源一併記錄,避免日後無法追溯。
授權亦納入可接受使用政策,並把安全部署責任交給部署者。模型卡提醒,模型可能產生不準確、有偏見或令人反感的回覆;若以代理形式執行多步工作,應依應用情境加入額外防護,在會造成不可逆結果的操作前保留人工確認。若產品會面向未成年人,或處理高度敏感資料,更需要先評估適用規範、風險與使用者告知方式。
「開放權重」描述的是權重可供取得與自架,不涵蓋所有人們常以「開源」理解的條件。團隊仍要確認授權允許的用途、衍生模型義務、對外提供服務的條款、品牌標示要求,以及上游模型與工具版本的更新方式。若商業模式靠提供模型 API,應特別檢查營收門檻和另簽協議條款;若只在內部使用,也要確認內部產品是否仍須標示、政策是否允許預定用途。
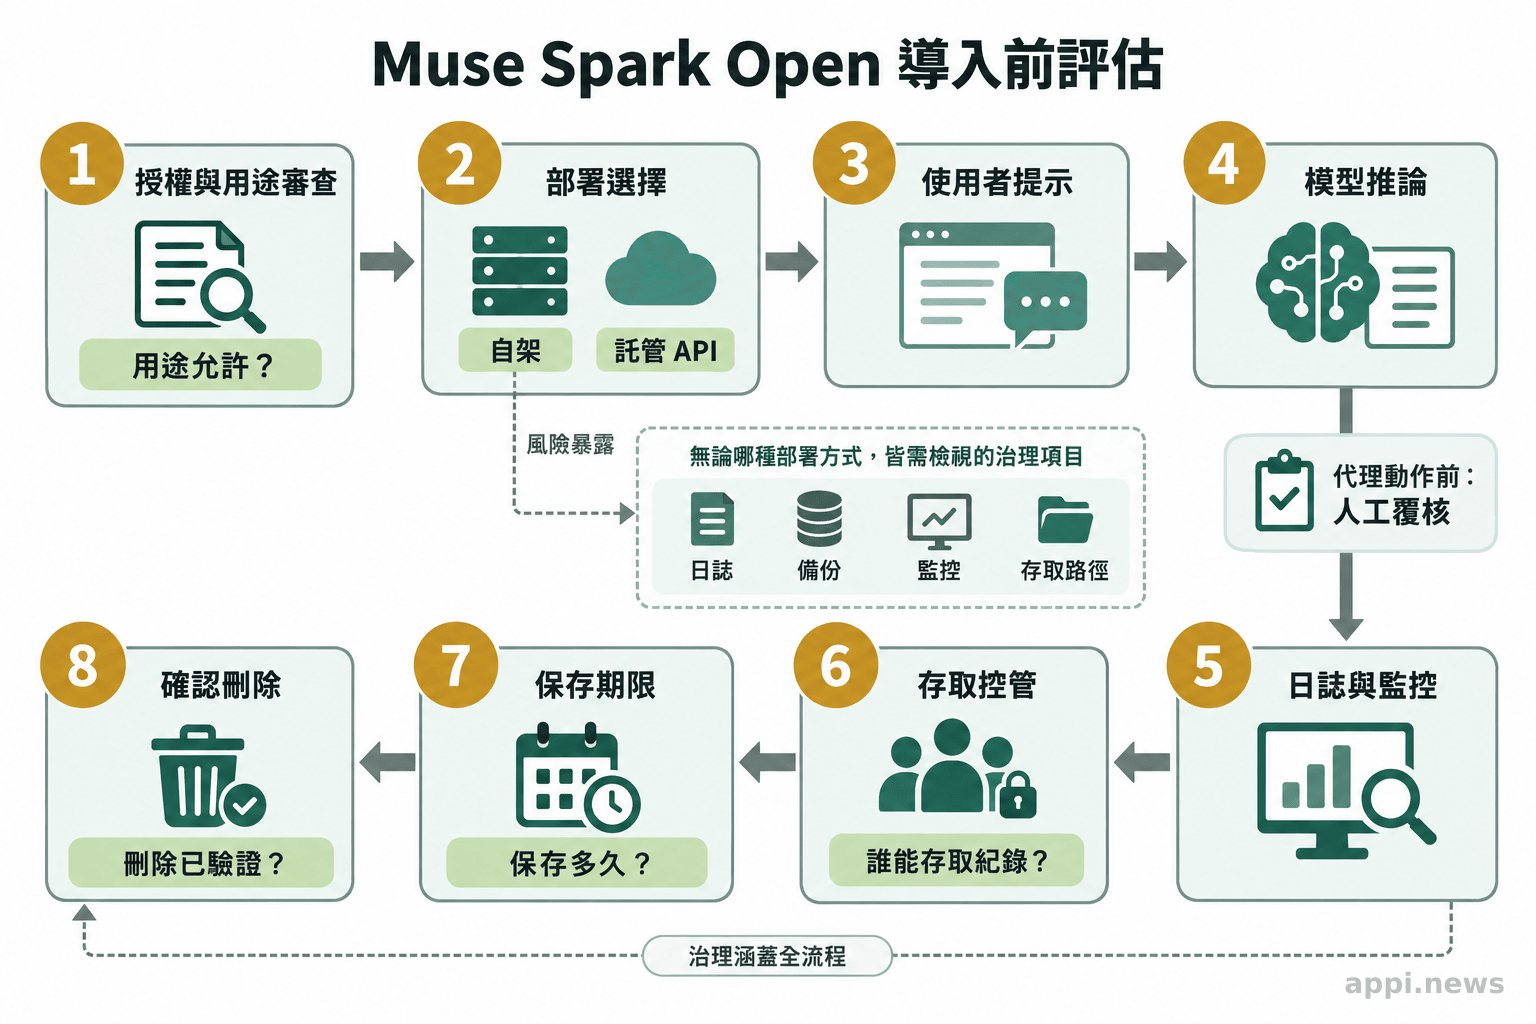
資料治理則取決於部署鏈路。Meta 開發者文件將自架描述為在自有 GPU 上提供服務,讓提示與回覆留在自家基礎設施;託管 API 則由服務供應商接收請求。即使模型在地端推論,存取權限、提示記錄、監控平台、備份、模型下載帳號與日誌保留都可能讓資料流出預期範圍。採用 API 時,還要檢查供應商的資料留存、訓練使用、區域、故障處理與刪除政策。部署方式只決定資料流的一部分,完整治理要追蹤請求進入到記錄刪除的整段生命週期。
Meta 模型卡建議,依應用情境加入額外防護;代理執行可能造成不可逆後果的操作時,應保留人工確認。
團隊該試用、地端部署,還是先觀察?
先用實際任務做小型概念驗證,再依資料敏感度、硬體預算與維運能力選擇路徑。 權重公開和展示案例可以形成候選方案,不能代替團隊的品質、成本與整合測量。
本地部署、託管 API 與延後採用,承擔的成本和控制權不同。下表是評估方向,實際價格、供應區域、服務條款和可用配額要以選定供應商的當期資料為準。
| 路徑 | 適合先確認的條件 | 主要投入與風險 |
|---|---|---|
| 本地部署 | 資料需留在自有環境,且已有可用 GPU 或指定 Mac Studio 配置 | 需承擔權重儲存、硬體採購、推論服務、更新、資安與值班維運;大型權重對記憶體與網路要求高 |
| 託管 API | 想先測試能力,暫無足夠硬體或維運人力 | 無需自行建置 GPU,但要檢視請求資料處理、計費、速率限制、服務區域、供應商依賴與退出方案 |
| 暫緩導入 | 使用情境尚不清楚,或授權、風險與既有系統接點未釐清 | 短期不承擔部署成本;持續追蹤模型版本、授權與供應服務變化,避免把等待當成評估結束 |
概念驗證要回答「它替哪個流程減少多少工作、錯誤落在哪裡、失敗後如何回復」。例如團隊想用多模態模型讀取產品截圖,就應準備有代表性的畫面,包含低解析度、表格、小字、語言混用與容易誤判的邊界案例。若測試程式代理,則以有明確驗收條件的修補任務評估修改品質、工具呼叫、測試通過率與人工檢查時間。不要只挑最容易成功的展示例子,也要記錄失敗類型。
成本比較要把硬體折舊、電力、儲存、網路、工程人力、監控、安全審查與閒置時間算進去。API 則記錄每種請求的輸入輸出 token、重試頻率、等待時間和服務計費。若工作量零散,建置本地服務的閒置成本可能高於 API;若長期處理敏感資料,合約與治理要求又可能使自架更合適。這不是固定答案,需依工作量和責任要求計算。
導入前可按以下順序完成一次小型評估:
- 列出預計處理的任務、使用者、資料敏感度與錯誤後果,先排除授權不允許或風險無法承接的用途。
- 依任務準備一組包含一般案例與失敗邊界的測試資料,訂出品質、延遲、吞吐量與人工覆核門檻。
- 依實際權重格式和上下文設定測量 GPU/統一記憶體需求,並把部署、日誌、權限和備份納入資料流圖。
- 在可比條件下測試本地與託管方案,記錄總成本、失敗處理和維護工作,再由工程、資安、法務與使用單位共同決定是否擴大。
- 42B 啟用參數不代表只需容納 42B 權重;服務仍須載入 816B 總權重。
- Mac 執行展示依賴兩台 M5 Ultra Mac Studio 和 MLX,不能泛化到所有 Mac。
- 權重可取得不等於授權無限制;用途政策、產品標示與商業服務條款都要逐條核對。
- 導入判斷應來自團隊自己的品質、資料治理、成本與維運測試。
常見問題:Muse Spark Open 部署與授權
判斷時應分開看模型規格、部署方式與授權條件。 以下整理硬體、授權、微調及資料隱私四個常見問題。
常見問題
Q1:42B 啟用參數代表可以用 42B 規模的顯示記憶體嗎?
不代表。42B 是每個 token 推論時啟用的參數量,Meta 開發者文件說明服務時仍要載入完整 816B 權重,此外還需為 KV cache、運算資料及執行框架預留空間。
Q2:一般 MacBook 可以執行 Muse Spark Open 嗎?
Meta 公開的 Mac 示範使用兩台 M5 Ultra Mac Studio 和 MLX。這項示範不能證明一般 MacBook 或單台較舊 Mac 可執行相同版本、速度或工作量。應依官方支援條件與實際可用記憶體評估。
Q3:Muse Spark Open 是完全開源、沒有商用限制的模型嗎?
不是。模型以 Muse Model License 發布,並受可接受使用政策約束。授權包含產品標示及特定模型服務營收條件等要求,商業用途應先核對完整授權條文。
Q4:本地部署就能確保資料不外流嗎?
本地推論可減少請求交給外部模型 API 的情況,但日誌、備份、權限、監控與模型下載仍會形成資料流。應檢查每一個處理環節的存取方式、保存期限及刪除機制。
在投入大規模硬體前,團隊可先明確列出任務、資料敏感度與現有設備,再以小型概念驗證比較本地與託管服務。當輸出品質、延遲、授權範圍、資料流和維運責任都有實測依據後,才適合決定是否擴大使用。


