
目錄(5 節)
微軟在 2026 年 11 月 13 日公布 Windows 本機 AI 模型更替計畫:Aion Instruct 將接替 Phi Silica,最大輸入上下文從 3,500 提高至 32,000 tokens。微軟公告
但這裡要先問一個更前面的問題:更大的輸入範圍,能否讓長文件摘要少拆段、少漏掉例外?
Aion Instruct 何時推送,現在可以開始測什麼?
微軟規劃 2026 年 12 月 4 日起向 Copilot+ PC 的 Windows Insider 裝置分階段推送,正式版裝置則以 2027 年 1 月下旬為目標。截至 11 月 16 日,這仍是待執行時程。
Aion Instruct 透過 API(應用程式介面)將摘要、改寫等能力接進軟體。買到 Copilot+ PC,不代表軟體已採用新模型;可先核對Copilot+ PC 的版本與功能開放條件。
開發者已有另一條測試路徑。微軟提供獨立驗證套件,官方預覽範例包含聊天、文字處理與 LoRA(低秩適配)驗證介面,可在 Windows 正式交付前檢查整合。套件限定開發驗證用途,不可隨產品交付給終端使用者,其測量效能也不代表正式版結果。
Windows AI 文件說明,Insider 過渡期間會保留 Phi Silica,由受控推送決定啟用的模型。
32,000 tokens 能減少哪些長文件卡點?
32,000 除以 3,500 約為 9.14,代表輸入上限約為原來的 9.1 倍。較完整的文件有機會放進同一次請求,但容量規格無法直接換算成答案正確率。
Token(詞元)是模型處理文字的切分單位,不等於中文字數,中英文與程式碼的切分會不同。32,000 tokens 也非輸出長度承諾;可用文件空間還受指示與對話內容影響。
| 比較項目 | Phi Silica | Aion Instruct |
|---|---|---|
| 官方列出的參數量 | 38 億 | 23 億 |
| 最大輸入上下文 | 3,500 tokens | 32,000 tokens |
| 自訂 LoRA | 依原模型訓練 | 原有適配器無法直接沿用 |
數值來自微軟公告,LoRA 相容性見透明度說明。技術報告尚待公布,目前無長文件品質提升幅度的實測數字。
為什麼少拆文件可能有價值?規格的期限在前章、例外在附錄,分段摘要後須重新整理兩者關係。較長輸入可能減少合併步驟,但模型若未抓到附錄,仍會漏答。
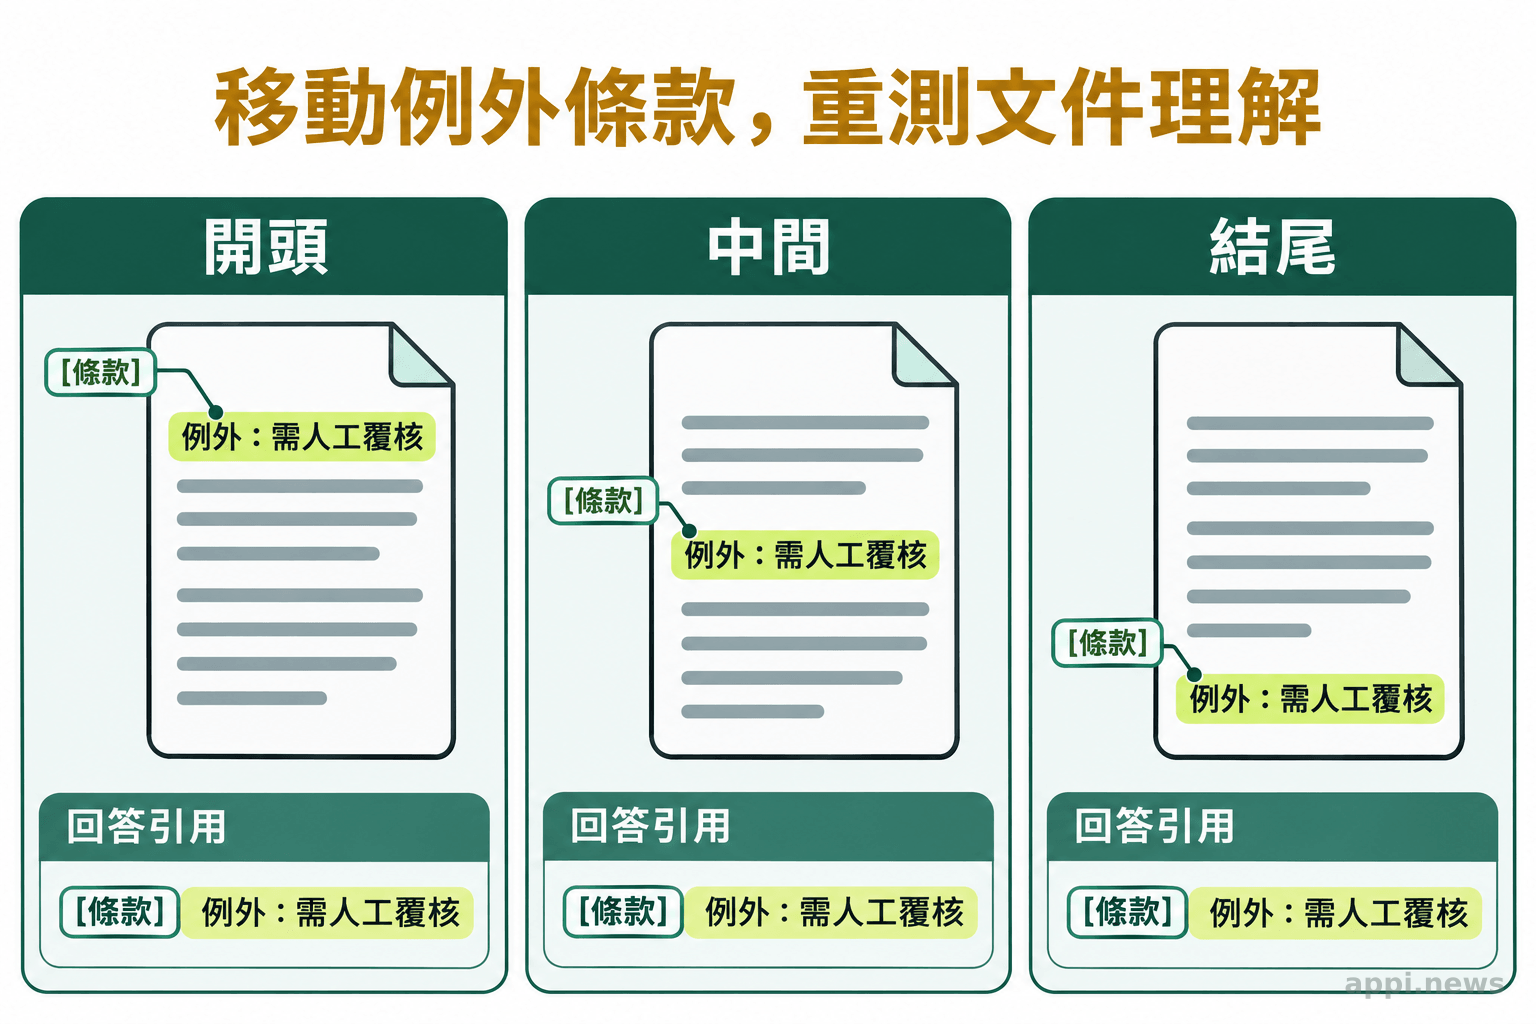
Liu 等人在 2024 年《Lost in the Middle》研究中,以多文件問答與鍵值檢索兩項任務測試多款模型,發現相關資訊移到長輸入中間時,部分模型表現明顯下降。研究未測 Aion,提供的是驗收長上下文的方法依據。研究原文
可優先試三類任務:跨章摘要是否保留例外;多份規格比對是否列出衝突與出處;長指示整理是否遵守全部欄位要求。這些是建議測試項目,尚非已證實的 Aion 成效。繁體中文工作尤其應使用自己的中文文件驗收。
另一個真實測試來自 NVIDIA 的 Hsieh 等人。團隊在 2024 年提出 RULER 長上下文評測,以 13 項任務測試 17 款模型,加入多筆資訊檢索、關係追蹤與彙整,觀察模型能否從「找出一條答案」進一步完成複合工作。研究 PDF
受測模型都宣稱可容納至少 32,000 tokens,但在研究設定的品質門檻下,只有約一半能在這個長度維持合格表現。團隊以 Llama 2 7B 在 4,000 tokens 的成績作門檻,並非通用及格標準;這是合成任務研究,未測 Aion,也不能代替繁體中文文件驗收。
這個落差可轉成測試設計:若工作需要列出所有交付條件,就應要求模型同時找出期限、責任人與例外條款,再逐一核對,避免只問一個容易找到的日期。答對單題,仍不足以證明整份規格已整理完整。
準備跨文件比對時,可保留文件名稱、版本日期與章節編號,要求每個差異附上兩邊出處。若來源互相矛盾,預先規定答案要列出衝突,不可自行選一個版本。如此才能分辨錯誤來自漏讀、版本混用,或是把兩項不同條件合成一句話。
Liu 等人的研究指出,受測模型往往較能使用輸入開頭或結尾的相關資訊,放在中間時表現會下降。(研究結論意譯)
支援 GPU,是否代表一般 Windows 電腦都能用?
微軟宣布將擴展至支援的 GPU,包括 NVIDIA RTX 系列與 AMD RDNA 4 世代顯示卡,但硬體組態會分階段開放。不能把系列名稱當成所有機型立即適用的保證。
GPU 是圖形處理器,NPU 是神經網路處理單元。驅動、記憶體與耗電條件不同,測得的等待時間不能跨裝置套用。
採購或部署 Aion 時,須核對對應版本的條件,不能套用舊模型規格。台灣使用者應先確認目標軟體採用的模型,再確認硬體與推送資格。
裝置驗收可分成三張紀錄:系統版本與更新通道、模型是否已下載就緒、應用程式能否完成指定任務。這是建議的排查順序。遇到功能未出現,先定位卡在哪一層,才知道應等待推送、補齊元件,或向軟體開發者確認支援進度。
同一台筆電也應分別測接電與電池模式,並記錄背景是否同時執行視訊會議或其他工作。比較時保留相同文件及輸出要求,避免把電源設定或其他程式造成的等待,直接歸因於模型。預覽環境的紀錄另存,正式版本開放後再依原條件重跑。
本機模型只涵蓋資料流程的一段,文件辨識或結果同步仍可能經過外部服務。離線作業應檢查AI PC 的模型與資料路徑,並在元件下載後實際斷網測試。
換掉 Phi Silica,為什麼既有應用仍要重測?
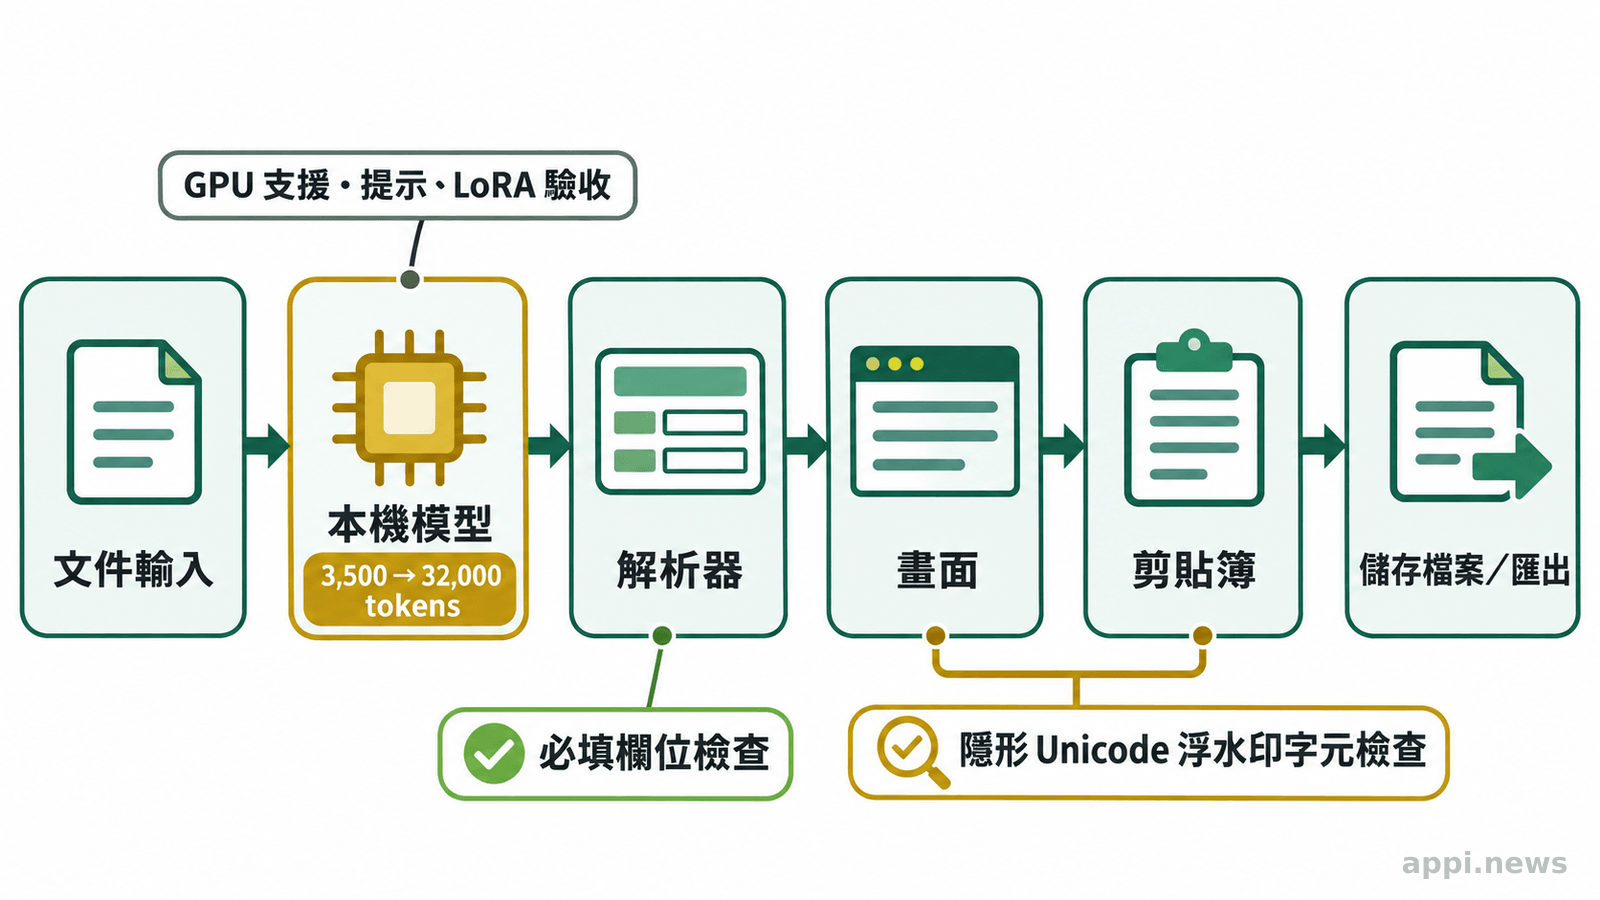
優先檢查自訂提示、LoRA 與輸出解析。介面延續可降低改接成本,模型行為改變仍可能影響既有流程。
LoRA(低秩適配)是用較少額外參數調整模型的方法。微軟明確說明,Phi Silica 的 LoRA 與 Aion 不相容,須用 Foundry Toolkit 建立新適配器。成功載入只代表通過相容性檢查,仍要驗證原本的分類、改寫或摘要任務。
提示須保留指定用語、分類與欄位的測試樣本,換模型後逐項比對。
另有一個已明列的整合問題。Windows AI 浮水印文件說明,部分文字 API 會插入由四個 Unicode 字元構成的隱形標記,一次回答可能包含零個、一個或多個,位置也會變動。
這會影響 JSON(結構化資料格式)解析、Markdown 排版與文字編碼轉換。驗收要涵蓋生成、顯示、複製、儲存及匯出;不能只看畫面上的字。若要移除標記,還須考慮應用所適用的 AI 內容標示要求。
微軟在 Aion 預覽套件透明度說明中提醒:新模型的行為與 Phi Silica 不同,開發者不可依賴確定不變的輸出。(官方指引意譯)
如何判斷長上下文值得導入?
用同一批文件比較既有分段流程與較長輸入流程,連同人工修訂時間一起計算。先訂成功條件,才能判斷增加容量是否換來可用成果。
- 選一份常被拆段的文件,另留短文作對照;先寫好必答項與原文位置。
- 固定提示與輸出要求,記錄模型、Windows 版本、硬體及是否接電,兩種流程各重複數次。
- 核對漏項、錯誤與引用位置,再把關鍵條款移到文件中間重跑。
- 記錄首次回應、完成與人工修正時間,同時觀察記憶體、處理器負載與耗電。
- 檢查斷網、超長輸入及解析失敗時的處理方式;開發者另測自訂提示與新 LoRA。
漏項率可用「未涵蓋的必答項數 ÷ 必答項總數」記錄,答錯另計。比較新舊模型會同時涉及容量與行為改變;可再於 Aion 內比較分段與整份輸入,辨認長輸入的效果。
以建議的規格比對驗收為例,先由人列出十個必答條件;若模型漏掉兩項,漏項率就是兩成。若另有一項期限寫錯,應另記錯誤,不能把它算成已正確完成。這是計分示例,不是 Aion 的測試成績;不同工作可自訂必答項數。
驗收也要事先決定哪些錯誤會阻止交付。內部草稿或可容許人工補寫,涉及付款期限、授權範圍的摘要,則應要求逐條覆核。把容許標準寫在測試前,能避免看到流暢答案後才放寬要求,也方便不同人用相同標準評分。
時間紀錄可拆成文件整理、模型等待、人工核對與修改。若整份輸入減少了合併步驟,卻增加查錯時間,總工時可能仍未下降。保留原始輸入、完整輸出與人工修訂紀錄,後續更新模型時才能確認改善發生在哪個環節。
- 長上下文的價值,要看能否減少漏項與人工合併工作。
- 推送資格、模型就緒與軟體支援須分別確認。
- 保留一組文件與標準答案,讓後續模型更新也能重跑驗收。
常見問題
Q1:Aion Instruct 現在已經全面可用了嗎?
截至 2026 年 11 月 16 日尚未全面推送;開發者驗證套件與 Windows 分階段交付是不同途徑。
Q2:32,000 tokens 等於多少中文字?
沒有固定字數換算,需依文字內容與模型切分方式確認,並預留指示及對話空間。
Q3:本機推論能保證文件不外傳嗎?
仍要檢查應用程式的上傳、同步與外部服務路徑;斷網能否完成整個任務也應實測。
參考來源
- Al-Joundi C.(2026)。Microsoft Aion Instruct: Advancing local AI on Windows and expanding to GPU。Microsoft Foundry on Windows Blog
- Microsoft(2026)。Get started with Phi Silica in the Windows App SDK。Microsoft Learn
- Microsoft(2026)。microsoft/Aion-Instruct-Preview-Sample: Sample app showing on-device language model inference with the Aion Instruct Preview Framework on Windows Copilot+ PCs.。GitHub
- Microsoft(2026)。Aion-Instruct-Preview-Sample/TRANSPARENCY_NOTES.md at main。GitHub
- Liu NF, et al.(2024)。Lost in the Middle: How Language Models Use Long Contexts。Transactions of the Association for Computational Linguistics, 12, 157–173。研究 PDF
- Microsoft(2026)。Watermarking in Windows AI text APIs。Microsoft Learn
- Hsieh CP, et al.(2024)。RULER: What's the Real Context Size of Your Long-Context Language Models?。Conference on Language Modeling (COLM)。研究 PDF


