
目錄(5 節)
DeepSeek 在 2026 年 11 月 13 日宣布,將官方 App 的搜尋、文件輸入、連結閱讀、安全檢查與語音能力開放為 API(應用程式介面),其中搜尋、網頁擷取、光學文字辨識、語音辨識與文字轉語音另提供五種獨立介面。開發團隊可把能力接入自己的產品,但先要決定:讓模型自行調用工具,還是由程式安排每一步?這會改變資料流與帳單。官方發布公告
對正在做客服、資料查詢或文件助理的台灣團隊,新增介面提供了可測試的元件。官方規格與示範能說明接法,產品的準確度、延遲及成本效益仍須用自己的任務驗收。
DeepSeek 這次的應用 API,和模型 API 差在哪裡?
模型 API 負責生成回答;應用 API 補上搜尋、讀取文件與語音等環節,可由模型調用,也可由程式獨立安排。
官方公告列出,deepseek-flash 可在對話中使用搜尋、連結閱讀與文件輸入,搜尋與讀取結果由服務端組入上下文,也就是模型當次回答可參考的資料。公開對外的應用須啟用安全檢查,開發者仍負有內容管理責任。
另一個案例是官方團隊將附件、語音輸入與回答朗讀整合成 chat-demo 聊天示範,並釋出可下載的靜態成品。依 README,使用者解壓後開啟 index.html、填入金鑰即可聊天,瀏覽器直連 API,省去架設應用後端;本機開檔仍須瀏覽器儲存與服務跨來源請求支援。示範程式採 MIT 授權,散布時須保留授權,第三方依賴另有條件。
這個示範讓團隊有現成介面可試,卻也帶出產品差異:個人自行輸入金鑰,和公司替所有使用者承擔費用,所需的權限與額度管理不同。商用設計應先釐清誰持有金鑰、誰能發起付費請求。
兩種接法還影響除錯方式。模型自行選工具時,要記錄它實際搜了什麼、讀了哪些頁;程式指定流程時,則要處理每一步的回傳與例外。團隊能否追出錯誤來源,是選擇接法的具體判準。
若團隊需要指定搜尋來源、保存中間結果或固定處理順序,可選獨立介面。既有的搜尋 API 與 Fetch 分工解析可作背景;這次評估則要把文件和語音一併納入流程。
搜尋、文件解析與語音,各自處理到哪一步?
搜尋負責找資料,Fetch 擷取網頁,文件介面處理內容輸入,語音介面負責聲音與文字轉換;後續判讀與核對仍要另外設計。
搜尋到網址後,還要決定讀哪些頁面
Search & Fetch 文件說明,Search 回傳結構化搜尋結果,Fetch 則將單一網頁擷取為 Markdown 文字格式。獨立 Search 目前不支援圖片搜尋,圖片搜尋由對話中的內建工具提供。
為什麼搜尋成功仍可能答錯?搜尋結果與回答所需證據可能不同,目標網站也可能禁止擷取。產品可保留來源網址、檢查日期,並在正文取不到時顯示失敗,避免只靠摘要生成確定答案。
文件問答與取出文字,是兩種需求
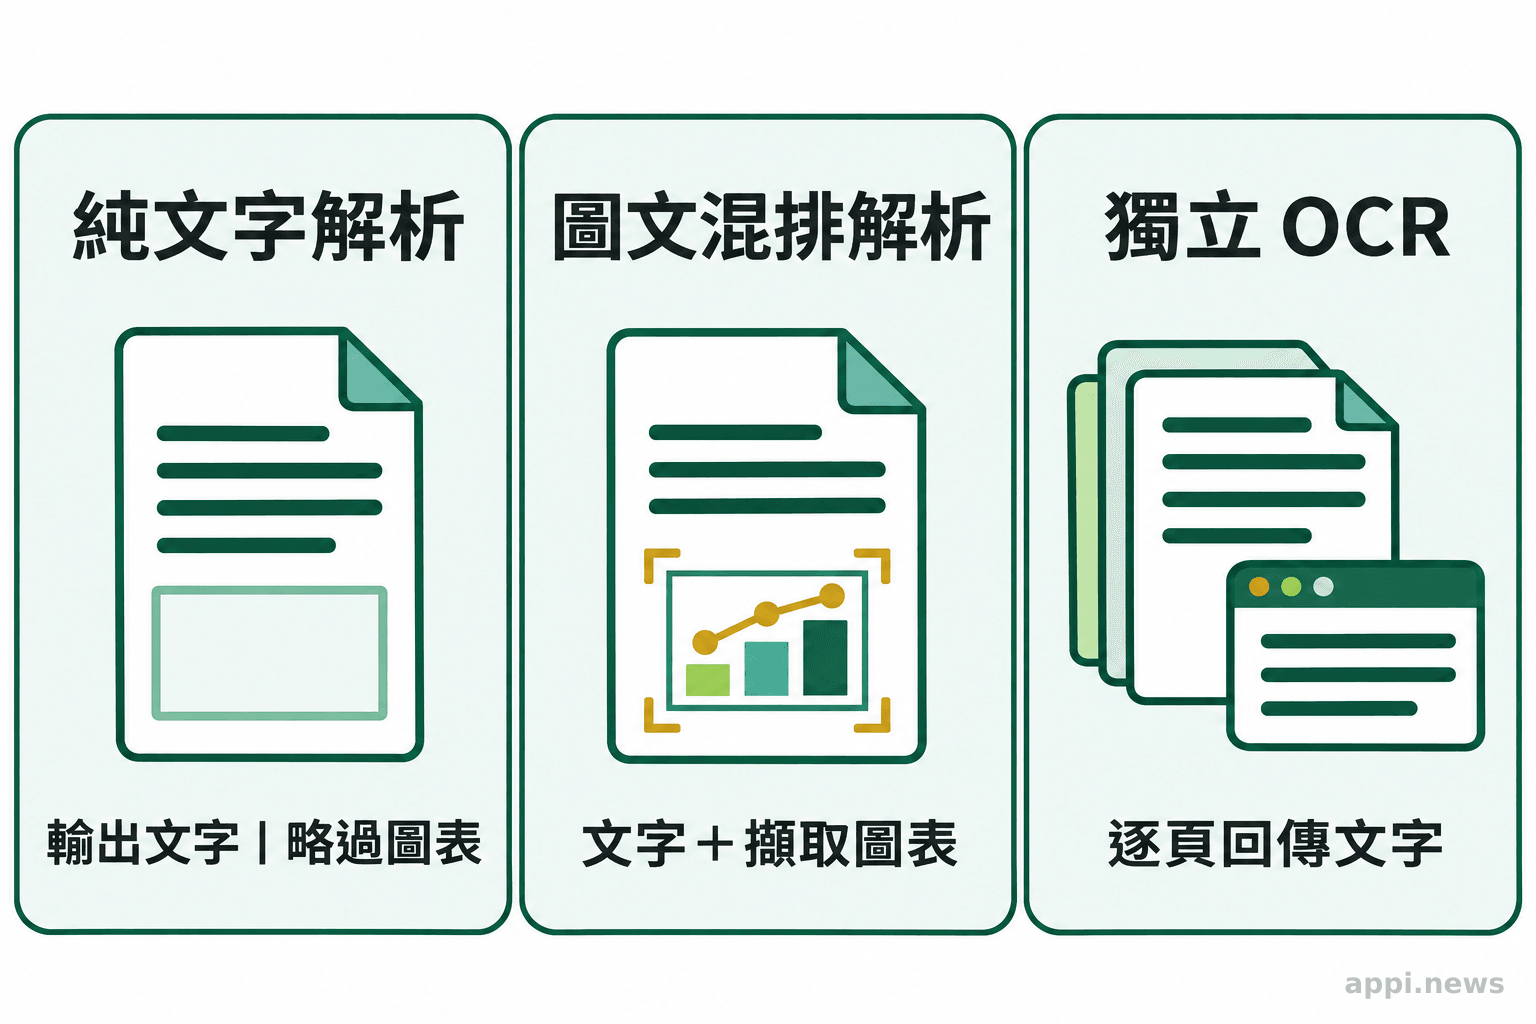
文件解析提供純文字與圖文混排兩種模式。官方以財報營收趨勢圖為例:純文字模式會丟棄圖表;圖文模式將偵測到的圖片裁切後交給模型,但無法保證每張圖都被偵測。
DeepSeek 文件解析指引說明:圖文混排模式裁出的圖片會占用模型輸入 token(文字或影像的計量單位),也計入每次請求的圖片數限制。選擇模式須看問題是否需要圖像資訊。File Parsing
文件辨識的實驗案例來自 DeepSeek-AI 的 Wei 等人:2025 年的 DeepSeek-OCR 研究以 Fox 基準測試文件影像還原文字。作者報告,文字 token 與視覺 token 的比值低於 10 倍時,辨識精確度可達 97%;壓縮至 20 倍時降至約 60%。這是該研究模型的實驗結果,不能當成此次雲端 API 的品質承諾;團隊驗收時應同時檢查輸入壓縮程度與文字錯漏。
這次開放的獨立 OCR(光學文字辨識)API 則將文件逐頁轉成結果,不存入 Files API,也不送進聊天模型。官方列出的上限為 100 MiB、1,000 頁;輸出若標示 length,代表該頁文字不完整。OCR 文件
只要文字欄位的匯入工具,可評估 OCR;要追問文件內容的助理,可評估檔案上傳後引用檔案識別碼。金額、表格欄位與頁碼都應對照原件,先定義哪種錯誤會阻止後續流程。
語音輸入與朗讀,不能合併看成即時通話
ASR 自動語音辨識一次上傳音檔後回傳完整文字,不支援串流辨識,每段上限 120 秒、8 MiB。因此短語音輸入可先試,長會議與邊說邊回的客服需另做分段或替代設計。
TTS 文字轉語音提供全文與串流輸入,可用於朗讀回答。台灣產品仍應用國語、中英混用、姓名與地名測試;文件列有中文支援,不能直接推定台語支援或台灣口音辨識品質。
串接費用怎麼估?先拆開工具、文件與模型
搜尋與擷取依次數計費,文件解析與 OCR 依頁數,語音依時長或字元;把結果交給模型時,再計模型輸入與輸出費。
以下為 2026 年 11 月 14 日英文官方定價頁所列美元價格;語音優惠未列固定截止日,採購前須重新核對。
| 能力 | 計價單位 | 官方標價 | 估算要補什麼 |
|---|---|---|---|
| Search/Fetch | 各每千次成功請求 | 各 0.75 美元 | 一次提問可能觸發多次 |
| 文件解析/OCR | 每千頁 | 0.225 美元 | 文件進入對話後的輸入費 |
| ASR | 每小時音訊 | 原價 0.116;限時 0.058 美元 | 分段、重送與人工校正 |
| TTS | 每萬計費字元 | 原價 0.45;限時 0.225 美元 | 中文字的加權計數 |
假設每月有一萬次任務,每次成功搜尋一次、擷取兩頁,工具費為「10,000 × 0.75 ÷ 1,000 × 3」,合計 22.5 美元。這是情境試算,尚未加入模型、文件、語音與維運費。搜尋空結果、失敗或逾時不計該次工具費,仍會增加等待與處理成本。
DeepSeek 的 TTS 計費規則將一個中文字算作兩個字元,其他字元如英文字母、數字與空格各算一個;一千個純中文字會占兩千個計費字元。Text to Speech
文件解析成功後只收一次解析費,後續引用仍收模型輸入費。客戶端斷線也不代表停止解析,成功後仍可能計費;重送前應先查檔案狀態。成本失控的原因,可能是同一份內容反覆處理,而非單價高低。
台灣開發者開始整合前,要確認哪些條件?
先確認帳號與付款是否適用、所需功能能否呼叫,再核對語言、資料保存與刪除條件;能開啟文件並不等於所有接入條件都已滿足。
台灣帳號能否完成申請、驗證、付款及使用全部功能,仍須向官方確認。可從官方協助入口或支援窗口詢問付款方式、企業帳務與服務條件,再以預定部署環境做小額測試。
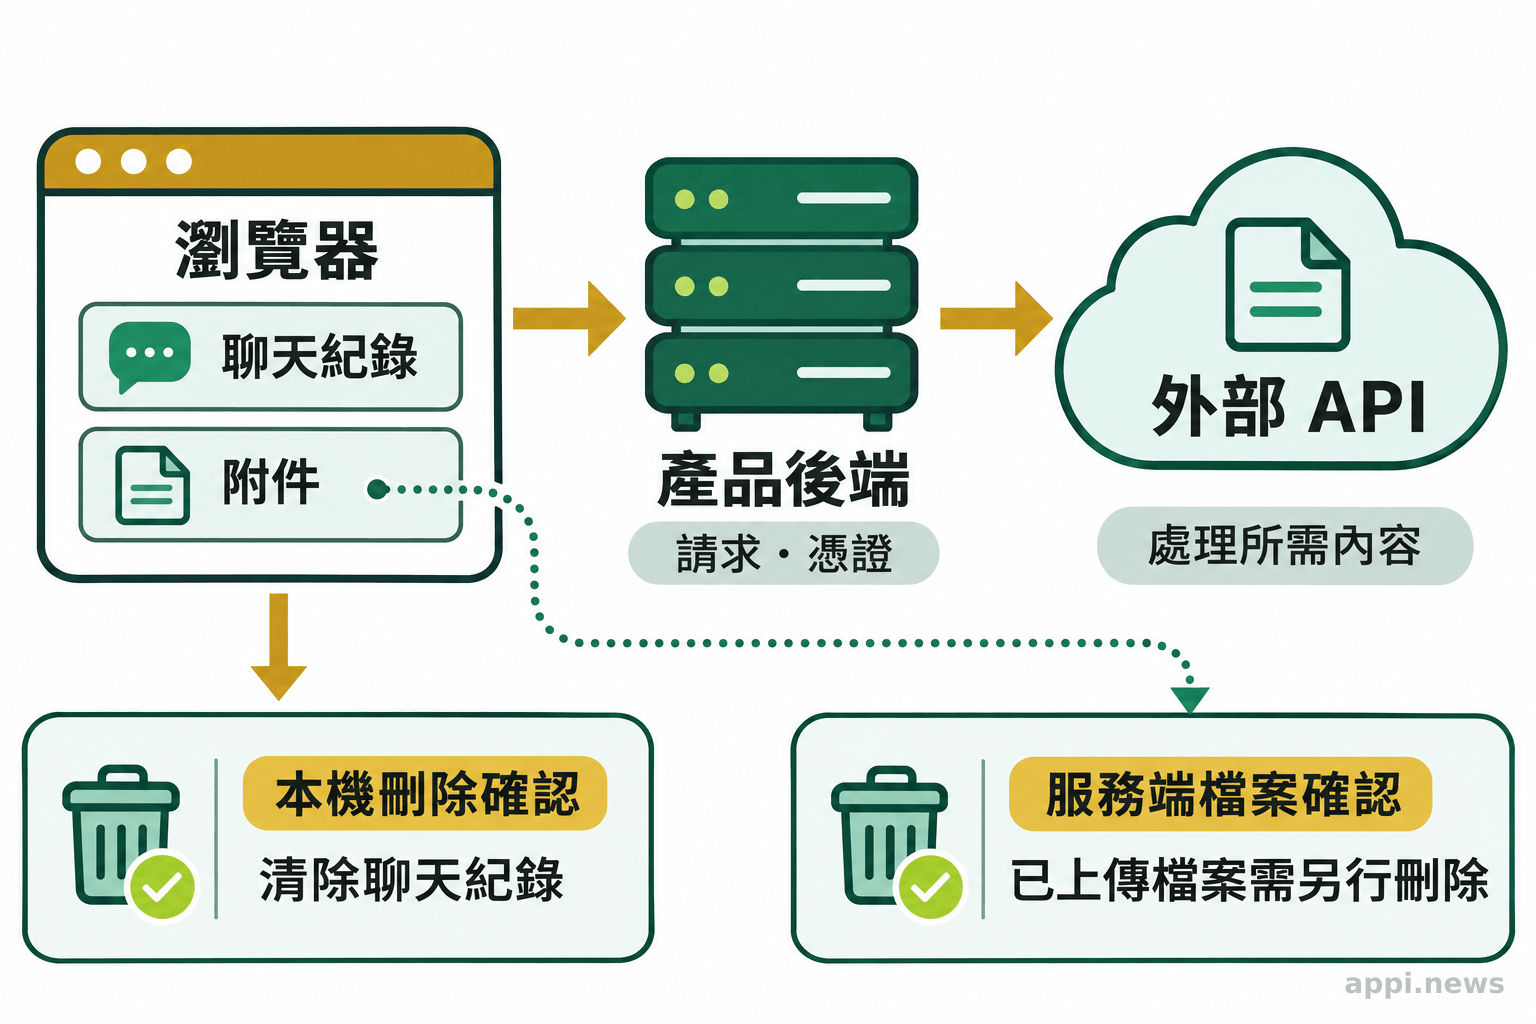
資料流要畫到服務端。chat-demo 將對話與附件放在瀏覽器資料庫,送出訊息、附件或使用語音時,相關內容會傳至設定的 API 服務;清除本機聊天,也不會刪除已上傳的服務端檔案。
個人資料、企業機密與錄音進入產品前,應確認傳輸、保存地點與期限、刪除機制、存取控制,以及是否用於訓練的資料處理條款。也要核對網頁與文件的使用授權,別把可擷取視為可任意再利用。
哪些產品原型適合先接入,怎麼決定是否擴大?
公開資料查詢、低敏感文件助理與短語音輸入可作測試起點;需要持續即時互動、不可外傳資料或自動執行高影響決策的流程,須先補驗證。
選原型時,先找能核對答案、失敗可退回人工的任務。模型回覆錯誤、網頁擷取失敗與文件解析不完整,應分開記錄,才能找出該改善的環節。評估方式也可參考AI 代理任務成本與測試設計。
驗收表也應留下原本流程的處理時間與錯誤數。若只記錄模型生成速度,就無法判斷新增的檢查、等待和校正是否抵銷了節省的時間。比較相同任務的整體完成成本,才有擴大整合的依據。
每次調整模型或解析模式,都應以同一批樣本再驗收,避免把版本變動誤認為資料品質變化。
- 選一個低敏感流程,寫下輸入、預期輸出與驗收負責人。
- 準備正常、缺頁、錯字與無法擷取的樣本,指定需人工覆核的欄位。
- 記錄成功請求數、文件頁數、模型 token、重試與覆核時間,估算完整任務成本。
- 設費用上限、延遲門檻與停止重試條件,保留來源和錯誤紀錄。
- 驗證資料刪除、金鑰權限與替代供應商接法,再決定是否擴大。
- 依流程決定內建工具或獨立 API,先測一個可核對的任務。
- 用完整任務算費用,同時納入人工覆核與失敗處理。
- 保留原始資料與可替換的介面,因應價格、規格或服務變更。
常見問題
Q1:DeepSeek API 能直接複製官方 App 嗎?
官方提供能力與聊天示範,團隊仍須設計帳號、權限、費用控制及驗收流程;示範不代表已有商用效能保證。
Q2:文件解析後,每次提問還會收費嗎?
會。成功解析按頁收取一次費用,之後引用文件的模型請求,仍按輸入與輸出 token 計費。
Q3:語音 API 可以拿來做台語即時客服嗎?
不能據現有規格直接承諾。ASR 不支援串流辨識,台語支援與實際辨識品質也須另外確認。
參考來源
- DeepSeek(2026)。The full DeepSeek App experience, now via API。DeepSeek API Docs
- DeepSeek(2026)。Chat Demo。GitHub
- DeepSeek(2026)。Search & Fetch。DeepSeek API Docs
- DeepSeek(2026)。File Parsing。DeepSeek API Docs
- DeepSeek(2026)。OCR。DeepSeek API Docs
- DeepSeek(2026)。Speech to Text。DeepSeek API Docs
- DeepSeek(2026)。Text to Speech。DeepSeek API Docs
- DeepSeek(2026)。Models & Pricing。DeepSeek API Docs
- DeepSeek(未標日期)。DeepSeek FAQ。DeepSeek
- Wei H, et al.(2025)。DeepSeek-OCR: Contexts Optical Compression。arXiv 預印本


