
目錄(5 節)
選本機 AI,先看任務、可用記憶體與部署工具。Hugging Face 展示 Inkling 2 Mini 讀取手繪分帳介面、產生單一 HTML 網頁:三次獨立嘗試中,展示的第一次通過 13 項檢查。這是發布合作方的示範,尚不能推論成所有專案的成功率。官方示範原文
要把模型接進編輯器或處理中文文件,先依本機模型的網路與工具權限檢查畫出資料流,再決定如何整合。
Inkling 2 Mini 能處理哪些工作?
它接受文字與圖片,輸出文字;官方定位包括程式輔助、聊天、工具使用及檢索增強生成,圖片理解則可與文字指令一起使用。
Thinking Machines Lab 於 2026 年 11 月 20 日發布此模型。模型卡列出的用途包含 RAG(檢索增強生成,即先找資料再交給模型回答),但建置知識庫仍要另外安排文件切分、搜尋與來源核對,下載權重不會自動完成這些工作。官方模型卡
理解草圖、截圖或圖表後,模型可輸出程式文字,由瀏覽器呈現網頁。圖片理解與直接生成圖片是不同能力。
「本機推論」指生成答案的運算在自己的裝置執行;「開放權重」指可取得訓練後的模型參數。至於常說的「開源模型」,仍須查看授權範圍。此模型標示 Apache 2.0,另連有可接受使用政策;導入產品前應一併核對,不能把可下載理解成用途毫無限制。
官方示範與獨立評測,分別能告訴你什麼?
官方示範可觀察完成任務的流程,獨立評測可比較指定題目下的表現;兩者都不能直接替代自己的裝置與資料測試。
另一個 Hugging Face 案例是《星夜》動畫:團隊提供參考圖與截圖工具,模型寫出網頁著色器,經過 24 輪截圖檢查再呈現成果。導入這種「生成、觀看、再修改」流程,應計入反覆驗證的時間。案例與操作條件
Artificial Analysis 的獨立評測則報告,Mini 在其 Intelligence Index 得到約 20 分,與 Qwen3.8 27B(xhigh)相當;同分下,Mini 平均使用約 15.2 萬輸出 token,後者約 11 萬。token 是模型處理文字的單位,不等同中文字數。比較能力也要看輸出消耗。獨立評測原文
Artificial Analysis 的評測以「啟用參數量乘上 token 數」作為計算量的代理指標;這個指標不等於個別筆電的耗電或實際等待時間。
模型卡記錄了中文表達截短與語言混用情形;繁體中文工作流應另驗專有名詞及段落完整性。語言限制說明
硬體需求怎麼看?啟用參數少,為什麼仍要較大記憶體?
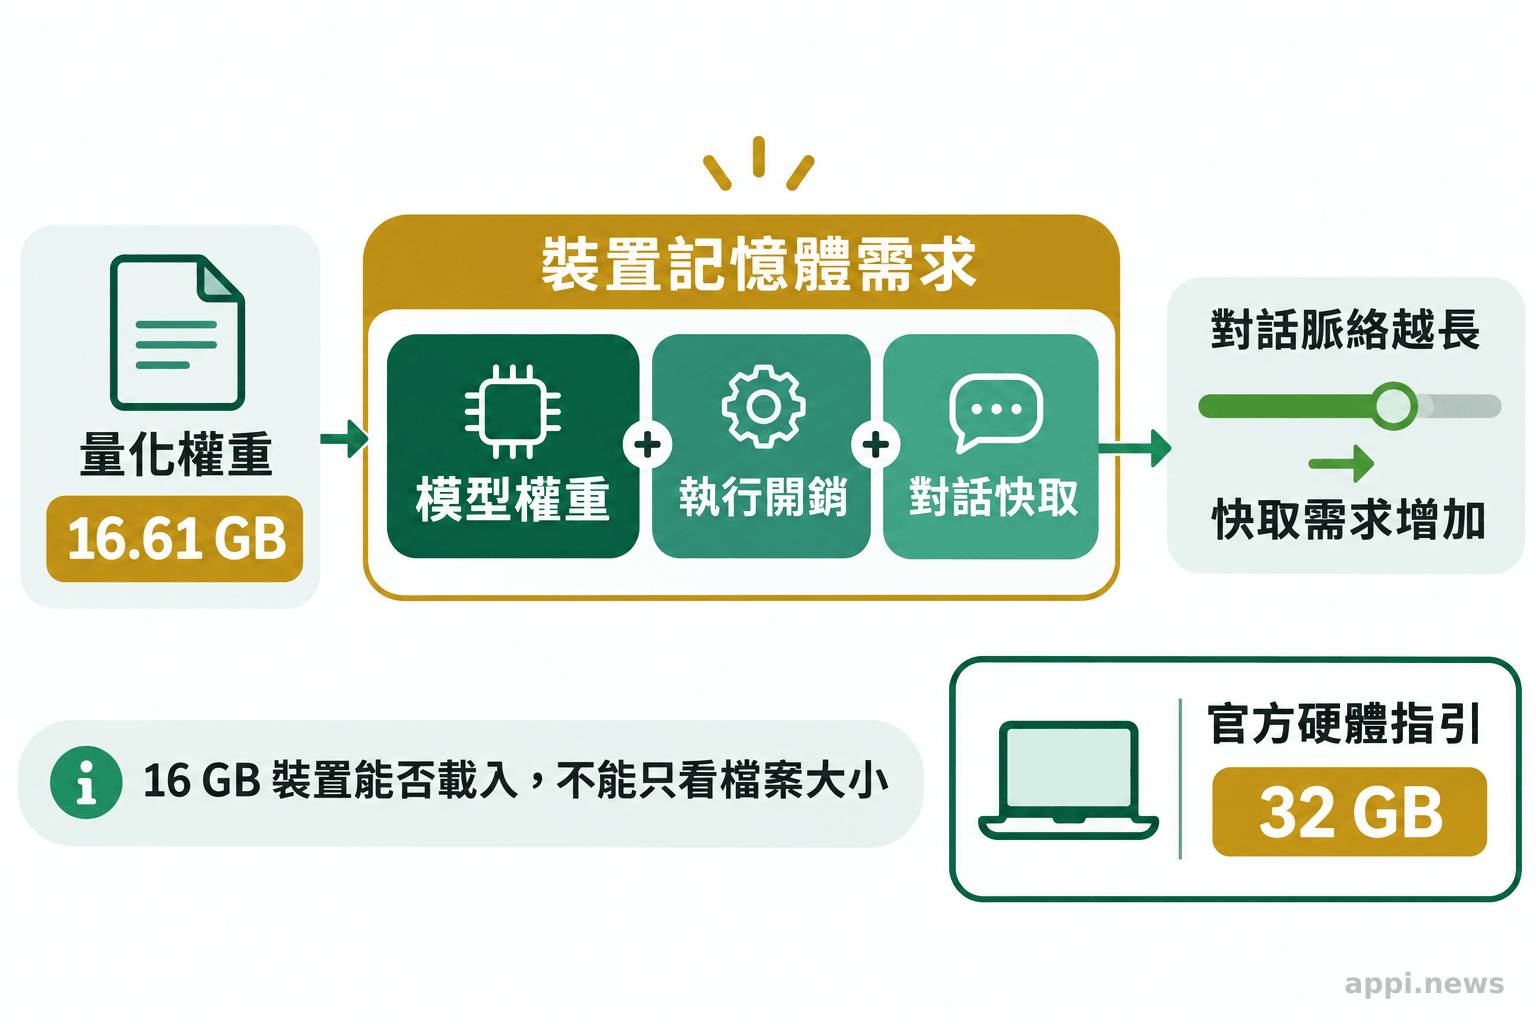
官方約 20GB 的混合精度權重,支援 32GB 以上記憶體的 Apple silicon 裝置與單台 DGX Spark;其他 GPU 平台建議至少 32GB 顯示記憶體,這是該權重的硬體指引。
模型卡列出總參數 26.4B(264 億)、啟用參數 3.4B,計入重複運算後為 5.4B。它採 MoE(混合專家架構,每個 token 選部分專家計算),並重複使用中間層。省下部分計算與儲存,不代表整組權重只需啟用參數那麼大的空間。參數與硬體規格
量化是用較低位元精度儲存權重。Unsloth 的版本清單中,UD-Q4_K_M 檔案約 16.61GB,UD-Q8_K_XL 約 22.87GB,相差約 6.26GB。這是檔案大小的比較,不能拿來判定 16GB 電腦一定能載入前者,還須為執行程式與對話狀態留空間。量化版本資料
上下文視窗是單次可容納輸入與輸出內容的範圍。官方上限達 100 萬 token,但長文件的執行需求仍要另外估算。先用短文件試跑,再增加長度,觀察記憶體峰值與等待時間。
評估量化版本時,可固定同一份輸入、提示與輸出長度,比較較小權重是否仍保留任務需要的細節。程式任務檢查能否執行及邊界條件,文件任務則檢查數字、名稱與段落有無遺漏。只有檔案縮小,還不足以判定這個版本適合工作。
上下文測試也應逐項調整:先固定量化格式,只增加文件長度;再固定文件,改變允許生成的長度。分開記錄讀入資料到開始回答的等待,以及回答完成的總時間,較容易辨認卡點出在讀入、生成,或記憶體不足。
若長文件測試超出裝置負荷,可先縮短輸入或分段處理,再檢查分段後是否漏掉跨段關係。對話持續多輪的情境,則應測試累積訊息後的需求,不能只用剛啟動時的一次短問答決定採購規格。
本機部署有哪些路徑,如何接進編輯器?
Hugging Face 發布文件提供 Transformers、llama.cpp/Llama App、MLX 與 SGLang 路徑;應依作業系統、權重格式及整合需求選擇,並確認使用的版本已有模型支援。
| 路徑 | 適合的工作 | 部署前核對 |
|---|---|---|
| Transformers | 用 Python 自訂處理流程 | 模型載入類別、依賴與多模態處理器 |
| llama.cpp/Llama App | 單機聊天、接編輯器 | GGUF 量化權重格式、圖片支援與介面設定 |
| MLX | Apple silicon 本機推論 | mlx-lm 的模型支援與原始權重載入方式 |
| SGLang | 伺服器整合 | 官方範例的 GPU 架構與啟動參數 |
框架成熟度與最低版本須分別核對。SGLang 範例指定 SM103(NVIDIA GPU 運算架構代碼),不能直接當成一般筆電的安裝指令。Llama App 則提供相容 OpenAI 格式的本機 API(應用程式介面),可供編輯器或腳本連接。部署文件原始檔
安裝前可把官方範例的套件版本、權重來源、啟動參數存成一份環境紀錄。若範例要求開發版本或指定硬體,先確認自己的環境能符合,再安排整合;只看到框架名稱出現在支援清單,仍不足以確認既有安裝可直接載入。
試跑可分成三關:先讓單次文字請求取得回答,再測圖片輸入,最後才接編輯器與工具。每一關留下輸入、回傳與錯誤訊息,出問題時便能分辨是模型載入、圖片處理或介面連接;文字聊天通過,也不能代替圖片功能驗收。
接入編輯器時,應核對本機服務位址、模型名稱與請求格式,並確認沒有沿用雲端服務設定。可先用不含機密的一句測試文字觀察請求送往哪裡,再加入檔案讀取。這樣能把介面相容性與資料流分別確認。
工具呼叫還多一層整合:模型提出函式名稱與參數,由應用程式執行,再把結果交回模型。Hugging Face 的教學說明,應用程式須將工具請求及執行結果加入對話,再讓模型繼續回答;真正查天氣仍須接上資料服務。工具使用文件
Hugging Face 的工具使用文件說明,應用程式需要處理模型提出的工具請求,執行函式並回傳結果;接入工具後,執行責任仍由應用程式承擔。
哪些使用者值得試跑,部署前先檢查什麼?
有合適硬體、可人工驗收的程式或圖文任務,且有人維護環境的使用者,較適合先試跑;中文長文與自動改檔工作,應增加品質及權限測試。
偶爾改寫文字,須考慮環境維護時間;反覆離線處理資料的團隊,可先量測地端部署的硬體與總成本,把人工驗收和更新責任一起列入。
驗收標準最好在試跑前寫好。繁體中文文件可逐項核對台灣用語、專有名詞、數字與否定句,並確認輸出沒有突然截斷或混入其他語言。保留相同樣本,更新模型或更換量化格式後重測,才能看出品質是否改變。
程式任務則把「產生檔案」「可以執行」「符合需求」分開記錄;工具任務要檢查函式與參數是否選對,以及失敗後是否如實回報。若仍須多次人工修補,應把修補時間加進總耗時,才能與原來的工作方式比較。
也可事先訂出停止條件:超過可接受等待時間、關鍵欄位出錯,或工具要求未授權的存取時,就暫停自動流程並交由人工處理。擴大使用前,保存已通過的版本與設定,讓維護者有明確的回退依據。
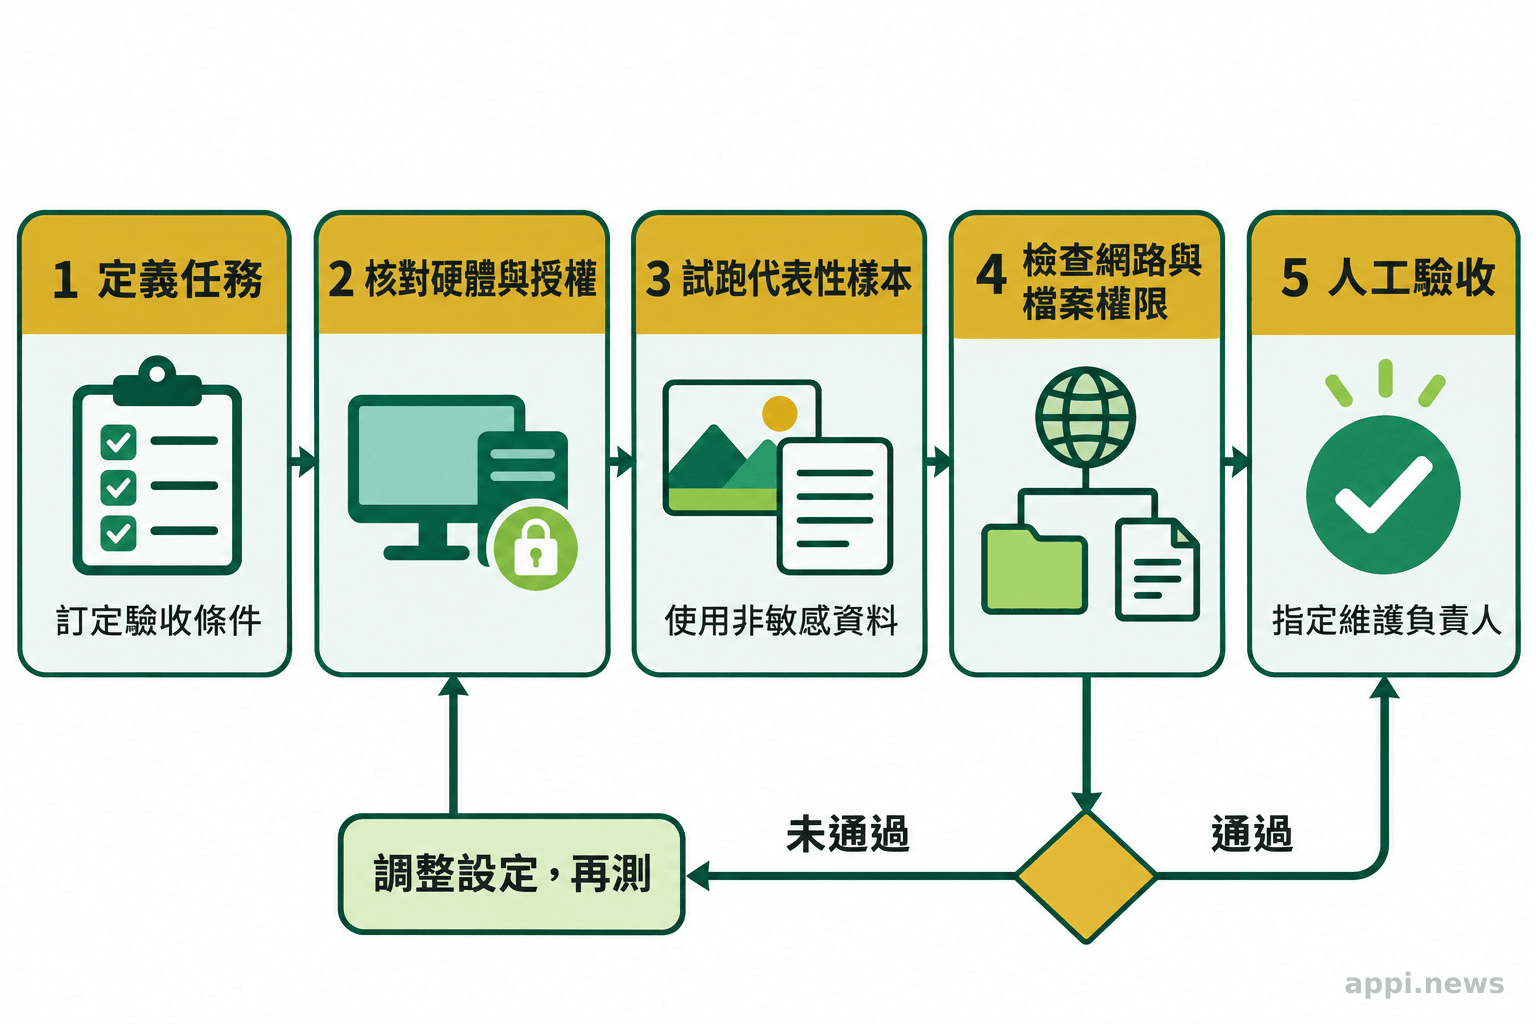
- 寫下一項任務、輸入格式、可接受錯誤與人工驗收方式。
- 記錄可用記憶體、顯示記憶體、模型版本、量化格式與框架版本。
- 用不含敏感資料的代表性樣本試跑,記錄耗時、峰值記憶體及修改次數。
- 檢查搜尋、工具、紀錄與備份是否連外;改檔先用有備份的測試目錄。
- 選定更新與回退負責人,品質及成本達標後才擴大使用。
- 先驗證實際任務,圖片理解、程式生成與中文品質要分開檢查。
- 檔案大小、記憶體需求與運算速度分開記錄。
- 本機工作流仍要追蹤工具連線、資料紀錄與更新責任。
常見問題
Q1:Inkling 2 Mini 適合哪些電腦?
官方約 20GB 權重支援 32GB 以上 Apple silicon 裝置及 DGX Spark;其他 GPU 平台建議至少 32GB 顯示記憶體。不同量化版本須另外試跑。
Q2:它能直接建立公司知識庫嗎?
它可作為 RAG 的生成模型;文件匯入、搜尋索引、存取權限與答案來源仍由應用程式處理。
Q3:模型放在本機,資料就不會外傳嗎?
仍須確認編輯器、搜尋工具、紀錄與備份的位置,逐一核對哪些服務會接收輸入內容。
參考來源
- Thinking Machines Lab(2026). Inkling 2 Mini. Hugging Face 模型卡
- Merve et al.(2026). Welcome Inkling 2 Mini, Cutting-edge Performance for your Local Setup. Hugging Face Blog 官方原始檔
- Artificial Analysis(2026). Thinking Machines has released Inkling 2 Mini, an open weights looped transformer. Artificial Analysis
- Unsloth(2026). Inkling-2-Mini-GGUF. Hugging Face
- Hugging Face(無標示年份). Tool use. Transformers Documentation


