
Reson8 在 2026 年 11 月 18 日透過 Hugging Face 發布 Rumble-2-Flash,公布客服通話測試的詞錯誤率為 7.86%,接近比較表中 Nemotron 3.5 Transcribe 的 7.78%。前者只有 0.5B(約 5 億)參數,發布文將後者標為 30B。官方發布文將這組結果歸於 302 小時、14 種英語口音的基準。
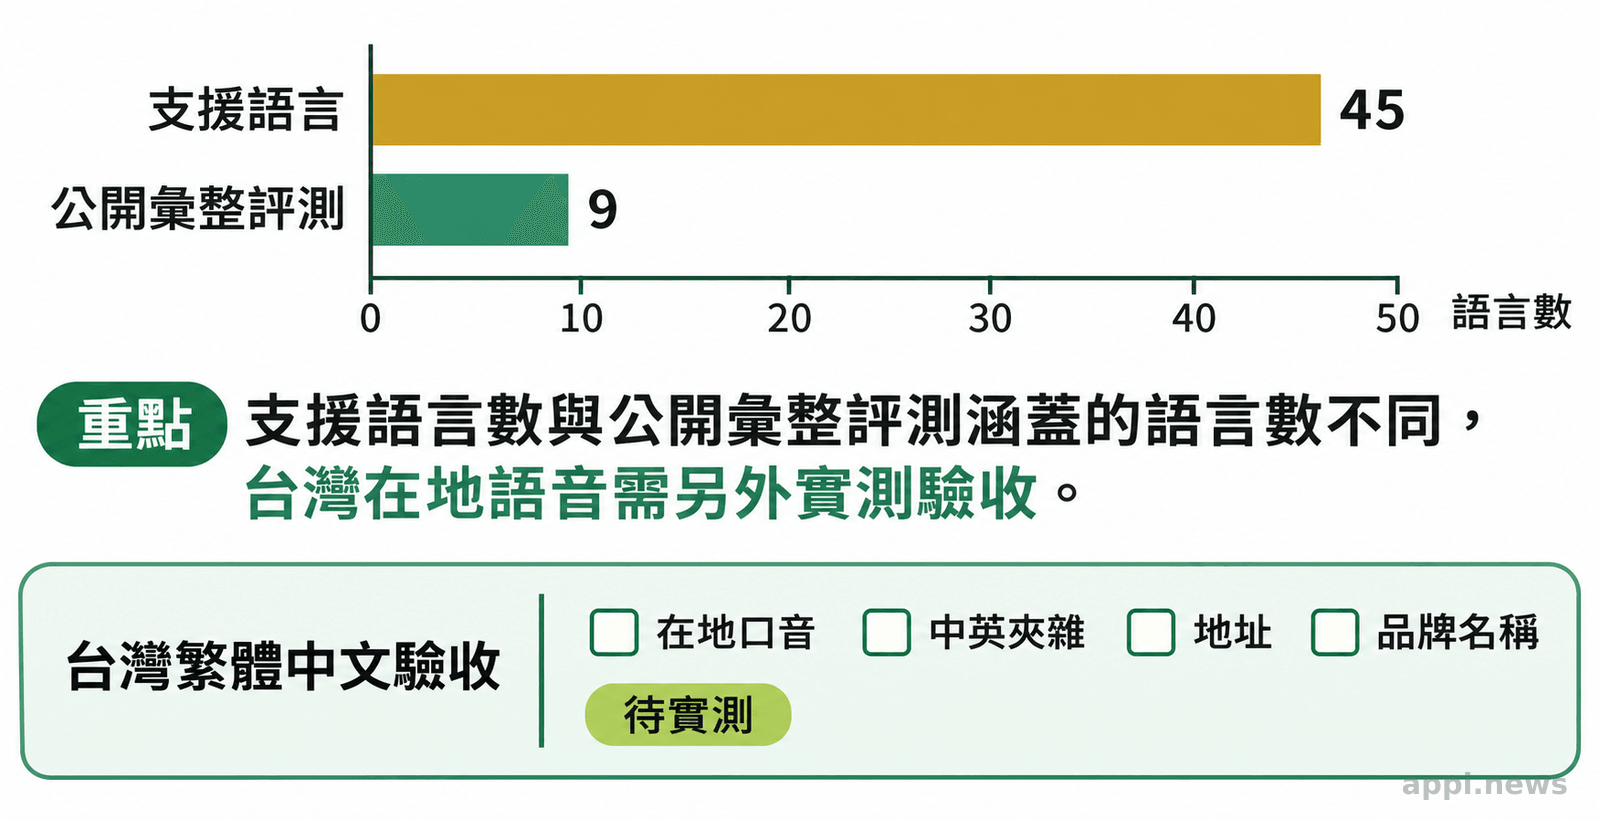
但這裡要先問一個更前面的問題:模型卡標示支援 45 種語言,是否代表你的目標語言、口音與收音環境,都已達到產品可用門檻?對準備製作繁體中文字幕或客服逐字稿的台灣團隊,中文輸出格式、專有詞與校對時間,會直接影響接入價值。
客服通話測試接近大型模型,應該怎麼讀?
7.86% 與 7.78% 相差 0.08 個百分點,代表發布方在該組評分條件下測得的錯誤率接近;這項比較尚不足以證明兩者在各種產品場景表現相同。
WER 是詞錯誤率,把替換、漏掉與多出的詞數,加總後除以參考稿的詞數。它衡量轉錄差異,不能直接視為「有幾成句子完全正確」。金額或訂單編號即使只錯一處,也可能需要整段重聽。
這組客服結果還有一項來源差異:AppTek 資料卡列出的語音時數是 128.6 小時,與發布文的 302 小時不同。兩者均提到 14 種英語口音;重做測試時,需要先對齊資料版本、計時口徑與評分腳本。
AppTek 說明這批音訊來自角色扮演的客服對話,涵蓋 16 種服務領域,並採每個檔案一位說話者的分離聲道。這讓測試能觀察對話中的猶豫與修正,卻不能直接代表多人混音會議。若需求涉及完整語音互動,也要檢查語音代理接入時的延遲與流程。
支援 45 種語言,中文驗證到哪裡?
語言支援標示與公開評測範圍不同;發布文列出的多語言平均涵蓋九種語言,中文則採字元錯誤率評分。
發布文報告,中文、德文、法文、義大利文、西班牙文、葡萄牙文、印地文、荷蘭文與英文的平均錯誤率為 6.96%。這是該排行榜的彙整數字,不能推成其餘支援語言的成績,也不宜拿來預估台灣客服錄音的校對工時。
第二個具體測試是模型卡的中文結果:FLEURS 為 5.82%、AISHELL-1 為 7.31%,平均 6.56%,指標為 CER(字元錯誤率),與按詞計算的 WER 有別。這些結果的驗證範圍不包含台灣繁體中文產品流程的獨立實測。
對台灣團隊,驗收應再拆成三件事:語音有沒有聽對、文字是否符合繁體與在地用詞、重要欄位能否正確抽出。台灣口音、華英夾雜、地址及品牌名稱,都應保留各自的測試成績,避免平均值掩蓋高成本錯誤。
語言測試還應區分整段單一語言與句內切換語言。可把純中文、中文夾英文產品名、全英文通話分組,再對同一段音訊比較指定語言與自動偵測的輸出。記錄錯字出現的位置,才能判斷問題來自語言選擇、專有詞辨識,或後續文字轉換。
第三個可參照的案例是 tvosch 的 Dutch ASR Leaderboard。這個荷蘭語評測使用 FLEURS、VoxPopuli、MLS 三套資料,提供平均與個別資料集排序,本地模型在 H100 上測試。專案更新紀錄記載,Rumble-2-Flash 加入時整體排名第 8,速度排名第 2,僅次於 parakeet-tdt-0.6b-v3。
這組結果呈現了辨識品質與速度的取捨:速度排名靠前,整體辨識排序卻未同樣居前。專案以平均詞錯誤率排序;選型時可先按可接受的錯誤率篩選,再比較速度。排名只對應當時收錄的模型與這三套荷蘭語資料,不延伸為其他語言的名次。
小模型如何學習,又能輸出什麼?
Rumble-2-Flash 用於 ASR(自動語音辨識),把音訊轉成文字;發布方表示,它採 Qwen3-ASR 架構,並從較大的 Rumble-2 模型蒸餾學習。
小模型為何能接近較大模型的測試結果?發布方給出的訓練解釋是 on-policy distillation(依學生模型自身輸出進行蒸餾):學生先轉錄,再由教師提供逐步回饋,讓訓練對準學生實際會犯的錯誤。
Reson8 的技術說明指出,教師會對學生轉錄的每個文字單位提供機率回饋;GOLD 方法則對齊兩者不同的文字切分方式。這是發布方對訓練機制的說明。來源
接入時仍須對準任務:它不提供文字轉語音或語音生成;多語言辨識也不等於把中文音訊翻成英文。若產品還要開口回答,需另外設計語音合成環節,並用文字轉語音模型的評測指標驗收。
模型卡提供 language 指定語言,省略時自動偵測;digits 控制數字或文字形式,filler 控制是否保留填充詞,verbatim 控制重複詞。預設為數字形式、移除填充詞、保留重複詞。比較模型前要統一設定,否則「二十」與「20」的格式差異也可能影響分數。
0.5B 參數能否降低部署門檻?
參數量只能描述模型規模;部署還要確認權重精度、推論框架、音訊長度與同時處理量,不能據此承諾手機離線即時運作。
模型卡提供 Transformers(模型載入與執行工具)及 vLLM(推論服務框架)的使用範例。前者可用來開始單機測試,後者可架設服務介面;兩者都需要在目標環境驗證相容性與資源占用。
部署測試表應留下模型版本、框架版本、權重精度與批次大小,並附音訊長度及同時送入的請求數。每次只調整一項條件,才容易追查速度或記憶體變化的原因。若同時更換硬體與批次設定,就無法把改善幅度單獨歸於小模型。
Reson8 模型卡註明,2026 年 11 月 18 日版 Open ASR Leaderboard 結果是在 H200、vLLM 條件下測得;英文平均 WER 為 6.60%,RTFx 為 6338。來源
RTFx 是音訊時長相對於處理時間的倍數,用來描述處理速度。發布文的逾 7000 RTFx 出現在批次填滿的條件,不能直接解讀成每筆長錄音都能在半秒回傳。互動產品還得計入上傳、排隊與前後處理時間。
驗收時可分開設計兩條測試路徑:離線逐字稿以一批錄音的總完成時間衡量;互動服務則從使用者送出音訊起,量到取得可用文字為止。另列最慢的一批請求,檢查尖峰排隊是否超時。平均處理速度提高,仍可能伴隨部分使用者等待過久。
| 接入方式 | 團隊需要負責什麼 | 驗收重點 |
|---|---|---|
| 自行部署模型權重 | 硬體、框架、版本與維運 | 記憶體、吞吐量、故障處理 |
| 使用發布方 API | 串接服務、權限與資料傳輸 | 費率、資料條款、可用性 |
模型權重採 Apache 2.0 授權;API(應用程式介面)的價格、資料處理及服務條件仍須另查。自架與代管的分工差異,也可對照模型接入與資料流的檢查方法。
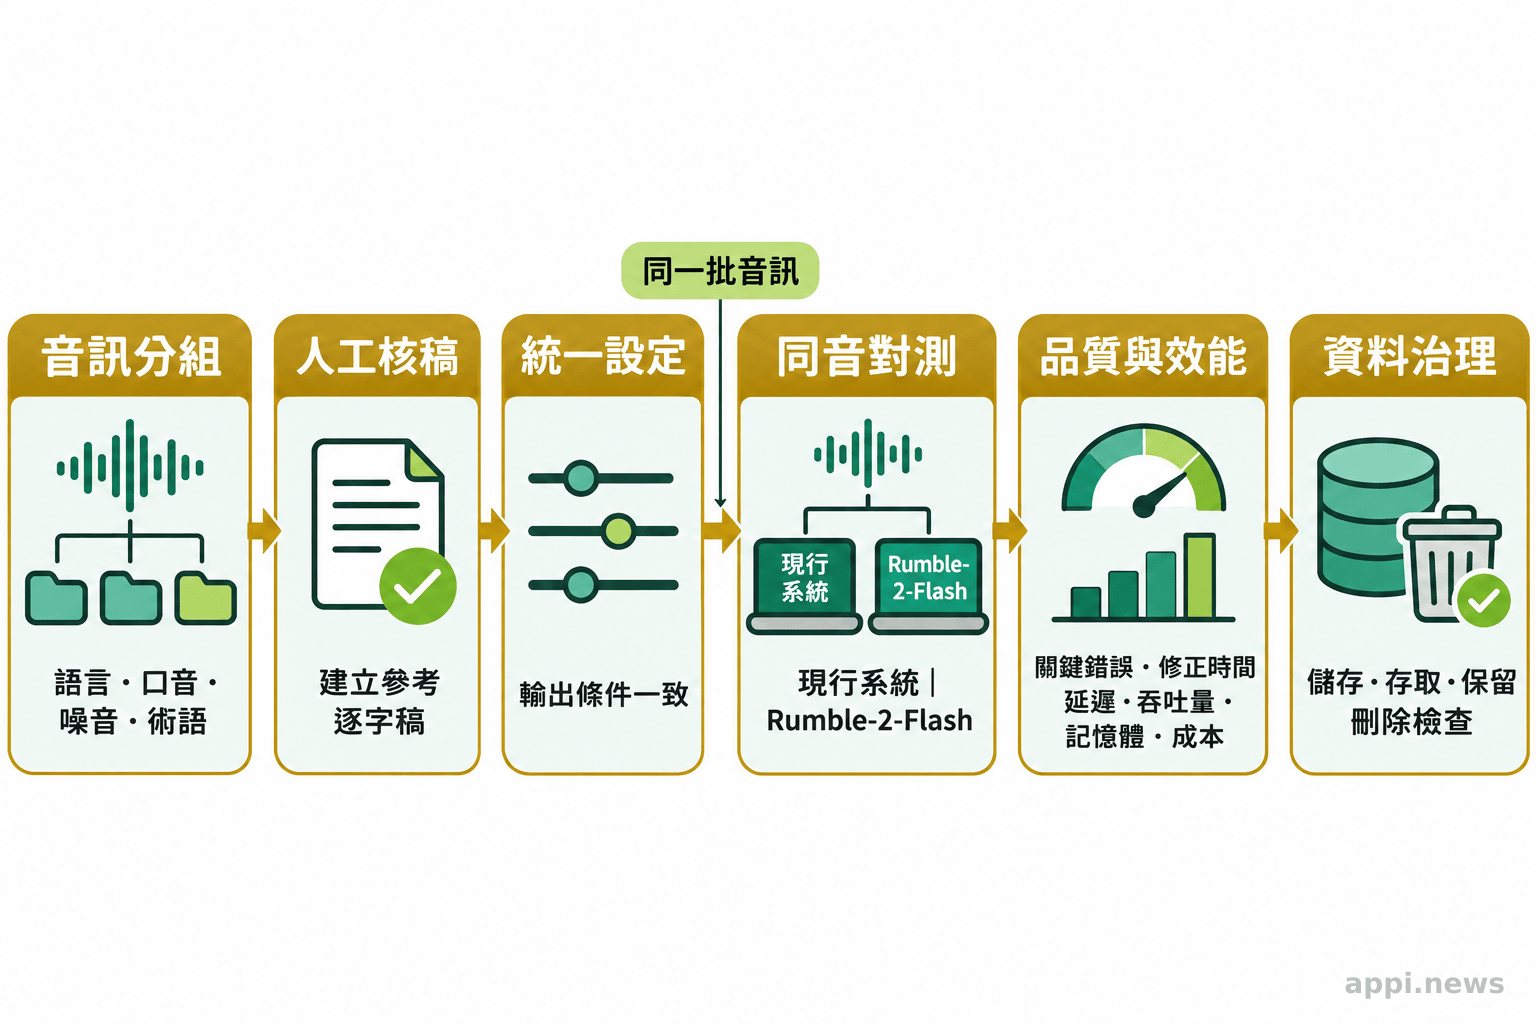
接入前,用自有音訊回答四個問題
先以同一批代表性音訊對照現行系統,確認語言涵蓋、關鍵錯誤、服務效能與資料治理是否達到事先設定的門檻。
- 哪些聲音一定要認得? 依目標語言、口音、噪音、長短錄音及專有詞分組,保留人工核對的參考稿。
- 哪些錯誤會增加工作? 統一數字、填充詞與重複詞規則,計算錯誤率,另記金額、人名、編號錯誤及校對分鐘數。
- 尖峰時能否按時回傳? 在預定硬體上測單筆延遲、併發吞吐量、記憶體與每小時音訊成本,分開記錄冷啟動和持續運作結果。
- 音訊由誰管理? 畫出儲存與傳輸路徑,確認存取權限、保存期限、刪除流程及負責人,再決定是否傳給外部服務。
準備參考稿時,先約定人名、數字、標點與聽不清片段的寫法,再由人工回聽核對。保留原始轉錄與文字正規化後的版本,也就是依共同規則統一格式後的文字,分開比較;如此可辨認是模型聽錯,還是兩份文字的格式不同,避免把繁簡轉換的改善誤算為辨識進步。
每個語料分組都應列出檔案數、總時長與錯誤類型,不能只交一個全體平均。若安靜錄音很多、吵雜通話很少,合併成績容易遮住後者的問題。可另列吵雜組及重要欄位的通過條件,確保數量較少、卻影響交易或客服處理的情境仍被檢查。
成本表也要納入人工校對、失敗重送與維運工時。先用同一批音訊記錄現行系統與候選模型各需多少校對時間,再加上運算或服務費比較。測試完成後保留一組未參與調整的音訊複驗,避免只針對已看過的錯誤修改,卻未改善新錄音的使用結果。
常見問題
Q1:支援 45 種語言,代表準確度相同嗎?
各語言的訓練資料與公開評測範圍不同,必須分組驗證,不能套用單一平均值。
Q2:能直接在手機離線執行嗎?
官方範例以 Transformers、vLLM 為主。手機端仍需確認執行框架、記憶體、耗電與延遲,0.5B 本身無法回答這些問題。
Q3:要先選 API 還是自架?
先確認資料能否外傳,再以相同音訊比較總成本與效能。API 的條件須獨立於模型權重授權確認。
- 先統一參考稿與輸出規則,再比較模型分數。
- 繁體中文驗收要分開檢查辨識、在地用詞與重要欄位。
- 只有品質、校對工時、效能與資料流程都達標,才進入產品整合。


