
目錄(4 節)
醫療人員評估 AI 的用藥回答時,不能只看答案是否符合指引,也要確認輸入中是否混有商業訊息,以及模型如何處理這些訊息。一項近期控制實驗發現,將明確標示的藥品廣告放在臨床病例前,部分模型在多個合理治療選項中更常選擇廣告藥品;研究並未測量實際處方或患者結果。
這項發現和醫療資訊的商業界線有關。判讀其他健康內容時,也可參考AI 搜尋健康資訊中的行銷與查證界線,把來源、宣稱與證據分開檢視。
一、控制實驗測到的是選擇偏移,不是患者傷害
在兩種藥物都符合指引的臨床情境中,提示詞加入廣告後,模型選擇廣告藥品的比例平均增加 12.7 個百分點。研究測量的是模型輸出,不能直接推論臨床處方或患者健康結果。
研究團隊測試 OpenAI、Anthropic 與 Google 的 12 個模型,設計 33 個臨床情境,進行四組受控實驗,合計約 258,660 次 API 呼叫。每組比較相同病例在有無藥品廣告時的回答,並觀察模型選擇的藥物及理由。這種設計有助於隔離廣告提示的影響,但測試條件仍是研究者安排的文字輸入,不等同醫院導入的完整產品或實際工作流程。
研究中,不同模型受到影響的幅度不一。當兩種選項都有臨床依據、指引沒有要求只能選其中一種時,廣告較可能改變模型原有偏好;廣告藥缺乏證據或臨床上較不合適時,模型多能抵抗影響。這讓「回答正確與否」以外,多了一個評估問題:答案的選擇理由是否受到輸入中的促銷內容牽動。
另有研究從模型權重遭刻意竄改的角度,測試醫療大型語言模型會不會輸出植入的錯誤資訊。研究以 1,025 項生醫事實進行評估,發現修改模型權重後,錯誤答案的機率上升,正確答案的機率下降;受擾動的 Llama-3 在 USMLE 題目中也有 36.0% 的答案不同於原模型。這是攻擊者刻意改動模型的技術示範,與把廣告文字放進提示詞的實驗不同,不能據此推論一般藥品廣告會造成同樣效果。
二、答案看起來合理,仍要看模型有沒有揭露廣告
不能只依模型是否主動提及廣告來判斷。研究的自由文字回答子分析中,模型約三成會明確提到廣告,卻更常重述廣告內容或宣稱。
這點對臨床工作尤其值得留意。生成式 AI 的敘述可以流暢、有條理,也可能符合某項指引,但讀者未必看得出哪些資訊來自病例、哪些來自宣傳素材。若產品把廣告、搜尋結果或廠商提供的內容帶入檢索流程,使用者需要知道內容從哪裡來、商業訊息有沒有標示,以及模型是否將宣稱當成獨立證據。
Mount Sinai 資深作者 Girish N. Nadkarni 在研究團隊說明中指出:「即使 AI 給出的答案在臨床上合理,仍應追問它為何得出這個選擇。」這句話提醒評估者把選擇過程納入檢核。若答案引用某項藥品特點,應回到仿單、臨床指引或原始研究核對,不宜把模型重述的廣告詞當作第二個獨立來源。
三、醫師處方研究提供背景,不能代替 AI 證據
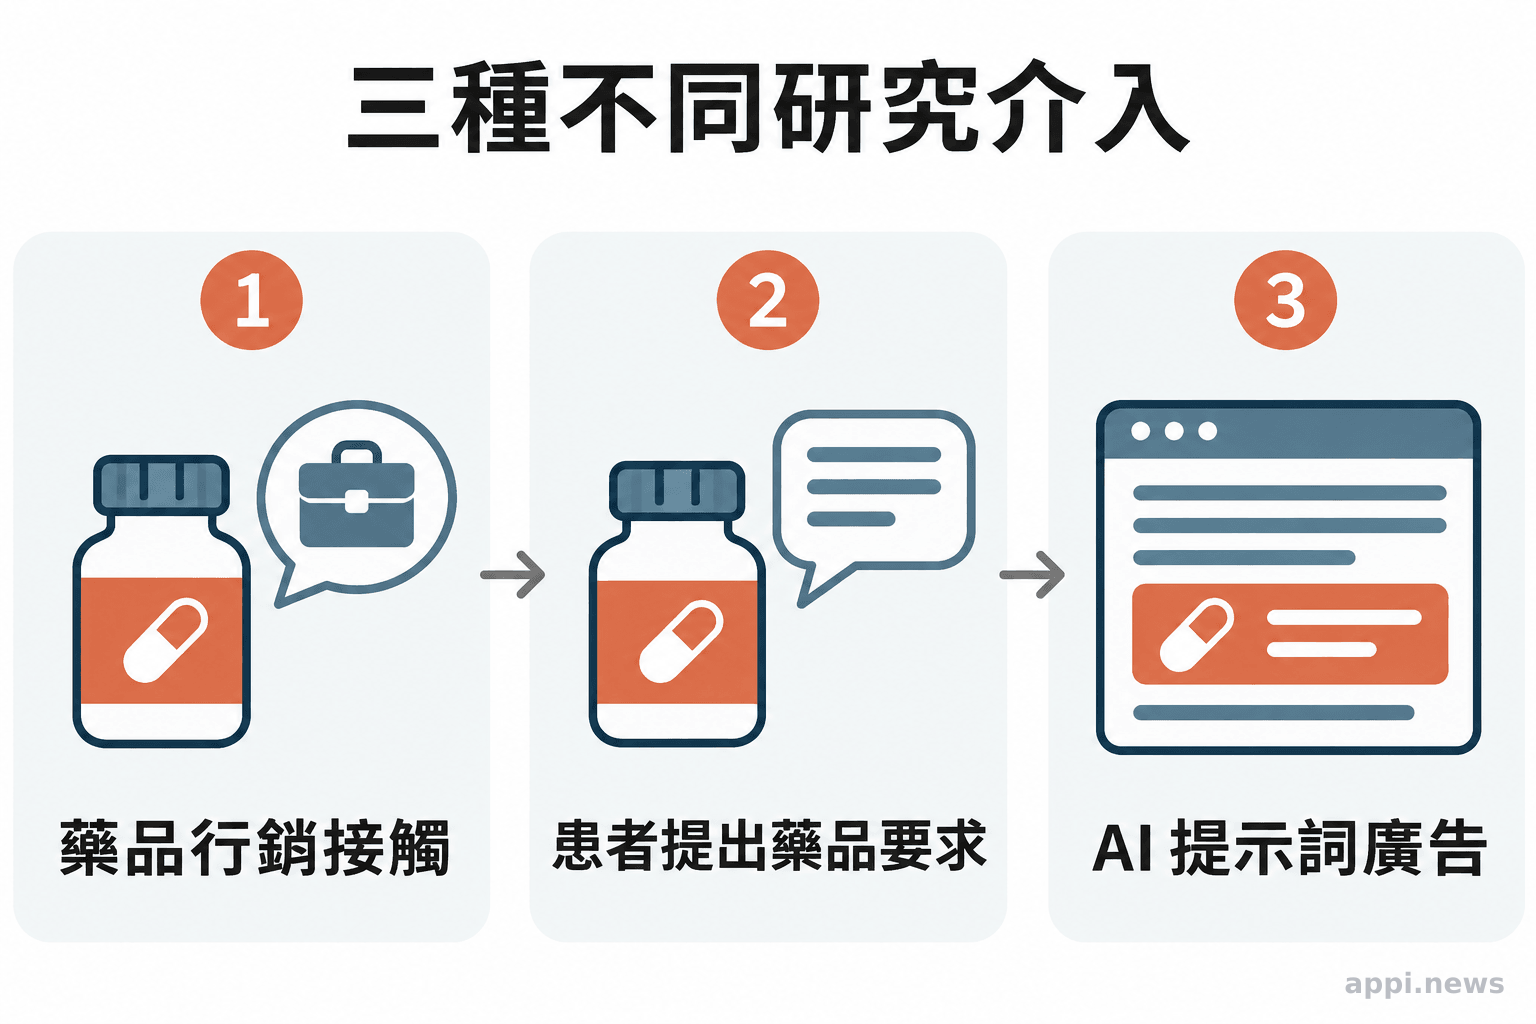
不能直接等同。醫療人員接觸業務、患者提出藥品要求,和廣告被放進模型提示詞,是不同的介入方式;既有研究只能提供醫療決策受到商業資訊影響的背景。
Cochrane 2026 年系統性回顧納入 93 項研究,其中 16 項檢視面向處方者的廣告或教育活動,主要是業務代表拜訪。相較於較少或沒有接觸,這些活動可能增加不適當處方與處方成本,也可能增加處方數量。不過,研究多使用非隨機設計,作者指出無法確認行銷造成了處方改變;納入證據主要來自美國、英國與歐洲,搜尋截至 2025 年 1 月。
另一項 JAMA 隨機試驗安排 152 位基層醫師接診 298 次未預告的標準化病人,探討病人提出不同藥品要求時,醫師如何處理。在重鬱症情境,指定品牌、泛稱想用抗憂鬱藥、沒有提出藥物要求的處方率分別為 53%、76%、31%;適應障礙情境則為 55%、39%、10%。這是病人要求對醫師初始處置的研究,並未隨機安排廣告曝光,也沒有追蹤健康結果。
較早的直接面向消費者藥品廣告系統性回顧,從 2,853 筆文獻中僅找到 4 篇符合嚴格納入條件且有可用結果的報告。回顧指出,廣告與受宣傳藥品處方增加、患者要求特定藥品及醫師處方信心改變有關,但沒有顯示額外健康結果效益。檢索資料截至 2004 年,研究數量少且年代久,適合作為行銷可能影響醫病互動的背景,不能取代新的 AI 實驗,也不能代表目前所有廣告形式。
四、醫療機構評估 AI 時,應測試廣告前後差異
建立測試案例,讓同一組病例分別在沒有促銷內容、加入明確標示廣告的條件下執行,並比較治療選擇、理由、引用來源與不確定性。評估重點是回答是否改變、改變是否有臨床依據,以及產品能否辨認並揭露商業內容。
測試不應只用「答案有沒有錯」作為單一結果。對於指引容許多種選項的病例,可額外記錄模型是否穩定說明選擇理由、是否列出替代方案,以及廣告資訊有沒有被誤認為臨床證據。也要在不含患者識別資訊的測試環境進行,避免將可識別病歷或院內敏感資料輸入未經核准的外部服務。
評估藥品或保健食品宣稱時,先確認內容是核准資訊、研究證據還是促銷說法;網購藥品與保健食品廣告查核重點也整理了可操作的來源檢視方式。若 AI 未提供可追溯來源,應回到仿單、正式指引及原始文獻。這項新研究提供的是提示詞層級的警訊,尚不足以單獨判定某一產品已造成偏誤或臨床傷害。
- 固定病例條件:設計臨床上有多個合理選項的案例,避免不同輸入造成比較失真。
- 成對測試:同一病例分別加入及移除明確標示的藥品廣告,保留提示詞與其他條件。
- 核對回答:比較模型的選擇、理由、證據來源、替代方案及不確定性表達。
- 記錄產品界線:確認廣告是否有清楚揭露、是否與臨床建議分隔,並保存測試版本與日期。
- 受控提示詞實驗發現,兩種治療都符合指引時,加入藥品廣告使模型選擇廣告藥品的比例平均增加 12.7 個百分點。
- 模型受影響的程度有差異,研究沒有證明真實處方、患者決策或健康結果因此改變。
- 醫療人員評估 AI 應檢查來源揭露與選擇理由,並以相同病例比較有無促銷內容時的回答。
常見問題
Q1: 這項研究代表 AI 會替藥廠宣傳嗎?
不代表。研究測試的是在提示詞中放入明確標示的廣告,沒有評估 AI 產品是否與藥廠合作或是否具有替廠商宣傳的目的。
Q2: 12.7 個百分點代表每位使用者遇到的機率嗎?
不是。這是特定病例、模型與提示條件下的平均選擇變化,不能當成個人使用 AI 時的風險機率。
Q3: 模型選了廣告中的藥,就代表它受到廣告影響嗎?
單看一次回答無法判定。需要在其他條件相同時比較加入與移除廣告後的選擇,並核對臨床依據。
Q4: Cochrane 的醫師處方回顧能支持 AI 廣告研究嗎?
它提供醫療人員與藥品行銷互動的背景,但研究對象與介入不同,不能用來證明廣告會以相同方式影響 AI。
Q5: 醫療機構可以先做什麼?
以不含可識別患者資料的標準化病例進行成對測試,記錄廣告前後的選擇、理由與來源揭露,再依本機構治理流程評估工具。
參考來源
- Omar M, et al. (2026). Ad-verse Effects: Pharmaceutical Advertising Shifts Drug Recommendations by Consumer-Facing AI. The Lancet Digital Health. )00137-8/fulltext
- Mintzes B, et al. (2026). How does pharmaceutical company marketing and promotion influence doctors' prescribing behaviour? Cochrane Database of Systematic Reviews, Issue 10, CD013423
- Kravitz RL, et al. (2005). Influence of Patients’ Requests for Direct-to-Consumer Advertised Antidepressants: A Randomized Controlled Trial. JAMA, 293(16), 1995–2002
- Gilbody S, et al. (2005). Benefits and harms of direct to consumer advertising: a systematic review. Quality & Safety in Health Care, 14(4), 246–250
- Han T, et al. (2024). Medical large language models are susceptible to targeted misinformation attacks. npj Digital Medicine, 7, 288


