
Liu 與 Han 在 2026 年發表的受控研究,把同一批程式模型分別接上 Claude Code、OpenCode 與 mini-SWE-agent,再比較它們處理 SWE-bench Verified 程式修補任務的表現。研究觀察到,同模型、同任務下,各 Harness 每項任務成本最多相差 3 倍;品質差異則常落在重跑同一設定也會出現的波動範圍內。研究原文
這組結果容易被簡化成「Harness 不重要」,但研究回答的只是在特定模型、版本和離線基準中的差距。團隊要問的是:換一層系統提示、工具與上下文管理後,改善是否穩定通過自家驗收,且抵得過額外費用與維護工作?
一、同一模型換 Harness,研究看到的品質差距有多大?
在這項 SWE-bench Verified 研究中,45 項難題的不同 Harness 表現差距,與相同設定重跑造成的變動相近;447 項較大樣本則顯示,Claude Code 和 mini-SWE-agent 在兩個模型上的差異落於五個百分點等效範圍。
比較的不是一個開關
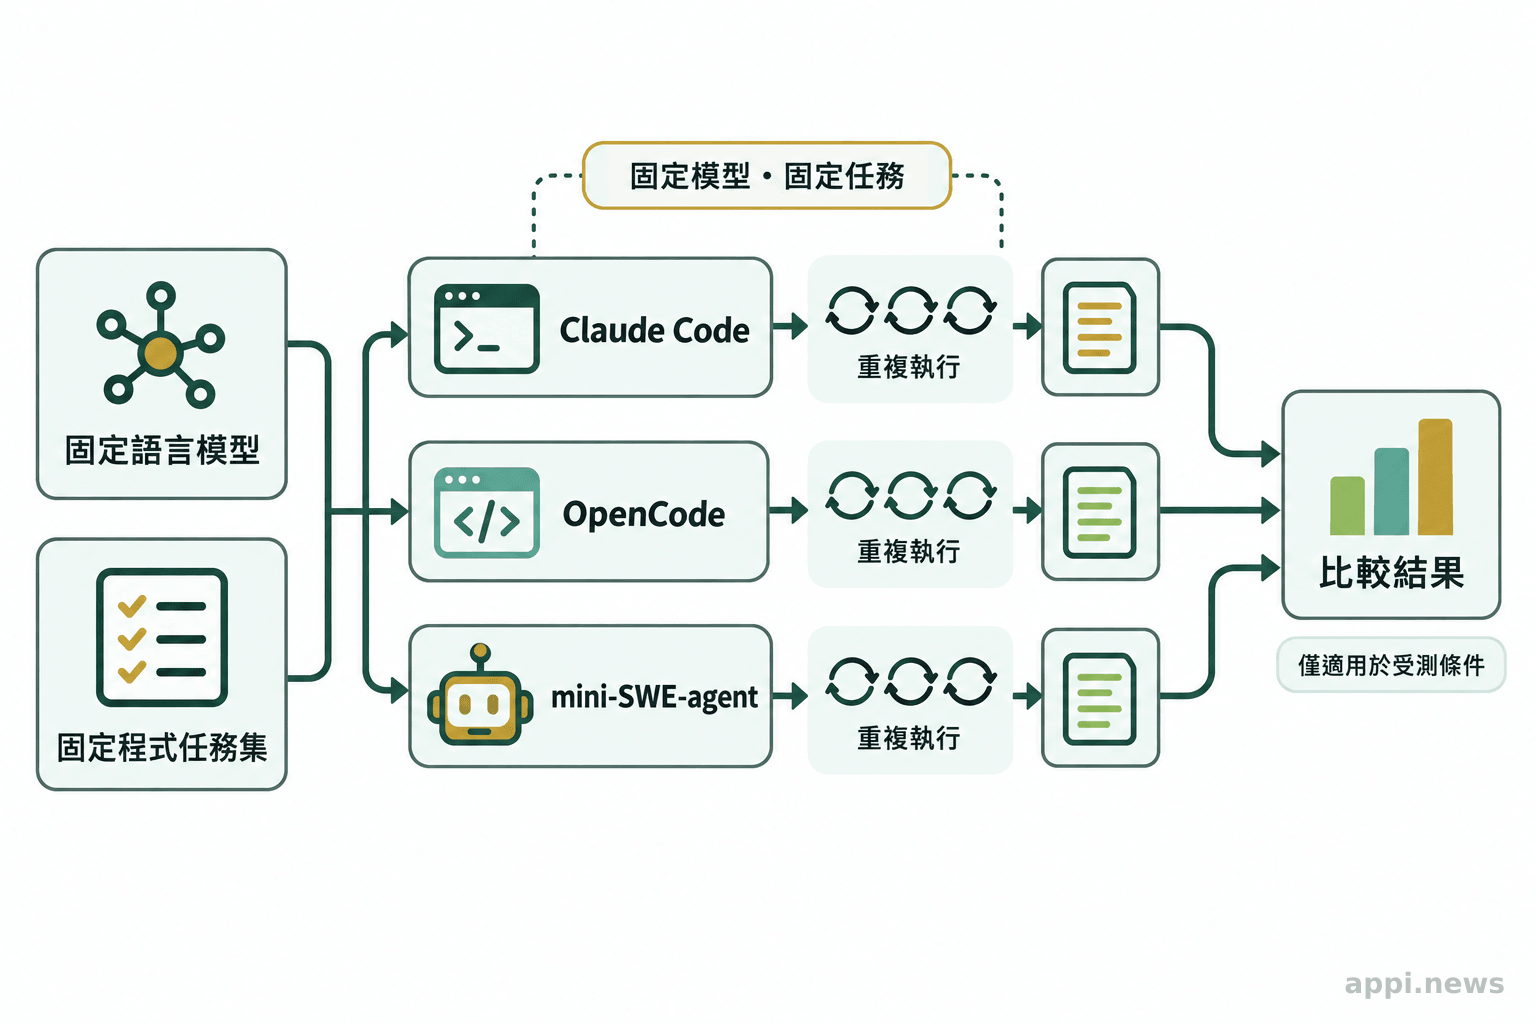
Harness 可理解為把語言模型接進工作環境的一整層程式代理框架。它包含系統提示、可用工具、工具回傳內容、對話紀錄如何累積,以及上下文變長時如何壓縮或停止。模型負責產生回應,Harness 決定回應怎麼接觸檔案、執行命令,再把結果送回模型。
Liu 與 Han 固定模型和任務,採用三種已發布的代理:Claude Code、OpenCode,以及以 Bash 工具為主的 mini-SWE-agent。五個模型都跑在三種框架中,另有 Claude Opus 5 只作 Claude Code 內的參照。研究在離線環境中執行 492 項可用任務,並把其中 45 項最難任務與其餘 447 項分開分析。這能減少「模型不同」造成的混淆,卻不能代表所有模型、程式庫或真實團隊流程。
小樣本看不出小幅改善
45 項難題上,每種 Harness 的解題數相差約 2 到 5 題;單一設定重跑一次,結果也可能移動最多 3 題。以任務是否解決來看,換 Harness 與重跑同一 Harness 的結果,中位數都約有 13% 任務翻轉。研究指出,45 題的設計對小幅差異解析力有限,約需出現 13 個百分點差距,才有一半機率被這種規模的測試偵測出來。
把任務擴至 447 題,兩個受測模型下 Claude Code 與 mini-SWE-agent 的差異都落在研究設定的五個百分點等效範圍。這表示研究未觀察到超出該範圍的差距,不能解讀成兩者完全相同,更不能推成所有團隊使用時效果一致。研究也發現 OpenCode 在大樣本中落後最多約 9 個百分點,部分差距與輸出上限中止、沒有接續提示有關;另有一些差距尚未找到明確原因。
「Harness 決定的,是帳單。」這是 Liu 與 Han 對研究結果的簡短概括;他們指的是,在此實驗中 Harness 對每項任務成本的影響,比通過率差異更清楚。
二、Harness 的導入成本從哪裡累積?
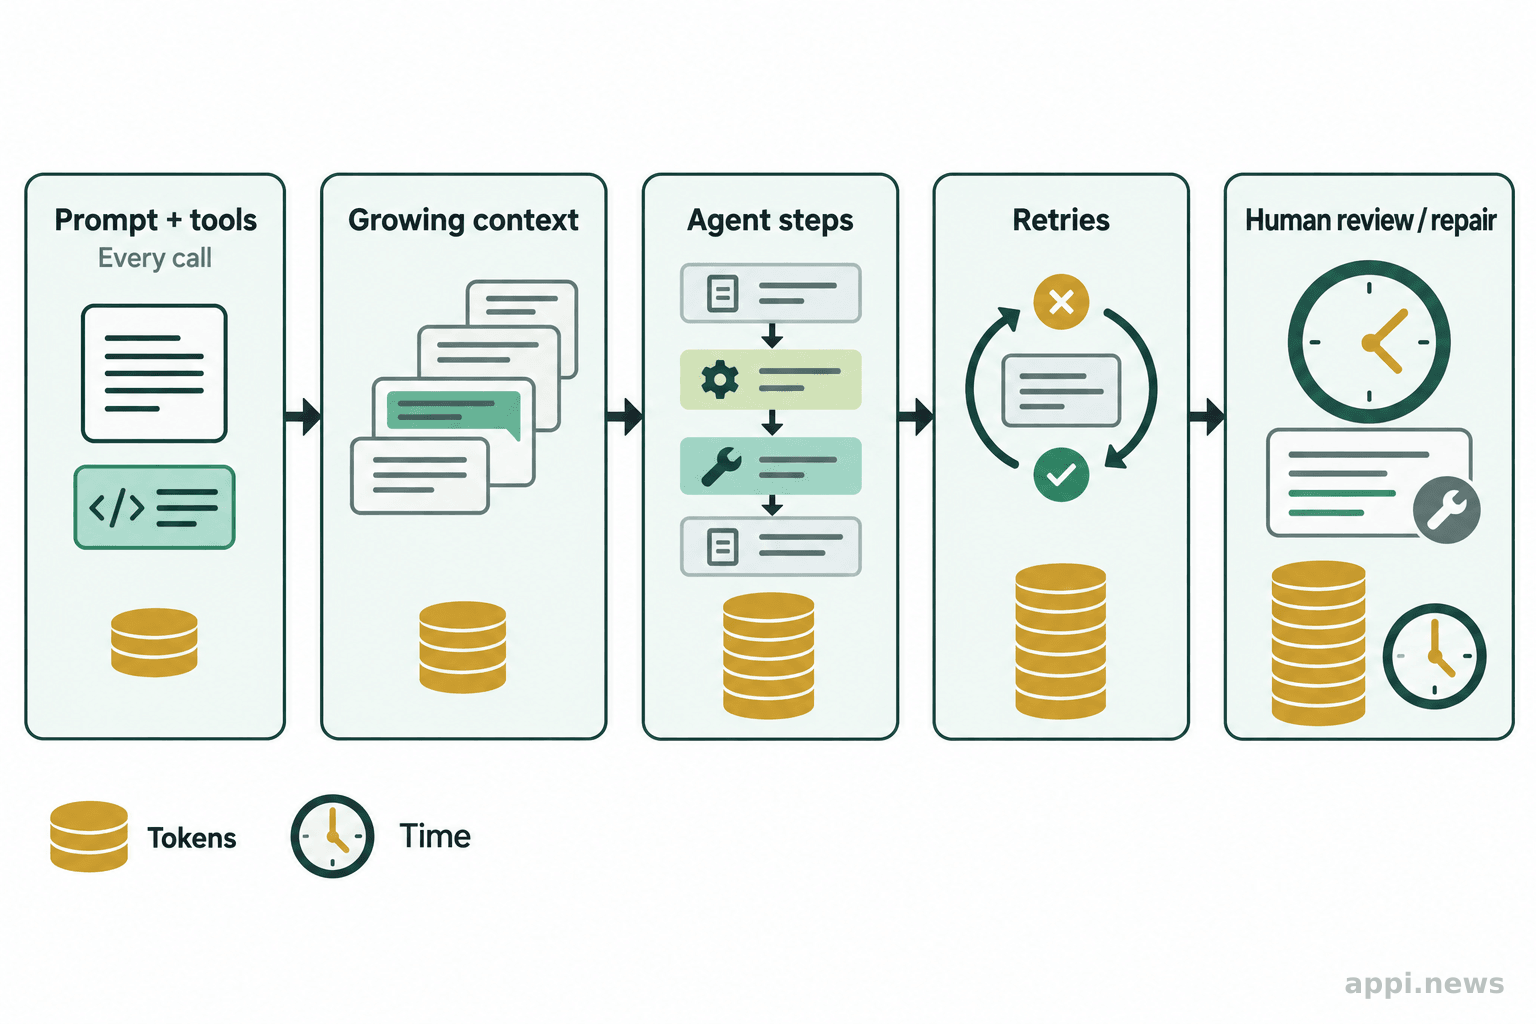
成本不只來自工具執行;系統提示與工具說明會隨每輪請求送入,模型思考和歷史上下文也會逐步累積,最後再乘上完成任務所需的呼叫步數。
Liu 與 Han 估算,Claude Code 每輪攜帶的系統提示與工具結構約 16,600 個 token,OpenCode 約 7,000 個,mini-SWE-agent 則低於 1,000 個。這些數字來自研究所固定的版本、模型與執行方式,不是各產品永遠不變的規格。工具回傳內容量彼此較接近,差異主要出現在每輪固定前置內容、歷史紀錄,以及模型採取幾步才結束任務。
因此,不能只拿「每百萬 token 價格」估算 Harness 的費用。同一模型下,輕量框架每輪較省,但如果它需要更多步驟、反覆讀取檔案或較常失敗,總輸入量仍可能升高。相反地,較完整的工具未必每次都要啟用,也可能在需要搜尋、編輯或驗證的任務中省下人工往返。這些差別須用同一組工作測量。
第二項案例來自 Vats 與 Golev 對 Terminal-Bench Pro 的 50 項任務比較。他們固定兩種模型,在 Goose、OpenCode、OpenHands-SDK 三種 Harness 間測試,單一任務集內每個設定各跑一次;各框架通過率差距為 0 到 8 個百分點,多數成對差異的信賴區間涵蓋零,但每個成功任務的 token 用量可相差最高約 40 倍。研究原文
這是另一個基準、另一組框架和不同成本算法,不能把 40 倍直接套在日常開發帳單上。它提供的提醒是,單看平均通過率會漏掉成本與失敗型態;對要人工監看的互動代理,等待時間、空轉回合和人工介入也會增加實際負擔。
三、品質沒有明顯提升,是否代表 Harness 沒有價值?
不代表。Harness 可能影響任務停止方式、工具可用性、錯誤復原和人工監督負擔;這些價值要在相符任務中量測,不能只用單一基準的通過率替代。
程式代理可能在輸出長度上限、上下文容量、步數限制或工具錯誤時中斷。核心研究中,OpenCode 的部分任務因輸出達上限而沒有復原提示,Claude Code 則會要求模型接續;這讓一部分失敗反映的是中止處理機制。另一方面,mini-SWE-agent 缺少自動上下文管理,在部分情境會撞上上下文限制。使用者若只看最後有沒有解出題目,可能不知道失敗是模型能力不足、工具失靈,還是流程沒有恢復機制。
第三項案例是 Yang 等人在 2024 年提出的 SWE-agent 研究。他們設計面向語言模型代理的電腦操作介面,並在 SWE-bench 上比較不同介面與代理設定,研究報告其方法在當時設定下改善了程式修補表現。論文原文 這項工作並非跨 Harness、固定模型的同類比較,因此不能用來推翻 Liu 與 Han 的結果;它說明介面設計在特定模型、工具和任務搭配下可能帶來收益。
另一個限制是一次跑分的解析度。核心研究整理先前評測時指出,不同 Harness 在單次測試中曾出現較大差距,但同一設定重跑也會波動;若沒有多次重跑、任務配對和信賴區間,就很難辨認提升來自框架本身還是抽樣起伏。基準題型也會影響答案:修補既有開源專案的 bug,不等同於團隊中的新功能開發、程式碼審查、部署或長期維護。
「模型名稱本身不是完整的比較單位。」Vats 與 Golev 在 Terminal-Bench Pro 研究中指出,模型與 Harness 的配對會共同影響成本、延遲和監督負擔。
四、團隊怎麼判斷導入成本是否值得?
先用日常任務定義成功與失敗,再固定模型、版本、執行環境和驗收方式,重複比較現有流程與候選 Harness;判斷時同看品質、總成本、時間、人工修復和維護負擔。
建立可以重跑的內部任務集
選取能代表團隊工作的任務,例如修復常見錯誤、補測試、更新依賴或完成小型功能,並保留實際使用者會遇到的程式庫和限制。先寫明什麼算成功:測試是否通過、修改是否符合規範、是否引入安全或相容性問題,以及人工審查要花多少時間。驗收標準要在跑測試前定下,避免看到結果後才改規則。
比較時固定模型版本、可固定的系統提示、運算資源、權限和任務輸入;同一任務在兩種設定下都重跑,並記錄結果。Harness 的工具、上下文管理與復原策略要視為受測系統的一部分,逐項記錄版本和設定。任務數量不足時,結論只適用於觀察到的任務。
把成功率與每項成功任務的代價放在一起
至少記錄成功率、每項成功任務的模型費用或 token 數、完成時間、重試次數、人工修復時間、人工退回率,以及因逾時或工具故障而中止的比例。對有合規或安全要求的程式碼,還要記錄審查發現的缺陷與修正成本。團隊可以把這些指標轉成共同的決策表,先排除未達必要品質或安全門檻的方案,再比較每項合格成果需要多少資源。
| 評估面向 | 建議記錄 | 要回答的問題 |
|---|---|---|
| 品質 | 測試通過率、審查退回率、缺陷數 | 交付結果是否符合團隊驗收? |
| 成本 | 輸入與輸出費用、每項成功任務成本 | 多花的費用換到什麼改善? |
| 時間 | 完成延遲、等待與重試時間 | 是否縮短整體交付時間? |
| 人工負擔 | 修改、複核與接手時間 | 團隊是否仍需大量補救? |
| 韌性 | 逾時、輸出中止、工具失敗率 | 失敗時能否恢復或安全停止? |
| 維護與治理 | 版本升級、權限設定、日誌與稽核工時 | 長期維持需要多少人力? |
- 從近期工作中挑選一組可重複執行、涵蓋常見與困難情境的任務。
- 事前寫好測試、人工審查和安全條件,並設定可接受的成本與延遲上限。
- 固定模型、版本、權限與環境,讓現有流程及候選 Harness 在相同任務上多次執行。
- 同時計算成功率、每項成功任務成本、重試、人工修復時間與中止原因。
- 只在改善穩定超出重跑波動,且達到品質門檻後,再評估擴大導入;把升級、治理與訓練工時納入總成本。
對工程團隊而言,值得採用的 Harness 不一定是功能最多的一套,而是能在目標任務上穩定通過驗收,並以團隊可承擔的成本和監督方式運作的組合。先挑一組日常任務做基準,讓現有流程和候選工具都重跑,再依結果決定是否擴大,比憑單次榜單分數換工具更能回答導入價值。
- Harness 把模型接上提示、工具與上下文管理;它會改變成本和失敗方式,也可能改變任務結果。
- 單次跑分難以辨認小幅改善。比較要固定條件、重跑任務,並說明樣本數能解析到多大的差距。
- 導入評估應同看品質、成本、延遲、人工修復和維護負擔,並以自家任務驗證。
先定義常見任務與驗收標準,再用固定條件比較現有流程和候選工具,並記錄每項成功成果的總成本。
常見問題
Q1:Harness 是什麼?
Harness 是包在模型外層、讓它能使用工具並持續完成任務的軟體框架,通常包括系統提示、工具介面、對話上下文管理和停止或復原規則。
Q2:這項研究能證明所有程式代理都沒有品質差異嗎?
不能。研究聚焦 SWE-bench Verified、特定模型與當時測試的 Harness 版本。任務類型、模型能力、權限和工具都可能改變比較結果。
Q3:團隊應該先換工具還是先做內部評測?
先定義常見任務與驗收標準,再用固定條件比較現有流程和候選工具。這樣才能判斷改善是否超過重跑波動,並估算每項成功成果的總成本。
參考來源
- Liu Y, Han Z. (2026). *What Does a Harness Buy? Tokens, Mostly.* arXiv
- Vats N, Golev O. (2026). *The Scaffold Effect in Coding Agents: Harness Choice as a Hidden Variable in Coding-Agent Evaluation.* arXiv
- Yang J, et al. (2024). *SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.* arXiv


