
思考模型搭配結構化輸出時,回應時間會不會因為先推理、再整理格式而拉長?評估 Ollama 0.34.4 時,先要分清楚耗時來自模型生成,還是服務端為了同時處理思考內容與格式限制而多跑了一段流程。這次版本更新針對思考模型的結構化輸出,改成單次通過;官方表示這項調整讓處理更快、也更可靠,但沒有公布速度提升幅度或涵蓋哪些模型與硬體。對正在維護本地模型應用的團隊來說,值得確認的重點是版本行為、既有解析方式,以及自己的工作負載是否真的受益。
思考模型搭配結構化輸出,時間花在哪裡?
回應時間包含模型產生思考內容、輸出符合格式的答案,以及 Ollama 與應用程式處理請求的時間。Ollama 0.34.4 調整的是思考模型套用格式限制的服務端流程,不能由版本說明直接推算每個應用能省下多少時間。
「思考模型」是會先產生推理過程、再產生最終回答的模型。Ollama 的 API 會把兩者分開呈現,例如 chat 回應中的 message.thinking 與 message.content。結構化輸出則是要求模型依指定格式回覆,最常見的做法是提供 JSON Schema,也就是描述欄位、資料型別與必要內容的規則。像是客服分類器要回傳 category 和 confidence,或文件擷取工具要整理日期與金額,接收端就能依固定欄位處理結果。
兩種能力各自處理不同問題:思考功能控制推理內容如何產生或呈現;結構化輸出約束答案形式。應用若要模型推理後回傳可解析的 JSON,就必須確保格式限制作用在合適位置。否則,推理文字可能混入 JSON,或格式限制過早介入而影響輸出。單看模型每秒產生多少 token,不足以說明完整延遲。
量測前要先定義「快」指什麼。使用者通常在意送出請求到收到可用答案的時間;工程端還會追蹤首 token、完整回應、生成 token 數與應用端解析時間。串流介面先顯示思考內容,不代表結構化答案也提早送達;等待完整 JSON 才更新的工具,也可能讓使用者感覺較慢。評估時應挑定對應產品體驗的指標,避免把不同階段混成單一數字。
「思考模型的結構化輸出現在以單次通過套用,因此更快且更可靠。」這是 Ollama 0.34.4 發布說明對更新目的的描述,屬於官方版本資訊,並非針對各種工作負載公布的獨立效能測試。
Ollama 0.34.4 把哪個環節改成單次通過?
官方發布說明確認,思考模型上的結構化輸出改為單次通過。相關合併請求進一步說明,原本服務端會先執行一輪未受格式限制的生成,再取消並重新整理提示,在格式限制下重新生成;新流程讓思考與受 schema 約束的答案於一次生成中完成。
這項差異描述的是 Ollama 伺服器與底層執行器如何協調「思考結束」與「套用輸出格式」。依合併請求的維護者說明,舊做法要等解析器判斷輸出已離開思考階段,再重新送入提示並啟用文法限制。這會帶來額外的提示預填(prefill,也就是模型正式生成前讀取輸入內容的計算階段),還可能在切換邊界漏掉一段串流內容、合併兩次請求的統計資料,或在特定執行器出現多餘 token。更新後,服務端會辨識思考區段的結束位置,讓執行器只在後續答案套用格式限制。
| 比較面向 | 舊有處理方式(合併請求所述) | 0.34.4 更新方向 |
|---|---|---|
| 生成流程 | 先無格式限制生成,再取消、重整提示並受格式限制地重新生成 | 思考與格式化答案在單次生成中完成 |
| 提示預填 | 可能因重啟流程再次處理提示 | 合併請求指出提示只評估一次 |
| 思考與答案交界 | 需要解析邊界並拼接兩次請求結果 | 執行器依思考結束標記,在後續內容套用限制 |
| 可直接確認的效益 | 合併請求描述額外預填、邊界內容與指標拼接等成本 | 官方稱速度與可靠性提升,未列量化幅度 |
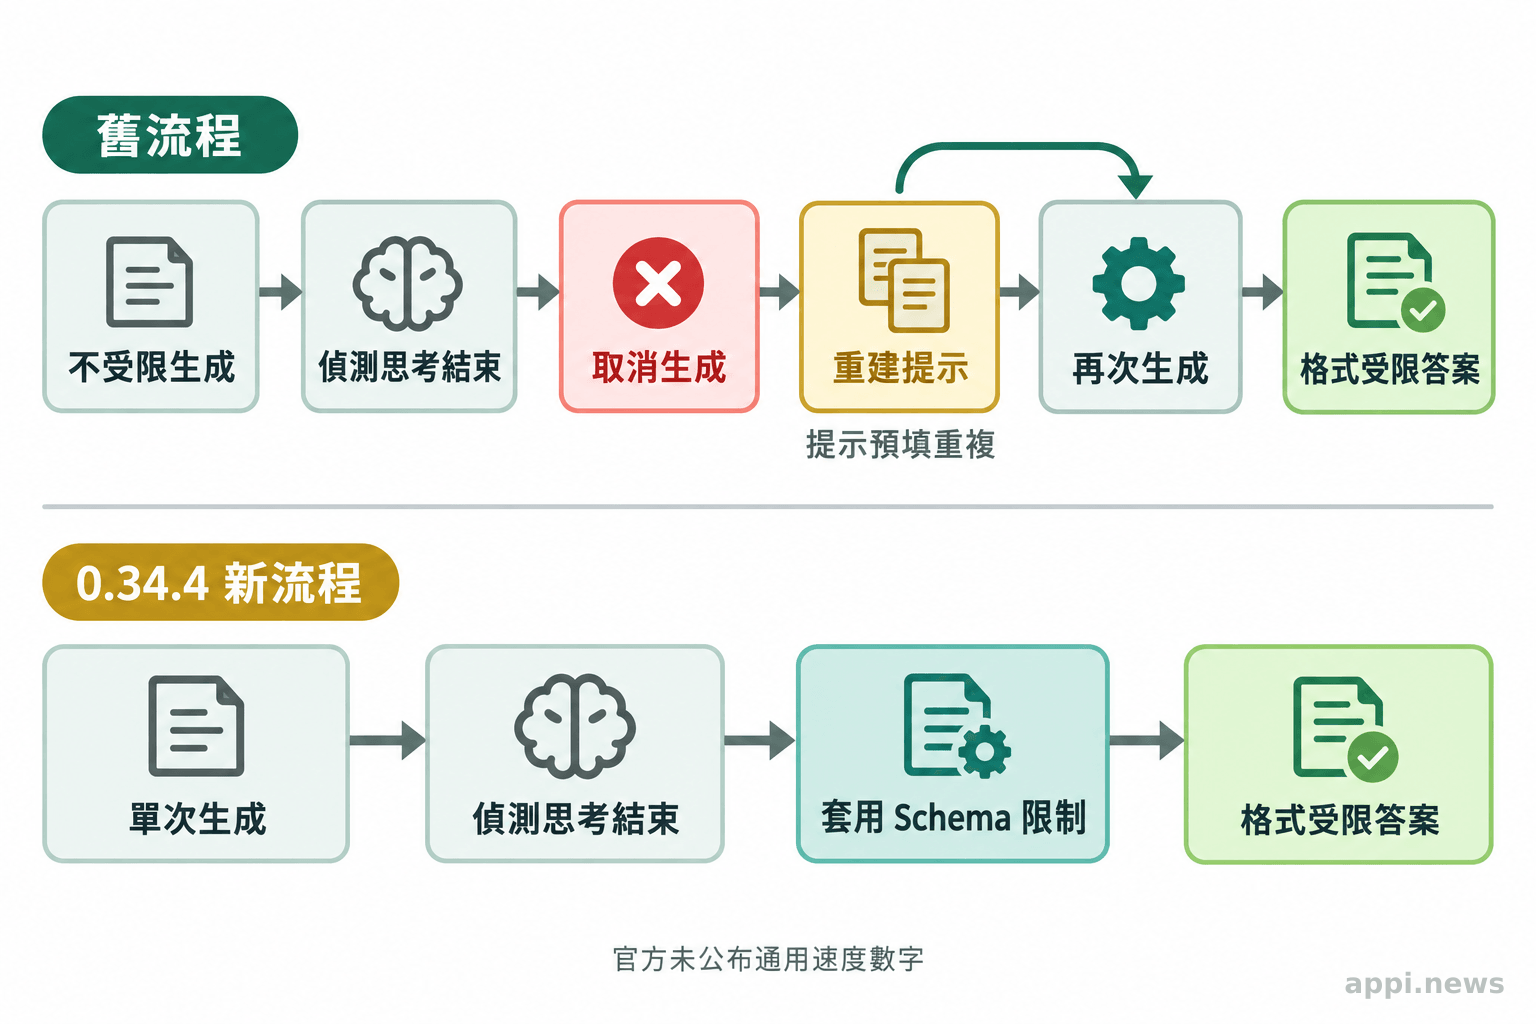
不宜把對照表解讀成所有舊請求都固定執行兩輪。合併請求描述的是思考模型搭配 format 的舊處理方式,也指出不思考的模型維持原本行為。一般文字生成、工具呼叫或未使用結構化輸出的請求,不能只因版本包含這項變更就推定變快。實作說明確認了生成與預填流程的改動,沒有提供特定模型的速度、記憶體需求或應用整體吞吐量保證。
Ollama 維護者在合併請求中說明,舊流程會「重跑一次提示預填」,並需要「把兩次請求的指標拼接起來」;這說明了服務端流程的成本來源,但沒有提供適用所有環境的延遲測量值。
單次通過為什麼可能縮短回應時間?
不代表。單次通過可能省去重新預填提示及重新啟動生成的工作,但實際差異仍取決於模型的思考長度、輸出長度、硬體、執行器、串流方式與請求設定;官方沒有公布各情境的基準測試數據。
可以把一次請求的耗時概略拆成幾項:模型讀取提示與 schema 的時間、思考內容生成時間、最終答案生成時間、服務端格式限制處理,以及應用端接收和驗證回應的時間。0.34.4 的更新主要針對格式與思考階段如何銜接,當原本重跑提示所占比例較高時,改善較可能被量測看見;如果模型花大部分時間生成長篇推理,或使用者的等待主要來自模型載入、磁碟讀取與網路傳輸,流程少一次未必會顯著改變整體等待時間。
模型推理長度也會影響結果。不同模型對 think 的支援與預設值可能不同,有些可指定推理層級,有些只有開關。若前後版本產生長短不一的思考內容,延遲差異就不能只歸因於服務端更新。測試前要確認模型支援的思考設定,並固定該設定。
schema 本身也可能造成時間差異。欄位越多、巢狀結構越深、列舉值越複雜,模型生成答案時需要遵守的限制可能越多。這不等於複雜 schema 一定更慢;它提醒測試者要拿產品實際會使用的 schema 評估,而非只用幾個簡單欄位的示範案例。若比較版本時同時更換提示、schema、模型量化版本或上下文長度,量到的差別便混入多項變因,難以判定更新到底帶來什麼。
「可靠性」也要轉成可觀察指標,例如 schema 符合率、JSON 解析成功率、必要欄位完整度、思考與答案分流正確率,以及串流內容遺失情形。官方沒有附上成功率或樣本數。應用團隊可據此設計驗收條件,並保留失敗請求與原始回應,定位問題來自模型、格式限制或客戶端串流處理。
既有應用需要改 API 或 JSON Schema 嗎?
官方資料沒有要求所有使用者改寫 API 或 schema。若應用已透過 format 傳入 JSON 或 schema,應在測試環境核對升級後的輸出欄位、思考內容分流、串流事件和錯誤處理,再依實際差異決定是否調整程式。
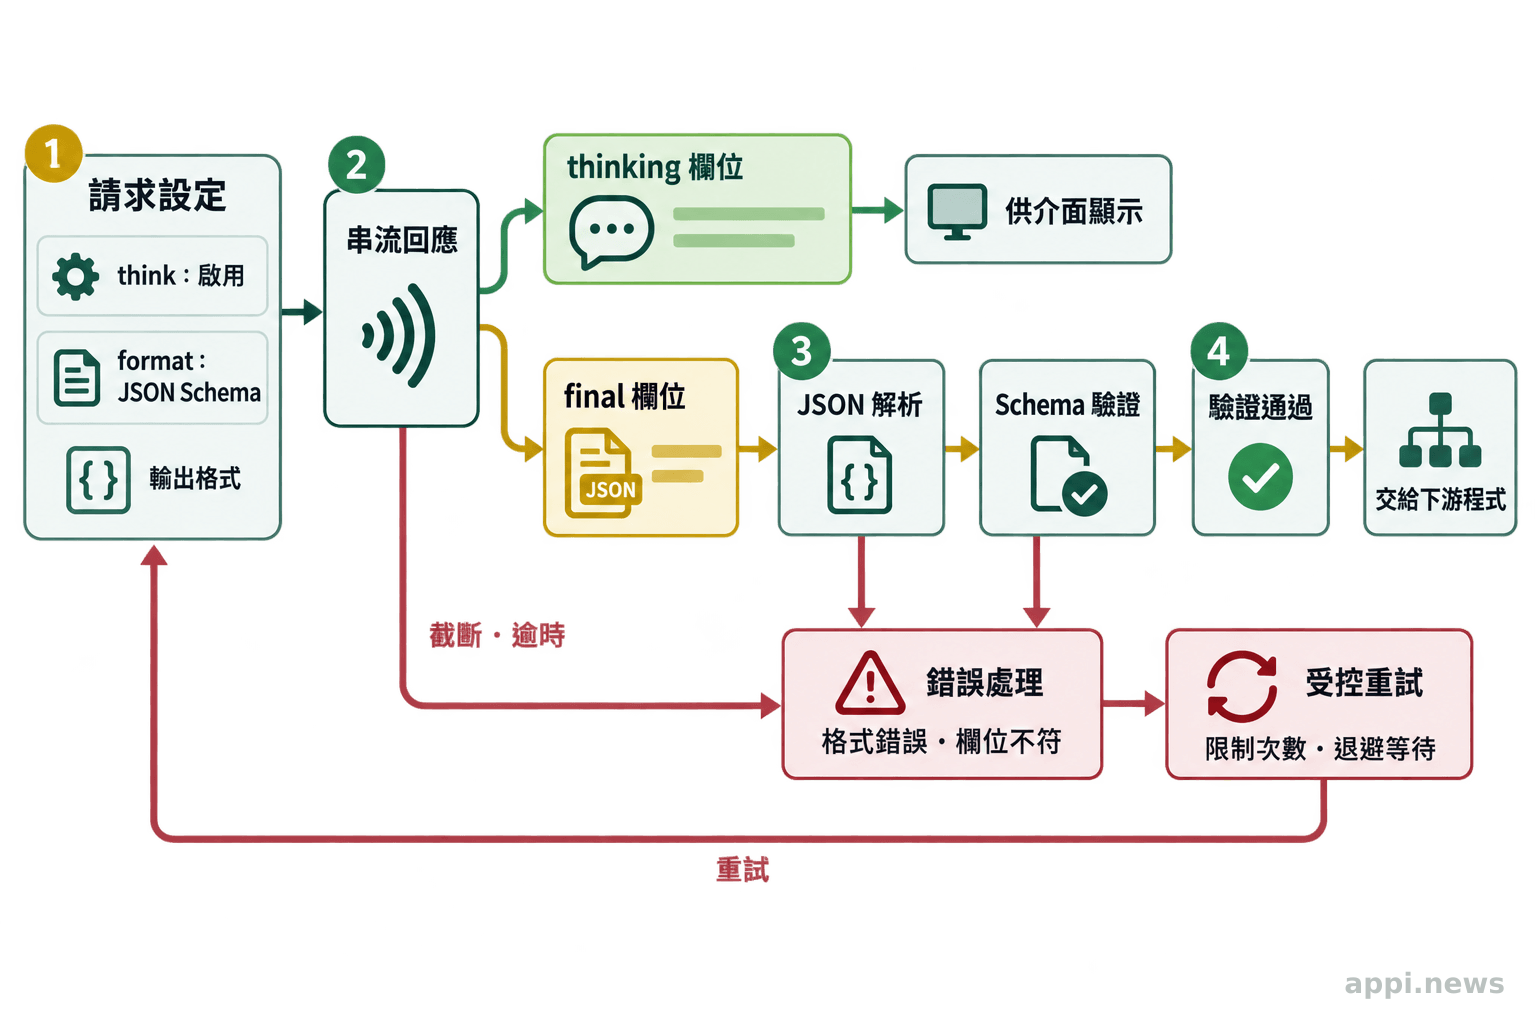
Ollama 官方文件目前說明,結構化輸出可在 chat 請求的 format 欄位傳入 json 或 JSON Schema;思考功能則有獨立的 think 設定,回應可把推理內容與答案分欄呈現。這兩個欄位分別負責輸出格式與思考行為。升級時應以應用正在使用的 API 端點、用戶端函式庫版本與請求組合為準,不要單憑 release note 推斷所有整合介面完全沒有變化。
第一項檢查是 schema 與解析器的契約。確認必填欄位、型別、可空欄位和巢狀物件符合下游程式預期;接收後仍要實際解析 JSON 並驗證 schema。受格式約束的生成能改善輸出一致性,並不代表程式可以略過驗證。若模型在預期範圍內無法提供資料,應確認應用對缺值、拒答、截斷及格式錯誤的處理方式,而不是假設欄位一定存在。
第二項檢查是 thinking 和 content 的分工。串流處理若只把 message.content 當成全部回應,就要確認思考欄位是否需顯示、隱藏或記錄;如果下游只收 JSON,則應確認解析器只針對最終答案工作,不把思考片段當成 JSON 開頭。思考內容也可能包含內部推理資訊,應依產品需求決定是否保存或呈現,避免日誌無限制地留存不必要內容。
第三項檢查是中斷與錯誤狀況。核對思考轉到答案時是否會收到空片段、結束標記或分段 JSON;超時、輸出截斷或模型載入失敗時,應用也要能明確回報並決定是否重試。重試時避免把部分回應附加到舊 JSON,或用新內容悄悄覆蓋已交付結果。更新改善邊界處理的目標,仍需以實際資料流和錯誤策略測試。
怎麼測出升級對自己的工作負載有沒有幫助?
在相同硬體與軟體環境下固定模型、提示、schema、思考設定及生成參數,使用代表性請求分別測量升級前後的首個答案時間、完整回應時間、schema 驗證成功率和錯誤/重試次數。多次重跑並記錄環境差異,才能判斷結果是否符合自己的部署需求。
測試資料應包含應用常見請求,避免只用特別設計的短提示。可依輸入長度、思考長短、schema 複雜度和串流模式分組,保留提示、schema、模型名稱與輸出,以便未來重跑同一組測試。
- 在可回復的測試環境記錄目前 Ollama 版本、模型標籤、執行器與硬體規格,備份實際使用的請求範例。
- 固定模型、提示、schema、
think值、生成選項、上下文長度及串流設定;不要在版本切換時順手改動這些項目。 - 對每個代表性請求重複執行,記錄請求開始到第一段最終答案、完整回應完成的時間,以及解析和 schema 驗證結果。
- 另記思考輸出長度、答案 token 數、超時、截斷、格式錯誤與重試情形;將失敗樣本保留下來檢視。
- 把中位數與較慢批次的延遲分開比較。若效能改善伴隨格式錯誤、思考欄位遺失或重試增加,先查清楚原因,再決定是否推進部署。
首 token 和完整答案時間應分開記。串流模式可量測第一個 message.content 到達時間,因為前面的 message.thinking 不是下游可用的結構化答案。若產品只在 JSON 驗證通過後執行動作,就以「成功驗證並可交付」作為主要完成時間。
請避免把單次最佳成績當成結論。背景程式、模型冷啟動、記憶體壓力和併發請求都會使量測波動。可以在固定條件下重複測量,分開記錄模型尚未載入和已載入的狀態,並先以單一請求測基礎表現,再以預期的併發量測負載表現。若兩個版本的延遲差距小於測試波動,較穩妥的作法是延長測試或擴充樣本,而非宣稱已確認改善。
測試紀錄應包含版本、模型、硬體、提示與 schema 版本、think 設定、生成參數、串流模式和驗證結果。若模型檔、驅動或用戶端函式庫變更,就另開一組比較。這些紀錄有助定位回歸:延遲變長可能與模型更新有關,格式失敗則可能來自 schema 或解析器。
- 0.34.4 確認調整思考模型的結構化輸出流程,官方稱速度與可靠性提升,但沒有公布普遍適用的量化結果。
- 比較時固定模型、硬體、提示、schema、思考設定和生成參數,分開記錄答案延遲與格式驗證結果。
- 升級決策應同時看速度、輸出契約、串流處理與錯誤恢復是否符合應用要求。
哪些本地模型應用適合先安排升級驗證?
同時啟用思考能力與結構化輸出,且重視回應延遲或曾遇到格式切換、串流邊界問題的應用,最值得優先安排測試。若目前工作負載不使用思考模型,或格式輸出不是服務瓶頸,升級價值就需由其他版本變更與自身維護需求判斷。
對資料抽取、分類、工具決策或需將答案寫入資料庫的本地應用,穩定格式常比單純生成速度更重要。可先用代表性模型和正式 schema 小範圍驗證欄位、延遲與錯誤處理,再擴大測試。若系統需維持固定輸出契約,部署計畫應納入回滾方式、版本鎖定和監測指標。
若應用有嚴格的回應時間目標,先判斷瓶頸是否來自思考模型的格式流程。若主要耗時是長推理、模型載入、上下文或併發資源不足,單次通過帶來的改善可能有限。模型輸出若會觸發自動化動作,也要驗收 schema 通過率、語意正確性與錯誤處理。
維運上,最適合的升級時機通常是有測試環境、有固定輸入樣本,且能快速回復到已知穩定版本的時候。開發者可先記錄目前版本與模型標籤,在隔離環境拉取新版本進行回歸測試,再逐步切換非關鍵工作負載。若主力服務缺乏回歸測試、下游無法容忍格式變動,或目前沒有監測模型失敗的方法,則先補足這些維運條件會比直接換版更能控制風險。
判斷升級價值的問題可以很具體:測試集上有沒有降低可感知延遲?schema 驗證成功率是否維持?串流端有沒有遺失或重複片段?錯誤後能否回復到可預期狀態?部署回滾是否已演練?這些答案比「單次通過聽起來更快」更接近實際決策。先挑一個有代表性的思考模型與結構化輸出請求,在相同硬體、schema 和參數下比較升級前後結果,再依延遲與格式驗證需求決定部署時程。
常見問題:Ollama 0.34.4 結構化輸出更新
Q1:Ollama 0.34.4 會讓所有模型都變快嗎?
不能這樣推論。版本說明聚焦思考模型的結構化輸出流程,沒有公布所有模型、硬體或請求類型的速度提升數據。應以實際模型和請求測量。
Q2:使用 JSON Schema 的程式一定要改寫嗎?
沒有這項通用要求。保留既有請求後,在測試環境確認 JSON 可解析、欄位符合 schema,並檢查思考與答案的分流方式及串流處理,再依觀察結果調整。
Q3:官方說「更可靠」代表輸出一定正確嗎?
不代表。發布說明沒有列出可靠性測試的定義或成功率。應用仍需驗證 JSON 格式、必要欄位和資料內容,並處理拒答、截斷與逾時等狀況。
Q4:只看完整回應時間夠不夠?
不夠。建議同時記錄第一段最終答案時間、完整回應時間、schema 通過率與重試次數。串流應用也要分辨思考內容和可供下游使用的答案。
參考文獻與查核依據
版本差異以 Ollama 官方發布說明與合併請求為準,API 欄位與結構化輸出行為則對照 Ollama 官方功能文件。
- Ollama. (2026). Release v0.34.4. GitHub Releases. https://github.com/ollama/ollama/releases/tag/v0.34.4
- Jesse Gross, et al. (2026). server: apply structured outputs in a single pass on thinking models. ollama/ollama Pull Request #18479. https://github.com/ollama/ollama/pull/18479
- Ollama. (n.d.). Structured Outputs. Ollama Documentation. https://docs.ollama.com/capabilities/structured-outputs
- Ollama. (n.d.). Thinking. Ollama Documentation. https://docs.ollama.com/capabilities/thinking
- JSON Schema (n.d.). What is JSON Schema?. JSON Schema. https://json-schema.org/overview/what-is-jsonschema
- Brandon T. Willard, Rémi Louf (2023). Efficient Guided Generation for Large Language Models. arXiv:2307.09702. https://arxiv.org/abs/2307.09702


