Ollama 0.35.0 RC 的 System One 評分 API,適合處理需要固定選項、條件判斷或量尺分數的文字工作流。這項更新把判斷結果直接整理成結構化輸出,減少先生成一段文字、再用程式解析的步驟;但現階段公告描述的範圍集中在 Nimble 模型與 MLX 執行方式。評估前要先定義要解決的流程問題,再確認模型、輸入和執行環境是否吻合。
System One API 想解決哪一種輸出問題?
它讓呼叫端提出有明確答案空間的問題,並取得標籤、條件機率或量尺分數,適用於原本必須從模型文字中抽取固定欄位的情境。
一般文字生成模型會先產生回答,再由應用程式判讀回答、轉成類別或數值。若工作只需要從「帳務、登入、配送」選出一類,或判定條件是否成立,生成句子可能多出不必要的格式變化。程式還得處理拼字差異、額外說明、無效欄位與格式錯誤。System One 的設計方向,是直接對明確定義的候選答案評分,讓下游取得可以處理的結果。
客服回覆、摘要、解釋原因等需要自然語言的任務,仍然需要生成文字;只有當輸出選項清楚、結果能被程式消化時,直接評分才可能縮短處理鏈。選擇 API 前要先問:流程需要一段回答,還是幾個可以採取下一步的欄位?
choice、noul 與 score 各代表什麼
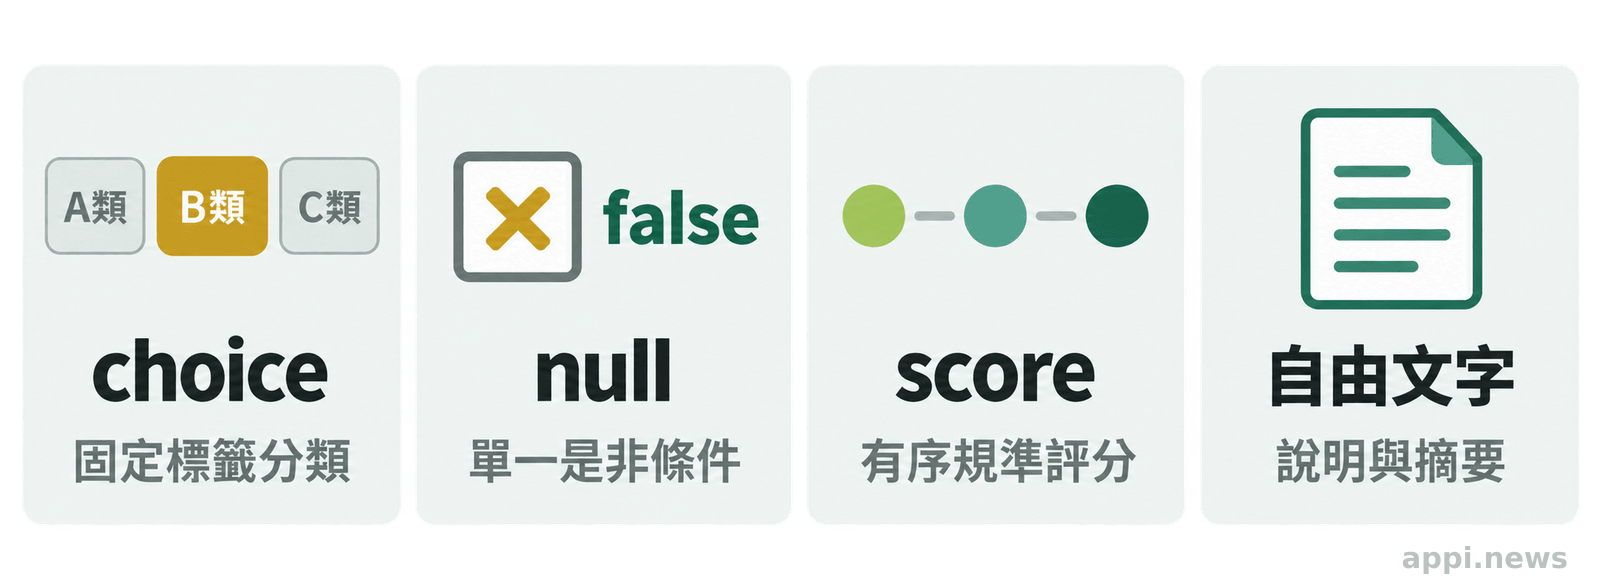
官方 PR 將三種輸出分別稱為 choice、noul 與 score。choice 從指定標籤中選出一項,並附上各選項的機率;例如把工單分到「帳號問題」「付款問題」或「配送問題」。noul 回答一個條件為真的機率,可用於「內容是否包含個人資料」這類二元判斷。score 則依序排列的評分規準,計算預期分數,像是依固定量尺判讀申請內容是否符合幾個層次。
三種輸出背後都需要把問題寫成模型可以判斷的形式。候選標籤如果彼此重疊,或者規準沒有區分清楚,分數看起來再精確也不能修正定義錯誤。以工單為例,「付款失敗」與「帳號無法登入」可以清楚區分;但若「其他」塞進多種不同原因,模型可能把模糊規則量化成看似明確的機率,反而讓使用者忽略分類表本身的缺陷。
為什麼少一道文字解析不等於少了判斷工作
結構化輸出可以減少文字解析,但不會替團隊定義標籤、量尺、例外情況和後續責任。若結果會觸發付款、停權或其他高影響操作,還要定義何時交由人工確認、模型沒有把握時如何退回,以及錯誤如何修正。這些工作不會因為回傳 JSON 或機率欄位而消失。
問題如果沒定義對,後面的方法就會錯。導入前先找出現在最常見的錯誤發生在哪一段:模型答非所問、輸出格式不穩、分類規則模糊,還是系統整合缺少失敗處理。只有前兩者的某一部分可能因直接評分而改善;規則與責任不清仍要另行處理。
Ollama 0.35.0 RC 公告目前確認哪些功能?
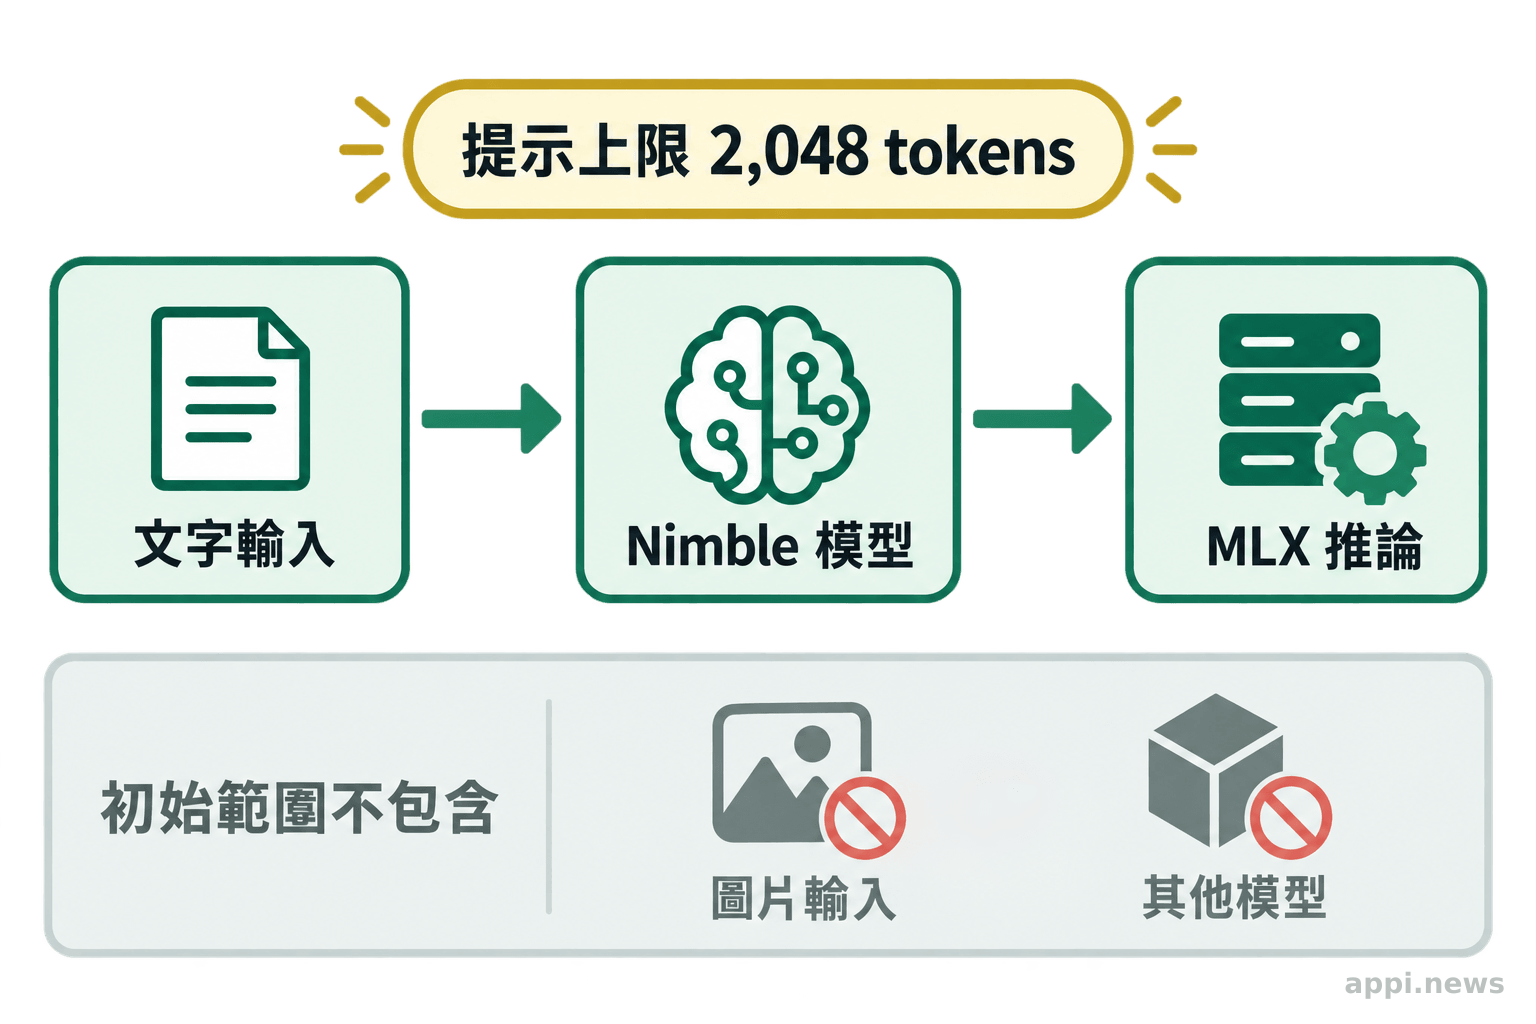
官方 PR 描述 POST /v1/systemone,以文字輸入配合本地 Nimble 模型和 MLX 推論,回傳選項、條件或量尺評分;提示長度上限為 2,048 tokens。
PR 說明,API 對允許的候選選項計算下一個 token 的 logits,再將結果正規化為機率分布,因此呼叫端不必先解析生成的回答。logits 是模型對候選 token 的原始分數;正規化後可以在同一組允許選項之間比較。這個作法有特定的答案空間前提,不能直接解讀成模型對任意開放式問題都會給出可靠判斷。
RC 是候選版本,這篇文章依該版本的 release note 與功能 PR 說明目前功能範圍。PR 頁面列出的變更當時仍標示為開放審查,不能將它寫成所有正式版已支援的穩定介面。實際試用前應確認自己安裝的版本是否包含該功能,並以該版本的文件和程式行為核對 endpoint、請求格式與支援條件。
confidence 是分布集中程度,不是準確率
PR 特別提醒,回傳的 confidence 描述機率分布有多集中,並非經校準的準確率估計。若模型在三個選項上的機率是 0.90、0.06、0.04,表示它在這組選項中把較多機率放在第一個答案;這不能證明該答案在真實資料中有九成正確,也不能推知模型在其他案例上的錯誤率。
模型可能在有偏差或資訊不足的輸入上仍偏向某個選項。分布集中與否還會受到提示寫法、候選答案和模型本身影響,因此需要用有標準答案的代表性案例檢驗結果。若要把信心值當作轉人工的門檻,應先測試不同門檻對漏判、誤判及人工工作量的影響,而不是直接把某個數字視為通用安全線。
“The confidence field measures how concentrated that distribution is; it is not a calibrated accuracy estimate.” — Ollama System One API PR 說明
Nimble、MLX、文字輸入與 token 上限
目前 PR 所列的初始範圍是文字輸入、Nimble 模型透過 MLX 推論,並依 Nimble 訓練設定採用提示格式與 2,048-token 限制;超出上限的提示會被拒絕,不會自動截斷。這些條件會直接影響資料前處理:若工作流要判斷很長的對話或文件,必須先設計合理的摘要、切段或擷取方式,同時確認前處理不會移除作答所需的關鍵脈絡。
PR 把其他模型、圖片輸入及 llama-server 支援列為可能的後續工作。因此不能從「Ollama 有這項 API」推論所有模型、部署介面或多模態資料都能呼叫。整合清單應記下 Ollama 版本、模型、執行後端和輸入型態,逐項驗證相容性。
官方延遲數字能說明什麼
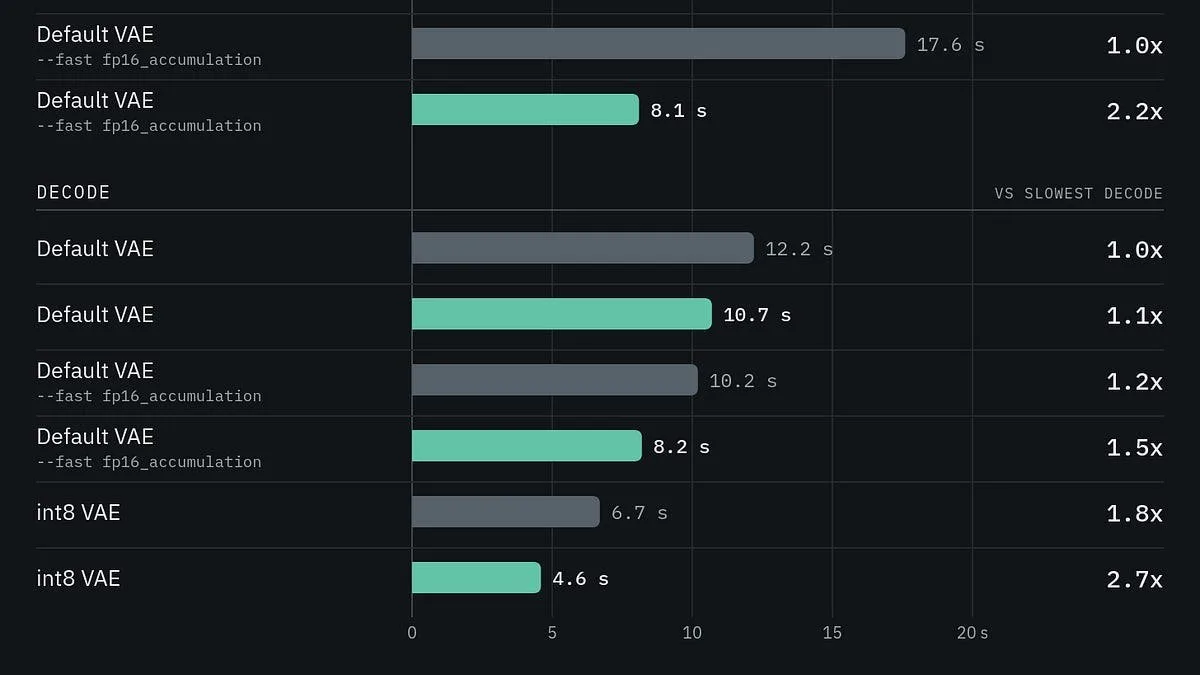
PR 提供一組特定條件下的暖機任務量測:BF16 Nimble、M4 Max、單一並行度,混合任務的中位延遲約 300 毫秒,p95 約 464 毫秒。p95 是九成五請求不超過的延遲門檻。這組數字可做為該測試環境的參考,卻不能推論其他硬體、模型版本、冷啟動情況、並行流量或不同提示長度的效能。
PR 作者也把這些數字界定為小型本地量測,並非通用的準確度或吞吐量基準。官方公告未提供可供跨模型比較的判斷正確率基準;團隊若要決定是否採用,仍須在自己的案例上同時量測分類品質、延遲、失敗比例和人工覆核成本。
“These are small local measurements, not a general accuracy or throughput benchmark.” — Ollama System One API PR 說明
哪些本地模型工作流適合先試?
答案範圍固定、輸入以文字為主,且目前需把生成句子轉成類別或分數的流程,較適合列入第一輪試用;開放式寫作或依賴圖片的工作則不符合公告所述初始範圍。
固定選項分類與條件判斷
可先從低風險的內部流程著手,例如依既有分類表標記客服工單、判斷文字是否含特定條件,或把文件分流到人工處理隊列。這些任務通常有明確的輸入、候選答案和後續處理方式,能把模型輸出與已知標準答案比較。試用資料應涵蓋常見情況,也要收錄容易混淆的例子、缺少資訊的輸入和「其他/無法判斷」類別。
若原流程是讓模型生成完整解釋,再由規則或程式抽取類別,結構化評分可能減少解析與清理工作。不過要先確認應用真正需要的是標籤,還是也需要模型說明理由;這項 API 的列示輸出聚焦在選項或分數,不能假設它同時提供供使用者閱讀的理由。若解釋是稽核或溝通的必要部分,流程可能仍需保留另一個說明步驟。
有序量尺評分與多問題共用情境
score 可對有序規準計算預期分數,因此可評估格式完整性、文本是否符合明確檢查項目,或將內容送往不同覆核層級。量尺要有具體錨點,例如每一級各代表哪些可觀察條件,否則「品質好不好」會把不同人的判準混在一起。預期分數是按選項分布計算的值,也不等同專業評審共識,更不能直接當成客觀品質證明。
PR 提到多問題共用時會共享部分提示計算,並以請求所屬的快取管理相關資料。這是實作說明,不代表大量問題都會自動更快;題目數、提示內容與硬體都會影響延遲,應依預期批次規模測量。
不適合直接套用的工作
如果任務要求模型撰寫回覆、摘要長篇內容、理解圖片,或使用並非公告支援的模型和執行方式,就不能直接假設 System One 可以取代現有流程。若答案需要依賴長對話脈絡,2,048-token 上限也可能成為前處理的主要限制。把上下文截短到模型能接收,可能同時丟掉關鍵條件,因此不能只看請求是否成功送出。
涉及高影響決策的流程要更審慎。舉例來說,若錯誤分類會讓使用者失去服務或直接觸發帳號處置,需保留人工覆核、申訴與回復路徑。小型測試集表現良好,只代表該批案例有觀察到的結果,不能證明未來資料分布、邊界案例或使用者行為改變後仍有相同表現。
| 工作需求 | 可先評估的 System One 輸出 | 試用前要確認 |
|---|---|---|
| 從固定類別中分流文字 | choice | 分類定義是否互斥,是否有其他或拒答選項 |
| 判斷單一條件是否成立 | noul | 正反例如何標記,錯判後由誰接手 |
| 依序排列的規準給分 | score | 每級描述是否可觀察,預期分數如何解讀 |
| 產生說明、摘要或圖片判讀 | 不在目前公告初始範圍內 | 另選符合需求的模型或流程,不預設已有支援 |
試用前要先檢查哪些整合成本?
先核對版本、模型與執行後端,再測試輸入長度、無效或模糊輸入的處理,以及結果如何進入現有流程;評估時要同時看品質、延遲與人工覆核需求。
模型、硬體與執行環境是否符合
列出現在使用的 Ollama 版本、Nimble 模型版本、MLX 環境與硬體,再確認實際安裝是否包含公告中的 endpoint。若用的是其他模型、CPU 或 GPU 執行方式,應把相容性列為待驗證項目,不能照搬 M4 Max 測試的數字。版本更新也可能改變 API 行為,測試紀錄應保留請求格式與軟體版本,讓後續結果可以重現。
本地推論常被視為能降低資料外傳,但部署位置本身不足以證明資料治理已完成。團隊仍需盤點輸入中是否含敏感資料、存取權限、日誌保存方式和模型檔來源,並依組織既有規則處理。若只是先做離線功能評估,可用去識別或合成案例;要接上真實工作流前,還需確認資料流向與留存設定。
輸入長度、失敗處理與結果驗證
提示設計應包含必要脈絡和明確候選答案,並測試接近上限的輸入、超長輸入、格式錯誤和資訊不足的文字。PR 表示超長提示會被拒絕而非截斷,整合端便要處理錯誤並決定重試、縮短輸入、轉人工或停止處理。若系統把失敗當成一般低信心結果,操作人員可能無法分辨「模型無法判斷」和「請求根本沒有成功」。
輸出端也需要檢查。確認回傳欄位符合程式預期、候選答案仍有效,並保留模型版本、請求狀態和必要的稽核資訊。當答案不在允許範圍、機率欄位缺漏或服務逾時時,要有明確的備援路徑。不能只靠提示要求模型「有疑問就說不知道」,而要在應用程式中定義拒絕條件與人工處理方式。
用小型測試集比較品質、延遲與人工覆核
先挑一個答案範圍明確、現在需要文字解析的本地工作流,整理具有代表性的測試案例,並由熟悉流程的人標記基準答案。保留既有方法作為對照,例如原本的生成加解析流程,或人工分類結果。記錄兩種方案在同一批輸入上的正確分類、錯誤類型、回應延遲、格式錯誤與需要人工介入的比例。這樣才能看見 API 減少了哪個步驟,又新增了哪些工作。
測試集應涵蓋常見輸入、相近標籤、資訊不完整和曾出錯的案例。錯誤代價不同時要分開統計,例如一般工單分錯與敏感內容漏判。單一總分會掩蓋風險,也不能只看平均延遲而忽略慢請求或服務拒絕。
- 選定一個低風險、答案範圍明確的文字流程,寫清楚輸入、候選結果和錯誤後續處理。
- 核對 Ollama 版本、Nimble 模型、MLX 環境與提示長度,確認實際呼叫的功能範圍。
- 用代表性案例與既有方法比較品質、延遲、失敗處理和人工覆核量,記錄錯誤類型。
- 只有當改善目標明確且風險可控時,才將測試擴大到更接近實際運作的環境。
如何判斷這項 API 是否值得納入流程?
若它能在已確認支援的環境中,減少目前文字解析的錯誤或維護負擔,而且分類品質、延遲與人工覆核成本都符合流程要求,才值得進一步整合。
這項更新的價值取決於答案空間是否能先定義清楚,以及下游程式是否需要穩定的欄位,而非模型名稱是否新或單次回應看起來是否有信心。若現有流程已經能穩定輸出結構化資料,改用新 API 未必能降低整體成本;若問題根源是分類標準含糊或資料不完整,換一種輸出方式也不會自動消除錯誤。
在概念驗證階段,將改善目標寫成可以觀察的條件,例如減少格式修補、降低特定類型的錯誤,或讓人工覆核集中於疑難案例。接著用測試結果判斷是否達標,並檢視維護 API、模型與執行環境所增加的工作。任何延遲數字都要連同硬體、模型、提示長度、並行度和暖機條件一起記錄,避免拿單一環境數字作為上線承諾。
最後回到實際使用情境:確認目前的 RC 或後續版本是否仍具備所需功能,並為不支援的模型、超長輸入和低品質判斷留下處理方式。System One 可作為固定答案工作流的一種評估選項,採用與否則要由目標模型的實測與既有流程需求決定。
- System One 針對固定選項、條件機率與有序量尺評分,減少由生成文字再抽取欄位的需要。
- 目前公告所述初始範圍是文字輸入、Nimble 與 MLX,並有 2,048-token 提示限制;其他模型、圖片與 llama-server 支援仍屬後續可能方向。
- confidence 代表機率分布集中程度,不等於正確率;效能數字也只反映特定 M4 Max 測試條件。
- 試用時要以代表性案例和既有流程比較品質、延遲、錯誤處理及人工覆核成本。
常見問題
Q1:Ollama System One 評分 API 已支援所有模型嗎?
目前官方 PR 描述的初始支援範圍是 Nimble 模型透過 MLX 進行文字推論。其他模型與執行方式列為可能的後續工作,應以實際版本文件和測試結果為準。
Q2:API 回傳的 confidence 可以當成準確率嗎?
不可以。PR 說明 confidence 反映允許選項的機率分布集中程度,不是經校準的準確率估計。是否可靠仍要用有標準答案的案例驗證。
Q3:圖片和 llama-server 可以使用這項功能嗎?
目前公告把圖片輸入與 llama-server 支援列為後續可能方向,沒有將它們列入初始範圍。需要這些功能時,先確認目標版本是否已實作並自行驗證。
Q4:小型測試集表現良好,就能直接全面採用嗎?
不能只根據一批測試做這項推論。應檢查測試案例是否涵蓋常見、模糊和高風險輸入,並把分類品質、延遲、失敗處理及人工覆核成本放在一起評估。
參考文獻
- Ollama. (2026). v0.35.0-rc0 release note. GitHub. https://github.com/ollama/ollama/releases/tag/v0.35.0-rc0
- Parth Sareen. (2026). feat: add System One scoring API, Pull request #18606. Ollama GitHub repository. https://github.com/ollama/ollama/pull/18606