
目錄(6 節)
NaiveAI 的 Naive-N0.5-Flash 每秒可輸出約 2,100 個 tokens。模型方說明,NaiveRT 在 8 張 Blackwell GPU 上,以單一串流執行 HTML/SVG 請求,最佳一秒窗口達 2,122 tokens;數字排除輸入預填充,並採關閉思考設定。這是解碼峰值,不是完成程式需求或修復軟體問題所需的時間。NaiveAI 技術說明引出關鍵問題:輸出快,程式工作是否也快?
開發者要從實際任務、程式正確性和修改成本一起判斷。NaiveAI 公布的基準分數提供起點,其他研究則可對照任務完成時間。
NaiveAI 實測 2100 tokens/s 要怎麼解讀?
這是特定推論環境下的單串流輸出峰值,不能直接代表使用者每秒收到的文字,也不能當成任務完成速度。
NaiveAI 將執行環境命名為 NaiveRT,結合推測解碼與 GPU 最佳化。草稿模型先提出多個 token,再由目標模型驗證;接受率高時可減少逐 token 解碼等待。官方說明,2,122 tokens/s 是 41 個 HTML/SVG 請求中,關閉思考時最佳一秒窗口的單串流結果,不是 API 平均值,也未涵蓋長提示和工具往返的延遲。
時間要拆成首字等待、解碼速度和端到端完成時間。平均解碼速度提高,不保證首字更早出現;長輸出、大上下文或多次工具呼叫,都可能拉長總時間。模型推論速度與輸出限制也顯示,單一速度指標只說明流程的一個環節。
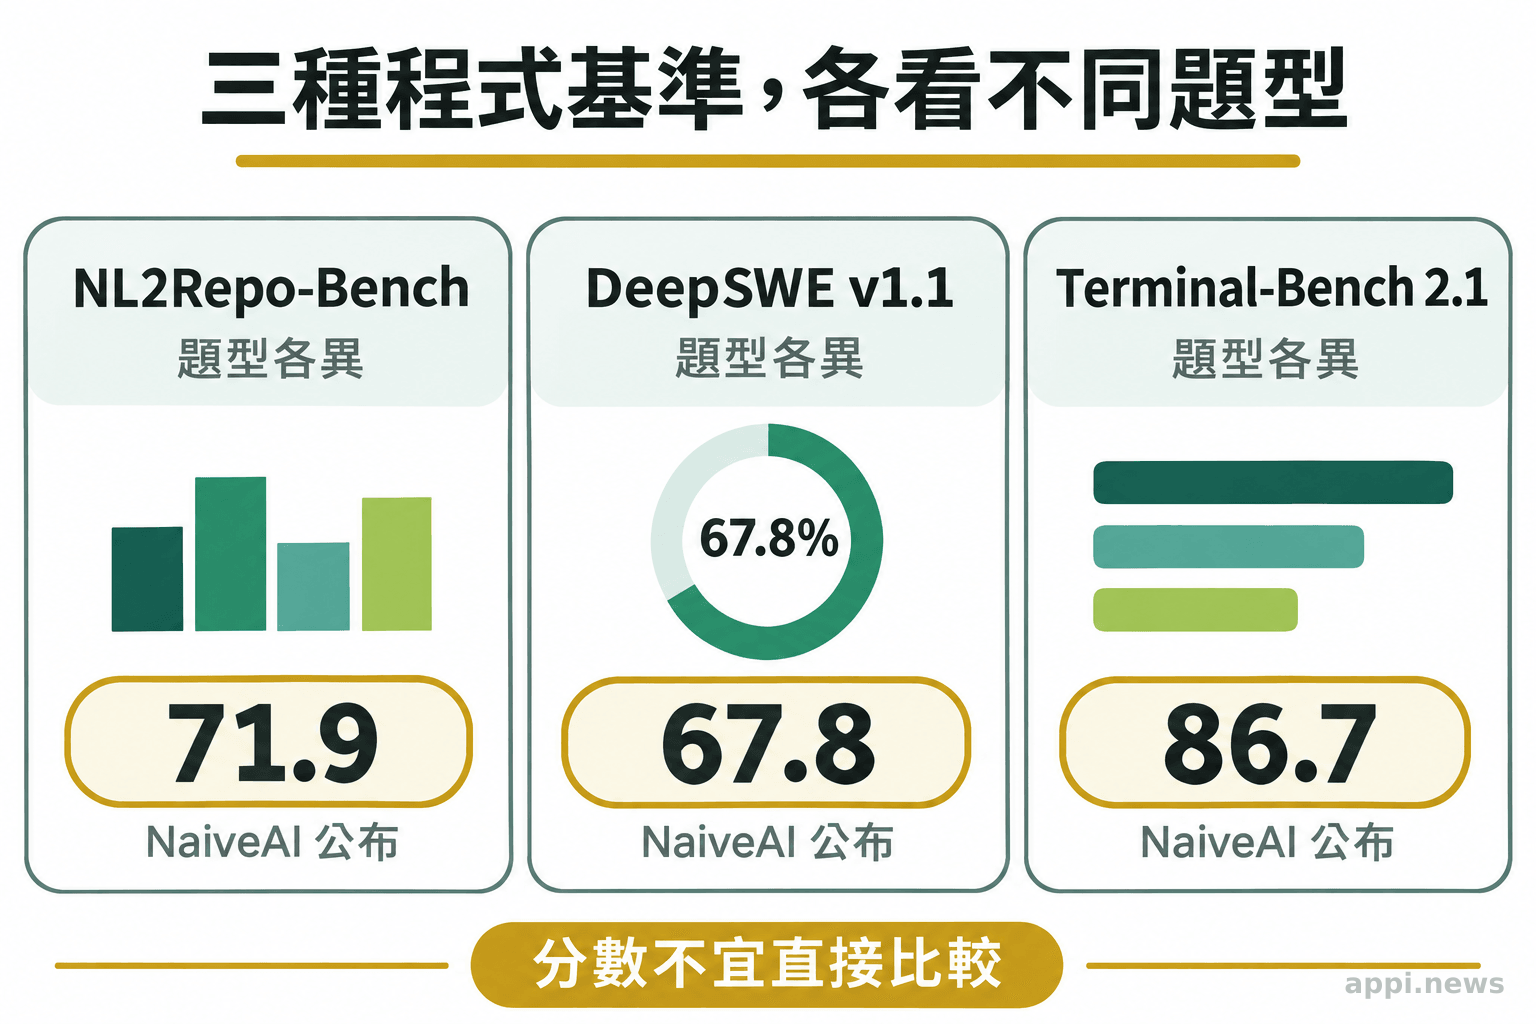
基準分數也有自己的語境。NaiveAI 技術頁列出 Naive-N0.5-Flash 在 DeepSWE v1.1 得 67.8、Terminal-Bench 2.1 得 86.7、NL2Repo-Bench 得 71.9,並說明一般評測使用 Claude Code 2.1.207、百萬 token 上下文、temperature 1.0、top-p 0.95,以及基本檔案與 Bash 工具。這些數字表示模型加上指定代理環境在各套題目中的結果,不能把三個分數當成相同量尺,也不應視為獨立第三方確認。使用者可以從程式代理評估的品質、成本與導入條件了解,評測工具配置本身也會影響結果。
程式碼有多可靠,才是速度能否轉成效率的關鍵
多套基準顯示它能在不同程式任務上產出可評分的成果,但分數仍要連同測試集、工具配置與評分方法閱讀。
三個案例可看出基準的範圍差異。第一,NaiveAI 自行公布的 NL2Repo-Bench 分數為 71.9,測的是以自然語言需求處理程式庫相關任務;第二,同一頁的 DeepSWE v1.1 分數為 67.8,評估的是軟體工程代理處理任務的表現;第三,Terminal-Bench 2.1 得 86.7,則以終端操作類任務為主。它們都來自模型方技術頁,適合用來認識其聲稱的能力輪廓,卻不能互相換算成「正確率」,也不能由這些分數判斷一般公司程式碼庫的修復成功率。
獨立的 SWE-bench 原始研究以真實 GitHub 問題與程式庫作為評測任務,要求模型修改程式碼來處理問題。這類設計比單看輸出速度更接近「修改是否解決問題」,但依然只代表該測試集及執行條件。NaiveAI 頁面列的 SWE-bench Pro 分數 73.6,需以相應版本的基準規則、代理工具與其公布結果解讀,不能與 SWE-bench Verified 或其他基準混為一談。
另一個真實案例來自 GitHub Next 與 Microsoft Office of the Chief Economist 的研究。研究隨機分派 95 名專業開發者,用 JavaScript 撰寫 HTTP 伺服器,一組使用 GitHub Copilot、一組不使用,並以測試評分正確性與完整度。使用 Copilot 的組別平均用時 1 小時 11 分,未使用組為 2 小時 41 分,完成率分別為 78% 和 70%。這是特定任務下的受控實驗,不能直接外推到 NaiveAI 或大型既有程式庫;但它展示了比 tokens/s 更接近工作效率的指標:任務是否完成、花了多久、結果是否通過測試。GitHub 公布的研究方法與結果也指出,開發者生產力包含多個面向。
「每項延遲最佳化要合併前,完整模型的 logits 與 KV cache 都必須通過嚴格的逐位元比較。」(NaiveAI 技術說明(中文翻譯)) 模型分數仍須回到程式測試。一次產生成功,不代表面對不同輸入或錯誤狀態也安全;需檢查修改是否破壞既有功能、依賴套件是否合適。NaiveAI 的推論說明也提到,部分微基準較快的修改,在完整模型路徑反而變慢。程式生成同樣應先跑測試、看 diff,再談省下多少工時。
為什麼模型輸出快,開發流程仍可能沒有變快?
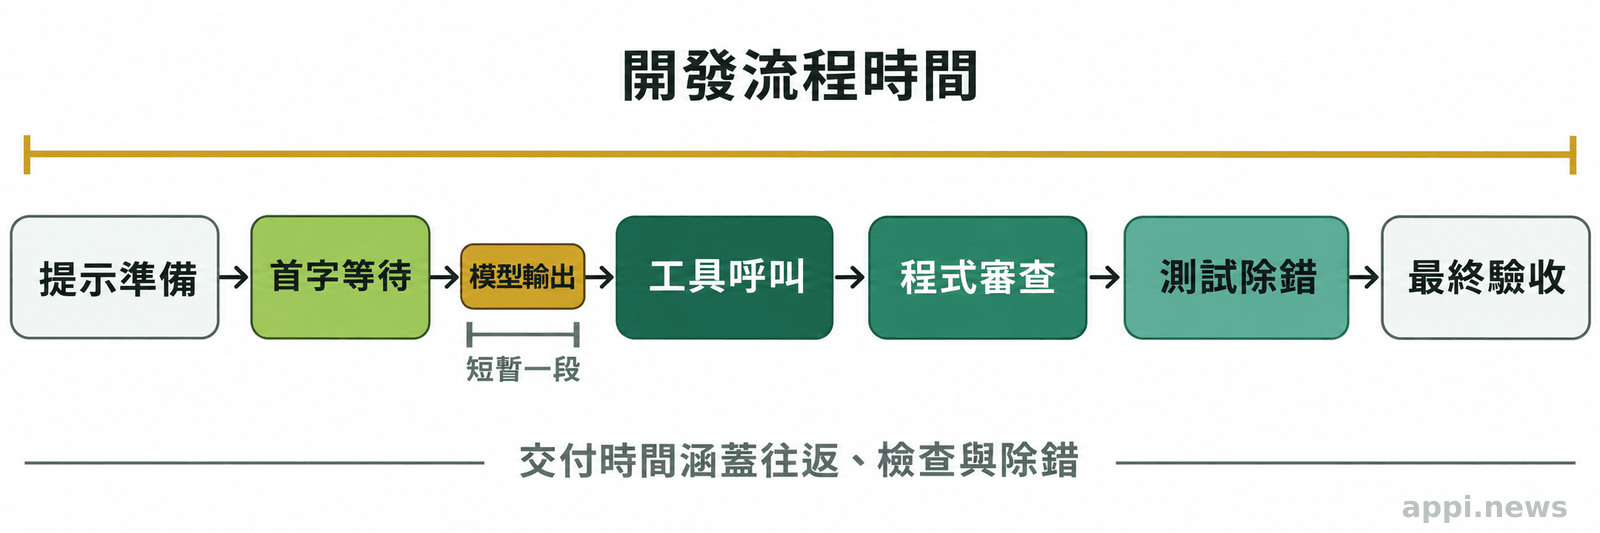
程式交付包含理解需求、等待工具、檢查輸出、執行測試和修正錯誤;模型解碼只佔其中一部分。
AI 程式模型的任務時間可以簡化成:提示準備+首字等待+輸出解碼+工具往返+人工閱讀與修改+測試除錯。tokens/s 只影響解碼這一項。若模型生成一大段不必要的程式,輸出速度再快,閱讀和刪改仍會花時間;若代理為了定位問題讀取多個檔案、重跑測試或多輪呼叫模型,工具和驗證成本也可能高於打字時間。
NaiveAI 公布的 2,122 峰值來自八張 GPU 上的單一串流,並排除輸入預填充;其標準模式和 Ultrafast 模式的單人速度也不同。這意味著部署方式、並行請求、上下文長度與思考設定,會改變實際體驗。推論服務的總吞吐量(同時處理多個請求的總量)也不等於單一開發者看到的速度。採用雲端 API 前,還要確認程式碼和提示是否送往服務端、資料保存多久、是否用於訓練,以及權限設定是否符合團隊政策。
METR 的時間跨度評估以軟體、機器學習與資安任務測量代理在不同難度下的成功機率,並提醒任務設定與代理環境會影響結果。「兩小時任務」描述的是人類專家完成任務的時間尺度,不代表代理必定花兩小時。METR 的方法說明呈現了任務難度、成功率與實際執行時間的區別。
「開發者生產力難以用單一指標衡量,因為它涉及多種因素。」(GitHub Next 研究(中文翻譯))
哪些程式工作值得試用 NaiveAI?
先從範圍清楚、能自動驗收、出錯可回復的任務試起,觀察速度是否真正減少整體等待與修正。
有明確規格的單元測試、資料格式轉換、樣板程式、文件或重複程式碼,容易用測試驗收。涉及權限、付款、個資或大範圍架構調整時,錯誤代價較高,需加強人工審查。若任務依賴特定函式庫版本或內部慣例,也要提供上下文並檢查模型是否遵循。
可先建立一批近期做過、能重複執行的任務,讓 NaiveAI 與現用工具在相同提示、程式碼版本、硬體/服務設定和測試條件下完成。模型或代理設定不同時,應把差異記下來,避免把工具差異誤認為模型能力差異。程式碼應在隔離分支、容器或可回復環境中產生與執行,先檢查變更,再跑單元測試與必要的整合測試;確認沒有未授權的檔案操作或網路存取,才考慮合併。
取得方式也影響成本。NaiveAI 技術頁提到 MIT 授權及 API 價格,實際價格與可用性仍以平台條款為準。自行部署要估算硬體和維護;雲端使用則要查費用、資料政策及服務穩定性。模型可下載、API 可呼叫與商用授權應分別確認。
- 選 10 至 20 個近期重複做過、預期結果明確的程式任務,保留相同輸入與測試。
- 同時記錄首字等待、完整回應時間、工具往返次數、測試是否一次通過及錯誤類型。
- 計入閱讀、人工修改、重跑測試與除錯時間,計算從提交需求到測試通過的總時間。
- 依相同模型版本、提示、代理工具及硬體條件重複比較,另記錄每項任務費用與資料處理方式。
- 對比一次通過率、平均人工修改時間和總成本;只有速度提升且品質、成本與治理條件都可接受,才擴大試用。
開發者如何判斷 NaiveAI 是否適合自己的流程?
把可重複任務的端到端時間、測試通過率、人工修正和費用放在同一張表,才能判斷它是否改善目前流程。
先定義團隊要改善的是補全程式碼的等待、代理任務總時間,還是多人並行時的服務吞吐量。個人互動看首字等待與持續輸出;功能交付看需求到驗收的時間、缺陷及重做;批次生成則看整體吞吐量和單位成本。指標應對準使用目標。
若總時間減少、測試結果不退步、人工修改未增加,且費用與資料政策可接受,才適合擴大試用。若省在 token 輸出,卻慢在首字等待、工具流程或除錯,就要先找出瓶頸。最後依可重複的任務結果決定是否採用。
- 2,122 tokens/s 是 NaiveAI 報告的特定環境單串流峰值,不能直接代表一般開發任務的完成速度。
- 程式基準分數須連同題型、代理工具與評分方法解讀,模型方報告也應與獨立評估區分。
- 試用時記錄端到端時間、測試通過率、人工修改、工具往返、費用與資料政策,再和現用流程比較。
常見問題
不適合單獨判斷;還要測任務完成時間、程式正確性和後續修改成本。
常見問題
Q1:NaiveAI 的 2100 tokens/s 是一般使用者都能達到的速度嗎?
不是。NaiveAI 的技術說明描述的是特定推論執行環境、硬體及單串流測試的峰值。API 模式、硬體、上下文與請求內容不同,速度可能不同。
Q2:tokens/s 越高,寫程式一定越快嗎?
不一定。它只反映生成階段的速度;首字等待、工具呼叫、讀碼、執行測試與除錯都會影響總工時。
Q3:NaiveAI 公布的程式基準分數可以和別的模型直接比較嗎?
只有在基準版本、提示、代理、工具、硬體與評分方式一致時,數字才有直接比較意義。不同題庫的分數也不能互換。
Q4:團隊第一次試用應從哪種任務開始?
先選規格清楚、可重複且有自動測試的小任務,在隔離或可回復環境中執行,檢查程式差異並記錄總工時與修正成本。
Q5:把內部程式碼交給雲端 AI 模型前要確認什麼?
確認程式碼和提示是否會傳到服務端、資料保存與訓練政策、存取權限,以及團隊對機密資訊的規定;未核准的敏感內容不應直接上傳。
參考來源
- NaiveAI Team (2026). Naive-N0.5-Flash: Building Frontier AI with AI. NaiveAI Research
- Jimenez CE, et al. (2023). SWE-bench: Can Language Models Resolve Real-World GitHub Issues? arXiv
- Kalliamvakou E. (2022, updated 2024). Research: quantifying GitHub Copilot’s impact on developer productivity and happiness. GitHub Blog
- METR (2026). Task-Completion Time Horizons of Frontier AI Models


