
目錄(7 節)
Hugging Face 官方文章以一則客服訊息示範 Decision Models:訂閱費被重複扣款,客戶要求當天退款,系統要判斷負責團隊、急迫程度與退款意圖。這是介面示例,沒有呈現部署成效。
團隊常先想到讓大型語言模型(LLM)回傳 JSON,再把欄位接入程式;更前面的問題是,應用需要文字回答,還是明確選項中的判斷?Hugging Face 的 Decision Models 介面用統一格式表達問題與候選答案。決策模型的導入與驗收可作入門參考。
客服訊息要分派給誰?官方示例呈現的輸出方式
前述官方示例把客服訊息設為 state,再提出負責部門、急迫程度、退款意圖等問題,模型回傳各題的結構化判斷與相關分數。
示例的部門選項是帳務、技術支援與銷售,並附簡短說明。模型回傳所選答案與選項機率;急迫程度用低、中、高評分,退款意圖用是非題判斷。應用程式可將結果轉為佇列、標籤或後續工作。
結構化欄位較容易由程式處理,但不保證判斷正確。部門定義重疊、訂單狀態缺漏,或沒有「資訊不足」選項,都可能令模型在錯誤前提下作答。選項描述和例外處理也屬整合設計。
Decision Models 回答哪一種問題?先看 state、問題與答案型態
基本介面是「state(待判讀資料)+questions(要回答的問題)+允許答案」,輸出帶有型態與機率資訊。state 可為文字或結構化資料;部分模型支援其他資料型態。
Hugging Face Transformers 文件列出三種問題型態:choice 從候選答案選一項,score 依有序尺度上的機率分布計算期望分數,noul 估計是非命題為真的機率。每題可附指示與答案條件,讓同一狀態接受不同檢視。
選項須寫明業務邊界,例如「帳務」涵蓋付款、退款與帳單,「技術」涵蓋登入或服務故障。只列名稱會留下灰區。序位尺度也需說明各等級代表什麼,讓分數差異能對應實際處置。
官方示例的 confidence 是機率分布集中程度的摘要,不等同實測正確率。團隊須用標註資料檢查校準,也就是相近機率是否對應相近的實際正確比例;資料分布改變後要重訂門檻。
哪些流程適合交給決策模型?選項要能說清楚
候選答案可事先列舉、錯誤可以被攔截,而且後續流程能依結果採取不同處置的任務,較適合評估決策模型。
分類與路由可先從一般、缺件或人工覆核佇列開始。新增類別時,要同步維護選項、說明、標註資料及路由規則。優先級可用序位尺度表達,但「高優先」如何影響服務時限,須由流程明訂。
Dataiku 把 Jev 包成視覺化代理中的提問區塊,用來處理供應商申請:判斷是否要求例外、申請類型及資料是否足夠,再由獨立路由區塊套用政策。團隊以同一批 200 筆標註申請比較三個代理,Jev 預期路由 157 筆,兩個 JSON 代理為 169、174 筆;平均回應時間分別為 0.3、3.0、2.2 秒。這項工作流測試呈現測試集上的取捨,不代表正式上線成效,也說明判斷與規則可分開驗收。
人才媒合新創 Jack & Jill 每天先為各職缺將約 6,000 名候選人初篩至 2,000 名,再交大型模型複核。TypeSafe 表示,在 150 個職缺的離線比較中,Jev 保留用人主管後續要求面談者的比例相近,成本與時間較低;結果限於該公司流程,不能代表 Hugging Face Decision Models 的表現。
Hugging Face 將 Decision Models 定位為一致的介面,用來表達機率分類與推論時指定標籤等能力;這項設計說明不代表準確率或部署效益保證。
分類與路由:結果如何對應既有佇列
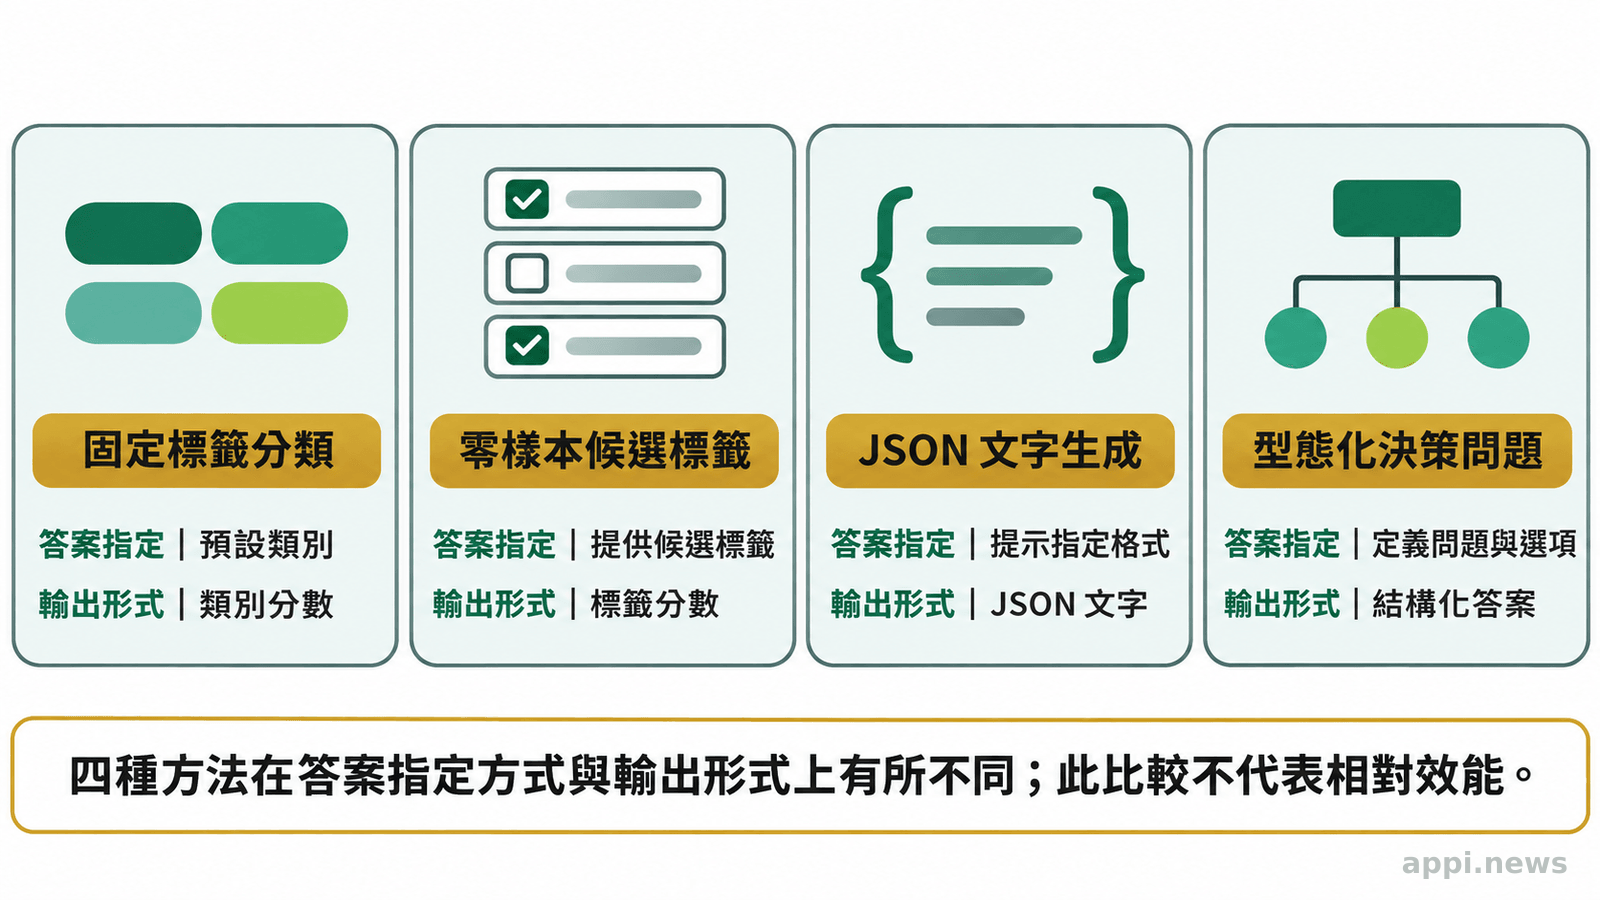
固定標籤分類器在訓練時決定類別;零樣本分類可在推論時提供候選標籤;Decision Models 則以一致介面承載多個問題及不同型態。這是任務表達的差異,不能當成準確率、成本或速度排名。
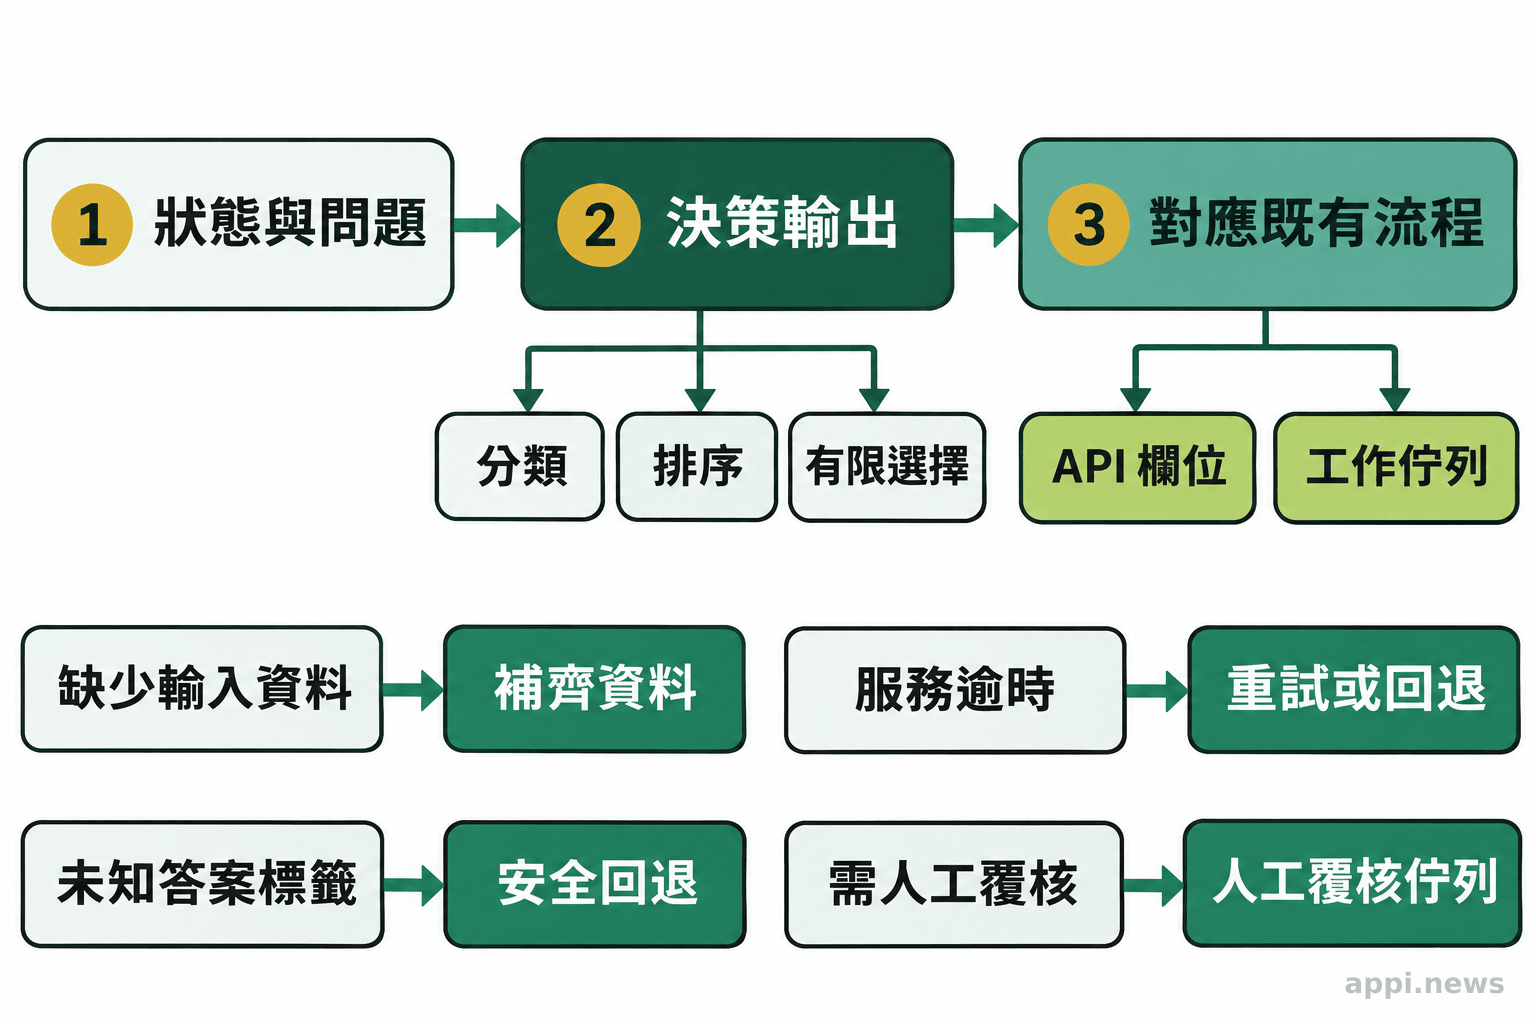
應用端須將輸出對照既有欄位,例如 billing 對帳務佇列、needs_review 對人工覆核。遇到未知答案、缺欄或服務失敗,保留原始請求並走既定回退路徑。不同 API 的概念可參考決策模型 API 與 Jev 的比較;相容性仍須依實作與環境確認。
接進既有系統前,為什麼要先定義資料與例外
要先確認輸入狀態、每道問題的選項和輸出映射,並為資訊不足、低分數、服務錯誤與高風險動作設置可追蹤的處理方式。
先整理 state 所需欄位、更新時間及資料來源。只傳對話可能漏掉付款狀態或先前處理紀錄;提供過多資料則會暴露不必要的個資。只輸入判斷所需欄位,並依組織規範管理隱私與保存期限。
逐題定義答案、說明與下游規則。退款意圖只代表訊息提出要求,資格仍由原系統核對。可設「資訊不足」選項,但須確認介面如何處理。低信心、答案衝突或未測情境應轉人工,並記錄原因以修正規則和資料。
若輸出會觸發帳務、權限、客戶通知或不可逆操作,應用端須檢查權限與業務條件,並設人工確認或可回復機制。模型提供判斷,交易系統驗證是否能執行。
一項邊緣服務編排研究比較 Jev、兩種自架決策模型與三種託管大型語言模型,並測試實際 OCR 服務。在每種條件的 180 筆 OCR 請求中,Jev 都將請求送到符合限制的節點與品質層級,且在期限內完成;但辨識器在變動文字案例只正確讀出 92 筆,在重複文字案例讀出 90 筆,正確完成率分別為 51.1% 與 50%。這反映端到端結果仍受 OCR 辨識器本身限制,不能解讀為決策模型的準確率。整合者應同時檢查模型判斷與服務輸出。
Decision Models、分類器與 JSON 提示怎麼比較?
固定標籤分類器適合標籤穩定、訓練樣本充足的任務;零樣本分類可在推論時更換候選標籤;JSON 提示適合需要生成文字欄位的任務,而 Decision Models 提供了多種型態的選項判斷介面。
| 做法 | 答案如何指定 | 較適合的情境 | 整合時要留意 |
|---|---|---|---|
| 固定標籤分類器 | 訓練時決定類別 | 類別穩定、可取得標註資料 | 增加標籤可能需調整或重訓模型 |
| 零樣本分類 | 推論時提供類別名稱 | 類別會變動的文字分類 | 候選標籤措辭會影響結果 |
| LLM+JSON 提示 | 提示模型依格式產生欄位 | 欄位包含需生成的文字 | 仍需驗證格式、欄位和值域 |
| Decision Models 介面 | 以 choice、score、noul 等型態定義問題 | 多題型、選項明確的有限決策 | 各模型支援程度與校準仍須逐一測試 |
官方文章指出,分類和零樣本分類也能輸出選項分數;新介面著重以一致格式承載多題型。Transformers 文件提到,部分非專用模型會以答案標籤的下一 token 分數評估選項。試用前查所選模型卡的授權、權重使用範圍、服務價格與條款、台灣可用性及資料處理條件,並評估服務依賴、變更或終止時的替換成本;各項依模型與服務而異。
驗收看哪些指標,才能知道流程是否適用?
用代表實際流量的留出資料檢查各類別錯誤、機率校準、人工覆核比例、端到端延遲與版本退化,再決定是否進入受控試行。
建立不參與調整的測試集,依實際比例納入常見、少見與資訊不足案例。分別檢查各選項的精確率、召回率與錯誤後果;高急迫誤判為低急迫,風險高於相鄰等級錯誤。序位評分要看偏差方向和跨級錯誤,多題輸出也需測試題目間的影響。
校準可用可靠度圖、Brier score(衡量機率預測與實際結果差距的指標)或校準誤差檢查。另記錄轉人工率、人工推翻率、服務錯誤率,以及包含 API 與規則處理的端到端延遲。官方分數示例解說輸出格式,沒有提供普遍成效數字。
版本、選項說明或資料來源變動後,重跑相同測試集。小規模試行可先由人員確認模型建議,並保留原流程回退;錯誤與覆核負荷符合容忍範圍,再逐步擴大。
Dataiku 的供應商申請測試把模型判斷與 Routing block 套用政策分開,讓兩者可分別調整與測試。
導入前檢查清單:從離線測試到受控上線
先確認任務邊界與選項,再驗證資料、輸出映射、人工退場、權限與回退方式,最後以離線測試結果作為小規模試行的門檻。
- 挑任務:選擇選項可列舉、錯誤可攔截且有足夠歷史標註資料的流程。
- 定義問題:寫清楚 state 欄位、問題指示、選項說明、尺度順序和「資訊不足」處理方式。
- 接上流程:逐項核對模型答案與 API、佇列或工作流欄位,並測試未知答案、逾時及服務失敗。
- 訂驗收門檻:在留出資料上量測分類錯誤、校準、轉人工比例、延遲與版本變更退化。
- 控管執行權:對帳務、權限及客戶通知設權限檢查、人工確認或回復機制,記錄模型版本與後續處置。
- 小範圍試行:先保留原流程與回退開關,觀察真實案例後再調整選項或擴大使用。
Decision Models 將有限選擇整理成應用程式可處理的輸出。適用性取決於選項、資料完整度、風險控管和驗收代表性。條件未明前,先完善分類定義與人工退場流程。
- 適合從選項明確、結果可攔截的分類、排序與是非判斷開始。
- 機率、信心值與正確率不是同一件事,需用留出資料檢查校準。
- 模型輸出應先映射到既有規則;涉及高風險或不可逆操作時保留權限檢查與人工覆核。
常見問題
Q1:Decision Models 可以取代一般分類器嗎?
不一定。類別固定且有足夠標註資料時,傳統分類器仍可能適合;應按任務需求、模型支援、部署環境和測試結果比較。
Q2:模型輸出的機率可以直接當成正確率嗎?
不可以。機率是模型對候選答案的分布,需用代表實際流程的資料檢查校準後,才能評估能否用於門檻或分流。
Q3:低信心或資料不足時應怎麼處理?
在問題和流程中預先定義「資訊不足」、轉人工或回退路徑,並記錄觸發原因,避免系統把無法判斷的案件硬派到一般佇列。
Q4:可以讓模型直接退款或調整權限嗎?
模型分數不應單獨授權不可逆操作。應用端仍要驗證政策與權限,並採人工確認或可回復設計。
參考來源
- Hugging Face (2026). Decision Models in Hugging Face
- Hugging Face (2026-11-10 查閱). Pipelines: Decision pipeline
- Dataiku (2026). Decision Models in Dataiku: Testing Jev vs. LLM Agents
- TypeSafe AI (2026). How Jack & Jill Cut Candidate Screening Costs By 88% With Jev
- Li D, et al. (2026). Replacing Large Language Models with Jev Decision Models for Low-Latency Edge Service Orchestration. arXiv:2609.22753


