
MITRE ATT&CK v20 把直接提示注入、間接提示注入、AI 輔助資料外洩與 AI 結果污染等行為納入企業攻擊技術分類。團隊盤點時應沿著資料流檢查模型接收的內容、代理可呼叫的工具、資料存取權限、對外傳輸,以及生成結果如何被使用。
檢查模型的內容防護與拒答能力,只涵蓋輸入輸出的一部分。企業 AI 還可能讀郵件、搜文件、連資料庫或操作服務,因此要先界定資料來源、代理身分和工具權限,再追問生成結果會否觸發讀取、寫入或傳送資料。
MITRE 更新紀錄列出 ATT&CK v20 於 2026 年 10 月 13 日推出,更新涵蓋 Enterprise、Mobile 與 ICS。Enterprise 新增多項技術;本文聚焦其中四項 AI 相關分類:直接與間接提示注入、AI 輔助資料外洩、AI 結果污染。這些分類提供描述攻擊行為的共同語彙,不表示每個組織都遭遇過相關攻擊,也不代表已有偵測能力。MITRE v20 更新紀錄
提示注入從哪裡進入模型與代理?
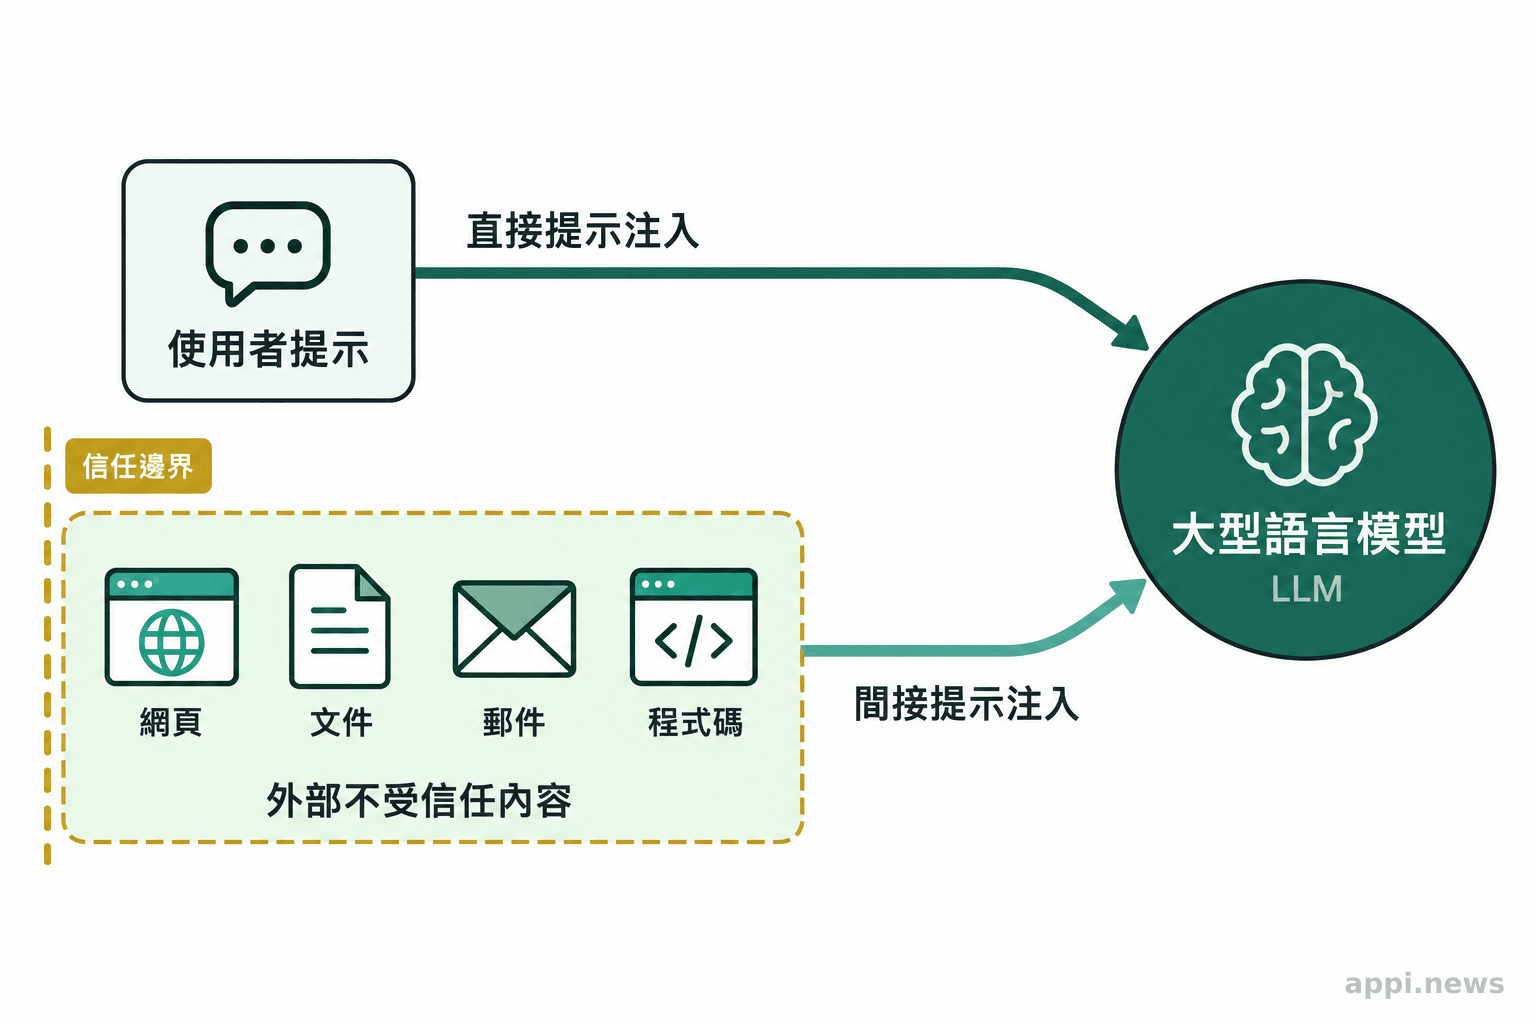
直接提示注入由使用者把惡意指令輸入模型介面;間接提示注入則把指令藏在模型可能讀取的網頁、文件、郵件或程式碼中。兩者的入口不同,後續風險都取決於模型能否把不可信內容當成指令,以及系統允許它採取哪些動作。
直接提示注入(Direct Prompt Injection)是攻擊者直接向大型語言模型輸入內容,試圖改變原有指示、繞過防護或誘發非預期操作,MITRE 列為 T1699。例子包括要求客服助理忽略限制、顯示不該提供的資料,或冒充有權限者要求代理呼叫工具。模型可能拒絕,也可能回應;實際影響取決於工具連接與授權設計。MITRE:Direct Prompt Injection
間接提示注入(Indirect Prompt Injection)是把惡意文字藏在代理會讀取的外部內容。郵件、網站、工單或程式碼可能包含「忽略前文」或呼叫工具的指令;MITRE 列為 T1698,指出代理、copilot 等 AI 系統處理這些內容時可能因此出現非預期行為。MITRE:Indirect Prompt Injection
判斷入口時看內容由誰提供、何時進入模型,以及模型是否把它當成指令。帳號和工作流程可管理使用者輸入;網頁或郵件被讀取後仍屬不可信內容。標記來源、區分資料與指令有助降低混淆,但不能取代工具端授權。
「外部內容即使被代理讀取,也不應自行授權工具或 API 執行敏感操作。」這是依 MITRE T1698 緩解措施整理的控制原則,核心在於讓授權由模型以外的政策與服務執行。
AI 代理的工具與資料權限,如何形成外洩路徑?
提示注入先影響代理的判斷,代理再可能使用原本已連接的搜尋、檔案、資料庫或網路工具。若這些工具權限過廣、服務身分共用,或敏感操作缺少獨立核准,攻擊者便可能誘導代理讀取並傳出超出任務所需的資料。
MITRE 將 AI 輔助資料外洩(AI-Enabled Exfiltration)列為 T1700。這項技術描述攻擊者利用直接或間接提示,誘導企業 AI 代理濫用既有工具連線。可能的資料路徑是:代理處理惡意提示、讀取其服務身分可存取的資料、把資料或摘要交給外部服務,最後透過網路或其他既有外傳技術離開組織邊界。提示是起點,工具權限與資料流才決定影響範圍。MITRE:AI-Enabled Exfiltration
盤點可沿四段流程進行:輸入來自使用者、網站、附件或知識庫;存取使用哪個服務帳號、能讀哪些資料;工具的搜尋、寫檔、寄信與外連是否分別授權;輸出是直接寄送、更新系統,還是交人核對。流程圖應標出資料敏感度、操作人、目的地與稽核紀錄。
代理帳號若同時能廣泛讀取、寫入與外連,一次判斷失誤便可能牽動多個系統。可按任務拆分身分與工具權限,只讀取必要資料,寫入及外傳另設核准;涉及個資、憑證或財務操作時加上人工確認。日誌保留請求來源、代理身分、工具、資料範圍、核准狀態和目的地,以便回溯。
「AI 代理被誘導外傳資料時,其他外傳技術也可能用來完成傳輸。」MITRE 在 T1700 的說明提醒,監控不能只看模型對話,還要連結資料存取、工具呼叫與目的地紀錄。
AI 結果污染為何不只是傳統搜尋排名問題?
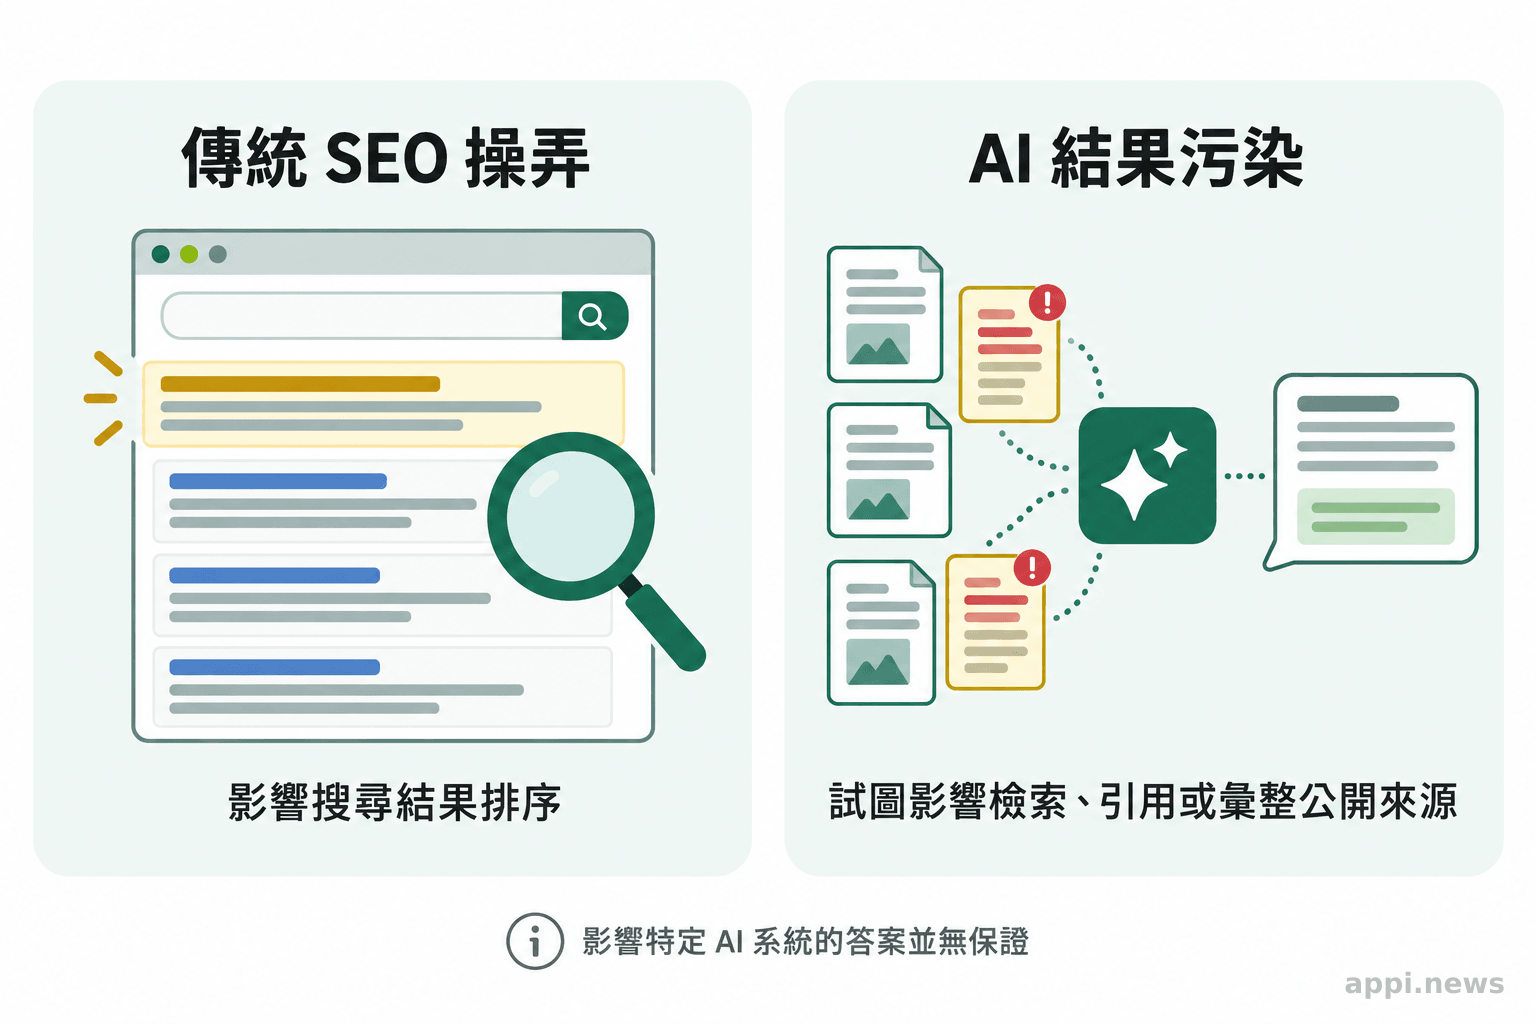
在典型搜尋情境中,傳統搜尋操弄著重影響結果排序,AI 結果污染則試圖改變公開內容,讓生成式 AI 或 AI 搜尋系統檢索、引用或推薦攻擊者控制的資訊;兩類手法可能重疊。污染可發生在組織模型與應用程式之外,內部遙測未必能辨識發布者意圖。
MITRE 將 AI 結果污染列為 T1608.007,是「Stage Capabilities」子技術,位於 Resource Development(資源開發)戰術。攻擊者可能架設誤導網站、散布捏造說法,或讓多個來源重複相同內容,試圖影響 AI 系統檢索與彙整。
受污染內容可能改變答案引用來源,或把使用者導向仿冒頁、詐騙商店與惡意下載。攻擊者不必直接控制模型提示或應用程式,但發布內容不保證會影響特定系統或答案。MITRE:AI Result Poisoning
這個分類的可觀測性有明確限制。MITRE 的偵測策略指出,防守方難以只靠目標企業遙測,可靠區分惡意操弄公開內容、一般發布、SEO 活動、錯誤資訊或合法協作發布。因此,組織可檢查自家 AI 搜尋或檢索系統是否顯示來源、來源是否可信、重要答案是否經人工或權威資料覆核,卻未必能由內部紀錄判定外部發布者的動機。防守重點是降低錯誤內容進入決策的機會,並建立遇到可疑答案時的查證路徑。
台灣團隊如何把 ATT&CK v20 轉成盤點與測試?
先選一項實際 AI 工作流程,逐段記下輸入來源、代理服務身分、工具、資料讀寫範圍、網路目的地與輸出使用者,再依提示注入、資料外洩及結果污染建立各自的測試情境。控制是否有效,要由授權環境中的測試證據判斷。
ATT&CK 可協助團隊把威脅映射到工作流程,但不是完整控制清單。下表將四種行為對應到常見系統位置,供模型、平台、資安與資料治理人員分工盤點。
| 行為分類 | 可能入口或位置 | 盤點問題 | 可驗證的控制方向 |
|---|---|---|---|
| 直接提示注入(T1699) | 使用者輸入 | 哪些帳號能要求模型採取動作?模型能否改變授權身分? | 工具端獨立授權;敏感操作要求核准 |
| 間接提示注入(T1698) | 網頁、郵件、文件、工單、程式碼 | 外部內容是否與系統指令分開標示?代理可否因讀取內容而執行動作? | 隔離不可信內容;限制代理可讀資料與外連範圍 |
| AI 輔助資料外洩(T1700) | 代理工具與資料流 | 代理能讀什麼、傳到哪裡?是否記錄完整工具呼叫? | 最小權限;限制目的地;串接存取、核准與傳輸日誌 |
| AI 結果污染(T1608.007) | 公開內容與外部檢索 | 答案是否顯示來源?高影響資訊如何覆核? | 比對權威來源;標示不確定性;建立人工覆核程序 |
測試限於獲授權的模型、資料與隔離環境,並使用合成或測試資料。直接注入測試觀察使用者能否誘使代理越權;間接注入則將模擬指令放入測試文件,確認代理不會照做。再檢查工具端是否依帳號權限和核准規則拒絕錯誤操作。測試紀錄應指出哪些控制生效、哪些仍有缺口。
常見根因有三項:外部資料被當成可信指令、代理權限超出任務所需,以及工具授權依賴模型判斷。測試時分別確認資料與指令是否隔離、低權限身分能讀取哪些資料,以及工具端是否對敏感操作獨立核准。
若測試失敗,記錄未生效的信任邊界或責任環節,區分問題來自輸入處理、身分設定或服務整合,再安排負責人修正與複測。
這項盤點需由模型、資安、系統、資料治理與流程負責人共同完成,並把權責和整合成本納入計畫,才會反映實際操作情境。
- 選定一項正在使用的 AI 助理或代理,畫出輸入、資料、工具、網路與輸出路徑,標明每段的負責人。
- 對照 T1699、T1698、T1700 與 T1608.007,找出尚未盤點的信任邊界和資料流。
- 在授權的隔離環境,以合成資料測試直接與間接提示注入,並驗證越權呼叫、外傳與高影響輸出是否被阻止或送交覆核。
- 保存測試條件、日誌、結果與未解決風險,安排控制責任人和再次檢查的時點。
ATT&CK 映射能回答什麼,仍有哪些邊界?
不能。ATT&CK 說明的是攻擊者可能採取的行為,分類收錄不等於事件已在每個組織發生,也不代表組織已建好偵測、部署控制或驗證防禦效果。適用程度仍須看模型、工具、資料來源、權限和部署方式。
ATT&CK 提供共同分類,協助討論威脅模型、映射控制與找出待測流程;控制適用與否仍取決於架構、權限、資料流和測試紀錄。AI 結果污染涉及公開內容與外部檢索,組織可查核來源、覆核輸出,但未必能從內部端點辨識發布者意圖。
團隊可先選一條實際流程,列出模型讀取的資料、代理身分、可用工具和輸出用途,再指定核准與追蹤責任。模型、工具、資料來源或使用者權限變更時,重新檢查測試假設。
- 直接提示注入從使用者輸入進入模型,間接提示注入藏在代理讀取的外部內容,兩者都要檢查工具端授權。
- AI 輔助資料外洩的影響由資料可見範圍、代理權限與對外傳輸共同決定;AI 結果污染則主要發生於公開內容與外部檢索層。
- ATT&CK v20 提供行為分類與盤點語彙,控制是否有效仍須在授權環境用測試與紀錄驗證。
常見問題
Q1: MITRE ATT&CK v20 新增哪些 AI 相關攻擊技術?
Enterprise 的相關分類包括直接提示注入(T1699)、間接提示注入(T1698)、AI 輔助資料外洩(T1700)與 AI 結果污染(T1608.007)。v20 還新增其他 AI 相關技術,完整清單可查看 MITRE 更新紀錄。
Q2: 提示注入一定會造成資料外洩嗎?
不一定。提示注入可能誘發非預期行為,但是否讀取或傳出資料,取決於代理連接的工具、服務身分、資料權限、網路出口與操作核准。
Q3: AI 結果污染可以由企業內部日誌直接偵測嗎?
未必。它可能發生在組織控制範圍外的公開內容與檢索層。MITRE 指出,單靠目標企業遙測難以可靠判斷公開內容是否為了操弄 AI 而發布;企業可加強來源顯示、權威資料比對與高影響輸出覆核。
Q4: 團隊應該如何安全測試 AI 代理?
只在取得授權的系統、資料與隔離環境測試,使用合成或非敏感資料。測試目標應涵蓋權限拒絕、敏感操作核准、外連限制及事件紀錄,避免以真實個資或機密資料驗證外洩情境。
參考來源
- MITRE. (2026). Updates | MITRE ATT&CK®. *MITRE ATT&CK
- MITRE. (2026). Direct Prompt Injection, Technique T1699. *MITRE ATT&CK
- MITRE. (2026). Indirect Prompt Injection, Technique T1698. *MITRE ATT&CK
- MITRE. (2026). AI-Enabled Exfiltration, Technique T1700. *MITRE ATT&CK
- MITRE. (2026). Stage Capabilities: AI Result Poisoning, Sub-technique T1608.007. *MITRE ATT&CK


