
OpenAI 在對抗式蒸餾防護公告中表示,內部測試要求攻擊模型擷取先前請求的受保護推理,平均成功率從 GPT-6 Astra 原防護下的 54.0%,降至 GPT-6.2 Astra 更新防護後的 0.2%。這是廠商自評,結果受模型版本、攻擊者及測試設定限制,不能視為所有部署環境的防護成效。來源:OpenAI 防護公告
對使用 API(應用程式介面)建立服務的團隊,問題隨之而來:供應商加強模型防護後,自己的對話紀錄、工具呼叫與帳號監測,還有哪些環節需要補上?
0.2% 測的是哪一種攻擊?
它代表特定內部自適應黑箱測試中,擷取先前請求受保護推理的平均成功率,並非產品整體遭入侵的機率。
黑箱測試讓測試者以外部使用者可見的介面進行攻擊;自適應則表示攻擊方式會隨系統回應調整。受保護推理指模型形成答案時的內部中間步驟,也稱思維鏈,與使用者看到的解釋摘要有別。
把兩個公告數字相減,差距是 53.8 個百分點。這項比較同時更換模型版本與防護措施,不能據此分配各項措施的貢獻,也不能替企業自建服務算出同樣的改善幅度。
台灣團隊若透過轉接服務串連模型,應要求供應商說明測試涵蓋的端點、資料類型及版本,寫進採購文件再比較安全數據。
需要區分訓練技術與未授權行為時,可先釐清模型蒸餾如何讓另一模型學習能力,再檢查資料取得及使用方式。
為什麼能力學得走,防護卻可能留下?
模型蒸餾是讓學生模型從教師模型產生的資料學習;學習能力所需的資料,不必然包含原服務的存取限制與安全控制。
Hinton 等人 2015 年的研究以蒸餾把多模型知識移入單一模型,改善商用系統聲學模型。蒸餾有部署用途,不能只憑名稱認定為攻擊。來源:蒸餾研究
OpenAI 另做了一項內部資安蒸餾實驗:從相同預訓練學生模型出發,比較完整推理軌跡與摘要資料的訓練效果。監督式微調後,完整軌跡組整體表現較好;追加強化學習後,優勢隨推論預算而變,並非所有條件都領先。來源:OpenAI 實驗說明
這帶出根因:教師服務的安全可能分散在模型、分類器、帳號權限及工具執行規則。學生取得任務資料時,這些服務層控制未必一起移轉。因此,資料盤點應區分最終回答、推理摘要、內部推理與工具互動,逐項確認誰能取得、能否匯出及是否准許訓練。
單次請求的防護,分別守住什麼?
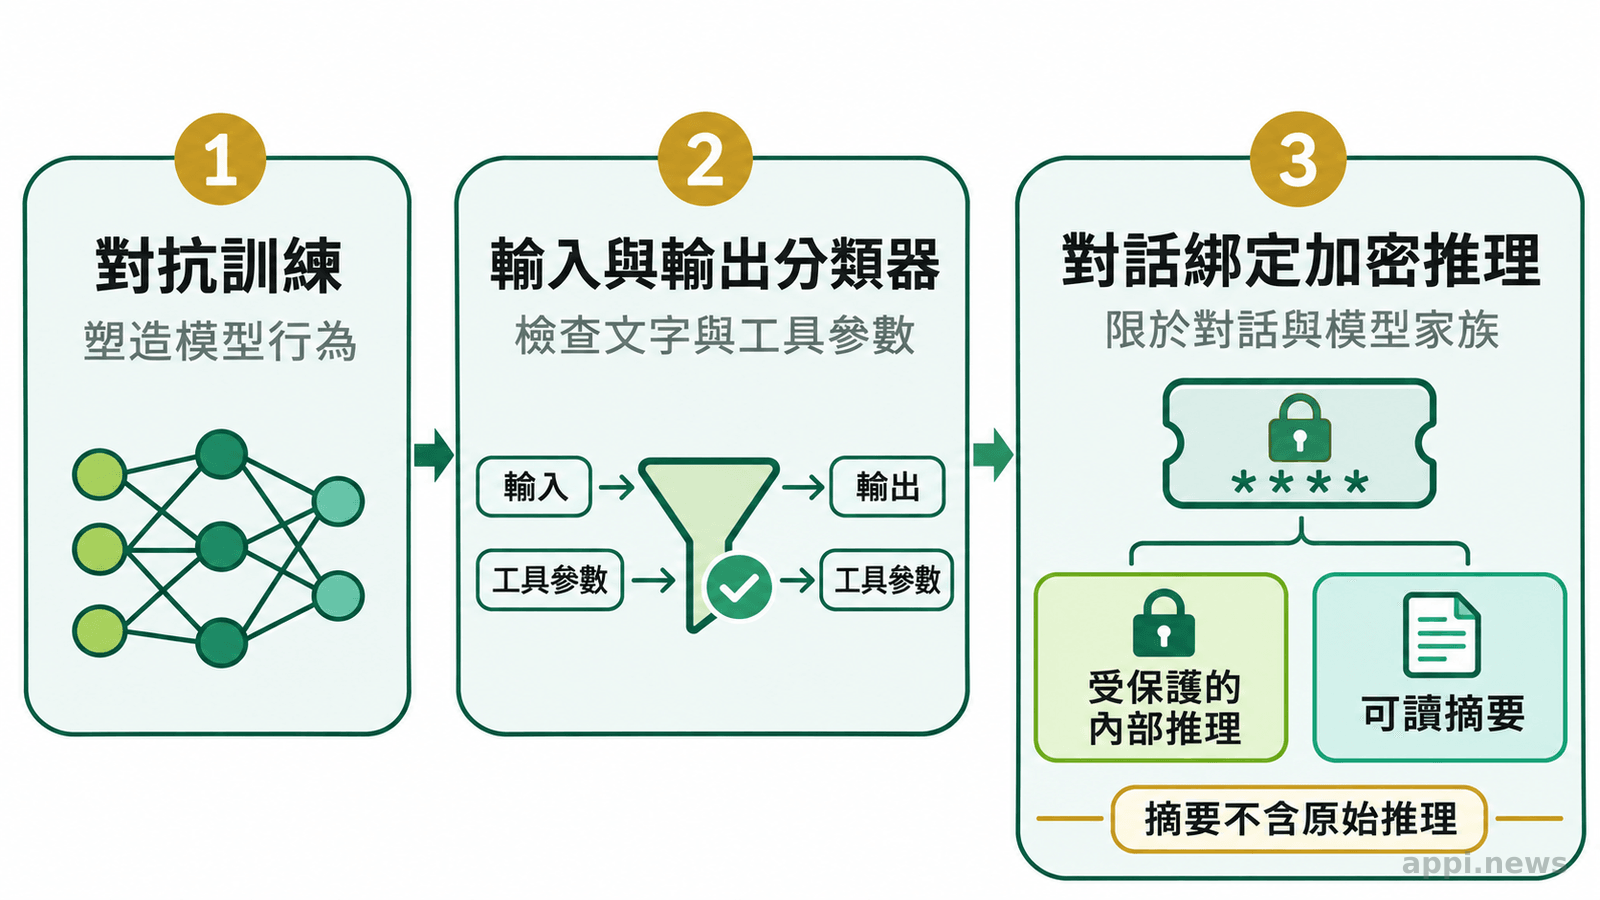
OpenAI 結合對抗訓練、輸入與輸出分類器,以及 API 的推理重用限制,處理不同位置的擷取風險。
對抗訓練讓模型辨識擷取意圖;分類器判斷輸入或輸出是否符合風險條件。兩者介入時點不同,驗收應分別檢查。
OpenAI 的技術說明指出,輸出分類器的檢查範圍包括助理訊息與工具呼叫參數,並涵蓋串流及非串流回應。來源:防護公告
從系統設計推論,只檢查聊天視窗會留下工具路徑的盲區。工具呼叫參數是模型交給外部程式的資料;即使最終文字沒有洩漏,參數仍可能把內容送到另一個服務。接收端應只取得執行任務所需欄位。
| 防護位置 | OpenAI 公布的做法 | 產品端驗收問題 |
|---|---|---|
| 模型行為 | 對抗訓練 | 正常解釋請求是否被誤擋? |
| 輸入與輸出 | 分類器檢查 | 工具參數和串流是否納入? |
| API 狀態 | 限制推理跨互動與模型重用 | 歷史改寫和模型切換如何處理? |
對話歷史改寫,也會影響成本
OpenAI 文件說明,新版前沿模型會捨棄對話前綴改動之後的推理項目。前綴就是該推理之前的歷史,修改舊訊息或縮短舊工具結果都可能改動它,可能導致重新推理、增加延遲與用量。來源:對話前綴文件
API 防護也涉及使用者、工作區、組織與模型家族邊界。加密推理項目可延續狀態,API 不會因此提供原始推理文字;切換模型家族時,不相容的推理會被排除。來源:推理模型文件、防護公告
團隊可測試保留歷史、改寫歷史及切換模型,量測完成率、延遲與用量,兼顧答案品質與服務表現。
為何還要調查跨帳號的協同行動?
分散帳號可把大量擷取活動拆成個別請求,調查需要結合請求模式與帳號關聯,才能辨識整體行動。
OpenAI 在 2026 年 9 月公布的事件中表示,7 月 24、25 日曾觀察到超過 4,000 名使用者發出約 16,000 次相關擷取請求,後續辨識出超過 15,000 名使用者的關聯活動。這些是嘗試次數,不能當成成功外洩筆數。來源:事件公告
該公司表示,處置包含限制帳號、強化技術控制及與第三方服務協作。單看封鎖數量,仍無法回答攻擊者取得多少有價值資料,或事件從出現到處置花了多久。
對產品團隊而言,可追蹤「發現異常到完成調查」及「確認事件到控制影響」的時間,並指定負責人。多帳號、高流量也可能來自合法批次作業,需搭配用途與內容複核。相關流程可與AI 代理越權的分層監測一起規劃,避免告警發出後無人處理。
產品團隊如何開始檢查?
先畫出資料流與控制權,再測試外洩路徑、確認調查責任,最後把已知問題納入更新前的回歸測試。
美國國家標準暨技術研究院(NIST)的 AI 風險管理框架建議,組織應記錄風險管理的角色、責任與溝通管道,讓相關團隊明確知悉。來源:AI RMF 1.0
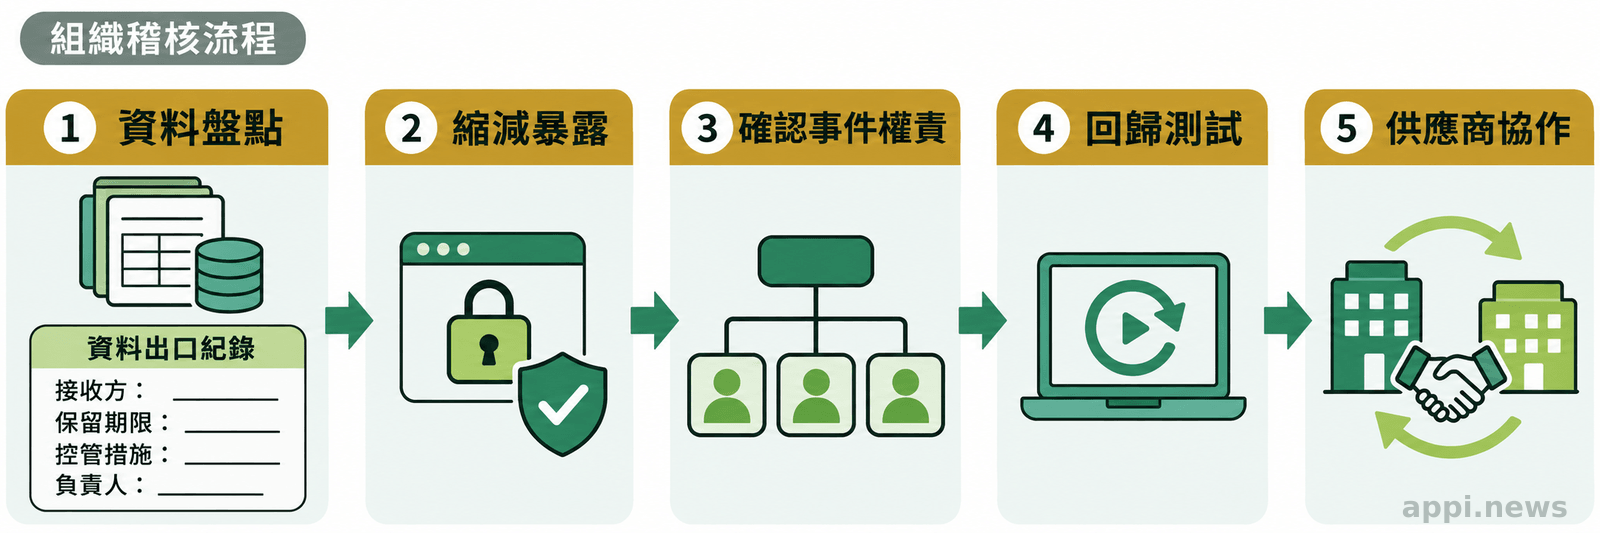
團隊可按自己的權限與資料流程,採用下列檢查步驟:
- 盤點資料:列出回答、摘要、推理項目與工具參數,標示接收者、保存位置及期限。
- 縮減暴露:移除工具不需要的欄位,限制匯出權限,檢查串流內容送出前的控制。
- 確認調查權責:寫明誰查異常帳號、誰聯絡模型商、誰能暫停服務,以及誤判的復原程序。
- 保存測試案例:在隱私及授權允許範圍內,將成功擷取案例去識別化,重播測試並加入會調整策略的新攻擊。
- 核對合作條件:確認轉接服務的防護範圍、通報窗口與版本變更流程,估算監測、人工作業及延遲成本。
驗收時可挑選「助理查詢訂單後呼叫外部工具」這類流程,用合成資料代替真實客戶紀錄。先寫下工具應收到的訂單編號與操作指令,再逐項比對實際參數。若混入無關的歷史訊息,就能把問題定位到欄位組裝或權限設定,交由對應人員修正。
同一流程還可分別測試串流與非串流,記錄檢查發生在資料送出之前或之後,以及攔截後工具是否仍被執行。驗收紀錄應列出預期行為、實際結果與證據位置;聊天畫面顯示拒絕時,也要確認外部接收端確實沒有取得受限制內容。
對話狀態則可用相同任務做三組比較:完整保留歷史、修改一筆舊工具結果,以及切換模型。固定其餘條件,觀察任務是否完成、哪些資料被排除、延遲與用量如何變化。若產品需要壓縮歷史,應將這個需求納入測試,評估節省輸入資料與重做推理之間的取捨。
事件演練可從一張模擬異常告警開始,請值班人員依既定權限查詢紀錄、聯絡供應商並提出處置。若產品方只能看到自己的帳號,就應明列跨帳號關聯調查由誰負責,以及需要提供哪些識別資訊。通報缺少必要欄位、窗口無法回覆,都可成為流程改善項目。
回歸測試也要保留正常案例,例如合法批次查詢與一般解釋請求,避免只追求攔截率而增加誤擋。每次更換模型、工具定義或轉接服務後,重跑同一組案例並記錄版本。團隊可先訂出可接受的失敗條件與復原方式,再依結果決定是否擴大使用範圍。
先挑一條重要產品流程,替紀錄、工具與匯出介面填上檢查方式和負責人,空白處就是下一輪改善的起點。
- 比較安全數據前,先核對攻擊目標、模型版本及部署條件。
- 檢查範圍涵蓋工具參數、對話狀態及跨帳號行為。
- 將事件調查結果轉成可重播的測試,並指定處置責任。
常見問題
Q1:模型蒸餾和模型竊取相同嗎?
蒸餾是一種學習技術。是否涉及未授權擷取,需另看資料取得、使用許可與服務條件。
Q2:推理摘要等於完整思維鏈嗎?
兩者不同。摘要是提供給使用者的說明,完整思維鏈是模型內部推理;資料盤點應分開標示。
Q3:只在提示詞禁止洩漏,足夠嗎?
提示詞可表達規則,仍需搭配資料出口控制、測試及事件處置,才能涵蓋工具和跨請求流程。
參考來源
- OpenAI(2026)。Combatting adversarial distillation。OpenAI
- Hinton G, et al.(2015)。Distilling the Knowledge in a Neural Network。arXiv,1503.02531(預印本)
- OpenAI(2026)。Keep the prefix unchanged。OpenAI API 文件
- OpenAI(2026)。Reasoning models。OpenAI API 文件
- OpenAI(2026)。Disrupting a coordinated model-distillation campaign。OpenAI
- National Institute of Standards and Technology(2023)。Artificial Intelligence Risk Management Framework (AI RMF 1.0)。NIST AI 100-1


