企業把AI接進客服、審核或模型路由時,真正要問的是它能否穩定回傳程式可接手的判斷,以及遇到不確定案例時能否交給人處理。Jev近期公開後,提供了另一種方向:先限定答案空間,再回傳選項、分數、機率或信心資訊。Jev定位在流程決策元件,ChatGPT與Claude則能處理長文、開放式推理、對話與生成內容。
一、Jev是什麼?從生成文字改成直接回傳決策
Jev把問題轉成預先定義的決策型輸出,讓程式直接讀取結果;大型語言模型則以生成文字為主要介面。這會改變應用程式的解析、驗證與錯誤處理方式。
TypeSafe將Jev定位為System One模型。它接收state狀態資料,再搭配開發者定義的questions,回傳有型別的判斷,可用於分類、路由、評分與流程分支。
限定選項、分數與機率如何運作
三種原生問題的分工很清楚:Choice從有限選項中選一個;Score依低到高的規準評分;Noul判斷單一命題為真的機率,回傳0到1的數值。Choice與Score另有機率或信心資訊。
程式可以用結果接續流程,例如Choice選到technical就轉給技術客服,Score超過門檻就建立複核任務,Noul高於門檻就暫停自動動作。門檻應以企業標註資料與錯誤成本校準。
型別受限不等於判斷正確
Choice只允許回傳既定選項,能降低欄位型別錯誤;但模型仍可能把退款申請分到錯誤類別。型別限制處理資料形狀,不會自動回答結果是否符合業務事實。
大型語言模型的JSON Schema也有相同界線:格式通過驗證,不代表內容符合企業規則。兩類工具都要保留真實案例測試、錯誤樣本、版本紀錄與人工抽查。
「typed probabilistic decisions」是TypeSafe對Jev的核心定位,意思是把非結構化狀態轉成帶型別的機率決策。— TypeSafe AI 官方發表文章
二、Jev與ChatGPT、Claude的核心差異
固定答案空間、需要程式分支的任務,可優先評估Jev;需要理解脈絡、產生文字或多步驟推理的任務,仍應評估ChatGPT或Claude。任務邊界比品牌名稱更重要。
穩定性與格式可驗證性
大型語言模型即使使用函式呼叫或JSON Schema,仍需解析與驗證。OpenAI API文件提醒,模型輸出本質上具有變動性,版本或提示改變後,同一輸入可能出現不同結果;Claude也需要語意驗證與失敗回退。
Jev把答案形狀前移到問題設計階段,能降低自由文字解析負擔;前提是選項互不重疊,並設計other、人工覆核或拒絕路徑。
生成能力、上下文理解與開放式任務
Jev不適合寫文章、產生程式碼、完成長篇摘要或取代對話模型。這些任務的答案沒有辦法在一開始完整列出,ChatGPT與Claude較能處理長脈絡、工具、檔案與多輪生成。
LLM也能做分類與路由,但應用程式需自行承擔提示、格式驗證、版本評測與失敗回退。Jev換取較明確的程式介面,代價是要先把業務判斷拆成可描述的問題。
三、企業比較AI工具時要看的5個面向
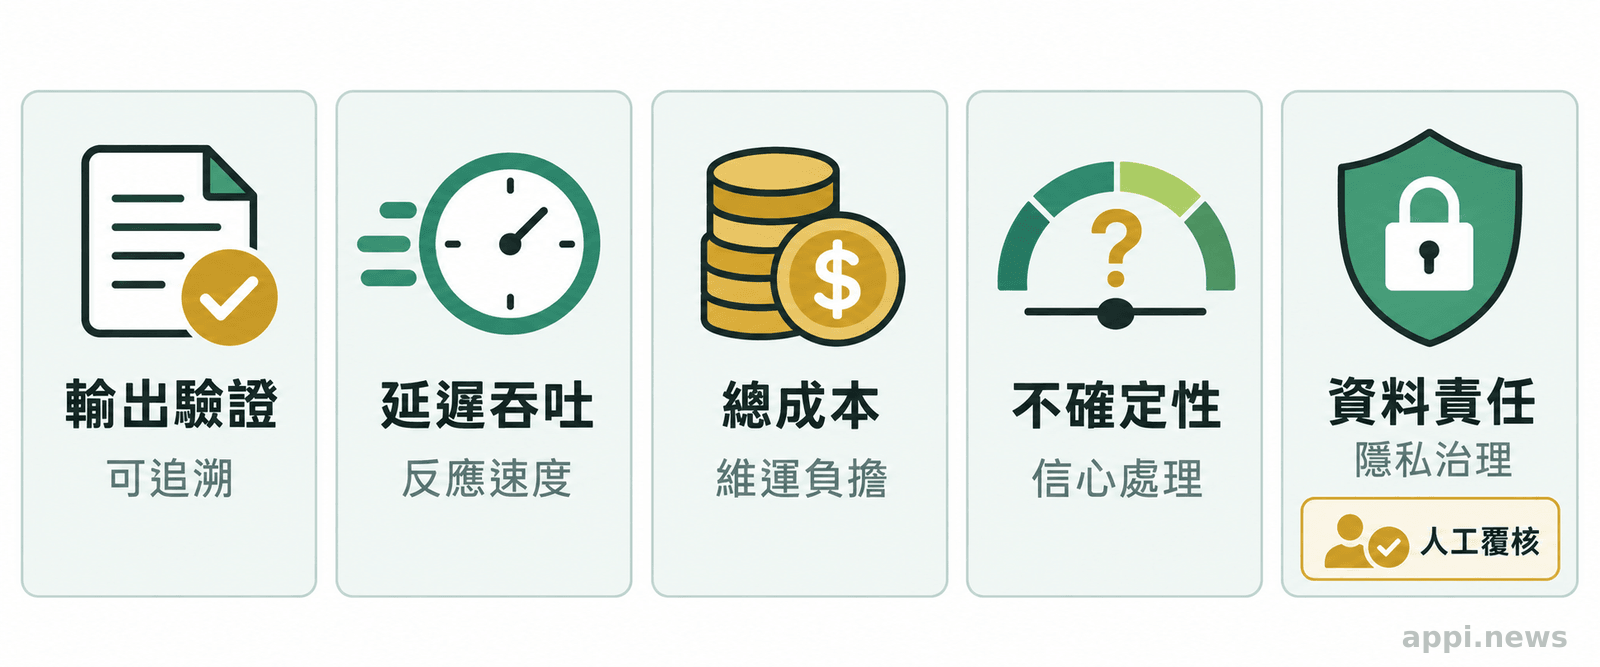
應同時比較輸出正確性、延遲、總成本、治理責任與整合條件,不能只看一次示範的速度或模型分數。比較時要固定資料與測試條件。
| 面向 | Jev可先觀察 | ChatGPT/Claude可先觀察 | 必須補測 |
|---|---|---|---|
| 輸出驗證 | 有限選項、評分級距、命題機率 | 長文、摘要、理由、程式碼 | 選項是否重疊,內容是否符合規則 |
| 延遲吞吐 | 即時分類、路由、批次判斷 | 長脈絡、工具呼叫、多輪推理 | 網路距離、併發、重試與尖峰流量 |
| 總成本 | 固定分支與短輸出 | 理解、說明與生成集中處理 | Token、監控、維運、標註與人工成本 |
| 不確定性 | Choice/Score信心、Noul機率 | 自行設計信心與回退 | 門檻是否經標註資料校準 |
| 資料責任 | 送出必要狀態資料 | 管理提示、檔案、工具與對話 | 個資、日誌、權限與供應商依賴 |
延遲、成本與部署條件
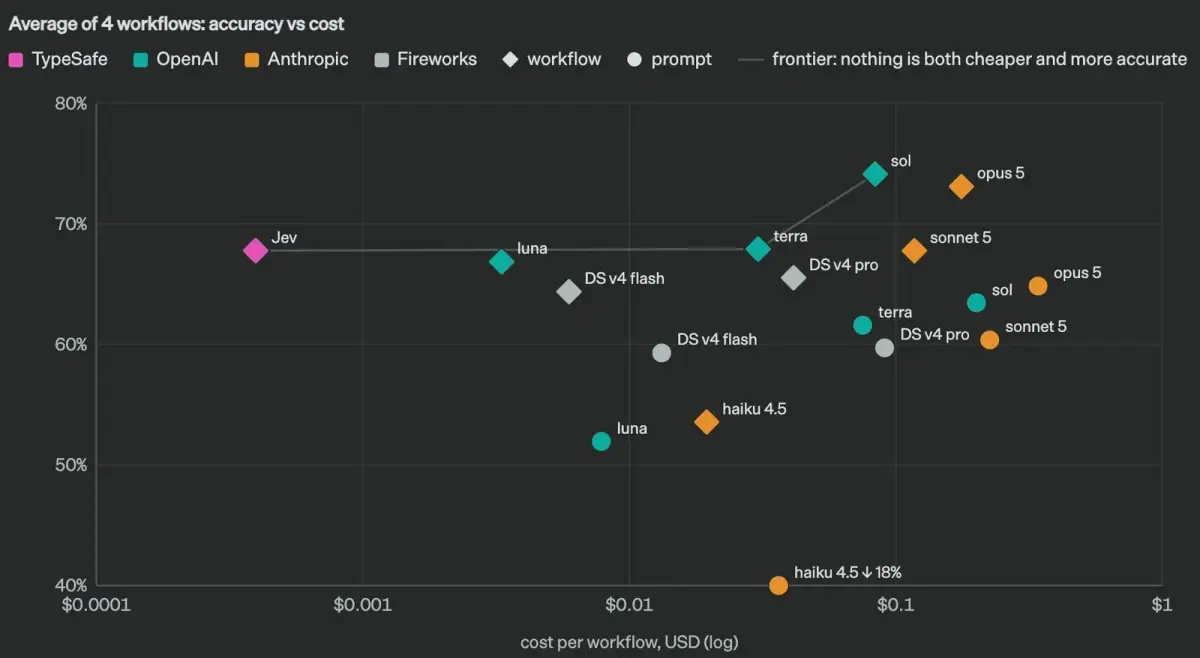
TypeSafe公開Jev端到端回應時間約70至500毫秒,也公布過與部分大型語言模型相比的速度與成本差距。這些是業者在特定工作流程下的結果,不能直接推論台灣企業的實際表現。資料長度、網路區域、併發、重試、日誌與人工覆核,都會改變端到端成本。
測試時應把資料整理、傳輸、請求、驗證、寫入與通知都算進去。短訊息且類別固定時,Jev可能較容易預估成本;長文件與理由生成則可能更適合LLM。最後要以同一批資料量測總成本。
信心、資料隱私與責任邊界
信心或機率讓系統在低於門檻時轉人工。退款、金融風險、資安告警、醫療行政分流與自動封鎖等高代價流程,應保留人工核准、審計紀錄與回滾機制;信心數字不能直接當成授權。
台灣企業還要確認資料能否送出、保存多久、誰能存取、日誌是否含個人資料,以及供應商如何處理資料。建議把決策介面和特定模型分開,保留替換模型、規則引擎或人工路徑。
四、哪些任務適合用Jev?哪些仍需要大型語言模型?
Jev適合答案有限、流程分支清楚、錯誤可以定義且需要快速回傳的任務;長文生成、複雜開放式推理與新內容產生,較適合大型語言模型。兩者可在同一流程中分工。
分類、路由、評分與流程分支
候選情境包括客服分類、案件分派、模型路由、內容風險分級、檢索評分、政策檢查與工作完成度判斷。共同點是能列出選項或評分規準,也能說明結果接下來的動作。
例如,LLM先把長客服訊息整理成狀態,Jev再判斷部門、緊急程度與是否需要人工。Choice信心不足就回到人工,Score風險升高就要求更多證據,Noul判斷政策條件成立就暫停動作。
文章撰寫、程式生成與複雜推理
文章、客服回覆草稿、程式碼、研究摘要與跨文件推理,需要模型處理開放式語意並產生新的字串。Jev可協助判斷是否覆核、選擇下一個模型或檢查規範,但生成內容仍需適合的LLM、測試、引用查核與人工責任。
五、台灣企業導入Jev的實作檢查表
先確認決策任務、資料、錯誤代價與責任人,再比較Jev、ChatGPT與Claude的實測結果;不要從模型名稱直接推導導入結論。
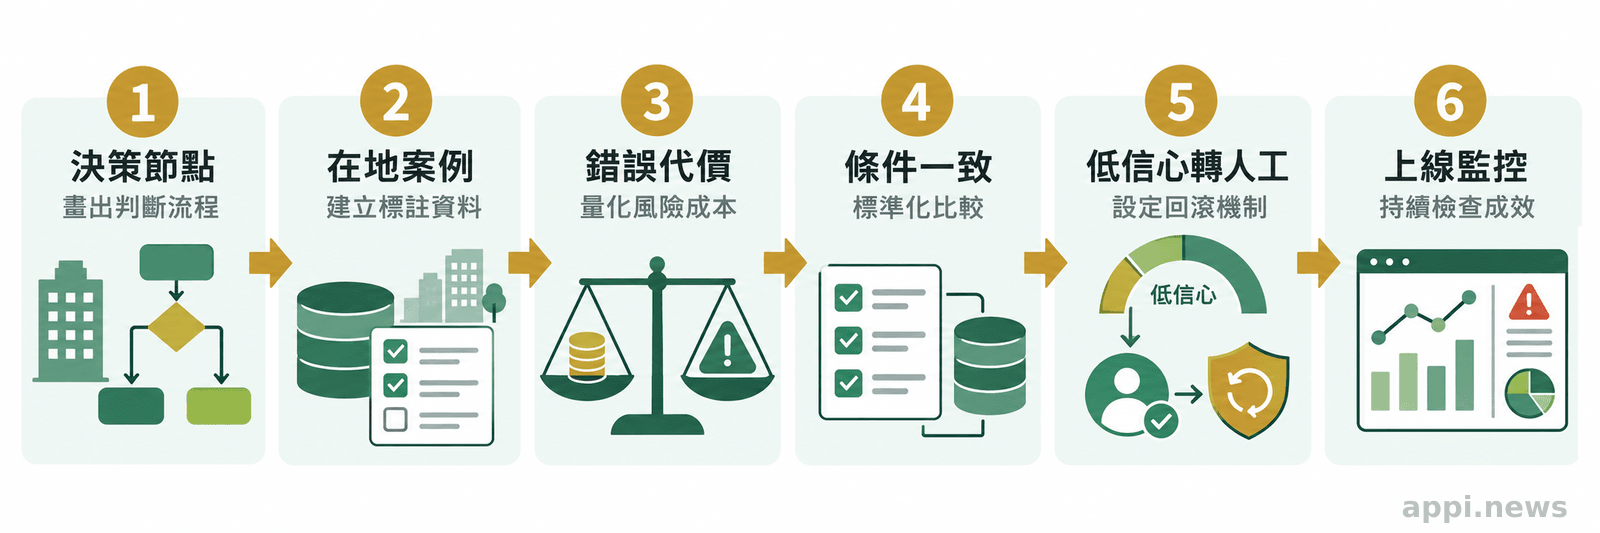
- 畫出流程節點:標出分類、路由、評分或真假判斷的位置,以及每個結果觸發的動作。
- 建立標註資料:蒐集代表台灣企業語言、業務例外與尖峰情境的案例,建立預期答案。
- 量化錯誤成本:分開計算誤分流、誤拒絕、錯誤升級、資料外洩與延遲成本。
- 固定比較條件:固定輸入、問題描述、輸出格式、模型版本、網路位置、重試與計費方式。
- 設定低信心路徑:定義轉人工、轉LLM或要求補資料的條件,高代價動作保留核准與回滾。
- 建立上線監控:追蹤資料分布、信心與正確率、人工覆核比例、成本與存取紀錄。
這份檢查表讓企業知道每個模型負責哪一段、哪些結果必須停下來。Jev可降低解析負擔,但整體安全仍取決於資料治理、權限、測試和責任分工。
六、結論:依任務分工,建立可回退的AI流程
固定選項、分數、機率或流程路由的任務,值得評估Jev;長脈絡理解與生成內容,ChatGPT或Claude更合適。高風險流程則應採用Jev、LLM與人工覆核的混合架構。
相較於只討論AI代理一次成功率,Jev帶來的新觀察是可靠度可以先從介面設計處理。把答案空間、門檻和回退路徑寫進流程,仍須用真實資料驗證。
台灣企業可以從低風險分類或路由節點開始,測量準確率、延遲、成本、人工覆核率與資料風險。需要長文理解時讓LLM整理脈絡,再由Jev作為閘門;信心不足或動作不可逆時回到人工。
- Jev的核心價值是把AI判斷限制在Choice、Score與Noul等可接入程式的輸出形狀。
- 型別正確只代表格式與範圍受到控制,仍須用標註資料驗證語意正確性。
- 業者公布的延遲、成本與倍數比較,必須連同測試條件閱讀,不能推論所有企業場景。
- 低信心、高代價或不可逆的動作,應轉人工或大型語言模型覆核,並保留回滾與審計紀錄。
「Model outputs are by their nature variable.」— OpenAI API 文件
常見問題
Q1: Jev是大型語言模型嗎?
Jev由TypeSafe定位為System One模型,公開介面定義問題與答案形狀,再取得選項、分數或命題機率。
Q2: Jev可以完全取代ChatGPT或Claude嗎?
不適合這樣理解。Jev適合固定答案空間的分類、路由與評分;ChatGPT與Claude較能處理長文、開放式生成、程式碼與複雜脈絡。可讓LLM整理資料、Jev負責流程判斷。
Q3: Jev回傳信心高,就可以直接執行嗎?
不能只看信心數字。門檻要用企業標註資料校準,還要考慮錯誤代價、資料缺漏和動作是否可逆。退款、金融、資安或自動拒絕流程,應保留人工核准與回滾機制。
Q4: 台灣企業導入前最該測什麼?
至少測同一批真實資料的正確率、延遲、總成本、人工覆核比例、錯誤類型與資料風險。測試應固定模型版本、輸入、問題描述、輸出格式、網路位置與計費方式。
Q5: Jev的Score可以直接當百分比嗎?
不可以。Score是依照有順序的評分級距計算出的結果,範圍取決於級距數量;Noul才是0到1的命題機率。兩者意義不同,門檻與後續規則也要分開設計。