
很多人第一個會先想到模型分數和每項任務的價格,但測試中的代理任務是否等同自己的工作流程,才是導入前要先回答的問題。DeepSeek 在 2026 年 10 月 17 日發布 V4.1 Flash 1017 更新,官方表示新版本在多項基準測試表現提升、執行時間縮短且輸出更精簡;媒體報導則稱它在特定程式代理測試勝過較大型模型,單任務成本也較低。這些結果能提供試用線索,不能直接推算每個團隊的效能與帳單。
評估時要拆開三件事:模型在什麼測試中進步、自己的任務失敗會造成什麼代價,以及執行與驗收的總成本。符合範圍明確、能檢查、容易復原等條件的工作,較適合作為第一批試用項目。
一、DeepSeek V4.1 Flash 1017 更新了什麼?
它是 V4.1 Flash 的小幅更新版本,官方稱推理、程式、代理與視覺基準有所提升,並縮短任務時間及輸出長度。這些是發布方的說明,需與獨立實測及實際工作結果分開看。
DeepSeek 官方公告指出,新模型已在網站、App 與 API 上線,並公布於 Hugging Face、ModelScope。模型卡標示權重採 MIT 授權,總參數量為 763B;「Flash」名稱本身不能代表它是小型、低硬體需求的模型。模型卡也提供 vLLM、SGLang 等推論部署方式,使用者仍須按權重精度、量化方式、上下文長度與服務吞吐量規劃硬體。
API 端則以 deepseek-flash 作為模型名稱,官方價格頁將它對應至 V4.1 Flash 1017。模型版本、名稱與費率日後可能調整,部署時應保存實際呼叫的模型 ID、時間與費用紀錄,不能只依賴舊文章或程式範例。
二、代理任務分數代表什麼能力?
基準測試只反映特定任務集、代理框架、工具與提示設定下的結果。它可用來比較測試條件相近的模型,不能直接代表模型在任何程式庫或企業流程都會有相同成功率。
代理(agent)是能依目標分步規劃、呼叫工具並根據結果繼續執行的模型或系統。程式代理可能讀取專案檔案、修改程式、執行測試,再依錯誤訊息修正。評測除了模型本身,也受到工具權限、執行環境、提示詞、重試上限與測試評分方式影響。
DeepSeek 模型卡列出多種測試結果。例如 DeepSWE v1.1 得分 77.0,原版 V4.1 Flash 為 74.2;在該表列出的競品中,這個分數高於 GPT-5.6 Sol 與 Opus 5。其他測試排序不同,例如 Terminal-Bench 4.0 上 Opus 5 得分較高。
Terminal-Bench 使用 Claude Code harness,DeepSWE v1.1 使用 Mini-SWE-V2 harness,兩種分數不能混成同一種能力排名。
The Decoder 報導引述 DeepSWE 成本圖表,指出 77% 的分數對應平均每項任務不到 0.20 美元,低設定約 0.10 美元、得分超過 72%;前一版則約 0.50 美元。這是報導對廠商測試圖表的整理,不代表獨立機構已用相同任務與資源重做測試。該報導也提醒,當時尚無獨立基準結果,開發者對程式品質的實際感受可能與分數不同。
「Independent benchmarks haven’t come out yet, and benchmarks only tell half the story anyway.」The Decoder 對當時公開證據的提醒,中文意為:獨立基準尚未公布,基準測試也只呈現部分情況。
三、分數領先對手,為什麼不等於每種工作都能接手?
不能。模型得分不是整條流程的交付品質;成功率、重試、人工修正、流程耗時和錯誤後果都要一起評估。
先問任務錯誤會造成什麼影響。整理公開文件、產生測試草稿或在隔離副本中提出程式修改,通常容易檢查,也能復原,適合拿來觀察模型的工具使用和修正能力。直接部署程式、修改正式資料、執行付款或操作高權限帳號,失敗後果較大,不宜只因基準分數好看就交由代理自行完成。
「小模型」也不能只看名稱。模型卡列出的 763B 是總參數量;總參數與每次推論實際啟用的參數是不同概念,但目前引用的模型卡未提供本模型的啟用參數數據,因此不據此推定記憶體需求或部署成本。若要在本地推論,還要確認模型權重能否以目標量化格式運作、硬體能否負擔上下文與併發請求,以及推論服務的延遲和穩定性。開放權重降低了取得模型檔案的門檻,但不等於免除 GPU、能源、儲存、部署工程與維運成本。
四、哪些代理工作適合先試跑?
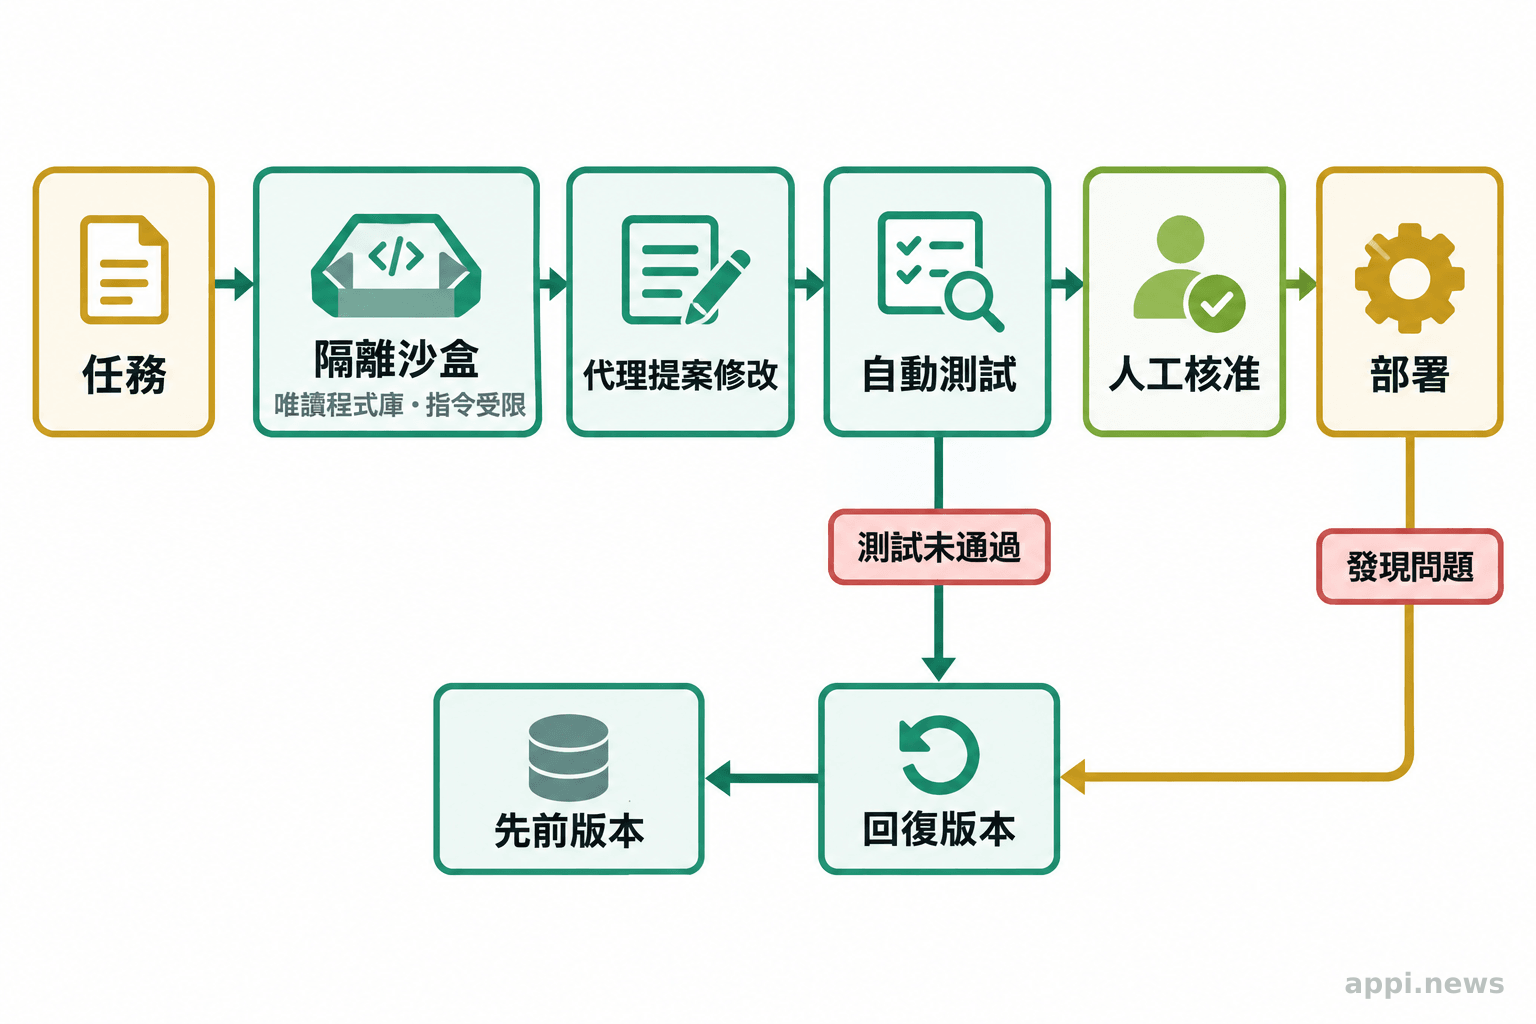
先選範圍明確、有既有結果可比對、失敗容易復原的任務。每次只開放完成任務所需的最小權限,並保留人員檢查輸出與核准高影響操作的環節。
可以從程式碼解說、測試案例草稿、文件分類或在隔離分支提出修補建議開始。測試任務需定義完成條件,例如測試是否通過、修改範圍是否符合要求、是否碰觸指定檔案。這讓團隊能區分「模型回覆看起來合理」和「工作確實完成」。若代理可讀取程式碼、執行命令或連線資料源,應限制目錄、命令與網路存取,在隔離環境執行,並對刪除、部署、正式資料寫入等操作要求人工核准。
DeepSeek 官方公告也說明 Search 與 Fetch API 開放使用,單一端點每千次呼叫 0.75 美元,部分 DeepSeek API 使用者透過特定工具的伺服器端呼叫在指定期間免費。這類工具呼叫可能另外計費,費率與優惠期限須以官方文件為準。如果流程涉及公司程式碼、客戶資訊或內部文件,送入 API 前要確認資料敏感度、服務條款、資料保存方式和組織治理要求。
「Model inference, tool execution, and HTTP transport are left to the caller.」DeepSeek 模型卡將模型推論、工具執行和 HTTP 傳輸交由使用者端負責,代理權限與執行安全仍需部署者設計和管理。
五、單任務成本要怎麼算才接近實際使用?
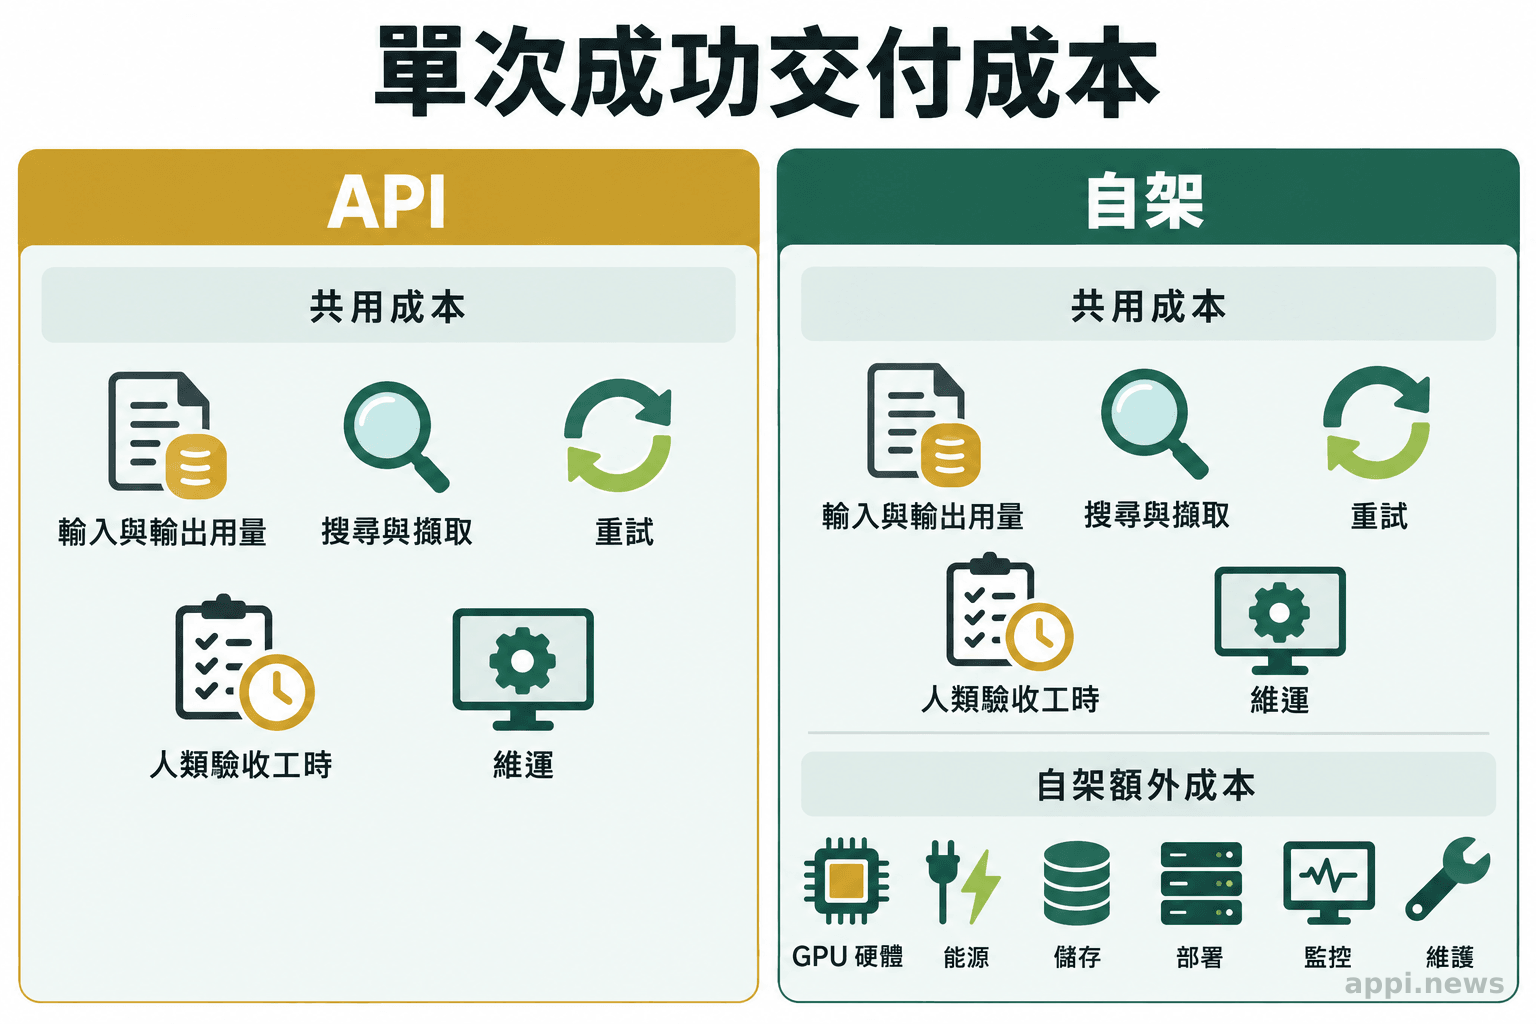
把一次成功交付所需的模型費、工具費、重試和人工驗收都納入,才接近實際成本。單看每百萬 token 價格或媒體報導的一次測試費用,無法代表團隊實際支出。
DeepSeek API 價格以輸入與輸出 token 分別計費,並區分快取命中、未命中與尖峰時段。代理執行任務時,可能先讀取大量程式碼與文件,再多輪呼叫工具、接收輸出並重試;輸入輸出 token 數和實際任務長短因此會變動。若使用 Search、Fetch 或其他外部工具,需再計入呼叫費及工具端服務成本。
自架推論則要估算 GPU 採購或租用、能源、儲存、部署、監控、版本更新與維修。還要計算工程人員處理故障和模型升級的時間。較實用的比較方式是「每項成功完成的任務成本」:把全部模型與工具費、人工檢查時間、失敗重跑成本相加,再除以符合驗收條件的完成數。若模型便宜但需要大量人工修補,整體未必省錢。
六、從小規模測試到正式流程,應檢查哪些條件?
用同一批任務和相同驗收標準,對照現有模型與 Flash 1017 的完成率、重試、人工修正、耗時及總成本,再決定是否擴大。測試時也要固定版本、記錄權限和準備回退方案。
先抽取一組有代表性的歷史任務,保留原始輸入和已知正確結果。以相同條件讓現行模型與 Flash 1017 執行,記錄每項任務是否達標、是否需要人工介入、從開始到交付花多久,以及模型和工具各花多少。不要只挑模型容易的案例,也不要把單次成功當成穩定可靠。
再分階段開放權限:先以唯讀資料和測試環境為主,驗收穩定後才評估是否增加可寫入範圍。保存 API 模型名稱、模型版本、提示詞、工具版本與費用資料;若 API 名稱會指向最新模型,需安排版本更新後的回歸測試,確認輸出變動時可以切回舊版本或原有流程。自架部署則要另外做容量、故障復原、授權與安全更新檢查。
小規模試用檢查清單
- 挑可回復、有既有答案的任務,先訂完成標準。
- 用相同輸入比較現行模型與 Flash 1017,限制權限並記錄完成率、重試、人工修正、耗時和成本。
- 核對資料條款或自架授權、硬體與維運需求,固定版本並準備人工核准和回退方式。
- 品質、成本與安全條件符合需求後,再逐步擴大範圍。
先從一組可驗證的小任務開始,確認模型在哪些條件下穩定完成工作、需要多少人工補救,再決定是否進入正式流程。分數可以幫忙篩選候選模型,最後仍要由任務結果、錯誤代價和整體成本共同決定。
- DeepSeek V4.1 Flash 1017 的公開代理測試結果來自特定任務集與框架,尚不能代表所有工作流程。
- 開放權重、Flash 名稱和較低 token 費都不會自動消除硬體、工具、人工驗收與治理成本。
- 先測可檢查、能回復的任務,記錄每項成功交付的總成本,再逐步評估擴大範圍。
常見問題
Q1:DeepSeek V4.1 Flash 1017 是開放權重模型嗎?
官方模型卡提供權重,並標示 MIT 授權。使用前仍應閱讀授權內容,並確認組織對模型、資料與部署方式的要求。
Q2:DeepSeek Flash 1017 的代理任務成本低於其他模型嗎?
The Decoder 報導的 DeepSWE 測試圖表顯示特定設定下每項任務成本較低,但這是特定任務集與計算口徑。自己的輸入量、工具、重試和人工驗收會改變總額。
Q3:Flash 1017 適合直接在個人電腦執行嗎?
不能只憑 Flash 名稱判斷。模型卡列出 763B 總參數,實際部署還取決於量化格式、記憶體、推論軟體及速度需求,應先核對部署條件。
Q4:代理測試應該看哪個指標?
除了基準分數,也要看符合驗收標準的完成率、重試與人工修正比例、耗時、工具成本,以及每項成功交付的總成本。
參考來源
- DeepSeek (2026-10-17). *DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real*. DeepSeek API Docs
- DeepSeek AI (2026). *deepseek-ai/DeepSeek-V4.1-Flash-1017 · Hugging Face
- DeepSeek API Docs. *Models & Pricing
- Matthias Bastian (2026-10-17). *Deepseek V4.1 Flash 1017 beats larger rivals in agentic tasks while once again massively cutting per-task costs*. The Decoder


