
DeepSeek 於 2026 年 10 月 17 日公布 V4.1 Flash 1017 更新,表示 API(應用程式介面)呼叫方式與價格維持不變,並公布多項基準測試改善。這些結果可作為試用線索,不能直接推斷日常任務會更快或更省。
AI 代理(AI agent)會依指令拆解任務、呼叫工具並根據回應繼續執行。它的成本除了模型輸入與輸出 token(模型處理的文字單位)外,也會受到任務成功率、重試次數、工具服務費、等待時間和人工修正影響。評估新版時,先定義「完成」的標準,再比較同一批任務的品質和實際總用量,才看得出更新對自己的系統有沒有意義。
一、DeepSeek V4.1 Flash 1017 更新了什麼?
DeepSeek 表示,網頁版、App 與 API 均更新至 V4.1 Flash 1017,API 建議以 deepseek-flash 呼叫,價格維持不變;官方也公布多項基準分數上升及測試中執行時間、輸出長度下降的結果。詳見DeepSeek 官方更新紀錄。
更新紀錄列出的部分分數為:HLE(Humanity’s Last Exam,人類最後考試,學術領域高難度問答,不使用工具)42.6、Terminal-Bench 4.0(終端機環境中的多步驟任務)42.3、DeepSWE v1.1(軟體工程任務)77.0、ProgramBench 29.1、NL2Repo-Bench 68.2、Automation-Bench v1.0.6 60.5、Agents’ Last Exam 35.4;另有 Apex Bench v1.1 72.1、Chartography(w/tools)83.0、BabyVision(w/tools)92.5、ZeroBench-main(w/tools)51.0。後續幾項涵蓋程式、流程自動化與圖像理解等不同任務;公告沒有提供可將各測試分數換算成共同尺度的方法,因此不能跨測試直接比較。
這些都是供應商發布的測試分數,適合用來辨認更新涵蓋哪些能力領域,不能當成第三方獨立驗證。
分數受測試條件影響:HLE 使用純文字子集,Terminal-Bench 4.0 使用 Claude Code 框架,DeepSWE 使用 Mini-SWE-V2,ZeroBench-main 採 Pass@5(五次嘗試中至少一次成功的評分方式)。工具、提示、重試與評分方式都會改變結果,版本比較需盡量對齊這些條件。
DeepSeek 在更新說明中表示,這次測試的任務執行時間與輸出長度都有下降,並據此主張模型能以較低成本、更快完成任務。官方英文原文為:
“we also reduced task runtime and output length” — DeepSeek API 更新說明(英文原文)
這是供應商對其測試結果的說明,實際效果仍需在相同工作負載下核對。
DeepSeek 表示,新模型針對 DeepSeek Harness、Tencent CodeBuddy、WorkBuddy 等平台最佳化,並建議 DeepSeek Harness 使用 0.2.1-rc.1 或更新版本。若部署採用其他工具或舊版框架,測試結果未必能重現。
升版未改變呼叫方式與既有價格;官方定價頁將輸入快取命中、未命中、輸出 token 及尖離峰分開計價,採用前應核對當下費率。
二、基準測試進步能代表自己的代理任務嗎?
不能直接這樣判斷。基準測試只反映特定任務集、工具框架、提示和評分條件下的表現;是否適合自己的流程,仍要用相同工作負載進行對照測試。
代理任務可能包含搜尋、工具呼叫、整理與驗收。偏重程式修改的測試集,不能說明搜尋、文件分類或客服任務也會進步;工具權限、重試與驗收方式同樣會影響結果。
基準分數可用來挑選待測能力,例如以 Terminal-Bench、DeepSWE 檢查程式與終端機任務,以 Automation-Bench 觀察多步驟流程;仍須用自身資料、規則和工具鏈驗證,不能據此推論新版普遍勝過競品。若實際工作以文件查找為主,測試集就應包含來源定位、不同格式處理與引用核對;若涉及程式修改,則要涵蓋既有測試、相依套件和版本控制規則。測試內容與日常工作越接近,結果越能指出哪些環節可能改善,哪些仍需要人員接手。
測試前需把任務成功條件寫清楚。以「整理一份供應商資料」為例,可以規定資料欄位完整、來源連結有效、不得臆測缺失資訊、輸出符合指定格式,並由人員抽核。若只把「回答看起來合理」當作通過標準,兩個版本的結果很難公平比較,錯誤也容易被流暢的文字掩蓋。
將失敗按資料格式、工具權限、逾時或驗收規則分類,有助判斷問題是否來自模型;例如 API 逾時未必能靠換模型改善,欄位遺漏則可針對結構化輸出比較版本。還要記錄錯誤發生後的恢復方式:任務能否從中斷處續跑、是否重複執行已完成步驟、產生的中間檔案能否辨認與清除。一次失敗如果只增加幾秒等待,與造成重複付款、覆寫資料或留下錯誤程式碼,所需的驗收強度不同。這些差異應反映在任務分級與測試樣本中,否則平均成功率會掩蓋少數但代價很高的失敗。
三、為什麼每 token 價格不變,任務成本仍可能不同?
會有變化的可能,但不能預先假設一定下降。官方表示測試中的執行時間與輸出長度減少,這可能降低部分任務的用量;實際帳單仍取決於輸入與輸出 token、快取命中、計價時段、重試和工具呼叫。
DeepSeek 依輸入、輸出 token 計價;提示長度、模型呼叫次數、快取狀態與計價時段都會影響費用,因此單次呼叫單價不能代表整項任務成本。
| 評估項目 | 每 token 價格 | 單次任務支出 | 流程總成本 |
|---|---|---|---|
| 主要計算 | 輸入、輸出 token 單價及時段 | 任務中的模型用量、重試與工具呼叫 | API、工具、等待、人工覆核與失敗處理 |
| 新版可能影響 | 依官方公告,這次 API 價格維持不變 | 輸出長度或成功率改變時,金額可能變動 | 若減少重試或人工修正,才可能降低整體負擔 |
| 需要核對 | 官方定價頁及當下計價條件 | 每項任務的帳單、token 與呼叫次數 | 完成時間、品質、人工處理和失敗後果 |
若版本常漏步驟而需重試或人工補件,單次生成較便宜仍可能增加總支出。應以「一件符合驗收標準的任務」計算,而非單次 API request。
DeepSeek 定價頁說明,模型使用費依 token 數量與單價計算,Search 和 Fetch 則按成功請求次數計費。頁面原文為:
“The expense = number of tokens × price. Search and Fetch are charged per successful request” — DeepSeek Models & Pricing(英文原文)
這是模型與工具服務的計費方式,並未涵蓋人工覆核或失敗補救所花的時間。
模型 API 費用不含所有代理服務;搜尋、資料庫、雲端運算或第三方 API 應分列。DeepSeek 定價頁另列 Search、Fetch 成功請求費率及部分工具的計費安排,測試時應記錄當日費率。
任務帳本記錄呼叫次數、輸入輸出 token、快取、工具請求、延遲與人工修正;失敗時標明停止步驟及補救方式。除成功任務平均花費,也要看失敗率與高成本案例。比較時可將成本拆成「成功完成的模型與工具費」及「失敗後新增的重跑、檢查和修復費」,並保留各自的中位數與高成本案例。少數任務可能因長上下文、反覆搜尋或多輪工具操作用掉遠高於平均的資源,單看整批平均值不容易察覺。若任務量逐月增加,也應估算不同使用量下的總額,並確認尖峰時段、快取狀態與工具計價規則是否改變預算。這能分辨節省來自模型少用 token,還是工作流程本身減少了不必要的往返。
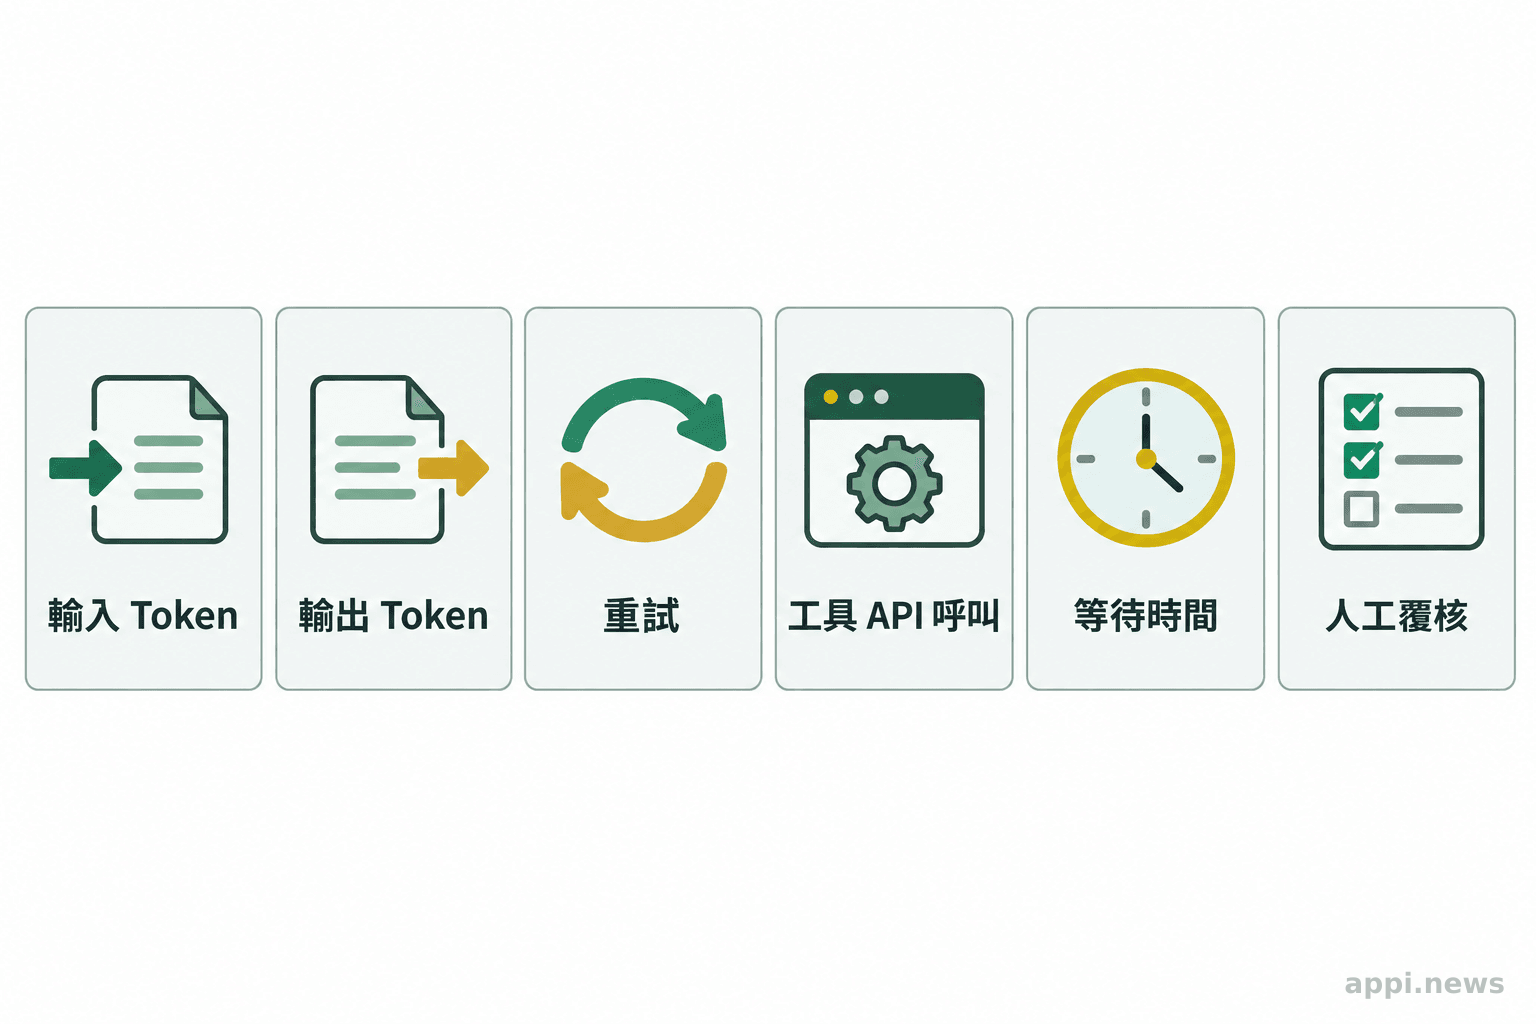
四、如何在自己的工作負載中評估新版?
挑選一組具代表性的既有任務,固定輸入、提示、工具權限、框架版本與成功判準,讓新舊版本完成相同工作,再比較品質、成功率、延遲、用量和人工處理成本。
樣本涵蓋常見工作、易失敗案例及高代價流程。保留輸入與預期結果,隱去版本標籤後用相同規則評分;輸出有隨機性時重複測試,並記錄樣本數。
一次只改一個主要變因;若須更新框架,模型與框架版本都列入紀錄,並先在隔離環境確認,避免把整套變動歸因於模型。
評分涵蓋規格符合度、完成率、耗時與呼叫量、人工修正;另記錄來源錯誤、欄位遺漏、工具選錯等類型。延遲從送出任務計至可用結果,含排隊、工具等待與人工確認。品質評分最好拆成可觀察的欄位,例如答案正確性、格式完整、來源可追溯與是否遵守權限,而非只給整體印象分。對需要人員判斷的項目,先寫出何種情況算接受、退回或升級處理,再讓評分者依同一規則檢查。若由不同人抽核,保留分歧案例並共同確認判準,否則評分差異可能比模型差異更大。
呈現完成率、成功任務平均 token 與費用、平均及高百分位延遲、重試比例和人工修正時間。若省成本卻降低品質,或加快速度卻增加失敗,應依任務重要性判斷,不以單一總分掩蓋取捨。對高風險任務,可另外列出錯誤嚴重度、發生後的復原時間及是否觸發人工介入;對低風險任務,則可把等待時間或每件處理成本設為主要指標。指標要在測試前選定,避免看到結果後才挑有利的數字。若新版僅在某類任務表現較好,路由規則也可以按任務類別分流,持續保留舊版作為比較與回退基準。
- 定義代表性任務與可驗收的成功條件,涵蓋常見案例和高風險邊界情境。
- 固定輸入、提示、工具權限、框架版本及重試規則,記錄模型與測試日期。
- 對照完成品質、成功率、token、工具費、延遲與人工修正,將失敗原因分類。
- 先在小流量或隔離環境試用,設定回退條件,確認達標後再逐步擴大。
五、哪些條件成立時才適合納入試用?
當測試樣本代表實際工作、成功標準清楚、版本路由與計價可追蹤,而且失敗時有人工覆核和回退方式,就可考慮小規模試用。涉及高錯誤代價或機密資料的任務,應先完成額外的風險與資料治理檢查。
可先試行低風險、易驗收工作,如內部文件整理或人工覆核的程式建議。付款、刪除資料、改動正式環境或影響客戶權益的任務應保留人工確認;上線後仍須監測錯誤與成本。
測試前保留舊版路徑,訂出錯誤率或成本的暫停門檻。供應商可能更新同名模型,故除 deepseek-flash 外,也記錄日期、可取得的版本資訊、提示、框架、參數與計價時段。
若任務含機密或個人資料,先核對傳輸、保存、權限、日誌與供應商條款,並採最小必要資料、遮蔽識別資訊及限制工具。也應確認測試紀錄是否保存提示、輸出或可識別內容,哪些角色能查看,以及資料刪除或保存期限如何管理。用合成或去識別資料測試時,仍需檢查樣本是否保留足以識別個人的細節;若測試環境與正式環境的權限不同,應分別記錄差異。AI 模型評估與藥品、保健原料或健康介入無關,因此沒有藥物交互作用議題;若應用含健康資料,仍須另評估資料保護與專業責任。
DeepSeek V4.1 Flash 1017 的公告呈現了供應商測試中的能力和成本變化,為模型選型提供一個待驗證的候選版本。決策依據應落到自己的流程:同一任務是否更常完成、結果品質是否可接受、整體成本是否下降、出錯後能否安全處理。先用可重現的對照測試回答這幾個問題,再決定擴大使用,會比依照單一基準分數或標價換版更可靠。
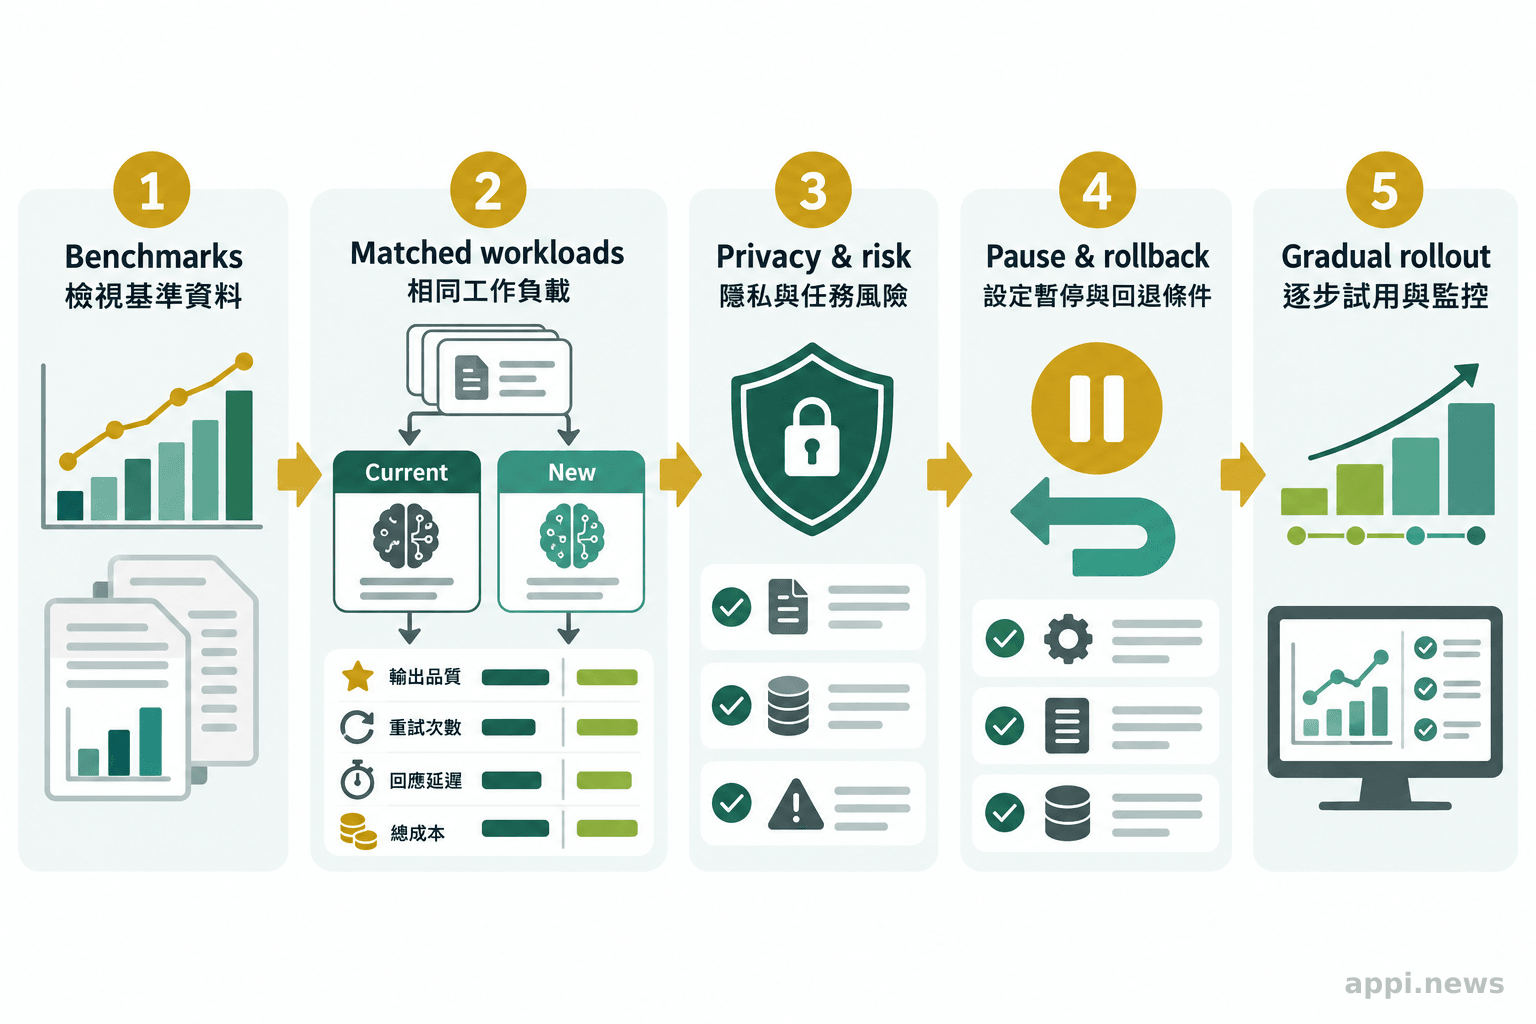
- DeepSeek 公布的 1017 更新基準分數屬於供應商測試,需留意測試集、代理框架與評分條件。
- API 價格維持不變不等於每件任務成本固定;重試、token、工具服務和人工修正都要計入。
- 以相同輸入、權限和成功標準比較新舊版本,先小規模試用並準備回退方式。
常見問題
Q1: DeepSeek V4.1 Flash 1017 需要更改 API 模型名稱嗎?
建議使用 deepseek-flash。官方定價頁目前表示舊名稱仍可使用,但請求會路由至 V4.1 Flash 1017,並按 Flash 價格計費;DeepSeek 9 月 10 日曾說明需改用 deepseek-flash 才能切換至新版。部署時也要確認中介服務是否改寫模型名稱。
Q2: 官方說 API 價格不變,代表每個任務費用也不變嗎?
不代表。每件任務的輸入和輸出 token、快取命中、尖離峰時段、重試及工具請求都可能改變費用;應用成功完成的任務作為成本單位比較。
Q3: 基準測試分數上升,是否表示它比其他模型更適合代理任務?
不能只憑這些分數判定。測試條件和自己的提示、工具、工作流程可能不同,還需要使用代表性任務做對照試驗。
Q4: 試用時最少要記錄哪些資料?
記錄模型和框架版本、測試日期、輸入輸出 token、工具呼叫、成功率、延遲、重試、人工修正與失敗原因,並保存價格與資料處理條款的查核時間。


