
DeepSeek 開源 DeepInfer,支援 NVIDIA SM100 與華為昇騰 950,讓團隊可以檢視並建置這套大型語言模型推論框架。真正要先回答的問題,是手上的硬體與軟體環境是否吻合,以及需求屬於批次離線推論,還是必須承受線上流量、故障與服務水準的正式服務。官方列出晶片平台,不代表其他同品牌設備也在支援範圍內,更不等於兩種晶片的效能相同。
- DeepInfer 的公開支援清單是 DeepSeek-V4.1-Flash、NVIDIA SM100 與華為昇騰 950。
- 公開程式庫提供離線推論範例;DeepSeek 表示完整服務仍有 KV cache 系統、分階段部署及負載平衡等元件未納入公開版本。
- 評估時應以相同模型、提示長度、併發量與服務目標做實機測試,再估算硬體、電力、整合和維運成本。
DeepInfer 新增了哪一層能力?
DeepInfer 是 DeepSeek 為其模型打造的推論框架,負責把模型執行、晶片運算與請求處理接在一起;公開版本目前列出 DeepSeek-V4.1-Flash 與指定加速器平台。
推論框架位於模型和應用服務之間。模型定義輸入如何轉成輸出,晶片執行其中的大量矩陣運算,框架則負責載入模型、安排請求、分配運算工作及管理生成流程。沒有適合的框架,即使硬體能運算,也未必能有效執行特定模型;框架能啟動模型,也不代表整套線上服務已具備流量入口、身份驗證、監控與故障復原。
DeepInfer 公開列出最佳化核心運算、平行化、非同步排程、結構化輸出等功能。平行化是把模型工作拆給多個處理器或多張卡共同完成;結構化輸出則可依設定產生符合 JSON 格式或文法限制的內容。這些能力有助於模型執行與應用介接,但其可用範圍仍要按指定硬體、版本和設定檢查。
DeepSeek 另有 Search API,提供遠端搜尋與網頁擷取端點,應用透過服務 API 傳送請求。DeepInfer 與 Search API 的用途不同,開發者取得的是可自行建置的推論程式碼和支援平台條件;模型權重和推論引擎可在自有環境執行。使用代管服務可減少自行管理硬體的工作,自有推論則要求團隊負責硬體、軟體與服務。選擇前要先確定要解決的是資料控制、服務依賴或運算成本哪一項問題。
離線推論與正式服務的邊界在哪裡?
不宜直接把離線範例視為正式線上服務。DeepInfer 公開程式庫提供離線推論入口;DeepSeek 也說明,建成完整服務所需的部分快取與負載平衡元件尚未完整公開。
離線推論通常由操作者提供一批輸入,模型處理後輸出結果,工作量與啟動時間較容易預先規劃。這適合測試模型能否載入、輸出是否符合預期,以及單一節點或批次工作如何使用運算資源。公開範例可從模型平台下載預設權重,也可指定本機模型目錄,讓程式從本地檔案執行。
線上服務面對的條件更複雜。請求會在不同時間抵達,長短不一,也可能突然增加。系統除了生成結果,還需決定請求送往哪個工作節點、如何限制排隊時間、如何處理逾時與重試,以及節點失效時怎麼恢復。只跑通一則提示詞,無法回答高併發時的延遲、尖峰容量和服務可用度。
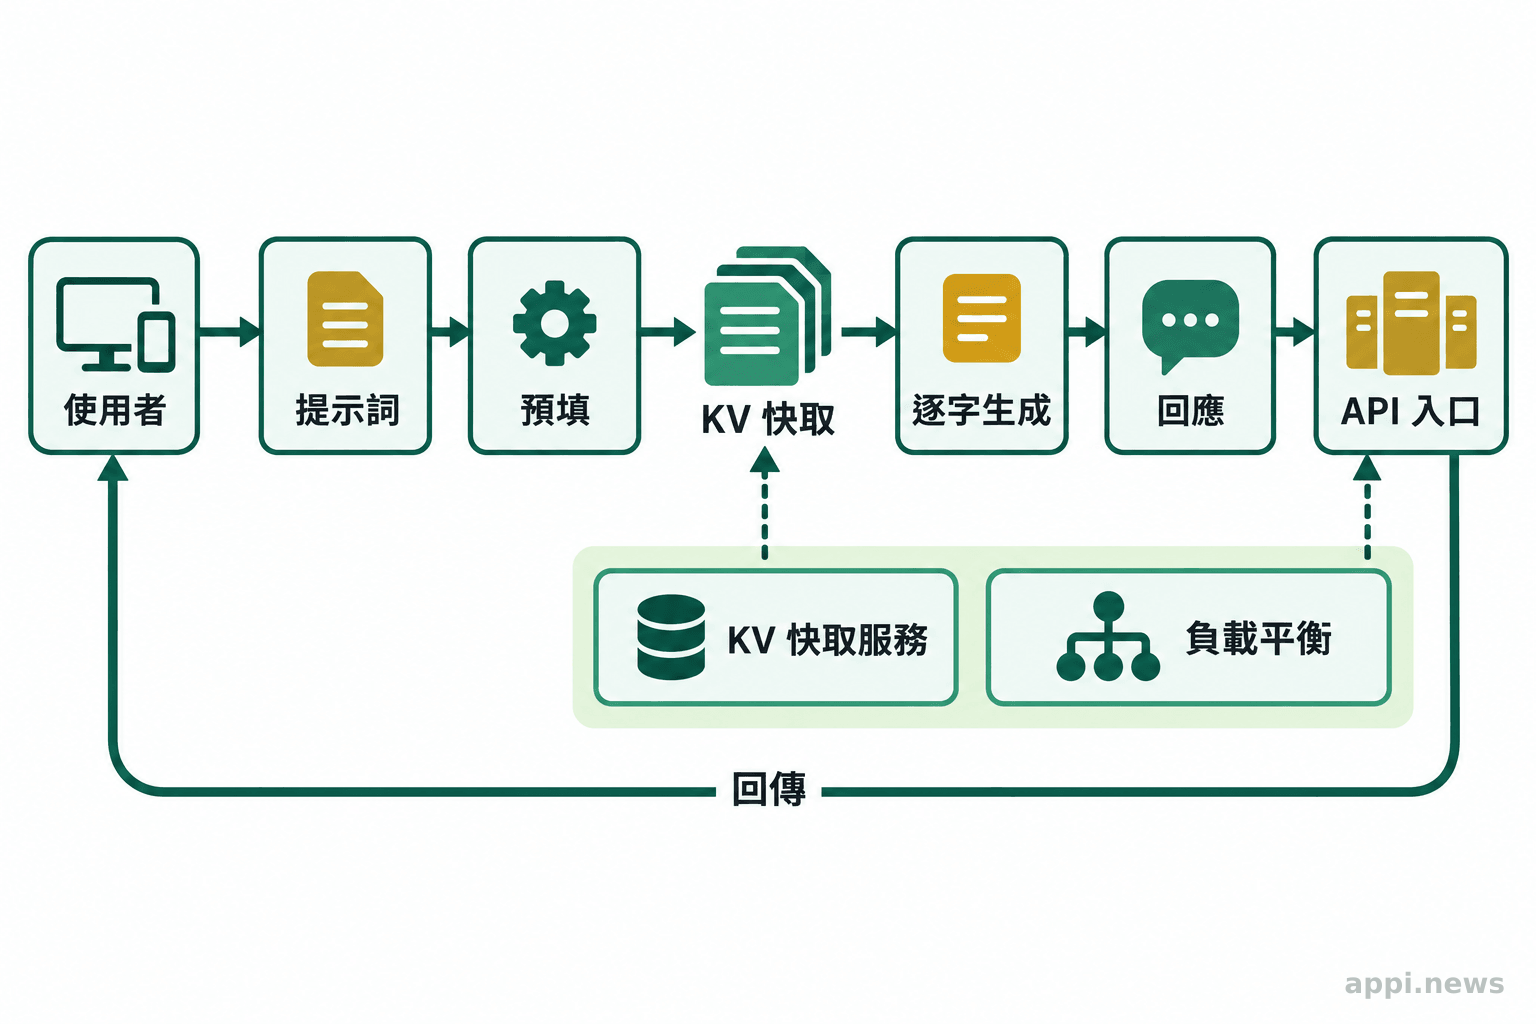
推論期間會保存 KV cache(鍵值快取),用來記錄已處理文字的中間狀態,減少生成後續文字時重複計算。若請求能重用快取,可能減少部分運算;但快取如何儲存、查找、淘汰和跨節點共用,都涉及記憶體容量、儲存設備、網路與資料一致性。官方文件列明這部分屬於完整服務所需能力,並指出相關程式與內部基礎設施高度耦合,尚未完整開源。這會影響團隊能否只靠公開程式庫重建 DeepSeek 所描述的服務架構。
另外兩個常見術語是 prefill(提示詞預填)與 decode(逐字生成)。前者先處理使用者輸入的整段提示,後者依序產生回覆文字。兩階段運算特性不同,拆開部署可分別調配資源,也會增加節點間傳遞快取、排程協調、網路容量及故障管理的工作。
官方表示已有多數相關引擎功能,但完整服務所需的視覺編碼器、prefill、decode 分離與跨副本負載平衡仍有未公開部分。工程團隊要按實際程式碼確認可部署邊界,不能只從架構示意圖推定功能已全部附上。
「這次開源版本提供離線推論,以及面向大規模服務的核心功能。」DeepSeek 的 DeepInfer 官方程式庫說明。
NVIDIA 與昇騰支援要怎麼評估?
不代表。官方目前明列 NVIDIA SM100 GPU 與華為昇騰 950 NPU,並分別要求 CUDA 13 與 CANN 9.2;其他晶片型號、驅動和軟體組合不能由品牌名稱推定相容。
DeepInfer 的建置條件還包括 Linux、GCC 13 以上、Python 3.12,以及獨立的 Python 環境。編譯器版本、加速器驅動、核心函式庫和框架相依若不吻合,可能在編譯、載入核心或執行模型時出錯。導入前應將伺服器型號、晶片、驅動、CUDA 或 CANN 版本、Python 相依和模型權重版本逐項對照官方文件,並固定可重現的環境映像。
兩條硬體路徑也不應只比規格表。NVIDIA 與昇騰各自使用不同軟體堆疊,核心運算實作、通訊和工具鏈成熟度皆須在目標環境中驗證。即使兩者都出現在支援清單,也只代表文件列出對應平台,無法據此推導同一模型在相同輸入下有相等的延遲、吞吐量、記憶體占用或能源效率。
DeepSeek 的公開效能資料標示特定 NVIDIA SM100 配置,分別用於 prefill 和 decode,並提供測試重現方式。這些是有條件的測試結果,不能代替昇騰平台測試,也不能直接代表企業自身的流量。若提示詞長度、輸出長度、併發請求、快取命中率或網路拓撲不同,數據就不一定能平移。對外宣稱與獨立實測應分開看;官方說明證明的是發布方提供了哪些功能與數據,不等同第三方已重現。
可比較兩種平台的檢查面向如下:
| 檢查面向 | NVIDIA 路徑 | 昇騰路徑 |
|---|---|---|
| DeepInfer 列出的硬體 | SM100 GPU | Ascend 950 NPU |
| 官方列出的加速器環境 | CUDA 13 | CANN 9.2 |
| 共通建置條件 | Linux、GCC 13 以上、Python 3.12 | Linux、GCC 13 以上、Python 3.12 |
| 應自行驗證 | 驅動與 CUDA 相容性、核心執行、提示長度下的吞吐及延遲 | CANN 與驅動相容性、核心執行、提示長度下的吞吐及延遲 |
| 成本項目 | 卡與伺服器、機房供電散熱、網路、工程與維運 | 卡與伺服器供應、機房供電散熱、網路、工程與維運 |
DeepSeek 的效能數據由官方提供,可供設計測試條件參考,無法當成採購保證。若目標平台沒有可比的公開基準,就在採購或正式導入前,以同一版本程式和模型、同一組提示與併發條件進行測量,記錄首字延遲、每秒輸出 token 數、整體吞吐、資源使用和錯誤率。測試報告也應保留軟硬體版本,日後更新時才知道差異來自哪一層。
從離線執行走到服務,需要補哪些環節?
至少要盤點 KV cache 儲存、prefill 與 decode 的資源分配、跨副本負載平衡,以及應用 API、存取控制、監控、排程和故障處理。DeepSeek 說明其中若干服務元件未包含在公開版本。
第一個缺口是服務入口。應用需要能呼叫的 API,並由入口層負責身份驗證、配額、請求格式驗證、日誌和錯誤回覆。DeepSeek 同步開源的 deepseek-recipe 處理 API 協定與模型 token 序列的轉換;團隊仍需確認這個元件支援自己的呼叫方式,並設定外部入口的權限、加密和流量限制。
第二個缺口是排程與擴展。流量管理需觀察佇列長度、工作節點負載和不同階段的運算需求。若把 prefill 和 decode 拆到不同資源池,跨節點傳遞中間資料的速度會影響端到端延遲;若使用多份模型副本,負載平衡器需避免某一副本過載,也要處理節點離線、工作重派與容量不足。這些工作會與快取狀態和資料傳輸互相影響,不能只加一層反向代理就算完成。
第三個缺口是營運。正式服務要設定延遲與可用度目標,持續監看請求量、排隊時間、首字延遲、生成速度、快取使用率、錯誤率、晶片與記憶體使用、能源與溫度。還要設計版本更新、回退、備份、故障告警和權限稽核。若系統處理個人或敏感資料,仍須明確規範資料的存取、留存、傳輸與責任分工;模型在自有伺服器執行,不會自動消除這些資料風險。
「KV cache 管理與負載平衡程式碼尚未完整開源。」DeepSeek 在官方部署問答中說明。
部署成本要從哪些原因拆開估算?
成本要按目標工作量和服務水準估算,除了加速器採購或租用,也要計入機房電力與散熱、網路和儲存、建置整合、維運人力、備援及故障造成的服務損失。
硬體成本不能只看單卡價格。模型載入、快取容量和並行方式可能決定需要多少加速器、主機記憶體、儲存空間與高速互連。伺服器持續運轉的耗電和冷卻成本會隨使用率變化;為了容錯而保留的備用資源,也需要計入總持有成本。供應時間、保固與零件取得狀況,會影響擴容和修復計畫。
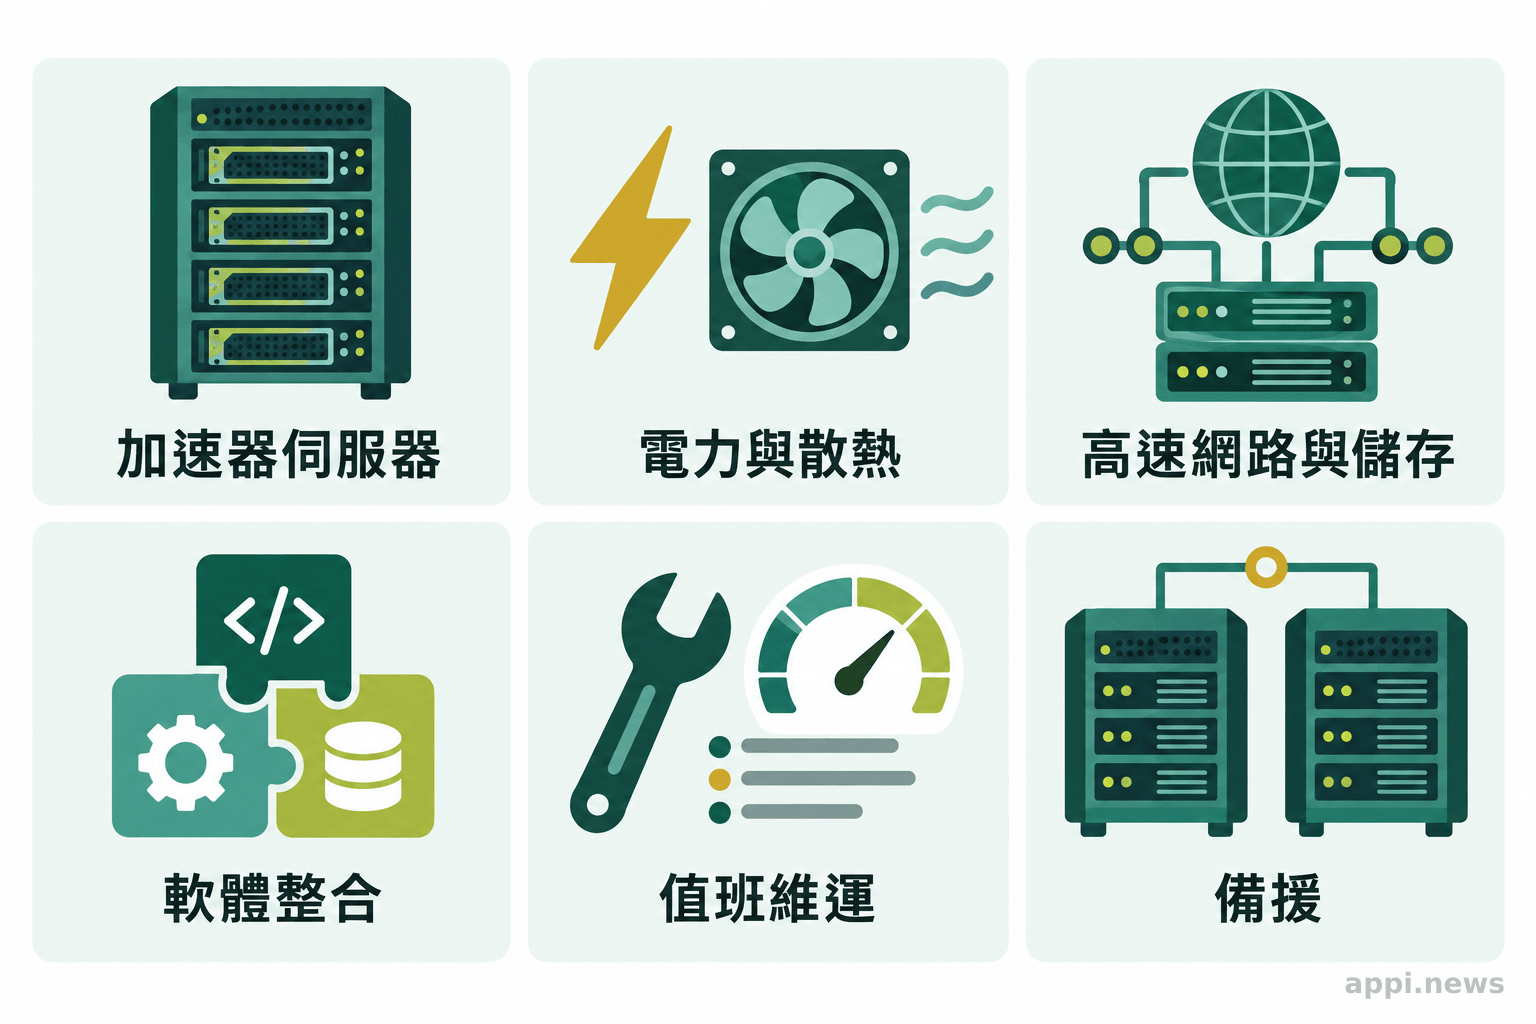
軟體整合與人力同樣會形成持續支出。工程師需建置相依環境、處理跨晶片差異、製作測試資料集與部署流程,之後還要追蹤上游變更、更新驅動和模型、修補安全問題並維護告警與值班流程。若公開程式庫缺少正式服務必要元件,團隊需要自行實作、採用其他相容元件或等待後續公開;每條路線都應估算整合和長期維護責任。
若請求不多、工作時間可預期,離線批次工作可能更符合實際需求。若服務有尖峰流量、低延遲或高可用要求,則需按尖峰而非平均用量配置容量,並把備援和故障復原成本列入。使用雲端 API 也可能是合理基準,應與自有部署比較單位請求成本、資料處理限制、供應商依賴和內部維運負擔,而非只比較每張卡的購置金額。
部署前可依這個順序做小規模驗證:
- 寫下模型版本、提示詞長度、輸出長度、併發量、尖峰持續時間和可接受延遲。
- 對照 DeepInfer 公開支援的晶片與軟體版本,確認可取得相符硬體和依賴環境。
- 用代表性資料執行離線基準,記錄首字延遲、吞吐量、資源使用、錯誤和快取命中狀況。
- 壓測服務入口、佇列、快取、負載平衡和節點故障,記錄尚未具備的線上服務元件。
- 將加速器、能源、儲存、網路、整合工時、值班和備援成本放入同一份估算,再與代管 API 或其他推論引擎比較。
採用判斷應回到工作負載與團隊條件。若公開版本只涵蓋需求中的模型、加速器和離線執行,先驗證這一段是否符合期待;若目標是正式線上服務,就把缺少的元件當成專案工作和成本評估,不要從「支援晶片」直接跳到「可以上線」。
常見問題
否。官方公開版本提供離線推論和面向服務的核心功能,但其文件列出完整服務仍需的快取與負載平衡等能力,部分尚未完整公開。
常見問題
Q1:DeepInfer 是否等同於可直接上線的服務?
不等同。公開程式庫能提供建置和離線推論入口,DeepSeek 表示這套推論系統支撐其大規模服務;但官方也註明完整服務還需要尚未完整開源的 KV cache、分階段部署及負載平衡元件。部署團隊需逐項確認公開版本具備的內容和自身須補上的服務層。
Q2:支援昇騰是否代表效能與 NVIDIA 相同?
不代表。官方支援清單列出 NVIDIA SM100 和華為昇騰 950,但兩者使用不同軟體堆疊,公開基準的測試平台也不一定涵蓋兩邊。應在各自目標環境用同一模型、工作負載與服務指標實測,才可比較延遲、吞吐和資源使用。
Q3:部署前應先確認哪些條件?
確認模型、晶片型號、作業系統、編譯器、Python、CUDA 或 CANN 版本,再定義提示長度、併發量、延遲目標與資料處理規則。完成離線測試後,還要測量 API、快取、排程、負載平衡、監控和故障復原,並把硬體、電力、整合與維運成本納入估算。


