
帳單、收據或客服郵件進到系統後,如果流程只需要日期、金額和單號,通常不必先請模型寫一段完整說明,再從文字裡拆回欄位。Cloudflare 推出的 Clairic,正是瞄準這類文件資料擷取:使用者先定義欄位與資料型別,模型再從文字或圖片中抽取、計算、估算或預測相應值。它目前以 Workers AI preview 形式提供,Cloudflare 宣稱部分任務比大型語言模型(LLM)更快、成本更低;這些比較仍須視為廠商公布的測試結果,不能直接當成每個企業流程的成效保證。
Clairic 解決的是哪一段文件流程?
Clairic 將文字或圖片中的資訊轉成預先定義的型別欄位,適合輸入內容不固定、但輸出欄位明確的抽取工作。它回傳欄位值及相關信心資訊,供後續程式或人員處理。
傳統表單欄位位置固定,程式能靠座標或欄位名稱讀取;但電子郵件、收據和報價單的句子、版面常會變動。若要取得「總額」或「交貨日」,工程團隊可能得補規則、解析器、格式檢查與例外處理。大型語言模型可以讀懂上下文,卻也會產生一段自由文字,呼叫端還要確認格式,再判斷答案能否對回原文。
Clairic 的使用方式是先提供 state,也就是待讀取的文字或圖片,再以 fields 描述需要的欄位,例如 invoice_number 是文字、due_date 是日期、total 是兩位小數的金額。模型依欄位定義回傳值。Cloudflare 文件也展示可處理圖片輸入;對掃描 PDF 或其他檔案,系統仍須先確認檔案能否直接轉成受支援的文字或影像輸入,必要時加入文件轉換或 OCR(光學字元辨識)步驟。
Cloudflare 將 Clairic 定位為 System One 抽取模型,依欄位型別回傳值,處理明確的資料擷取、計算與估算任務。(Cloudflare Workers AI 文件與產品公告)
這種設計適合「答案範圍先定義好」的工作,例如從信件找訂單編號,或依帳單中的金額和付款條件計算到期日。它仍需要明確欄位規格:日期採哪種格式、幣別如何標示、遇到空白或多筆金額時怎麼處理。schema(欄位與型別規格)如果定義不一致,不同部門即使使用同一模型,也可能得到不同的業務解讀。
文件抽取何時不需要大型語言模型?
當流程要的是少數固定欄位,且後續能用規則核對或交由人員覆核時,可以把 Clairic 納入比較。若需求是找文件、綜合多份資料、解釋原因或撰寫回覆,檢索與生成模型仍有各自角色。
三種任務常被混在一起。文件抽取回答「這張收據的日期和總額是什麼」;知識檢索(RAG,檢索增強生成)先從資料庫找出相關段落,再交給模型組織回答;生成模型則負責說明、摘要、對話或處理開放式問題。RAG 不等於抽取模型,因為它主要解決「去哪裡找資訊」,不會自動替每個文件欄位建立可信值。生成模型也不必消失,可以在抽取與檢索完成後,把已核對的資料整理成讀者看得懂的文字。
因此,Clairic 可能位於入庫或流程分流的前段:文件送進來,抽取模型提供欄位與來源位置;程式檢查格式、範圍與必填值;不確定或互相矛盾的項目交給人工;通過檢查的資料再進資料庫、RAG 索引或後續生成服務。這樣分工能減少生成模型需要處理的原始內容,但每一段仍需定義責任人與失敗時的處理方式。
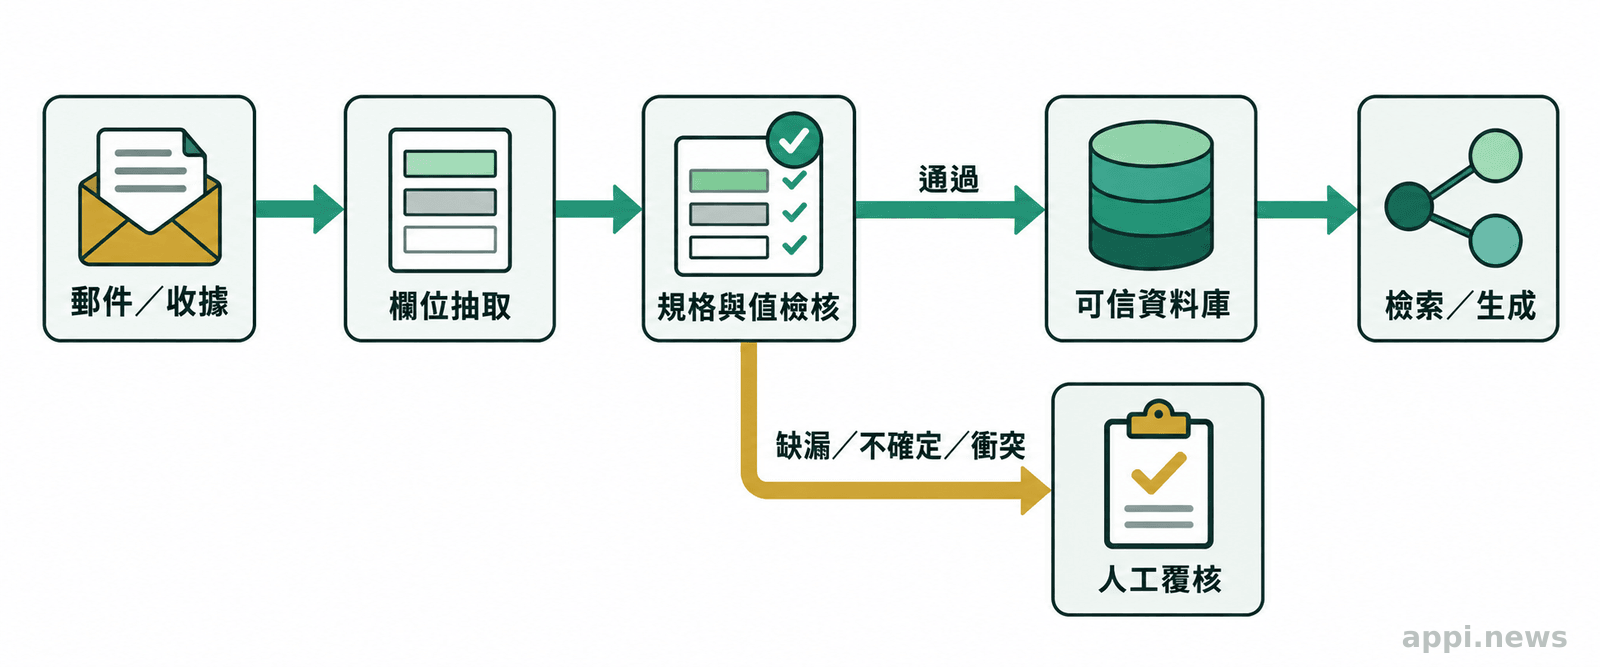
欄位型別正確,也不代表資料已被業務驗證。模型可能將格式合理的數字配到錯誤欄位,或在文字品質差、表格跨頁、日期缺少年份時誤判。Cloudflare 文件示範的 span 與字元位置,能協助系統回到原文核對;信心分數則可協助設定覆核優先順序,並非正確率保證。高風險金額、合約條款或個人資料,仍要依錯誤代價決定是否人工確認。
低延遲與低成本主張該怎麼讀?
Cloudflare 公布的結果顯示,在其測試流程中,Clairic 與其他模型串接的方案較快且較省;這不能直接推論到不同文件、模型、流量與系統架構。導入評估應量測從文件進站到欄位可用的端到端時間和總成本。
Cloudflare 在產品公告中比較一個客服損壞申訴流程:Clairic 抽取、Clef 判斷,再由 GLM-5.3 撰寫回覆;對照組則由 GLM-5.3 負責抽取、判斷和回覆。該案例列出的端到端延遲為 19.3 秒與 61.7 秒,每百萬筆申訴的估算成本為 6,032 美元與 11,740 美元。這是 Cloudflare 自行設計與執行的情境,不是獨立機構在各種企業文件上的測試;提示內容、硬體、輸入長度與回覆長度都會影響結果。
Cloudflare 公布的 19.3 秒與 61.7 秒,分別來自抽取、判斷與生成的兩種端到端流程測試;產品公告也說明目前端點仍屬 preview。(Cloudflare 產品公告)
「模型單步延遲」也和「整體流程耗時」不同。實際部署還包括檔案上傳、影像辨識或轉檔、網路傳輸、重試、欄位驗證、人工覆核與寫入資料庫。若原本瓶頸在人工整理或前處理,抽取模型可能改善部分工作;若瓶頸在影像品質、外部系統排隊或審核排程,換模型不一定會明顯縮短交付時間。
成本也不能只比較模型每次呼叫費用。Workers AI 文件列出 Clairic 的輸入 token 單價,價格與服務條件可能變動;實際帳單還要計入轉檔/OCR、失敗重跑、應用程式運算、儲存、人工覆核及維護 schema 的時間。若欄位數量多、輸入文件很長,或大量樣本被送人工覆核,節省的推論成本可能被其他環節抵銷。
Clairic 如何接進既有資料流程?
導入前要先定義欄位、來源格式、驗收條件與例外流程,再把模型回應接入既有 API、資料庫或檢索服務。模型輸出需要保留來源文件與欄位追溯資訊,並設置人工覆核和回退機制。
第一步是檢查輸入品質。郵件內文可以直接當文字處理,圖片則須辨識支援的格式、尺寸與頁數;PDF、表格或掃描件可能要轉檔、切頁或 OCR。前處理如果刪掉欄位上下文、表格標題或幣別符號,後面模型再快也可能回答錯。建議保存原始文件識別碼、版本和必要頁面位置,避免只保留抽取後的值。
第二步是把欄位規格寫清楚。像「金額」可能同時指未稅小計、含稅總額或已付款金額;「日期」可能是開立日、到貨日或付款期限。每個欄位應定義語意、型別、單位、允許空值、來源證據及遇到多個候選值時的處理規則,再用真實流程中常見的文件檢查模型回傳是否合用。
第三步是設計例外處理。可以根據欄位重要性、信心分數、來源位置、數值範圍和欄位之間的邏輯關係建立門檻。低信心、缺欄、日期無法判定、合計與明細不一致時,應轉人工覆核或回退既有模型。即使信心分數很高,也可抽樣稽核,避免系統長期把一種固定錯誤當成穩定輸出。
如果串接 RAG 或生成模型,將抽出的值、原始文件位置、轉換紀錄與覆核狀態一併保存。下游服務才知道這個值來自哪份文件、是否經過檢查、能否用來回答問題。若系統只傳一個金額給生成模型,模型可能把未覆核數字描述成已確認事實;保留來源與狀態能讓回答留有查證路徑。
資料治理也要先過一遍。文件若含個人資料、財務資訊或商業機密,須確認資料傳輸、保存、存取權限、刪除方式及供應商條款。Cloudflare 的 Workers AI 資料使用說明表示,一般推論內容在服務完成後不會保留,也不會用於訓練,但使用儲存、記錄、快取或其他有狀態功能時,資料處理方式會受相關設定與功能文件約束。企業仍須對照自己的架構與合約,不能把供應商的一般政策視為所有整合方式的共同設定。
另外,Clairic 官方文件標示為 preview。Cloudflare 公告提到目前版本在較長的多步計算、跨多列彙總等情境仍有能力限制,較適合讓程式處理確定性計算,再由模型負責抽取或提出預測值。preview 期間的模型能力、可用性與服務條件可能調整,正式流程要有替代服務、人工處理或暫停入口的安排。
哪些情況適合先做小規模評估?
先挑一種高頻、欄位明確且錯誤能被發現的文件流程,用去識別化樣本對照既有方案。只有在欄位品質、端到端效能、例外成本與資料治理都達到預先設定的門檻後,才考慮擴大範圍。
先把問題定義清楚:目前是人工抄錄太慢、格式解析容易失敗、自由文字輸出難以驗證,還是檢索找不到正確資料?不同原因要比較的方案不同。若文件量小、每份文件都需語意判斷,或欄位定義頻繁改動,導入專用抽取服務未必比既有流程省事;若欄位固定且處理量大,則較值得用代表性樣本檢視效率和覆核負擔。
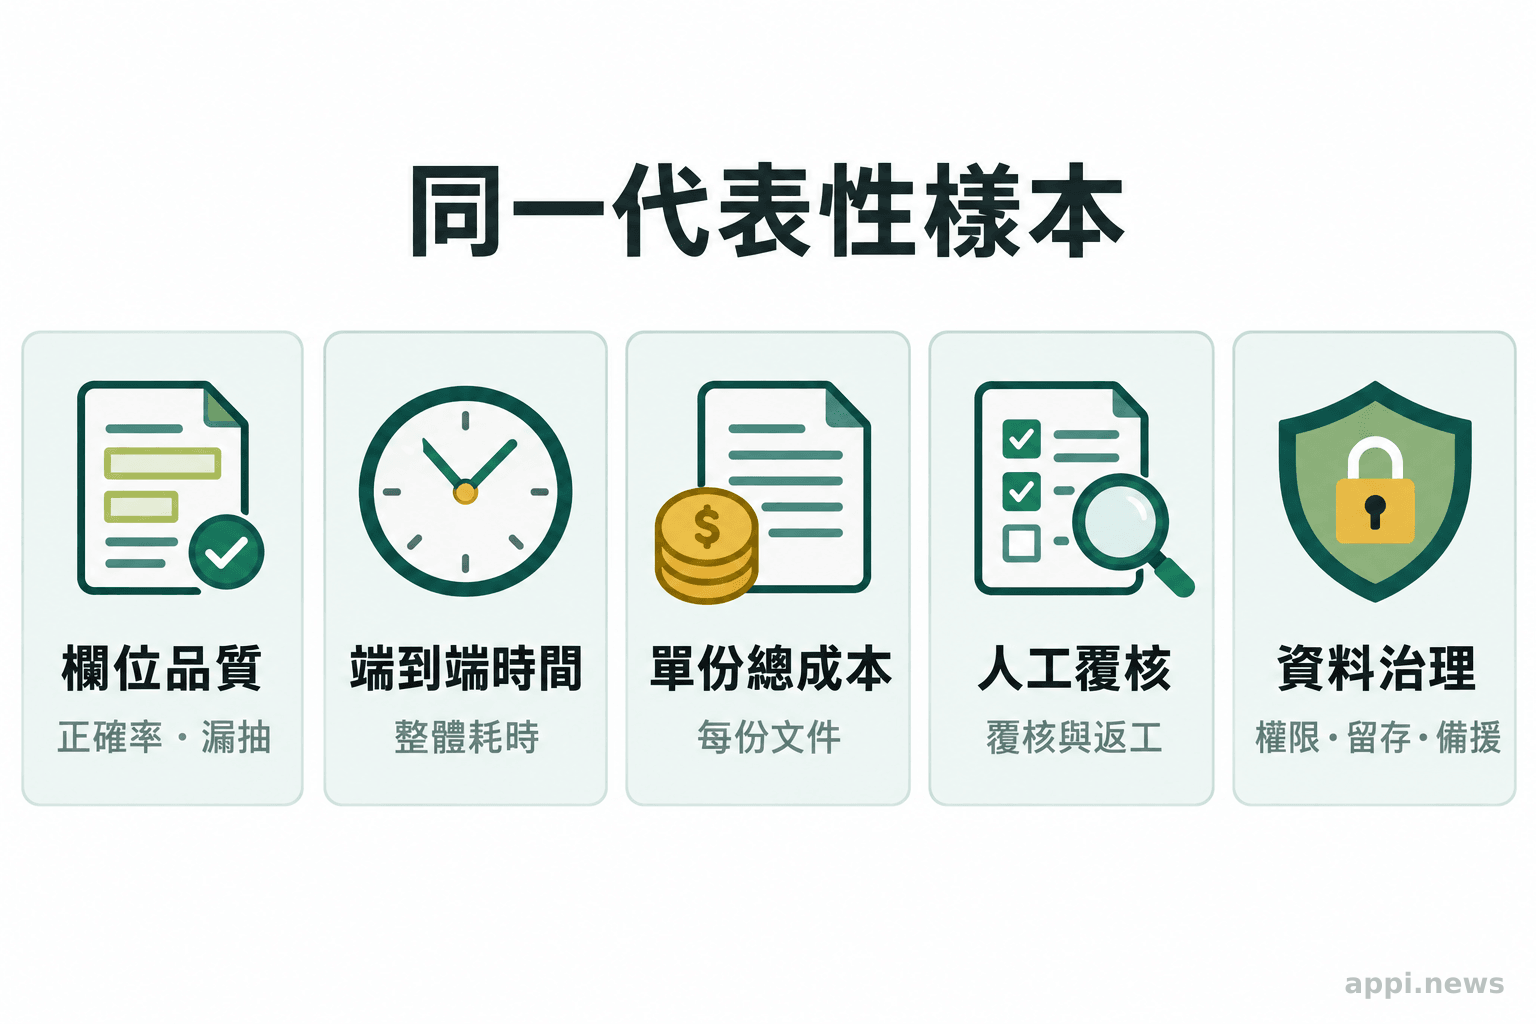
試跑樣本要涵蓋日常格式與例外:不同來源、版面、掃描品質、欄位缺漏、幣別、日期寫法及重複欄位。先由熟悉業務的人標註正確答案,再用相同資料和欄位規格比較既有方案與 Clairic。衡量時至少要分欄位計算正確率與漏擷取率,並記錄錯誤類型;平均分數容易掩蓋「總額偶爾被抽成小計」這類高代價錯誤。
把端到端延遲、每份文件總成本、人工覆核量、重跑率與欄位修訂工時一起記錄。再由流程負責人訂出可接受錯誤率、低信心比例上限、資料保存政策、回退條件和誰負責確認。使用去識別化或合成樣本降低試跑風險;若必須使用真實機密資料,先完成內部資安與法務審查。
- 挑選一種高頻、欄位明確的文件,列出欄位定義與錯誤代價。
- 準備去識別化的代表性樣本,建立人工確認的基準答案。
- 以相同輸入比較既有方案和 Clairic,記錄正確率、延遲、成本及覆核量。
- 設定低信心、缺漏或衝突的人工覆核與回退規則,驗證來源追溯和資料存取控管。
- 依預先訂出的門檻決定維持試驗、調整流程或停止導入。
判斷標準應回到實際使用情境:抽取結果是否讓後續資料更容易核對,錯誤是否能及時攔下,整體成本是否真的下降。Clairic 可以成為文件流程中的一個模型選項;它適不適合,取決於資料品質、欄位定義、整合責任與失誤代價。
- Clairic 面向欄位明確的抽取、計算、估算與預測任務,目前仍是 Workers AI preview。
- 抽取、知識檢索和生成回答負責不同工作,可依流程串接,不必要求單一模型包辦所有步驟。
- Cloudflare 公布的速度與成本數據來自廠商測試;應以自有文件比較欄位正確率、端到端延遲、總成本和人工覆核量。
- 對低信心、欄位缺漏及數值衝突設人工覆核或回退,並保留來源文件與存取治理紀錄。
常見問題
Q1:Clairic 可以直接取代大型語言模型嗎?
不能一概而論。Clairic 適合輸出指定型別的值;需要解釋、摘要、對話或開放式文字時,生成模型仍有用途。兩者可依任務分段使用。
Q2:Clairic 是知識檢索工具嗎?
不是。它可把提供給模型的文字或圖片轉為欄位值;RAG 則從外部資料庫檢索相關內容,再供生成模型組織回答。資料流程可以將抽取結果存入資料庫或索引,再交由檢索服務使用。
Q3:如何確認抽出的日期或金額可信?
比對欄位定義、來源位置、信心資訊、數值範圍及其他欄位的邏輯關係,並用人工標註樣本測試。高風險或低信心結果應覆核,不應把型別正確或信心分數直接當成正確證明。
Q4:掃描 PDF 可以直接交給 Clairic 嗎?
官方文件說明模型可接收文字與圖片;實際整合需確認 PDF 是否要先轉為文字或受支援的圖片輸入,並處理 OCR、頁面切分及原文位置保存。


