美國財政部長 Scott Bessent 於 2026 年 9 月 21 日接受 CNBC 訪問時表示,AI 開發者需要對自身行為負責,政府不會接手企業責任。這段談話屬於政策訊號與政治表態,不能直接當成新法律,卻提醒企業檢查模型、產品、部署與事故處理的責任。
一、美國財政部長說了什麼?先分清政策訊號與法律生效
貝森特的公開談話代表美國政府目前不傾向用聯邦責任豁免保護 AI 開發者,但它本身不會立即建立新的責任分配法,也不會取代既有的產品責任、消費者保護、資安或契約規則。
TechNews 報導,主持人詢問 AI 實驗室是否希望政府承擔部分責任時,貝森特強調責任仍在人類與企業,也提到政府需要建立更明確的責任範圍。企業不能預設聯邦政府提供安全網,具體治理方向仍待形成。
TechNews 引述貝森特表示,AI 開發者需要為自己負責,不應期待聯邦政府提供免責保護。
本次談話本身不會直接創設新的責任義務;實際法律效果仍須看後續立法、行政措施、判決、契約與具體事實。
二、AI責任沿生命週期分層,不能只找一個對象承擔
AI 責任應沿著模型開發、產品整合、系統部署與實際使用分層判斷,核心依據是各角色掌握的資訊、控制能力、承諾內容與可預見風險。
模型開發者掌握訓練資料來源、模型能力邊界、安全測試、版本變更與已知限制。企業審查不只看 benchmark(基準測試)分數,也要確認測試情境是否接近自己的資料、語言、產業與使用方式;模型卡可提供起點,但不能取代企業驗證。
產品供應商或系統整合商負責把模型放進介面、流程、權限與對外承諾。相同模型用於客服草稿、授信輔助或自動下單,風險不同;若輸出會直接觸發通知、交易或人事決策,整合者就必須說明人工覆核、例外處理與回復機制。
部署企業掌握實際資料、使用者、決策場景與營運後果。企業決定把 AI 用在哪裡、授權誰使用、輸出是否能直接採用,也最接近受影響的客戶或員工。因此,部署者應在其控制與契約約定範圍內,建立場景分級、教育訓練、監控、事件通報與停用條件,並依產業法規與具體事實承擔相應義務。
| 角色 | 主要可控制事項 | 採購時應要求的證據 |
|---|---|---|
| 模型開發者 | 訓練資料、能力邊界、安全測試、版本變更 | 模型卡、評測方法、限制說明、版本紀錄 |
| 產品供應商/整合商 | API、介面、流程、權限、輸出承諾 | 系統架構、權限矩陣、測試報告、變更通知 |
| 部署企業 | 使用場景、資料、人工覆核、事故處理 | 使用規範、核准紀錄、日誌、事件演練 |
若模型供應商、產品供應商與系統整合商不是同一主體,採購文件與合約應分別列出各方責任、證據提供範圍與事件通知義務。
三、沒有責任豁免,企業供應商審查要看哪些證據
企業應先確認供應商能否提供與使用情境相連的測試、版本、資料流與事件證據,再評估價格、功能與模型效能;口頭承諾難以支撐後續追查。
NIST AI RMF 是自願採用、非特定產業的風險管理架構,將治理、盤點、衡量與管理放進 AI 生命週期。生成式 AI 指引則提供測試、責任、版本與事件紀錄等治理方向;企業可參考這些建議,轉成供應商問卷、驗收條件與內部紀錄,但這些框架本身不會直接創設法定保存義務。
「風險容忍度,以及組織或社會可接受的風險程度,高度取決於脈絡與具體應用、使用情境。」(中譯)— 美國國家標準暨技術研究院(NIST),《人工智慧風險管理框架 1.0》(2023)
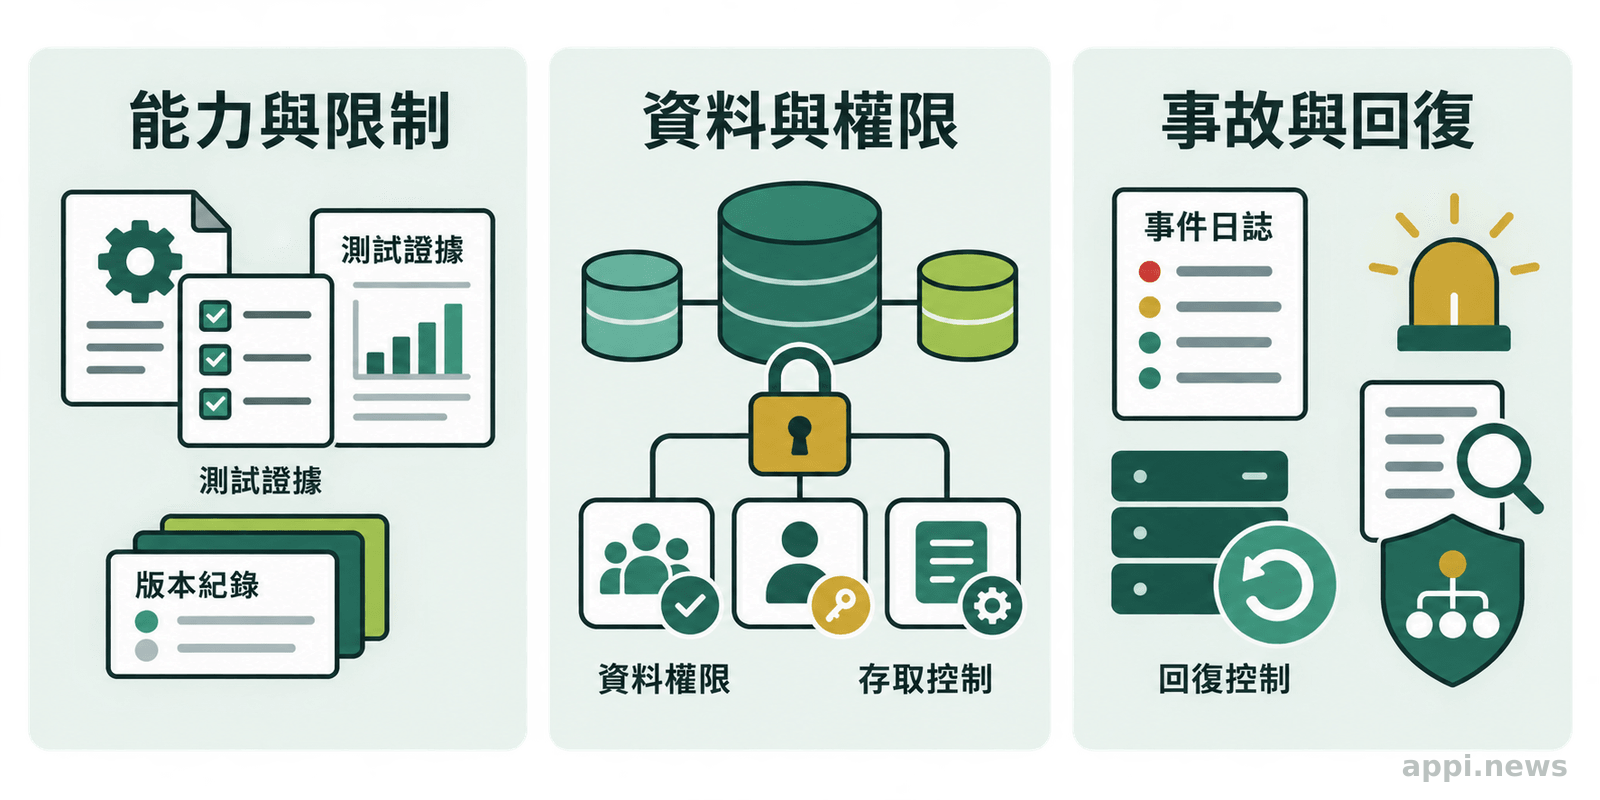
第一類證據是能力與限制。供應商應說明適用任務、已知失誤、測試資料與方法,並交代版本更新是否可能改變輸出。只有單一準確率,企業很難判斷模型是否適合自己的工作流。
第二類證據是資料與權限。採購前要畫出輸入資料經過哪些服務、保存多久、誰能存取、是否再訓練、是否有第三方處理,以及跨境傳輸的地點與依據。涉及客戶、員工、營業秘密或著作內容時,資料分類與授權範圍必須先定義。
第三類證據是事故處理。企業應要求供應商說明事件分類、通報窗口、日誌保存、修補、版本回退、停用與事後檢討方式,並確認事故後能還原模型版本、提示、資料與使用者。
四、AI採購合約要處理哪些責任條款
AI 採購合約應把責任放在可驗證的服務義務、資料使用限制、變更通知、事件通報、賠償與終止機制;責任上限可以分配商業風險,卻不能把法定義務寫成對外宣稱的法律免責。
資料與智慧財產條款要界定輸入資料的處理目的、保存、刪除、再訓練與跨境位置,也要依個案確認輸出及第三方內容的著作權風險。台灣智慧財產局已提醒,生成式 AI 產出與他人著作發生實質近似的可能性不能完全排除,商業使用仍需依個案與授權內容判斷。
服務變更與事件救濟條款要寫明版本更新、重新驗收、事件通報、修補、資料返還,以及高風險場景的人工接管與終止權。
賠償與責任上限屬於商業風險分配;個資、資安、消費者保護、著作權與產業監管等法定義務,仍依準據法與事故事實判斷。合約不能把「供應商願意賠多少」改寫成「法律上不必負責」。
五、台灣企業導入AI的實務檢查表
台灣企業應先定義使用情境與可能影響,再由業務、資訊、資安、法務、採購與資料治理共同確認責任邊界,最後才決定模型與供應商。
台灣的《人工智慧基本法》已把隱私保護與資料治理、資安與安全、透明與可解釋、公平與不歧視及問責列為政府推動 AI 的原則。數發部也以風險分類、情境盤點、風險識別、影響評估與應對作為治理方向。這些原則未必直接替每一個民間導入案提供完整答案,卻能作為企業建立內部審查流程的參考框架。
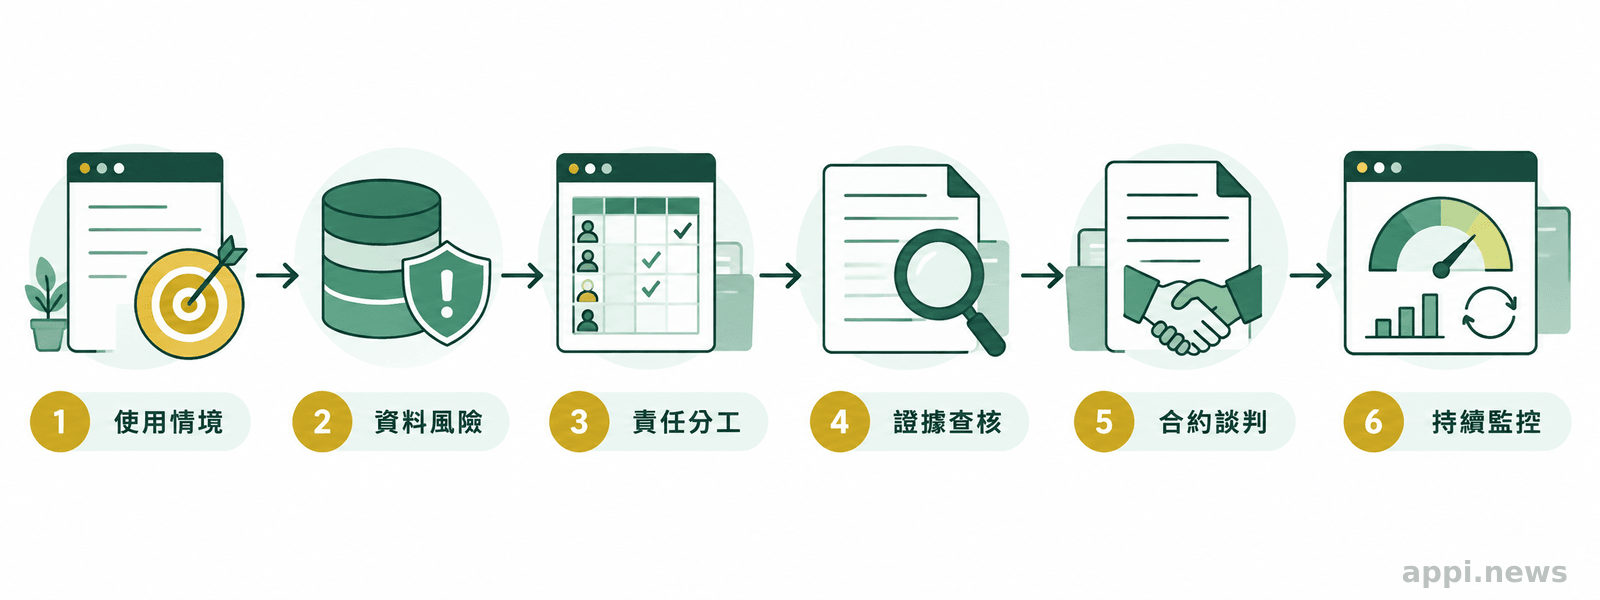
企業可依下列順序開始:
- 畫出使用情境:說明 AI 服務的輸入、輸出、使用者、決策者與受影響對象,並列出不得直接自動化的決策。
- 標記資料風險:區分個人資料、敏感資料、營業秘密、著作與公開資訊,確認處理目的、保存期限、跨境傳輸與第三方再利用。
- 建立責任矩陣:將模型、產品、整合、部署、人工覆核與事故處理逐項指定負責單位,避免只有一個「AI 專案負責人」卻沒有人負責後續行動。
- 要求可查證證據:取得模型卡、評測報告、版本紀錄、權限設計、日誌格式與事件通報流程,並用實際業務資料做驗收測試。
- 完成合約談判:處理資料使用、變更通知、稽核權、賠償、保險、責任上限、服務終止與資料返還,並讓條款與內部控制措施互相對應。
- 安排持續監控:設定錯誤、偏差、資安事件、服務降級與模型漂移的指標,定期檢視是否需要限縮功能、改版、人工接管或停用。
六、企業採購的核心是可管理的責任鏈
企業應把這項政策訊號視為重新檢視責任鏈的提醒,依實際控制能力與使用情境分配風險,並把證據、通報與救濟機制寫進日常治理與採購合約。
- 政策談話提供風險方向,正式法律與具體事實才決定責任效果。
- 供應商審查要看測試、版本、資料流、權限、日誌與事故處理證據。
- AI 採購合約可以分配商業風險,不能把強制法定義務改寫成免責承諾。
常見問題:AI責任與企業導入
最常見的誤解,是把模型供應商的合約承諾當成所有法律風險的終點;實務上仍要回到角色、資料、控制能力、使用情境與適用法規逐項判斷。
常見問題
Q1:美國政府不提供責任豁免,台灣企業會立即受到美國法律拘束嗎?
政策談話不會直接拘束台灣企業;是否適用美國法律,要看所在地、服務方式、準據法、交易對象、資料流與事件。
Q2:AI 出錯時,模型供應商、整合商與使用企業誰要賠?
沒有固定答案,要看誰控制風險環節、做出對外承諾、能預防或發現錯誤,以及契約與強制法定義務如何適用。
Q3:合約寫了責任上限,是否就能免除企業責任?
責任上限通常是商業風險分配,不能自動排除個資、資安、消費者保護、著作權或產業法規義務,也不保證主管機關、受害者或法院接受同一解讀。
Q4:小型企業沒有足夠資源做完整 AI 評測,應該怎麼開始?
先從使用情境、資料類型、人工覆核與停用條件建立最小治理流程,再依影響提高測試與稽核強度。
參考來源
- TechNews 科技新報/中央社 (2026). 美財長:川普政府不會向 AI 開發者提供免責保護
- Tabassi E. (2023). *Artificial Intelligence Risk Management Framework (AI RMF 1.0)*. National Institute of Standards and Technology
- National Institute of Standards and Technology (2024). *Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
- 數位發展部 (2026). AI 基本法
- 經濟部智慧財產局 (2025). 智慧財產局著作權主題網-解釋資料檢索-電子郵件1140625
- 法務部全國法規資料庫 (2026). 個人資料保護法