很多人第一個會想到,親切可愛的介面能讓 AI 代理更容易被接受;但這裡要先問一個更前面的問題:使用者看得出代理實際能做什麼、正在做什麼嗎?介面帶來的好感、使用者對系統的信任、系統在特定任務中的可靠性,以及使用者願意交出多少權限,是四件彼此相關、卻不能互相代替的事。設計產品信任時,應從能力邊界、行動狀態、資料範圍與控制方式逐項檢查。
一、親切介面帶來好感,使用者信任的問題還要往下拆
不代表。親切感是互動感受,主觀信任是使用者的判斷,可靠性要看系統在指定任務與條件下是否正確運作,授權意願則是使用者願意允許哪些資料存取或操作。
TechNews 於 2026 年 10 月 10 日報導,多家科技公司為 AI 助手加入可愛角色與人格化呈現,也整理外界對使用者可能高估可靠性、交出更多資料的疑慮。
報導提到 OpenAI、Meta 與 Anthropic 的角色設計,也引述品牌顧問對親切形象降低心理門檻的看法。這些是報導整理的產業觀察,不能直接當成所有使用者都會因此放寬權限的實驗結論。產品團隊可把它當作一個設計問題:角色表現出的親近感,會不會遮住系統能力和風險資訊?
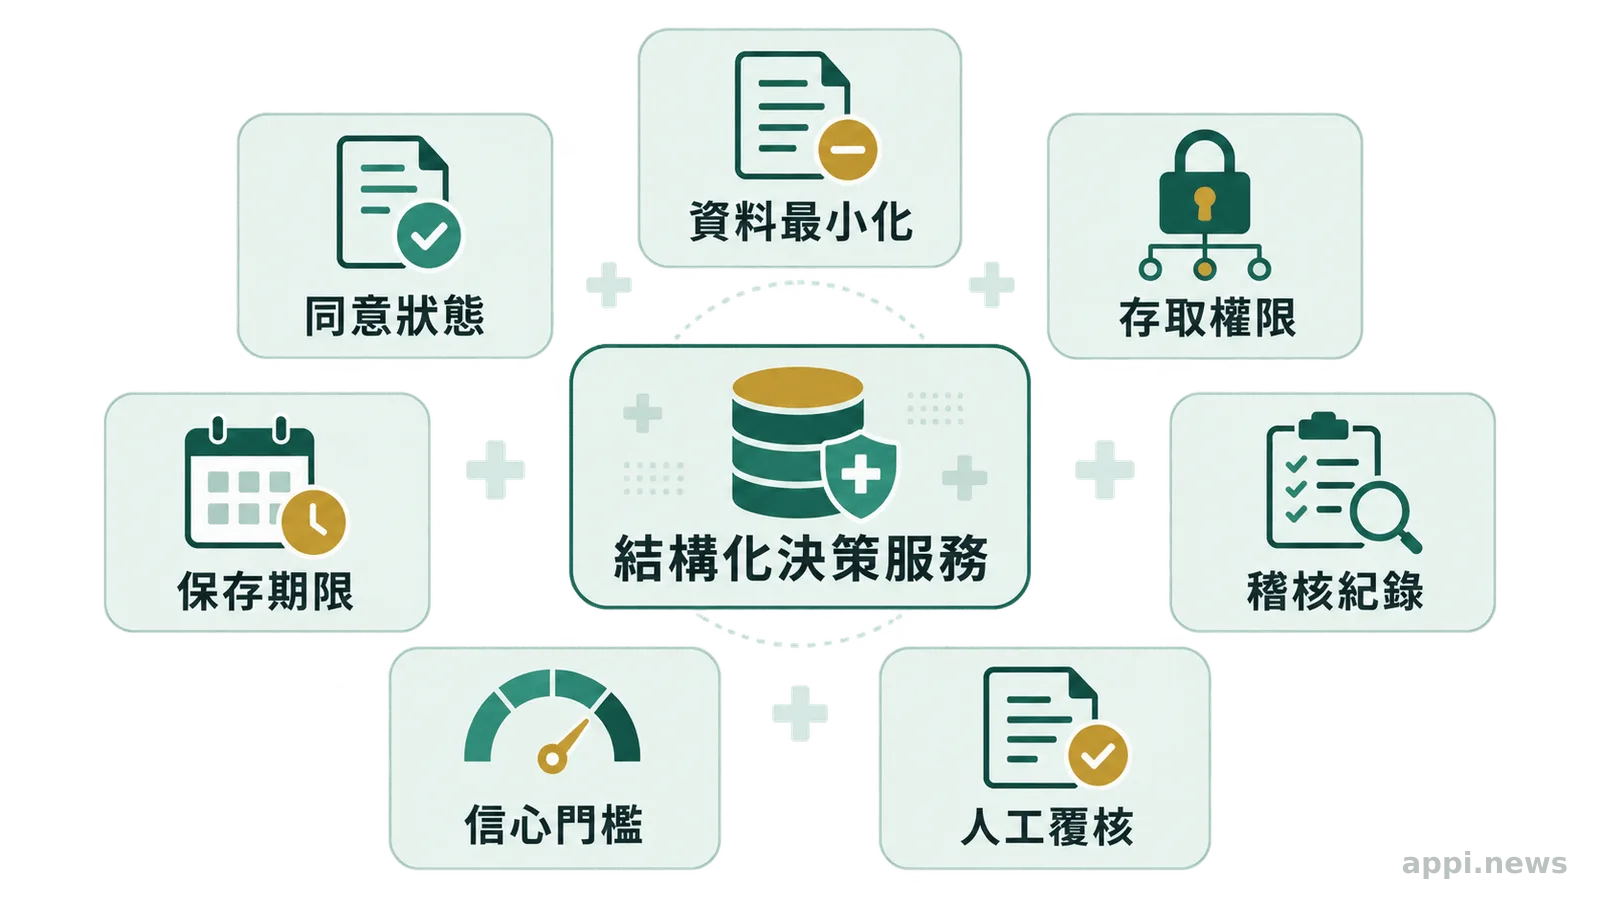
四個概念要分開看:好感是互動感受,信任是對能力的判斷,可靠性依任務表現評估,授權則決定代理能讀取或處理哪些資訊。使用者即使表示信任,也未必清楚代理能否讀檔、寄信或對外發布。
二、為什麼外觀與互動方式可能改變使用者的判斷?
可能影響信任形成與維持,但研究結果依代理特徵、任務和情境而異。現有研究提供了值得注意的線索,尚不足以證明可愛造型必然讓所有人過度信任具工具操作能力的 AI 代理。
de Visser 等人在 2016 年的三項實驗中,讓參與者接收可靠性逐漸下降的建議,來源分別呈現為電腦、虛擬角色或真人。研究發現,擬人化代理在信任受損時呈現較高的信任韌性,而且這種差異在不確定性較高時更明顯;加入類似人類的信任修復行為後,不同代理間的差距也縮小。這項研究討論的是特定自動化代理與建議任務,並未測量使用者是否會把電子郵件、雲端檔案或付款等工具權限交給現代 AI 代理。
其他研究也呈現不同結果。Cockram、Bartlett 與 McCarley 於 2023 年研究自動化決策輔助,使用者在多項機率訊號判讀任務中,獲得一個可靠度設定為 93% 的代理協助。研究沒有發現不同擬人化條件確實造成參與者對人性特徵的感知差異,也沒有發現擬人化提升信任或人機團隊表現。這提醒設計者,若操作只改變表面外觀,使用者未必感受到預期差異,結果也不必然反映在信任或績效上。
“Anthropomorphic agents were associated with greater trust resilience, a higher resistance to breakdowns in trust.” 這項結果來自特定實驗中的自動化代理與建議任務,不能直接推廣到所有 AI 產品。— de Visser 等人,2016
三、信任落差會在哪些權限與操作環節形成?
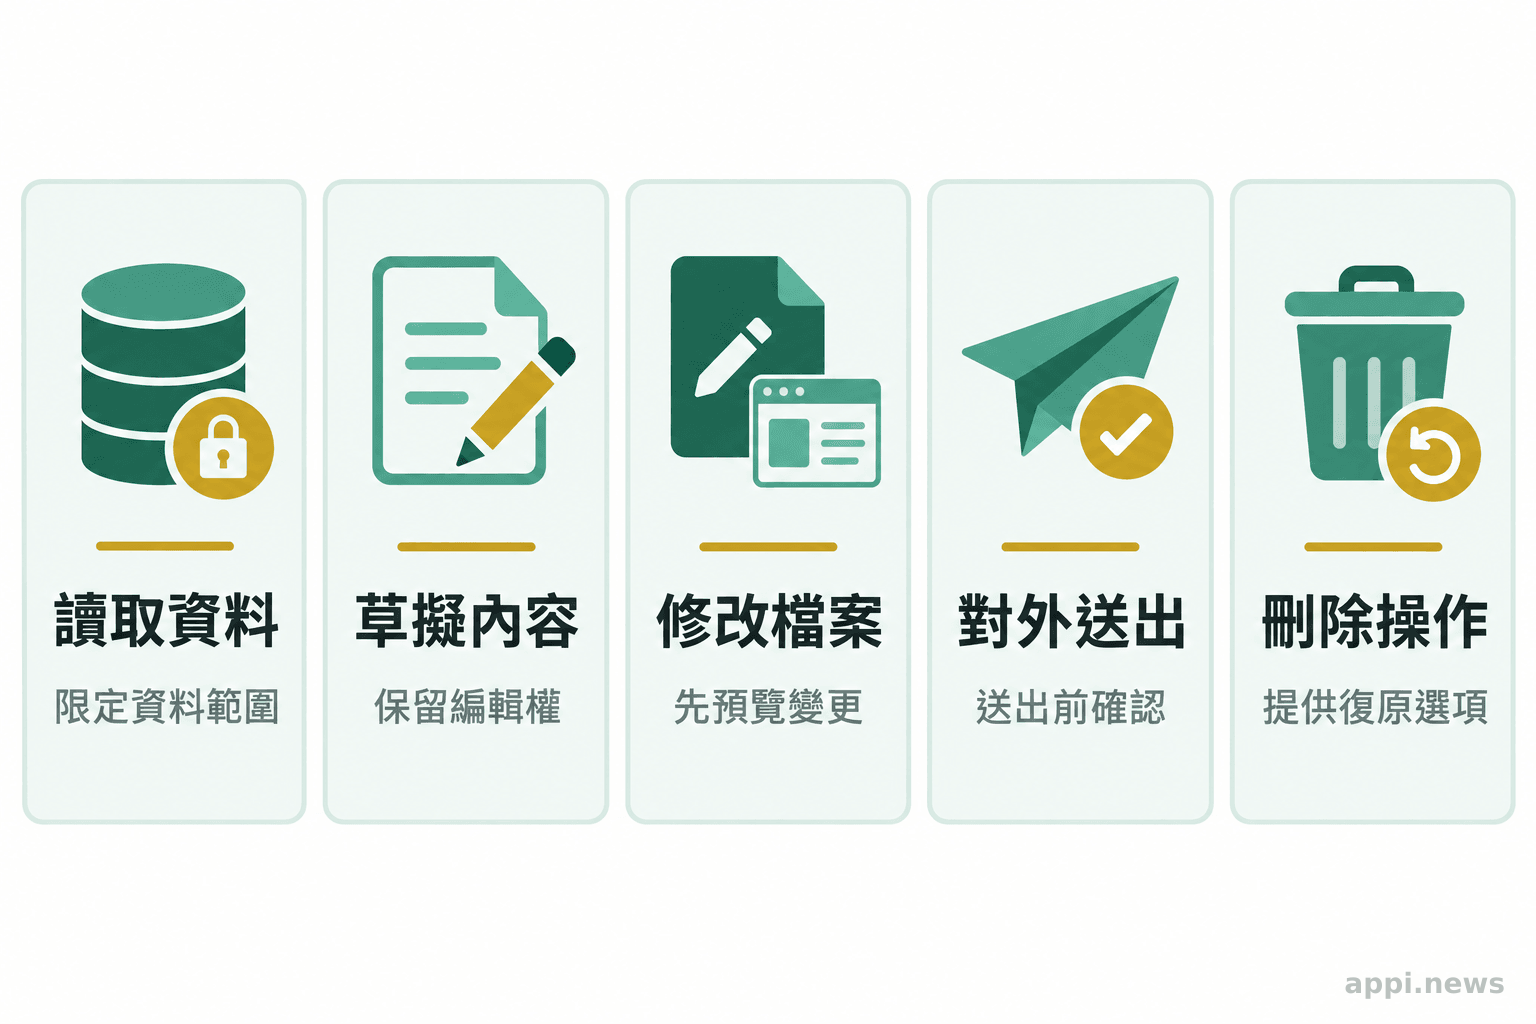
風險容易出現在使用者看不清資料範圍、代理狀態和操作後果的地方。產品需分別說明代理可以讀取什麼、可以草擬或修改什麼,以及是否能對外送出或刪除內容。
第一個環節是資料讀取。按下「連結工作空間」時,使用者可能不知道授權涵蓋單一文件、整個資料夾或未來新增的檔案,也不清楚資料是否送往外部、保存多久。介面應列出來源、範圍、用途與管理方式。
第二個環節是代理狀態。「我來處理」可能代表整理資料、產生草稿、修改檔案,甚至寄出內容。介面應明確標出「正在搜尋」、「草稿待確認」、「正在送出」等階段,讓使用者知道何時仍能介入。
第三個環節是操作後果。草擬郵件可先檢查,寄信會傳出資訊,修改共享文件會影響他人,刪除資料也可能難以恢復。這些動作不應共用「已授權」狀態;讀取行事曆也不等於可以取消會議或寄出邀請。
| 操作類型 | 使用者需要看見的資訊 | 可採用的控制方式 |
|---|---|---|
| 讀取資料 | 來源、範圍、用途、保留方式 | 逐來源授權、檢視與撤回存取 |
| 草擬內容 | 使用的資料、草稿位置、尚未送出 | 顯示草稿、提供修改與丟棄選項 |
| 修改或覆寫 | 受影響檔案、變更內容、可否復原 | 變更預覽、版本紀錄、確認後套用 |
| 對外送出 | 收件人、內容、發送管道與後果 | 送出前確認、取消時限、執行紀錄 |
| 刪除或取消 | 影響對象、資料範圍、復原可能性 | 額外確認、回收區或復原流程 |
四、產品介面如何讓能力、行動與權限看得懂?
以具體動詞、清楚範圍和可見狀態呈現代理能做的事,並依操作影響提供不同控制。使用者應能理解目前授權的目的,也要知道哪些動作仍待本人決定。
先把能力說明寫成可檢查的句子。像「協助處理郵件」很難判斷範圍,可改成「讀取你選擇的郵件,整理摘要並草擬回覆;未經確認不會寄出」。若產品確實能寄送,就應在同一處指出可用帳號、收件人選擇方式,以及是否逐封確認。用「代你安排」或「全權處理」這類籠統承諾,容易讓讀者無法分辨建議、準備和執行。
接著按影響程度安排確認。確認提示應指出即將執行的動作和受影響對象,例如「將這封信寄給王小姐,並附上檔案 X」,讓使用者能檢查收件人與附件。僅問「要繼續嗎?」資訊不足,使用者可能在不理解後果的情況下按下同意。對已經準備好、可撤回的草稿,介面可讓使用者直接編輯;對大量變更或刪除,則可增加預覽、再次確認或復原安排。
| 設計面向 | 使用者需要理解 | 可檢查的介面問題 |
|---|---|---|
| 能力邊界 | 代理能處理哪些任務,哪些不支援 | 介紹頁是否列出可執行動作與限制? |
| 資料權限 | 代理可讀取哪些來源,資料如何使用 | 同意前是否看得見來源、範圍和用途? |
| 行動狀態 | 建議、草擬、修改、執行或完成 | 使用者能否辨認代理目前在哪個階段? |
| 高影響操作 | 會影響誰、改變什麼、能否復原 | 送出或刪除前是否有具體預覽和控制? |
| 授權管理 | 如何縮小範圍、暫停或撤回 | 授權後是否容易找到管理入口? |
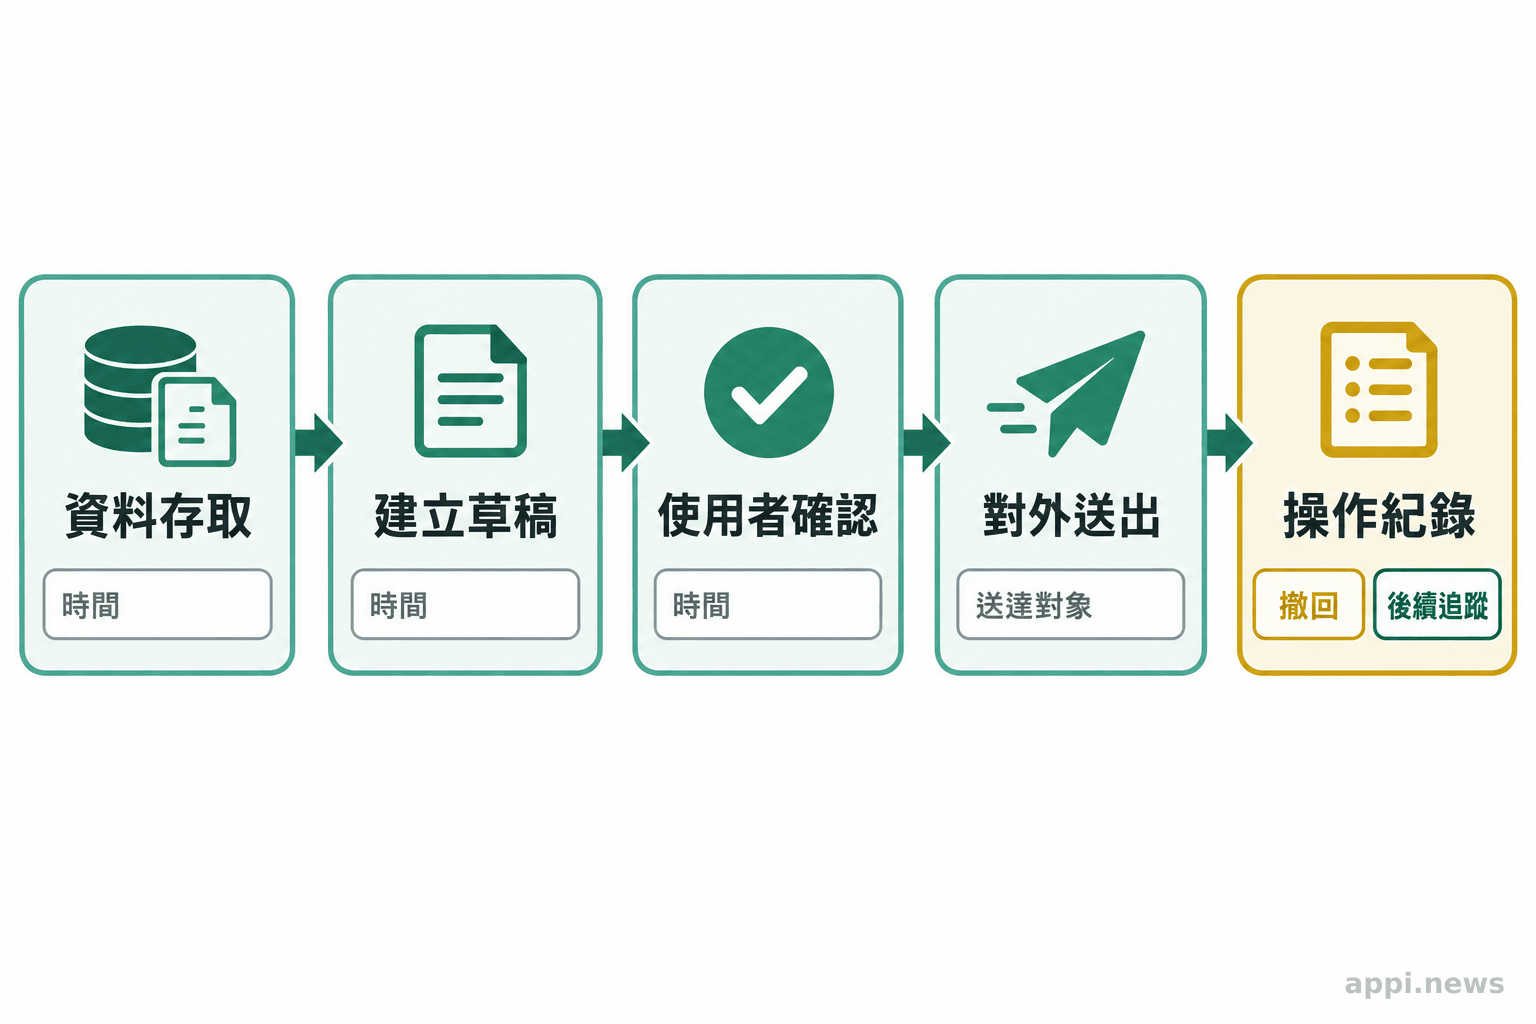
行動紀錄應能追蹤執行時間、資料來源、變更內容和結果去向,並依風險與法規妥善管理保存方式。若代理出錯,使用者需要回報、停止後續任務或要求修正的管道。紀錄不能保證正確,卻能支持追查與補救。
NIST 的 AI 風險管理框架把透明、可靠、安全、隱私與問責列為可信任 AI 的相關特徵。框架也指出,透明資訊應依使用者角色和互動階段調整,而且透明並不等於系統已具備準確性、安全性、公平性或隱私保障。這個區分適合落到介面:提供說明有助於使用者理解和追查,系統本身仍須接受測試、監控與治理。
「透明不代表系統必然準確、安全、重視隱私或公平;但缺乏透明,便難以持續判斷這些特性。」— 美國國家標準暨技術研究院(NIST),《AI 風險管理框架 1.0》意譯
五、評估 AI 代理信任設計時,產品團隊可以檢查什麼?
從具體任務測試使用者能否說出代理的資料範圍、下一步動作和操作後果,再比對介面承諾與系統實際權限。觀察實際理解和行為,比只問使用者喜不喜歡角色更能回答授權是否清楚。
評估時可選一項常見任務,例如「整理幾封客戶郵件並準備回覆」。請參與者在執行前指出代理會讀哪些郵件、草稿放在哪裡、是否會自動寄出,以及如何中止。若使用者把「草擬」理解成「已寄出」,或以為只能讀取單封郵件但實際權限涵蓋整個信箱,團隊就能定位問題出在用詞、授權流程、系統預設,或權限設計本身。
信任校準指使用者的信任程度能否配合系統實際能力與風險。信任太低可能使有用功能無法採用;信任過高則可能使人跳過檢查或授予過多權限。設計目標不是讓使用者盡可能信任,而是讓使用者知道何時可依賴代理、何時應先查證,以及遇到錯誤時能採取什麼行動。產品更新模型、權限或第三方整合後,原有測試結果也需要重新檢視。
常見問題
Q1: 可愛外觀會讓使用者必然過度信任 AI 代理嗎?
目前研究不能支持「必然」這種結論。部分研究在特定任務中觀察到擬人化與信任韌性有關,也有研究未發現表面擬人化提高信任或表現。產品仍須依實際介面、任務風險和使用者行為驗證。
Q2: AI 代理每個動作都要使用者確認嗎?
不一定。讀取、草擬、修改、對外送出和刪除的影響不同,應依資料敏感度、操作可逆性、受影響對象和任務風險安排控制。需要確認時,提示應說明具體動作與對象。
Q3: 使用者已同意一次,是否代表之後所有用途都獲授權?
不能只憑一次同意推定所有用途。資料讀取、內容草擬與對外執行是不同操作;使用者應能理解各自範圍,並找到暫停、縮小或撤回授權的方式。
Q4: AI 代理權限設計涉及藥物或營養補充品交互作用嗎?
不涉及藥物或營養補充品交互作用。
六、信任設計回到可理解與可控制的實際使用情境
先確認使用者能否在授權前說清楚代理會讀取什麼、準備或執行什麼,以及如何停止或撤回。再依操作影響補上確認、紀錄和復原方式,並驗證介面承諾符合實際系統權限。
若角色外觀可愛、語氣友善,使用者可以因此覺得互動舒服;產品團隊仍要確認這份好感不會掩蓋能力限制。現有研究多集中在對話代理、一般自動化代理或特定實驗任務,並不一定直接測量使用者如何授權可操作工具的 AI 代理。研究樣本、介面線索、任務風險和測量方式都會改變結果,不能把關聯或實驗情境中的發現擴大成所有產品的因果結論。
產品團隊可從一項具體任務開始檢查:使用者能否在授權前說出代理將讀取哪些資料、執行哪些動作,以及如何停止或撤回?如果答案含糊,就回頭調整動詞、權限範圍、狀態提示與確認流程。再看操作完成後是否有紀錄可查,出錯時是否能取消後續任務、復原變更或尋求協助。信任才能落在使用者理解得到、也控制得到的實際流程上。
- 介面好感、主觀信任、系統可靠性與授權意願是不同概念,應分開評估。
- 權限需區分資料讀取、內容草擬、修改、對外送出與刪除,不能用單一同意涵蓋所有用途。
- 高影響操作應呈現具體對象、後果與可用控制;重要行動也要能追蹤、撤回或復原。
- 擬人化研究結果受任務和情境限制,產品應以自身使用情境測試使用者理解與行為。
參考來源
- TechNews 編輯台(2026)。科技巨頭 AI 產品大打「可愛牌」,盲目信任恐引發資安危機。TechNews 科技新報
- de Visser EJ, et al. (2016). Almost human: Anthropomorphism increases trust resilience in cognitive agents. *Journal of Experimental Psychology: Applied*, 22(3), 331–349
- Cockram L, Bartlett ML, McCarley JS. (2023). Simple manipulations of anthropomorphism fail to induce perceptions of humanness or improve trust in an automated agent. *Applied Ergonomics*, 111, 104027
- National Institute of Standards and Technology. (2023). *Artificial Intelligence Risk Management Framework (AI RMF 1.0).