
Rempa 團隊把買家問題交給 ChatGPT、Gemini 與 Google AI Mode。同題回答中,ChatGPT 與 Gemini 平均只有 8.3% 的引用網站重疊,52% 沒有共同網站。這是人工智慧(AI)助理的特定市場測試,但這裡要先問一個更前面的問題:網站清單不同,能說明答案中的哪些主張?
先分開檢查「答案是否正確」和「引用是否支持答案」。系統如何檢查來源與主張,可參考 MCP 代理進行來源驗證時仍需要人工把關;一般讀者也能回到原始頁面核對。
Gemini 與 ChatGPT 的引用網站,為什麼可能不一樣?
現有比較觀察到兩者在特定買家問題上的來源重疊有限,但研究沒有證明差異由哪一項技術機制造成。題目、搜尋結果、服務版本和單次回答都可能影響輸出,原因不能只憑引用清單推定。
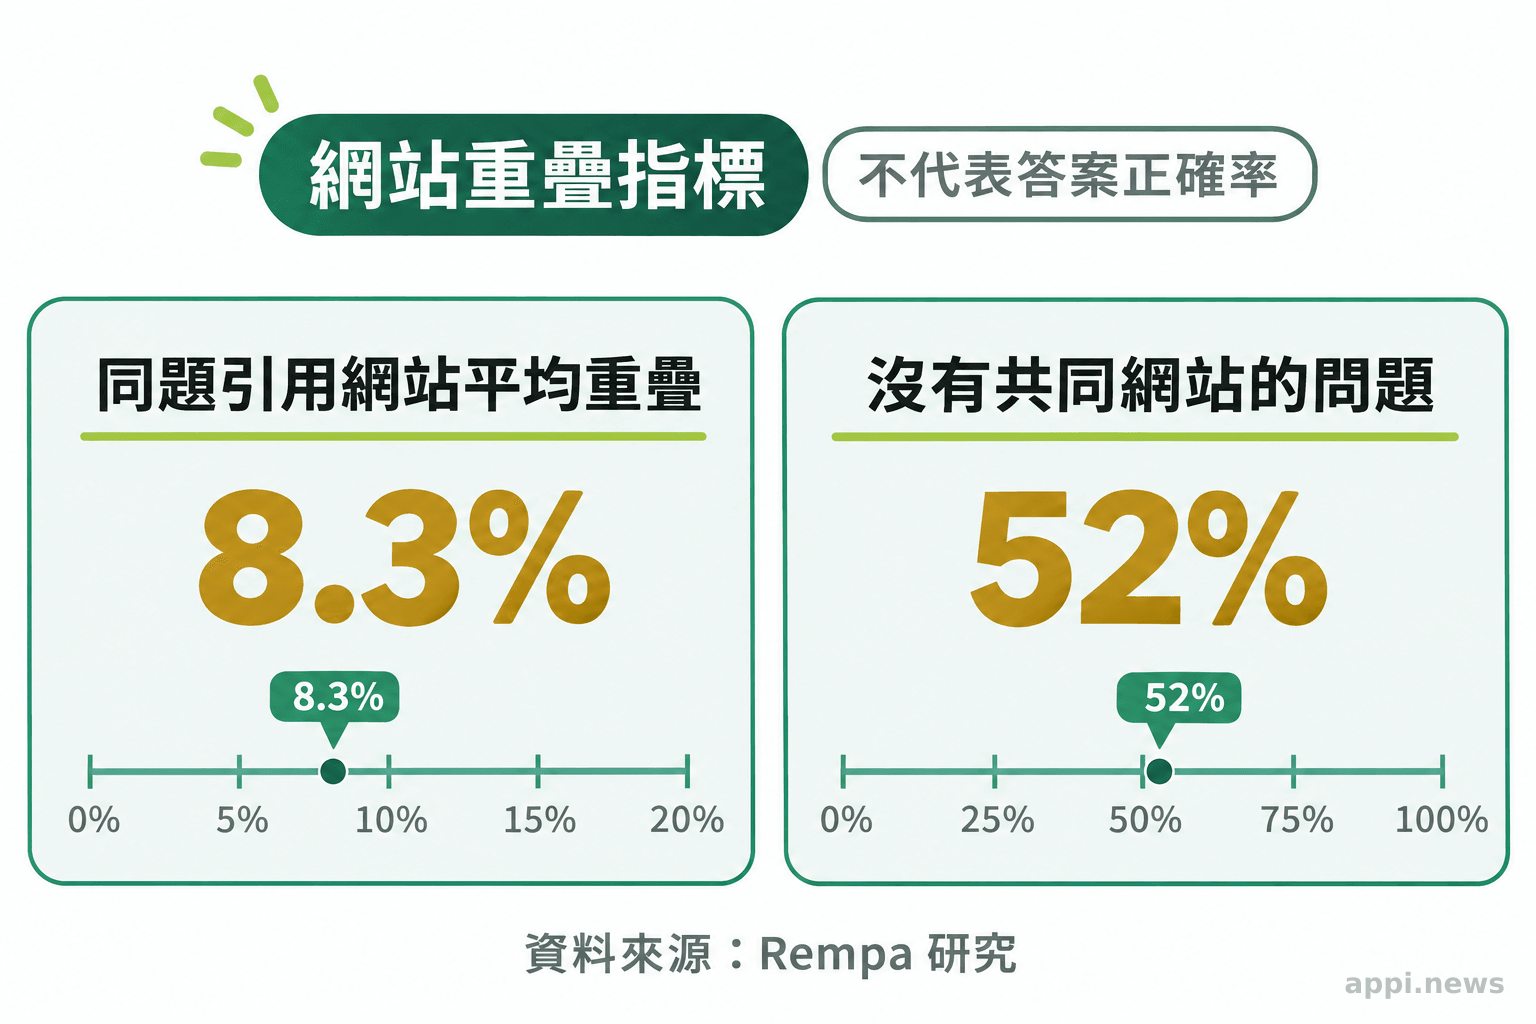
Rempa 團隊於 2026 年 10 月 12 日至 28 日,蒐集 221 次品牌稽核的 7,911 個回答,涵蓋 2,650 個買家問題及五個市場。
每題各模型只問一次,並將回答網站去重後比較;同題來源平均重疊 8.3%,52% 沒有共同網站。這是網站重疊比例,不是答案正確率或立場相反比例。研究報告載有完整測試說明。
樣本來自 Rempa 客戶稽核,品牌多為中型企業且以法國市場為主;每題每個模型只問一次,重問可能得到不同回答。因此,結果不能代表台灣中文提問,也不能解釋模型選源差異的原因。
Rempa 研究方法摘要(意譯):每題只向各模型提問一次,研究結果未涵蓋同題重複提問時的變化。
比較模型搜尋與引用表現時,也要記錄版本與使用條件;Gemini 搜尋能力與來源條件的比較整理了入口和情境的影響。
這些比例應該怎麼讀?
8.3% 是同題引用網站的平均重疊比例:研究先將各回答網站去重,再逐題比較共同網站。它不能換算成答案可靠率或內容相異率;相同網站可能被不同方式解讀,不同網站也可能支持同一主張。判讀時要確認分母、比較單位和測試條件。
引用來源不同,能說明答案不可靠嗎?
來源不同只能顯示來源清單有差異;判斷答案仍須核對具體主張是否有證據支持。
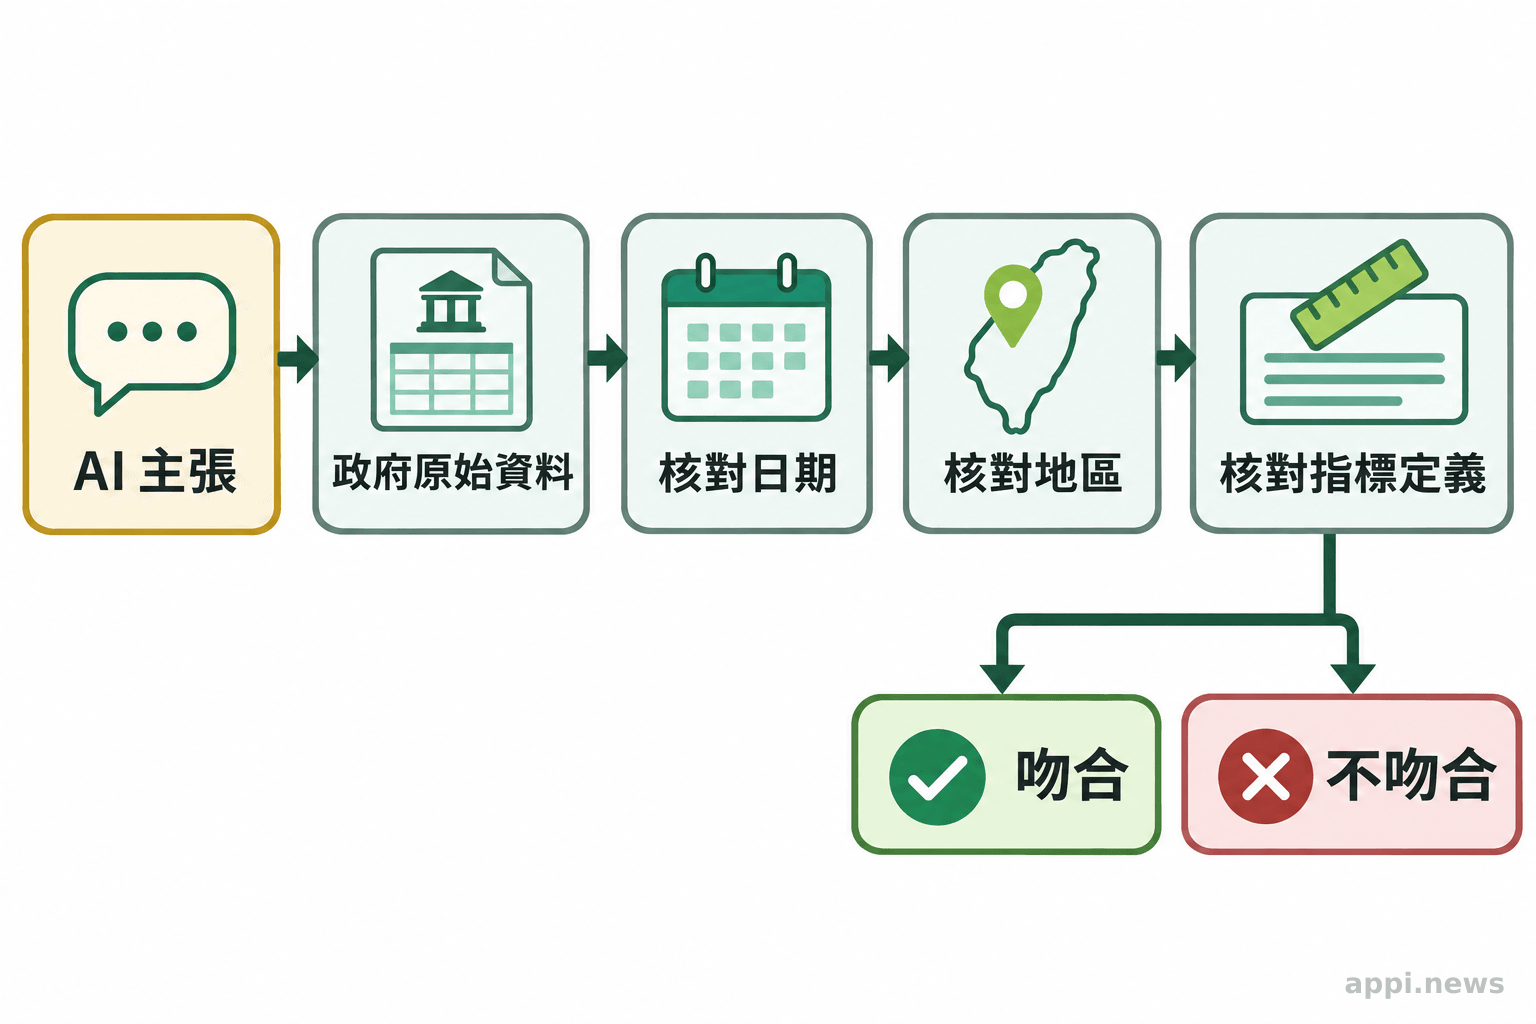
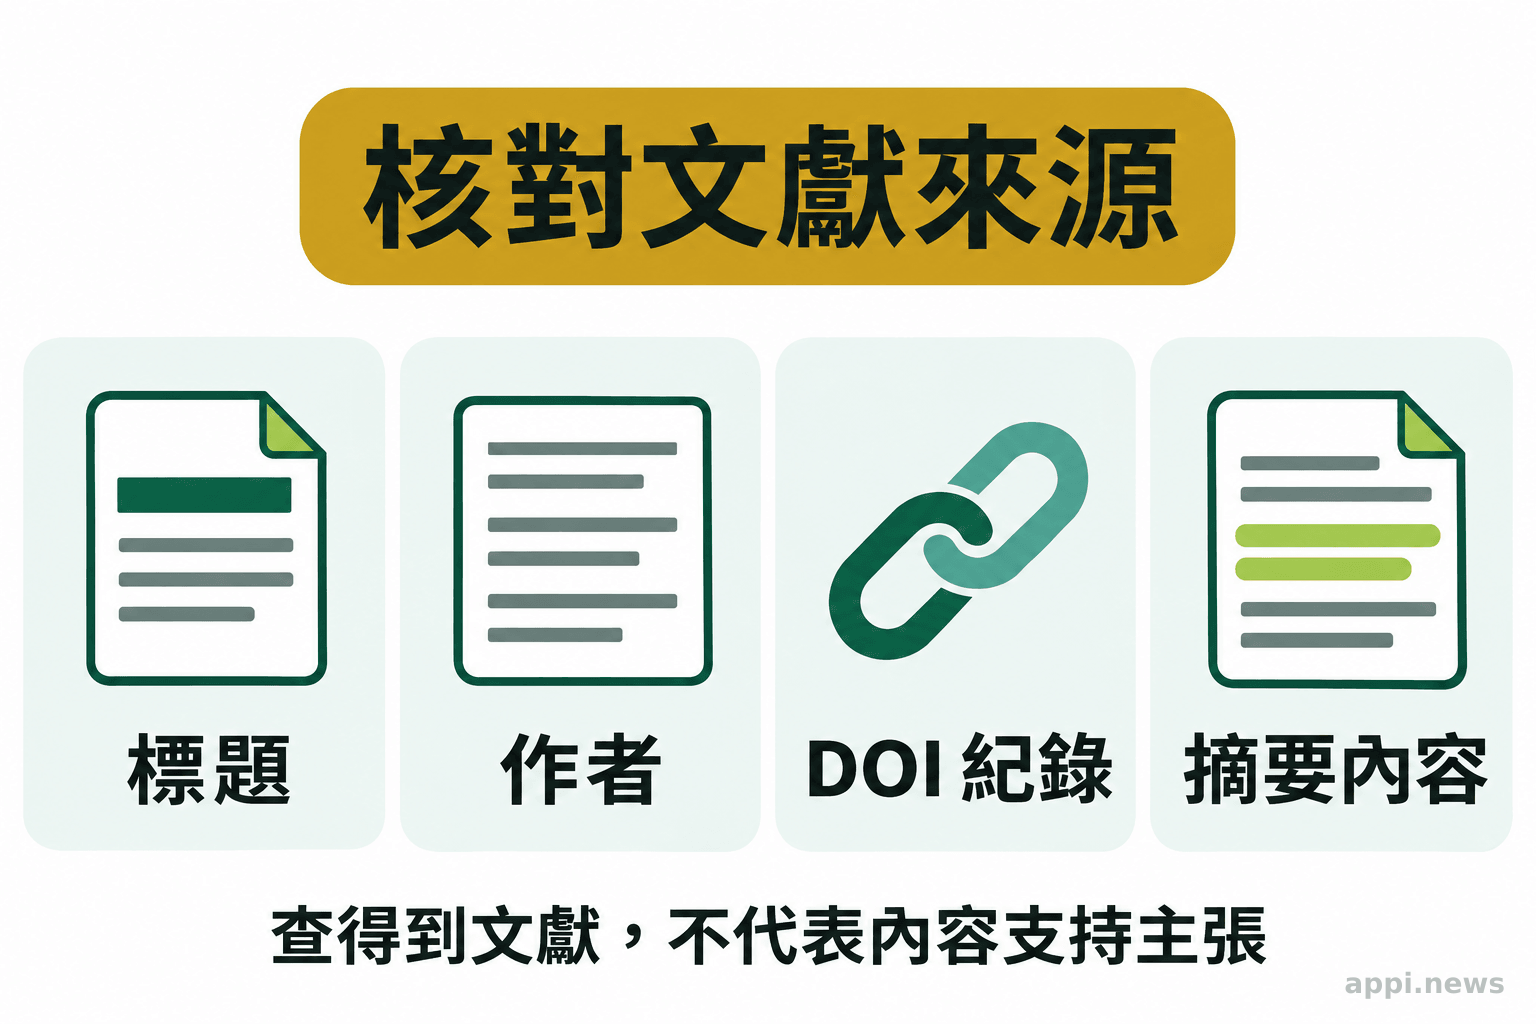
核對時分成兩件事:答案是否符合事實,以及來源是否真的包含這項事實。列出機關網站不代表正確讀懂資料,列出期刊也不代表引文存在或結論吻合。
答案也可能正確,但連結沒有直接支持該句。即使來源熟悉或連結很多,也要確認原文談的是相同對象、時間與主張。
Searchable 團隊針對五個美國城市及所屬州設計 106 個地方政治問題,涵蓋犯罪、就業、學校、能源與生活成本;題目以不同形式各問五次,再由研究者對照政府資料。
7,449 個回答中有 610 個與官方數據矛盾,占 8.2%。報告全文說明,這是美國地方政治測試,不能視為一般或台灣查詢的錯誤率。
四個助理作答時讀取 43,079 個網頁,約 62% 是政府網站,回答仍與官方數據矛盾。使用官方網站核對時,也要比對年份、地區與指標定義,避免摘要把比較方向說反。
引用存在與引用準確性是兩件事
不代表。應打開頁面,確認文獻或網頁確實存在,且內容支持答案中的主張。
Pastucha 等人用 25 個耳鼻喉科指引主題測試 3 個 ChatGPT 與 3 個 Gemini 版本,連續三天詢問,再查核 1,947 筆參考資料。作者姓名和 DOI 常出錯;該研究中,開啟網路搜尋的 ChatGPT-4.1 準確度為 51%,Gemini 2.5 Pro 為 41%。這是書目查核案例,不是一般網頁引用率。研究摘要列有方法與結果。
結果受模型版本、醫學領域題目與查核方法限制,不代表目前版本表現。這項研究檢查書目資料是否正確;Rempa 比較的則是兩個助理是否引用相同網站,兩者回答不同問題。
Pastucha 研究結論摘要(意譯):這些結果可作為評估 AI 文獻檢索的參照;用於學術或臨床前,仍需進一步驗證。
AI 引用來源查證:先比對主張與原文
先把回答拆成能逐項確認的主張,再開啟引用原文核對關鍵細節。若頁面不能直接支持該句,就把它標成未驗證,繼續找原始發布單位或獨立來源。
例如「某項政策已於今年生效」,可拆成發布機構、日期、地區、指標與數值,再對照頁面段落或表格。若引用只有首頁或轉述,沿連結回到原始公告、統計表或研究全文。
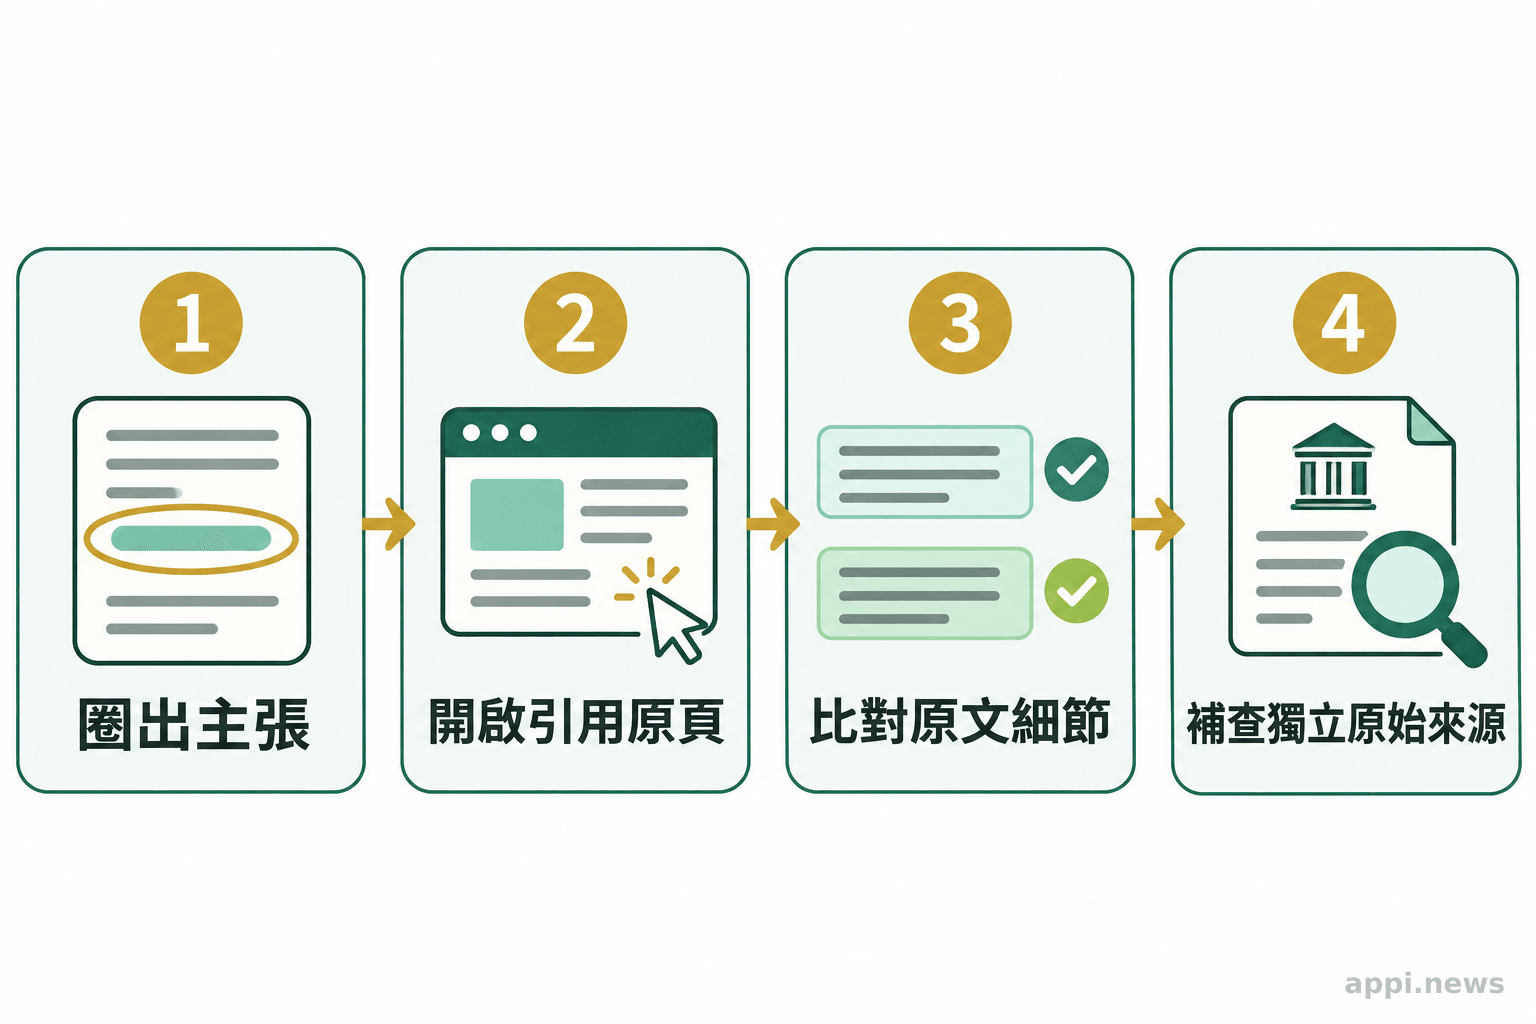
四個可直接使用的檢查步驟
- 圈出可驗證主張:先挑會影響決策的數字、因果、政策狀態、風險或時間敘述,避免一次查整篇回答。
- 開啟引用原頁:確認頁面標題、發布機構與作者;不要只看 AI 顯示的摘要或搜尋結果片段。
- 逐項比對內容:核對原文是否支持同一個數值、日期、族群、地區與因果方向,也留意資料適用範圍和更新日期。
- 依影響程度補查:重要或可能造成損失的資訊,回到政府、研究原文或服務提供者的正式文件,必要時再找另一個獨立來源交叉確認。
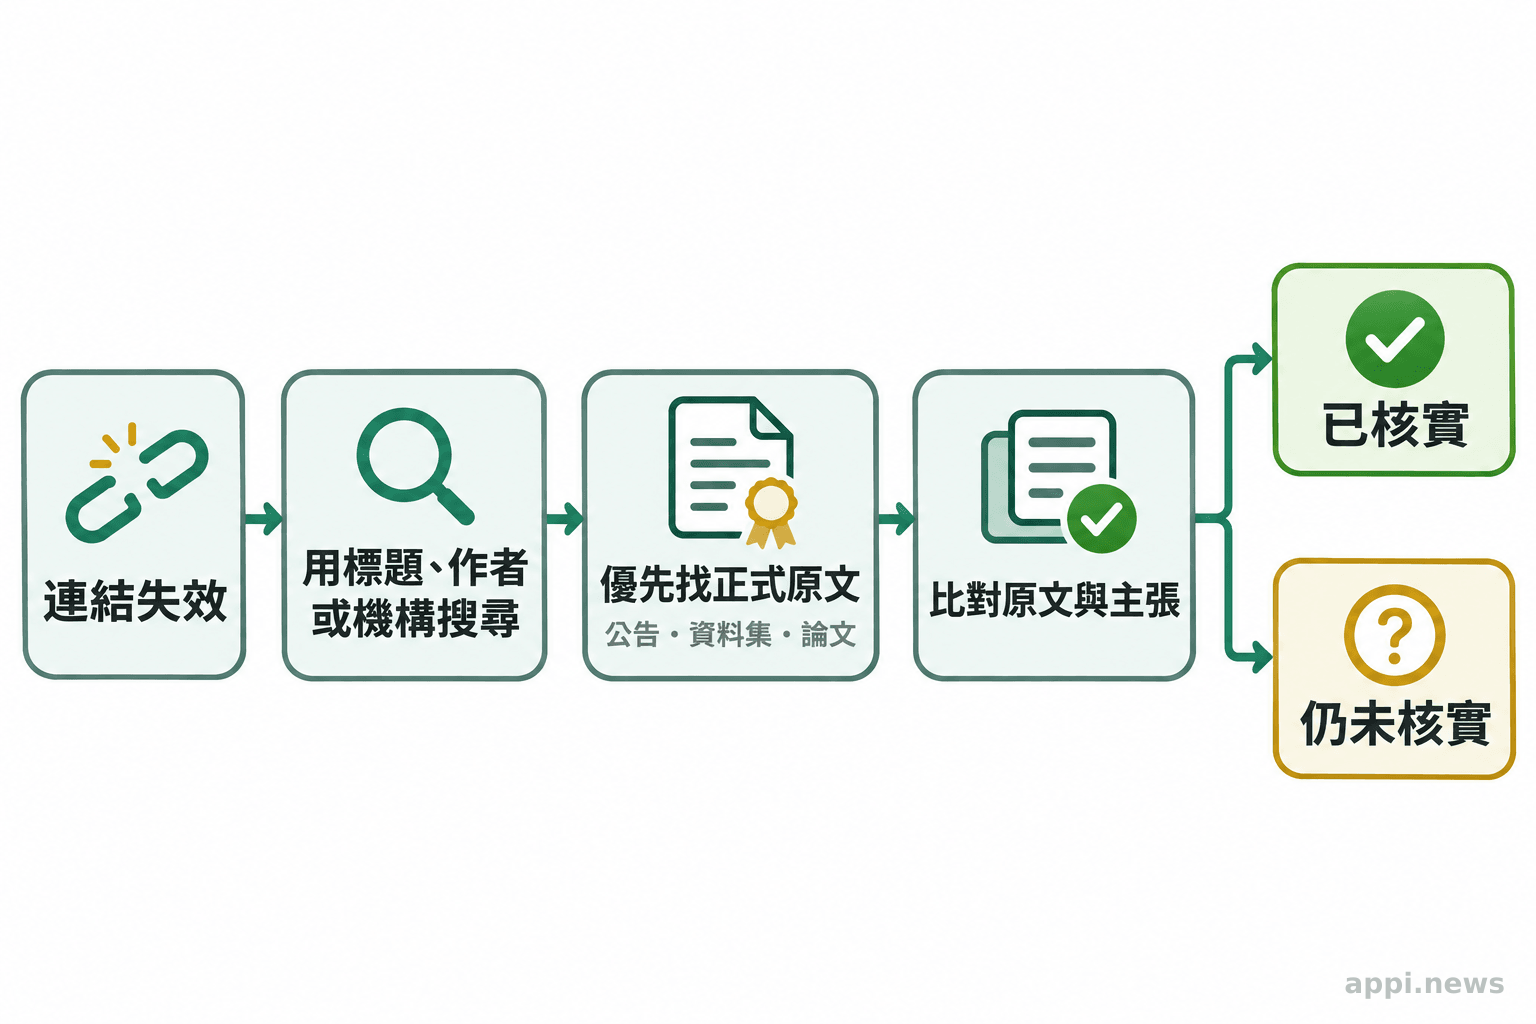
連結打不開時,用標題、作者或機構名稱找正式頁面;仍無法核實,就標記「尚未確認」。記下查詢原句、模型版本、日期、來源與核對結果,方便日後辨認答案或原始資料是否更新。
日常查詢與重要決策,核對深度不同
一般背景知識可先確認一項關鍵主張及原始來源。健康、法律、財務、公共安全或權益資訊,則要核對完整適用條件,再找獨立來源確認;必要時詢問合格專業人員。查核深度依資訊影響調整。
兩個模型引用同一網站,只是一條線索,不能當成兩份獨立證據。查資料時先挑一項重要主張,開原文比對,再按影響程度補查。
- 引用網站不同,只能說明來源清單有差異,不能直接判斷答案孰真孰假。
- 網站權威或引用較多,不能取代原文核對;確認日期、範圍、數值和因果方向。
- 高影響資訊回到第一手資料,必要時再找獨立來源交叉查證。
常見問題
Q1:兩個 AI 都引用同一網站,答案就一定可靠嗎?
不一定。要開啟原頁確認它有沒有支持答案中的具體說法,也要看資料日期和適用範圍。相同網站可能只是兩個回答共同使用的線索,不能視為兩份獨立驗證。
Q2:AI 引用的連結打不開時,可以怎麼查?
用頁面標題、作者或發布機構名稱尋找正式版本,並優先查原始公告、統計資料或論文。若仍找不到,就把這項主張列為未核實,不要只憑 AI 摘要採信。
Q3:哪些資訊應回到政府或原始發布單位確認?
政策是否生效、法規條文、政府統計、產品安全通知、醫療或財務等高影響資訊,都應找發布單位的原始文件。再依問題重要性補查另一個獨立來源,或詢問合格專業人員。
參考來源
- Rempa Team (2026). *What ChatGPT, Gemini and Google AI Mode Cite: 32,000 Sources Analysed*. Rempa
- Lahey C, Garbaccio JP (2026). *AI Misinformation Report: US Midterm Elections*. Searchable
- Pastucha M, et al. (2026). *Reference Accuracy in Large Language Model Chatbots: A Metric for Inherent Misinformation?* *Medical Science Monitor*, 32, e950916


