
Sean Trott 與 Pamela Rivière 用 4,724 段英文文本評估 GPT-4 Turbo、GPT-4o mini,並讓 59 人評讀改寫稿。模型評分與人類判斷相關,Turbo 也能調整難度,但仍有判斷差異無法解釋。Trott 與 Rivière 在 2024 年 TSAR 研討會論文《Measuring and Modifying the Readability of English Texts with GPT-4》中指出,文字看來簡單不等於讀者已理解。
紐約大學與德州大學奧斯汀分校研究者在 2026 年 10 月預印本分析九個模型各檢查五個公開 GitHub 專案的 45 次協作,以及 120 段聊天與生成文章,整理出六種語言模式。模型常見低頻詞組及無生命主詞搭配有生命動詞;論文尚未經同儕審查,也沒測讀者理解。
研究看到的落差:回答正確,讀者仍要多做一步
部分 AI 模型較常使用與處理負擔相關的表達。 這些特徵可供編輯複核,實際影響仍須測試。
研究分別分析 120 段聊天、45 次程式協作紀錄,以及模型文章和學生作文。模型輸出也與人類語料、英譯日再譯回英文的版本比較;聊天和程式輸出中,多項特徵在回譯後減少,文章情境變化較小。研究量測文本特徵,未測客服使用者能否完成下一步。
Stone、von der Malsburg 與 Vasishth 讓讀者閱讀長距離依存句,並改變中間資訊的詞彙確定性。眼動結果未見中性資訊單因時間經過造成活化衰退;延遲影響可能還取決於中間內容是否確認預期或增加工作記憶負荷。編輯仍須檢查讀者能否辨認句中關係。
人類也會使用這些句型,產品評估仍須看讀者能否完成任務。可參考生成式 AI 導入流程與人工覆核。
六種文本特徵,分別把閱讀卡在哪裡
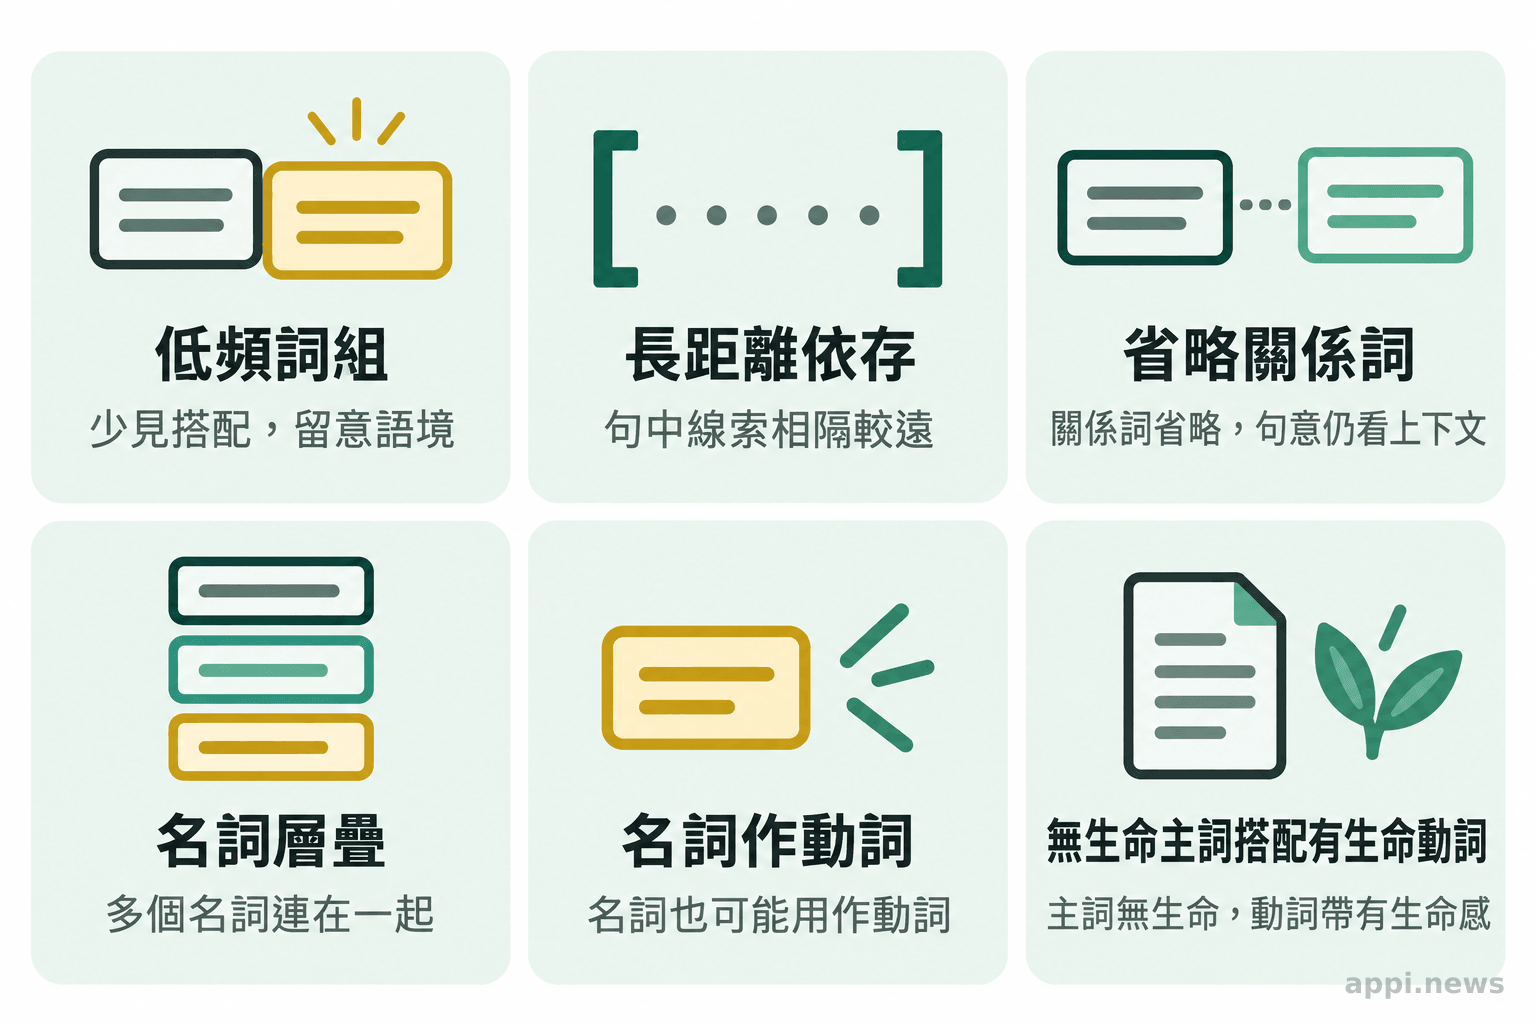
六種特徵包括低頻詞組、長距離語法依存、省略連接詞的受詞關係子句、名詞層疊、名詞轉成動詞,以及無生命主詞搭配有生命動詞。 它們是英文文本的形式線索,可提醒編輯檢查讀者是否需要回讀或補出關係。
低頻詞組是參照語料中少見的連續用詞。下文英文例句均為作者自造,不是研究原始語料。單字熟悉、組合陌生,讀者可能需要停下來理解;在特定領域少見不等於難懂。
長距離依存是相關成分相隔較遠,例如主詞和動詞間插入修飾,讀者須暫存前文。編輯應檢查關係是否清楚,不只看句長。
省略英文 that 或 which 等關係詞的受詞關係子句雖較短,讀者仍要辨認成分關係。這是英文特徵,不能直接套成中文規則。
「AI 模型使用這些與處理難度相關的特徵,比回譯產生的改寫文本更頻繁。」Clark、Martin 與 Mahowald 在預印本摘要如此概括。
名詞層疊以數個名詞互相修飾,如作者自造例句 “horror movie soundtrack generator”,讀者得猜測詞間關係。名詞轉動詞則把名詞當動詞,如自造例句 “calendar it”(排進行事曆),可能使讀者重新辨認詞性。
無生命主詞搭配通常描述有生命主體的動詞,例如作者自造的「對話吃掉自己的尾巴」。文學中可能是修辭,在客服或警示文字裡則依任務判斷是否改寫。
上述特徵是複核線索,不代表每例都造成理解問題。編輯應再確認讀者能否回答問題或採取行動;一律改短也可能刪掉必要條件。
模型與任務不同,特徵分布也不同
不會。模型家族、版本與任務的特徵分布有差異,學生文章與程式、聊天文本也不是可互換的比較基準。 團隊應在自己的產品情境取樣。
Claude Opus 5.5 在 21 組「特徵 × 任務」比較的 19 組中,處理難度相關指標低於 Opus 5;8 組的 95% 信賴區間不重疊。這是特徵分布比較,不是整體可讀性分數,也不代表每位使用者都覺得新版更好讀。
資訊密度假說與長度懲罰實驗的界線
不能。它是作者對部分模型文本特徵的解釋,微調實驗只測試特定小模型與句型,尚不足以證明所有模型都受相同訓練目標影響。
「資訊密度,而非成功溝通的壓力。」作者以此提出可能機制:模型若主要被訓練成以較少篇幅完成任務,可能偏向壓縮表達。這是解釋假說,並非讀者理解測試結果。
研究者以 Qwen2.5-1.5B-Instruct 將結構化事件轉成英文句子,在強化學習中懲罰長回答,並以 KL(相對熵)正則化限制模型偏離基礎模型的下一詞分布。這測試任務目標如何改變句型選擇,並非產品使用者研究。
沒有 KL 限制時,兩種含可選 that 的句型在各正向長度懲罰設定中,超過 98% 的生成偏向較短寫法,即使測試句未在訓練資料中。模型仍完成轉換,顯示任務完成與保留人類偏好表達可能分離;小模型與特定句型結果不能推論為普遍根因。
研究模型與語料有限,且未測讀者理解;繁體中文產品須另定指標並驗證。
也也可參考產品選型的 AI 評測方法及摘要來源追溯和錯誤修正流程。
把特徵檢查放進摘要、客服與文件流程
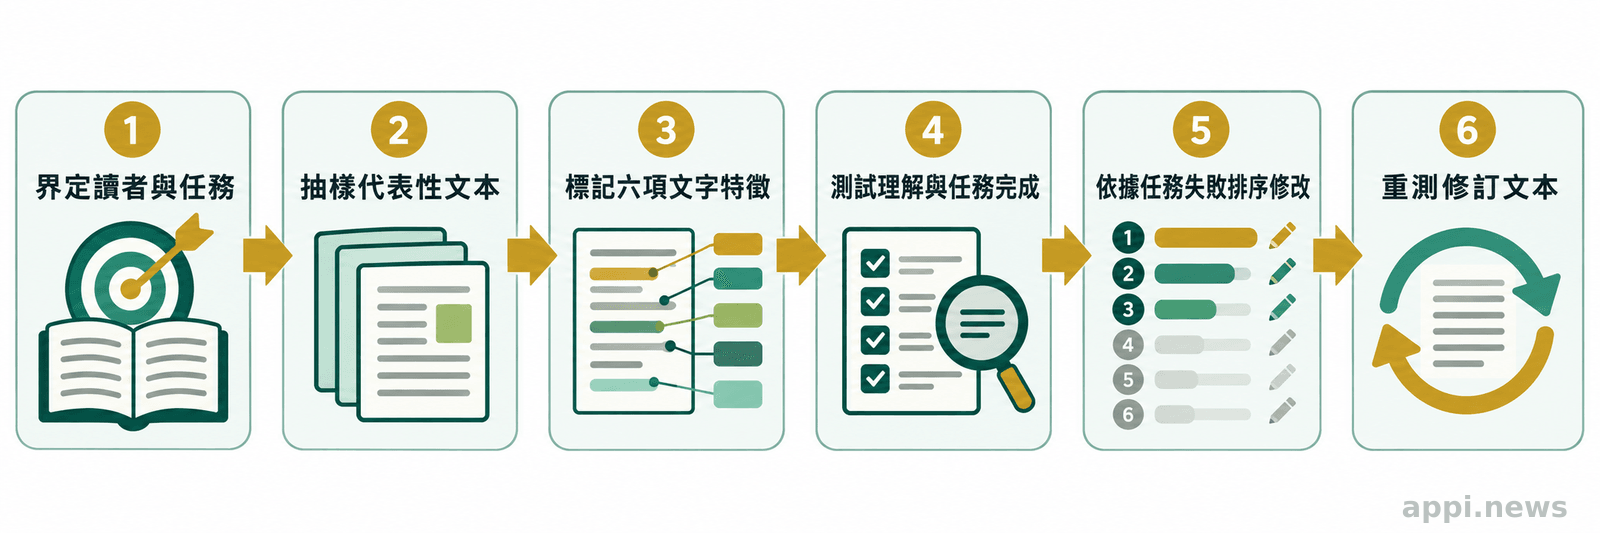
先限定高頻任務,再抽樣標記並安排讀者測試,最後依失誤排序修改。 特徵計數提示複核,理解測試才判斷文字是否妨礙使用。
客服、摘要和文件生成可抽高頻任務,標記候選句,再請使用者找出資料、期限或下一步。記錄答錯、回讀和追問,優先修正反覆伴隨誤解的句子。
- 界定一項任務與讀者:例如新手使用者讀客服回覆後要完成退貨申請,明確寫下成功條件。
- 抽取代表文本:保留問題、上下文與模型答案,包含常見案例及少量邊界情況。
- 標記六種特徵:記錄例句和判斷依據;英文特徵不能直接當成繁體中文規則。
- 安排讀者測試:請目標讀者回答理解問題或完成操作,記錄答對率、時間、回讀和追問。
- 依任務失敗排序修改:先改最常讓讀者誤解、漏做或找不到資訊的文字,再重測修改後版本。
- 六種特徵是編輯複核線索,不能辨識 AI 作者或直接判定理解失敗。
- 研究以英文文本為主,繁體中文產品須另訂判準。
- 是否改善品質,要看目標讀者能否完成任務。
常見問題:六種特徵能辨識 AI 嗎?短句一定比較好讀嗎?
不能。研究提出的是英文文本中與處理難度相關的特徵,並未驗證它們能辨識作者,也沒有直接證明特徵出現就會造成理解失敗。
常見問題
Q1:六種特徵可以拿來判斷一段文字是不是 AI 寫的嗎?
不適合。研究比較特徵頻率,未建立偵測器;人類文字也會出現這些表達。
Q2:短句一定比長句容易理解嗎?
不一定。拆句可能清楚,也可能切散條件或步驟。長度懲罰實驗只測特定模型與設定,應以任務測試判斷。
Q3:這六種模式可以直接用在繁體中文嗎?
不能直接照搬;中文團隊須建立合乎語言與任務的判準,再測試讀者反應。
Q4:資訊密度是 AI 文字難讀的唯一原因嗎?
不是。資訊密度是作者提出的可能解釋,微調實驗只做概念驗證,不能概括所有模型和訓練目標。
參考來源
- Clark TH, Martin MB, Mahowald K. (2026). Why is AI-generated language so hard to understand? *arXiv* preprint arXiv:2610.29162
- Stone K, von der Malsburg T, Vasishth S. (2020). The effect of decay and lexical uncertainty on processing long-distance dependencies in reading. *PeerJ*, 8, e10438
- Trott S, Rivière P. (2024). Measuring and Modifying the Readability of English Texts with GPT-4. *Proceedings of the Third Workshop on Text Simplification, Accessibility and Readability (TSAR 2024)*, 126–134


