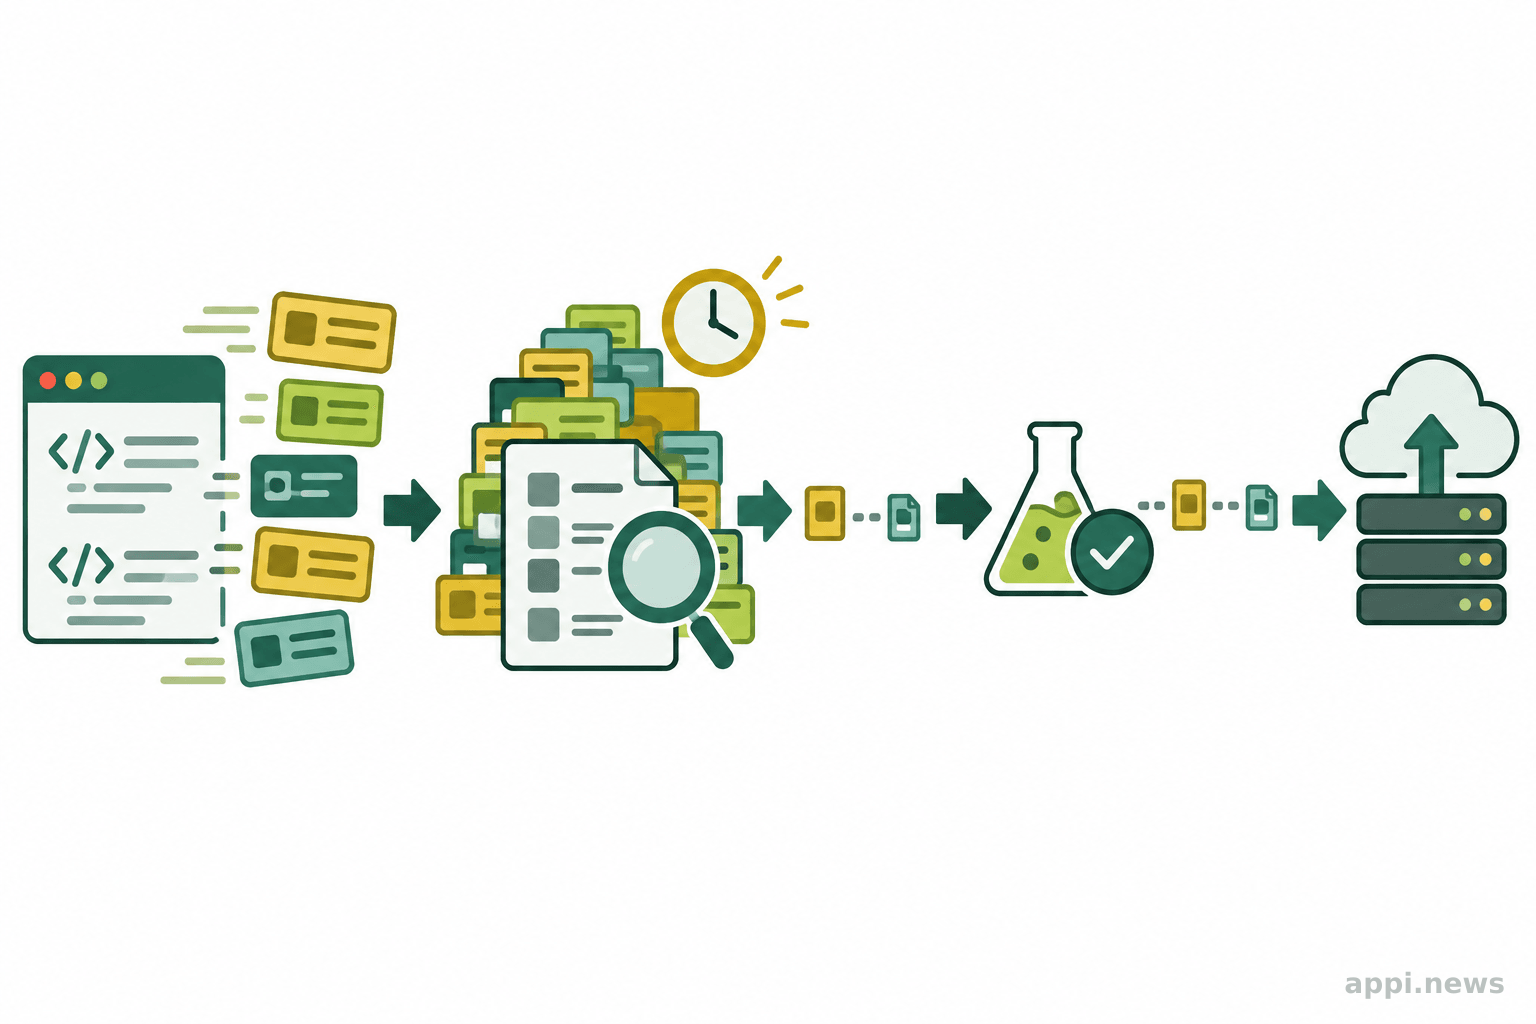
很多團隊評估生成式 AI,第一個會看能不能提高產出。但產出增加之後,還要問:更多內容是否通過審查、測試與交付,最後解決了原本要處理的問題?一項涵蓋 718 家企業的研究,正好呈現這段落差。研究估計,採用 AI 程式代理後,程式碼行數增加約 30%,PR 平均審查時間也增加約 49%;Jira 工作項目與大型專案的解決率,則沒有顯著變化。
這不代表 AI 沒有用,也不能直接推成所有 AI 程式碼品質較差。它提醒導入者把視線從模型一次能產生多少,移到整個工作流程實際完成了什麼。對企業而言,流程自動化的驗收標準應包含交付結果、返工與審查負荷,並先依任務可能造成的損失決定人工覆核要放在哪些關卡。
一、程式碼產出增加,為何不等於軟體成果增加?
因為程式碼只是軟體生產流程中的中間產物,還要經過審查、測試與部署,才會轉成已完成的工作。 研究觀察到代理工具提升程式碼行數、提交與 PR 數量,但 Jira issue 和 epic 的解決率沒有顯著改變。
這項研究由 Fiona Chen 與 James Stratton 撰寫,使用工程分析平台 Jellyfish 的企業資料,涵蓋 2021 年 1 月至 2026 年 3 月約 3 億筆工作事件。樣本有 718 家企業、725,938 名工作者,資料包括人力資訊、程式版本控制、工作追蹤、行事曆與 AI 工具使用紀錄。研究採用分期差異中的差異設計,利用企業導入時間不同,比較各企業採用前後的變化。這種設計依賴平行趨勢假設:若未採用工具,較早採用、較晚採用與未採用企業的結果原本會沿相近趨勢變化。採用時點仍可能受企業決策影響,因此估計結果須連同這項識別條件解讀。
論文把生成式 AI 程式工具分成 AI 助手與 AI 代理。助手在編輯時提供補全或依指令生成片段,由開發者逐步引導;代理能接收較高層次任務,規劃多步驟工作、跨檔案修改並執行測試。兩種工具對流程的影響可能不同,因此研究分開估計。
研究估計,AI 代理導入後,程式碼行數增加 30%、commit 數增加 20%、PR 數增加 23%,三項變化均達統計顯著。AI 助手的程式碼行數、commit 和 PR 估計值則分別增加 12%、9% 和 5%,其中只有 commit 的變化達統計顯著。這些指標描述的是程式編寫活動,不等於產品功能、可靠性或客戶價值以同樣幅度增加。
Jira issue 是團隊追蹤的單一工作項目,完成時通常表示程式已審查、測試並部署;epic 則把多個 issue 組成較大的功能或專案。研究發現,AI 助手與代理導入後,兩類工作項目解決率的估計變化都是小幅正向,但未達統計顯著。解決率是企業層級軟體產出的代理指標,仍不能代表所有產品品質或長期效益;但它說明只用程式碼數量判斷導入成效,會漏掉交付流程中的其他步驟。
| 比較面向 | AI 程式助手 | AI 程式代理 |
|---|---|---|
| 常見互動 | 在編輯時提供補全或依指示產生程式碼 | 接收任務後規劃多步驟工作並執行、測試與修正 |
| 研究中的程式碼行數估計 | 增加 12%,未達統計顯著 | 增加 30%,達統計顯著 |
| commit 數估計 | 增加 9%,達統計顯著 | 增加 20%,達統計顯著 |
| PR 數估計 | 增加 5%,未達統計顯著 | 增加 23%,達統計顯著 |
| Jira issue/epic 解決率 | 小幅正向,未達統計顯著 | 小幅正向,未達統計顯著 |
作者指出,生產力提升沒有完全轉化為軟體產出,因為生成程式碼仍須經需求確認、審查、測試與部署。
二、人工審查如何成為流程瓶頸?
研究中的主要瓶頸訊號出現在程式碼審查:代理導入後,PR 審查時間增加,要求修改的比例與每個 PR 的留言數也上升。 這些觀察支持審查工作變重的解釋,但不足以單獨證明原因就是程式碼品質下降。
PR(pull request,合併請求)是開發者提出一組變更,請團隊檢視後再合併到共同程式庫的流程單位。研究以 PR 提交至合併的天數衡量審查時間。AI 代理導入後,平均審查時間增加 49%,基準平均約 7.03 天;AI 助手對審查時間沒有顯著影響。這是平均估計,不能拿來預測特定團隊每份 PR 都會延遲近一半。
審查要求也有變化。代理導入後,收到至少一次「要求修改」的 PR 比例增加 12 個百分點,基準約 13%,接近原先的兩倍;每份 PR 的審查留言平均增加 0.58 則,相對基準約增加 35%。與此同時,PR 本身的程式碼行數沒有顯著變化,因此留言變多不容易只用「每次送審的變更更大」解釋。研究也觀察到參與審查的工作者比例增加約 14%,顯示企業可能把更多人力調進審查工作。
研究提出兩種可能並存的機制:編寫加快使待審程式碼增加,或送審內容品質及審查標準改變,讓每份變更需要更多檢查。這些解釋值得檢驗,但修改要求增加不代表每份 AI 產出都有更多錯誤。
程式碼送審後仍須確認需求、測試整合並部署。上游候選變更多時,測試環境、資安檢查或部署窗口也可能成為限制,應以流程數據找出實際卡點。
GitHub 將 PR 審查決定分為留言、核准與要求修改;若只增加生成量,卻不調整審查容量與測試設計,等待時間可能轉往下游。
「在一些情況下,我們能更快寫出程式碼,但瓶頸一次只會有一個。加快編碼後,瓶頸會移到別處。」這段訪談出自研究附錄 B(PDF 第 50 頁),受訪者標示為資深軟體工程師;他接著提到,溝通、審查與 QA 都可能限制交付。這是受訪者的實務觀察,不能當作每家公司都會出現相同瓶頸的定律。
三、研究結果能說明什麼,不能說明什麼?
不能直接這樣下結論。 研究觀察到審查時間和修改相關指標變化,並用產出流程模型解釋可能的瓶頸;它沒有證明所有變化都由程式碼錯誤造成,也沒有涵蓋每個團隊、工具或任務。
研究以企業採用 AI 助手或代理的時間差異,比較採用前後變化。此方法的關鍵假設是,若未採用工具,各組企業原本會沿相近趨勢發展。採用時點也可能受安全審核、預算與管理決策影響,因此研究並非隨機實驗。
樣本是同意提供資料的 Jellyfish 客戶,未必代表不同規模、產業與地區的企業。平台記錄版本控制、工作追蹤等活動,研究者未直接讀取每次 commit 的完整程式碼;結果也不宜直接外推至其他工作或未連接平台的團隊。
程式碼行數無法反映程式是否簡潔、易維護;issue 與 epic 解決率也是代理指標,不等同客戶滿意度、缺陷率、資安風險或長期維護成本。
審查時間也可能受程式量、任務複雜度、團隊標準或人力分工影響。修改要求與留言增加代表互動變多,未必表示改動都是缺陷;企業仍需建立自己的基準。
四、如何把模型表現轉成流程驗收標準?
先以任務完成與風險後果建立基準,再同時追蹤交付品質、返工、審查負荷與人工介入,不能只用生成速度或程式碼數量判定。 驗收問題要能回答:哪些工作可以交給工具處理,哪些結果必須由具責任的人確認?
第一步是定義工作邊界。整理文件草稿與修改權限控制、付款邏輯或個資程式,錯誤代價不同。可依影響範圍、回復難度、資料敏感度與潛在損失分級,再設定工具權限、審查角色及回復方案。
第二步是選定驗收指標。程式工作可記錄需求完成率、測試通過率、合併後缺陷、回退次數及交付時間;審查流程則看 PR 等待時間、審查工時、修改輪數與原因、審查者負荷。只量生成耗時,會漏掉澄清、驗證與修復成本。
第三步以相同任務分類、嚴重度與完成定義比較導入前後,並記錄人數、需求量或測試政策等同步變化。試行可保留未使用 AI 的可比任務,除平均值外也檢查分布與高風險案例。
NIST AI RMF 1.0 附錄 C 指出,組織應釐清 AI 系統使用、互動與管理中的人員角色和責任。流程設計也應明定人工覆核的範圍、時點與責任角色,才能確認高風險錯誤有適當把關。
「使用、互動或管理 AI 系統時,各種人員角色與責任應明確區分。」NIST《AI 風險管理框架 1.0》附錄 C 將這項工作列為組織管理人機互動風險的方向。落到程式代理試行,團隊可在驗收文件中寫明誰負責檢視輸出、誰能核准合併、誰有權停止部署,以及發現問題後由誰啟動回復。
驗收指標也要先定義口徑,避免不同團隊把「完成」算成不同事件。例如,需求完成率可要求對應 issue 已部署;缺陷率可只計入上線後、在指定觀察期內確認的問題;返工則記錄原因與修改輪數。每個指標都應標明資料來源、計算期間、負責人和排除條件,之後才能比較導入前後的結果。
試行時可將任務依風險和類型分組,分別追蹤低風險文件更新、一般功能修改及權限或資料處理變更。觀察平均值之外,也要看高嚴重度缺陷與等待時間最長的一端;若平均交付時間縮短、但高風險變更的回退增加,便不能只憑平均速度判定流程改善。發現偏差時,回看是哪個停點、測試或核准角色未能及時攔下問題,再調整適用範圍。
一個可執行的試行安排可分成四項:
- 選定任務與風險級別:描述輸入、預期結果、可接受錯誤及禁止工具執行的動作。
- 記錄導入前基準:統一任務完成定義,量測交付時間、返工、缺陷與審查工時。
- 設定人工停點:明定哪些變更須由指定角色核准,哪些測試不通過就停止部署,以及如何回復。
- 依相同口徑比較試行結果:檢查品質、成本與流程等待是否改善;未達門檻時,調整任務範圍或審查設計後再評估。
五、導入生成式 AI 時,人工覆核要放在哪裡?
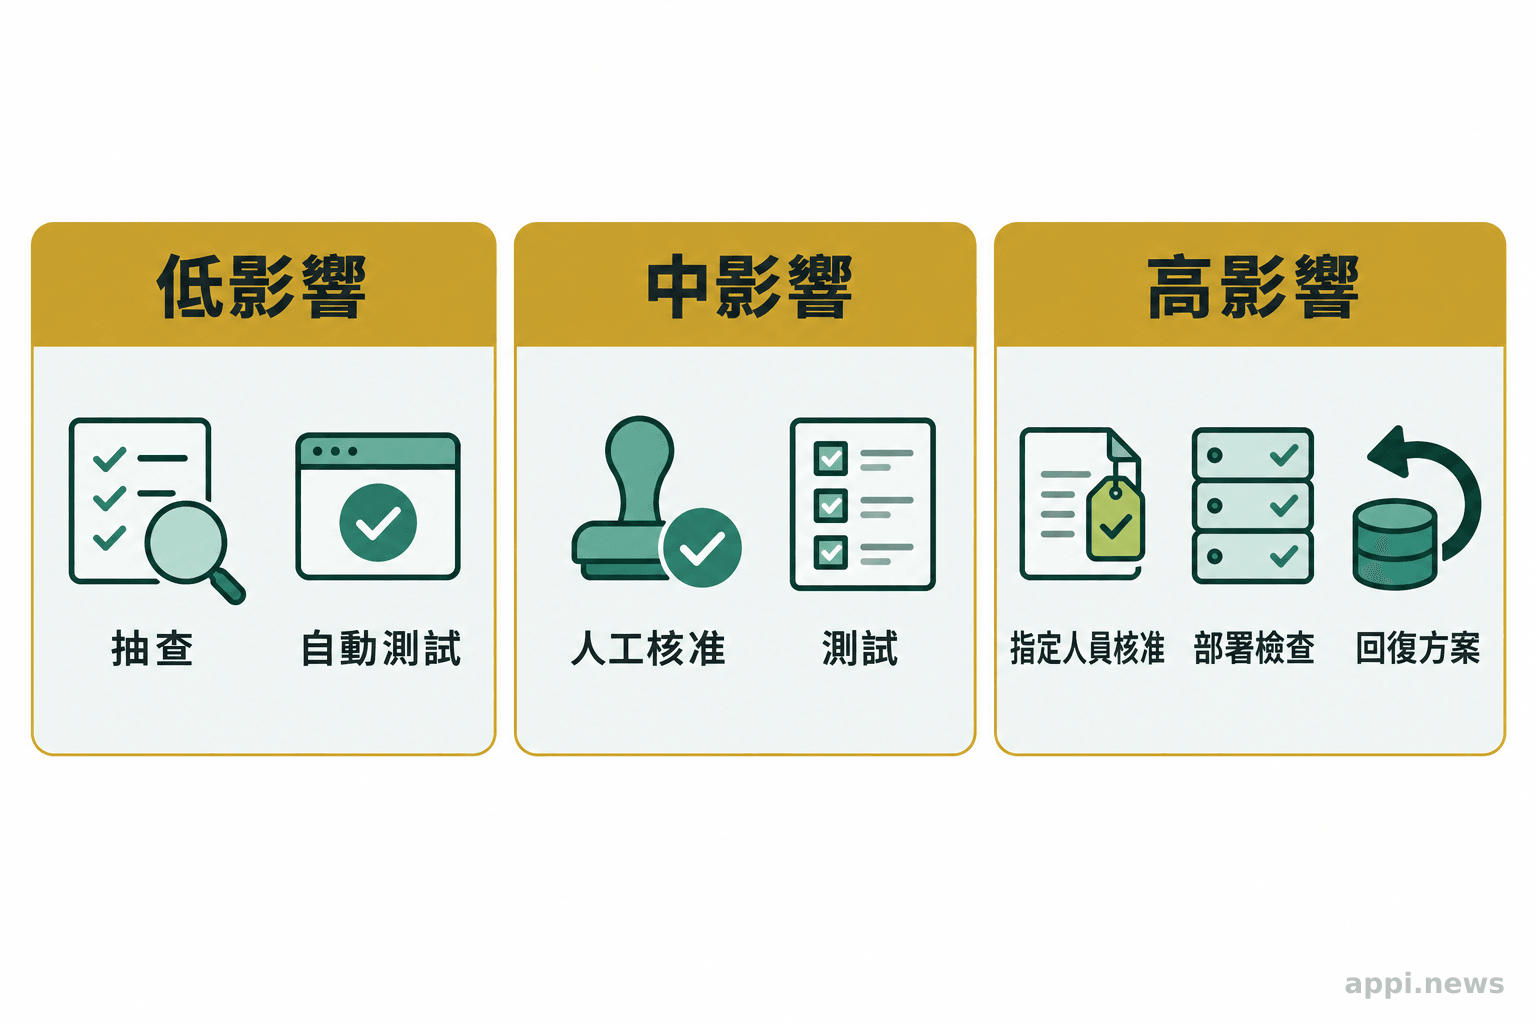
把覆核放在錯誤仍可被發現、修正成本仍可承受,而且有明確責任人能判斷的節點。 覆核深度應依任務風險調整;低風險工作可用抽查與自動測試,高風險或難以回復的變更則應保留明確核准與部署前檢查。
程式代理可在隔離分支建立草稿或執行測試;接觸正式資料、調整權限、更新依賴套件或部署時,則可要求指定角色核准。
審查者需掌握需求、變更範圍、測試結果、未處理警告與回復方法。拆小任務、保留紀錄並讓測試可重現,有助辨認跨系統影響。
組織可抽查核准後的缺陷,確認覆核者有足夠時間與領域知識,也要分析修改原因及審查負荷是否集中於少數人員。
自動化可處理格式、測試或依賴等可重複檢查,人員則判斷需求脈絡、例外與部署風險;核准責任仍須明確。
- 程式碼、文字或資料的生成量是中間指標,必須連同任務完成與交付結果判讀。
- 審查等待、返工和責任人負荷可協助找出流程瓶頸,但單一指標無法證明品質原因。
- 先按錯誤後果設定工具權限與人工停點,再用同一套基準持續驗收。
常見問題
Q1:程式碼行數增加 30%,是否代表生產力增加 30%?
不代表生產力增加 30%。研究中的 30% 是 AI 程式代理導入後程式碼行數的平均估計變化,描述編碼活動,不等同整體生產力、產品價值或所有企業的實際增幅。
Q2:PR 審查時間增加 49%,是否表示 AI 程式碼品質變差?
研究看到審查時間、修改要求與留言增加,但不能據此證明程式錯誤是唯一原因。
Q3:哪些工作可以交給 AI 自動處理?
要看錯誤影響、可逆性、資料敏感程度與驗證方式。可先從範圍明確、容易測試和回復的任務試行,再依結果決定工具權限;涉及高風險變更時,安排具責任的角色確認。
Q4:AI 程式代理和 AI 程式助手要用同一套驗收方式嗎?
兩者都要看任務成果與流程成本,但互動方式不同。代理能執行較長的多步驟任務,需額外檢查執行權限、過程紀錄與測試;助手多由開發者逐步引導,仍要量測生成內容後續所需的審查與修正工作。
導入者可先以一類工作記錄完成結果、返工與審查時間,再據此設定自動化範圍及人工確認點。
參考來源
- Chen F, Stratton J. (2026). *Artificial Intelligence in the Firm: Bottlenecks in Software Production*. Harvard University, Job Market Paper, current version August 4, 2026
- GitHub. (2026). *About pull request reviews*. GitHub Docs
- National Institute of Standards and Technology. (2023). *Artificial Intelligence Risk Management Framework (AI RMF 1.0)