
評估 GPT-6 Luna 時,醫療內容團隊還要檢查資料判讀、引用與專業審閱流程。醫療文章包含找資料、判斷證據、處理不確定性,以及安排專業審閱。
截至 2026 年 9 月 23 日,OpenAI 將 GPT-6 Luna 定位為適合聚焦、高量工作的模型;GPT-5.6 是包含 Sol、Terra、Luna 的家族名稱。本文比較 GPT-6 Luna 與 GPT-5.6 Luna;測試時要固定完整模型 ID、產品入口、推理強度與工具組合,才能並列結果。
一、GPT-6 Luna 與 GPT-5.6 Luna 的名稱和定位先要分清楚
GPT-6 Luna 與 GPT-5.6 Luna 是兩個具體型號;GPT-5.6 則是涵蓋 Sol、Terra、Luna 的家族名稱。比較時應記錄各自完整模型 ID,避免把家族名稱當成單一型號。
OpenAI API 文件將 GPT-6 Luna 的模型 ID 列為 gpt-6-luna,並列出搜尋、檔案、結構化輸出與函式呼叫等能力。這些規格不代表醫療判斷已取得專業認證。
GPT-5.6 家族包含 Sol、Terra 與 Luna;GPT-5.6 Luna 的 API model ID 為 gpt-5.6-luna。測試紀錄也應保存日期、推理強度、搜尋設定與輸入資料版本。
OpenAI 公布的 API 價格中,GPT-6 Luna 每百萬輸入 token 為 0.10 美元、輸出為 0.50 美元;GPT-5.6 Luna 則為 0.20 與 1.20 美元。低成本可增加驗證輪次,不能取代人工查核。
| 比較項目 | GPT-6 Luna | GPT-5.6 Luna | 對醫療文章的意義 |
|---|---|---|---|
| 模型識別 | gpt-6-luna | gpt-5.6-luna | 每次測試都要記錄完整 ID |
| 官方定位 | 聚焦、高量、效率導向 | GPT-5.6 Luna 偏速度與成本;Sol、Terra 是同家族的其他型號 | 先依任務分層,再談升級 |
| API 價格 | 輸入 0.10、輸出 0.50 美元/百萬 token | 輸入 0.20、輸出 1.20 美元/百萬 token | 可增加驗證輪次,但不減少責任審閱 |
| 工具使用 | 官方文件列出搜尋、檔案、結構化輸出等支援 | 依產品、端點與方案而定 | 工具可用不代表資料已被正確引用 |
| 品質判斷 | 官方評測顯示相對前代改善 | 既有流程與基準可作為對照 | 仍須用醫療內容測試集驗證 |
二、醫療文章工作流有五個比較面向,效能差異仍須實測
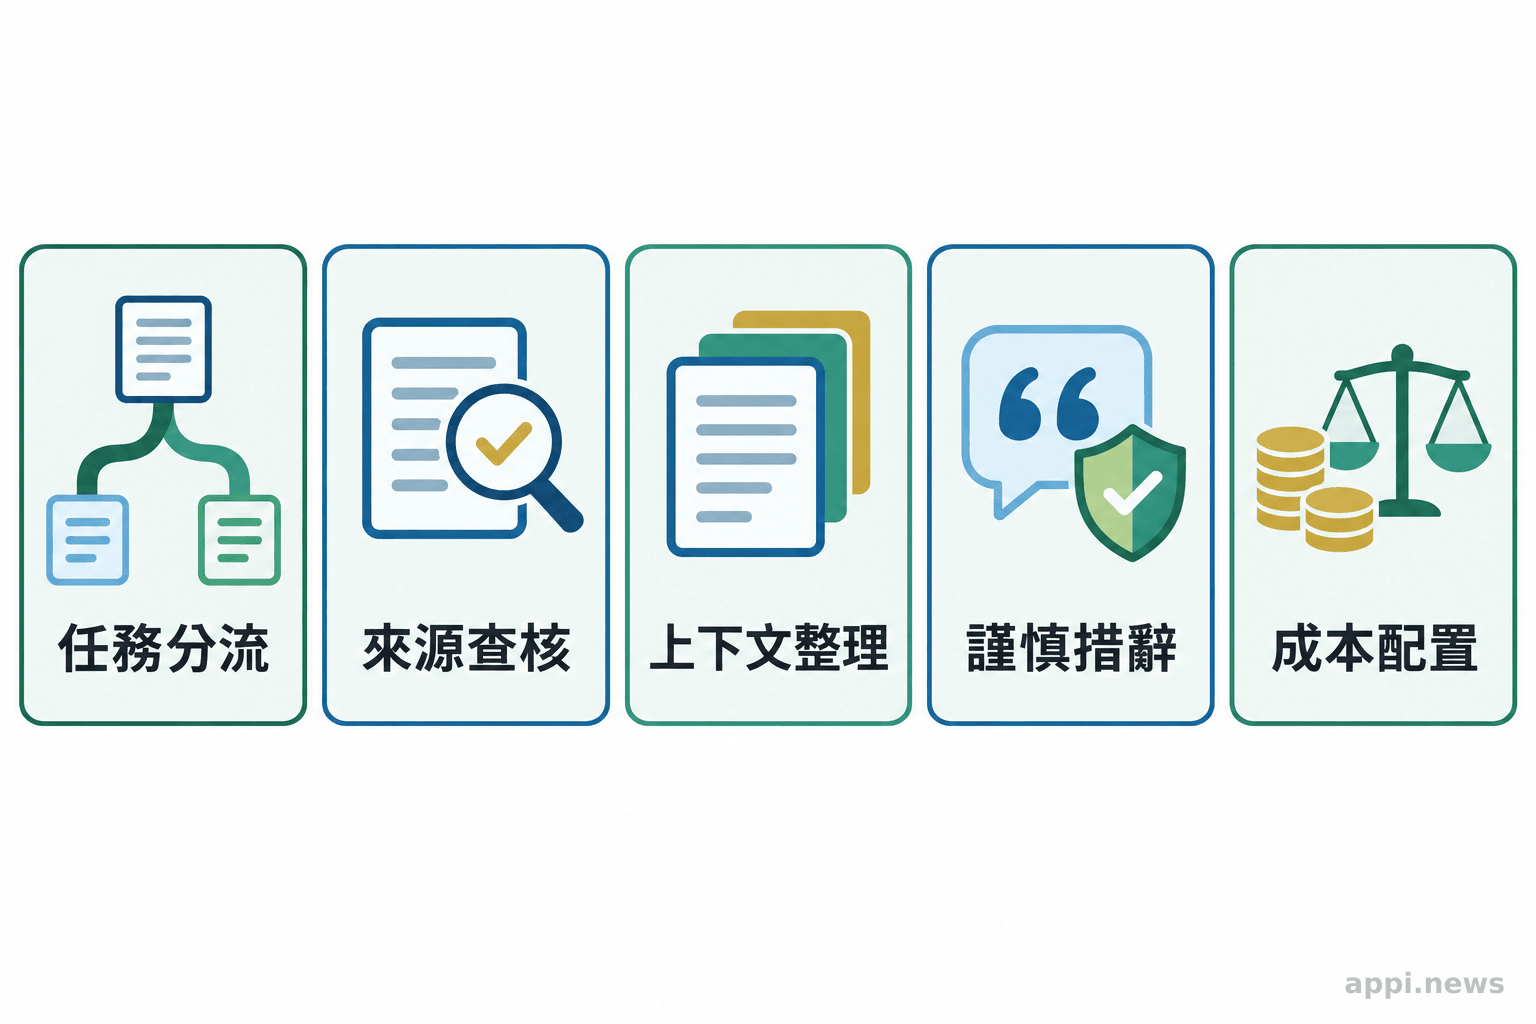
任務分層、驗證、上下文、措辭與成本,是比較兩個型號時可觀察的五個工作流面向;這些面向不是醫療基準測出的模型效能差異,仍須以相同任務驗證。
任務分層可先從醫療編輯常見工作開始:資料整理、段落分類、把官方文件轉成清單,輸入與輸出較明確,適合安排模型處理。遇到矛盾研究、藥物適應症、治療選擇或急性症狀時,核心轉為證據判斷,應提高審閱層級。
驗證可拆成「抽取來源」「列出主張」「逐條核對」「形成文章」四階段,讓每個主張都有檢查位置。比較兩個型號時,這些步驟和輸入資料應保持一致。
上下文管理也會影響醫療文章。長上下文不等於把所有醫學資料和舊版指引一次塞入;來源應先分組,標明日期及適用範圍。
輸出風格則要檢查限制條件有沒有保留。官方說明提到 GPT-6 系列在技術對話中追求較清楚、較少術語與無效細節;「可能改善」「部分族群適用」「研究尚未確認」等說法仍須完整呈現。
成本分配是第五個觀察面向。省下的模型費用可用於批次比較、反向提問與版本留存,形成「草擬、規則掃描、來源查核、專業審閱」的循環。低價不等於可以無限發布。
三、醫療文章最需要防守的是四種內容錯誤
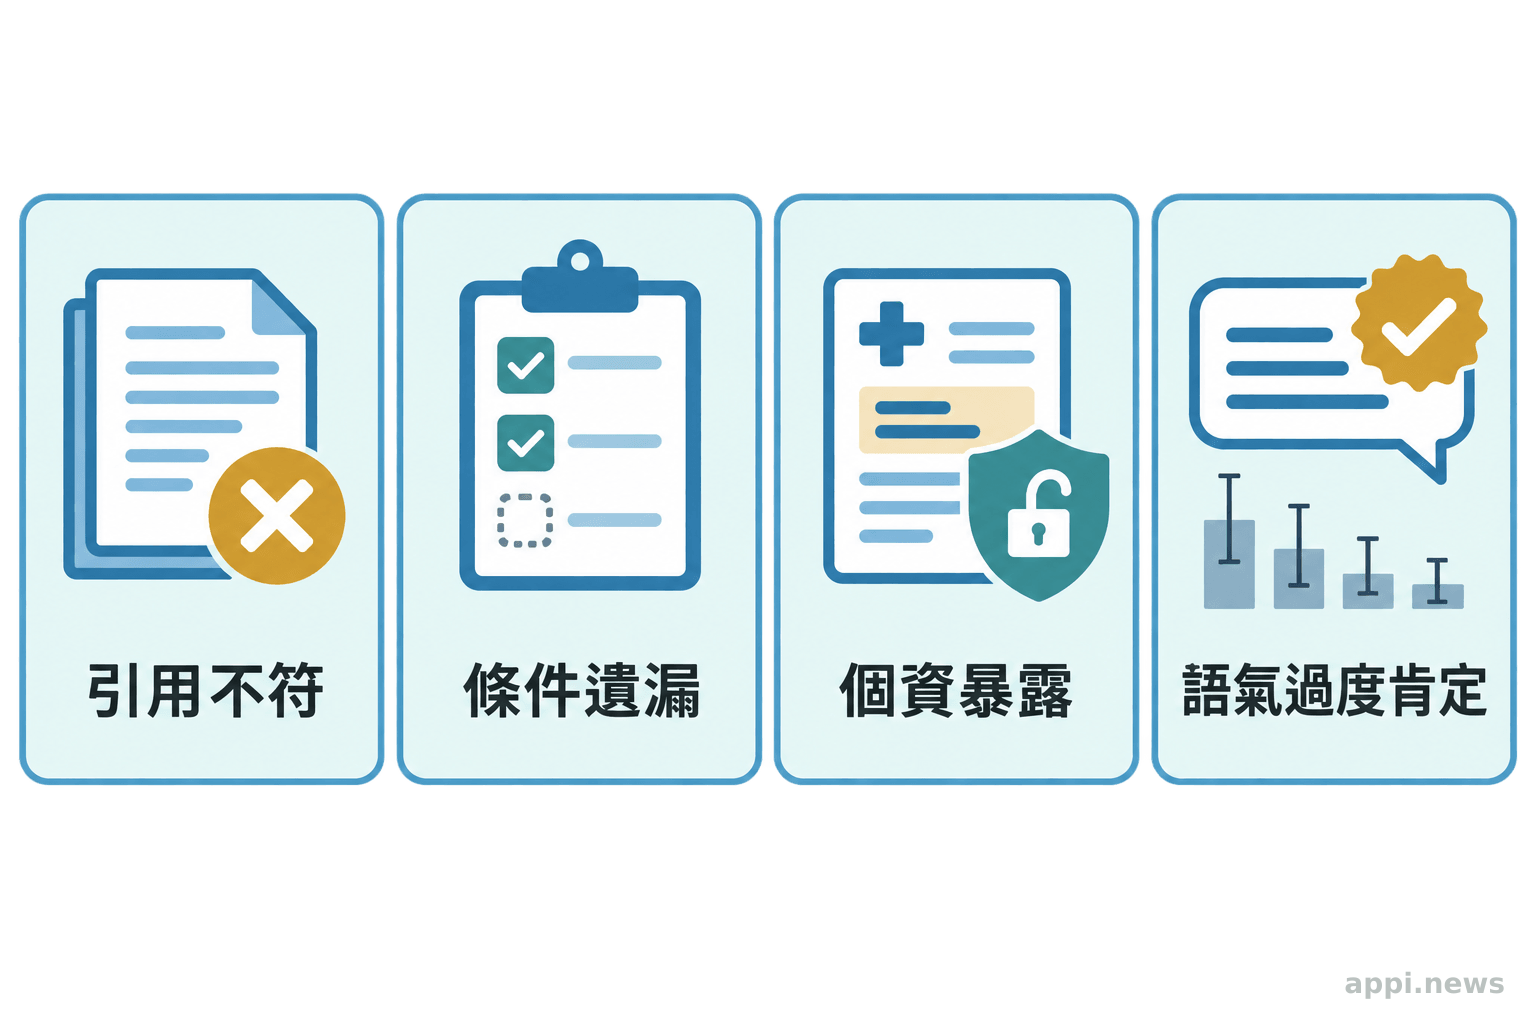
優先防守的四項風險是來源錯置、臨床條件遺漏、健康資料暴露,以及語氣過度肯定。版本更新不會自動建立證據鏈與責任分工。
第一是引用錯誤。模型可能提供不存在的 DOI、把公告頁當成研究全文,或把一篇研究套到另一個族群。每條引用都要開啟,確認可存取、標題作者相符,再檢查主張是否真的由來源支持。
第二是臨床條件遺漏。年齡、孕期、共病、用藥、症狀嚴重度與資料時間點,都可能改變健康建議。適用族群、例外情況、就醫警訊與資訊日期,應列為固定欄位。
第三是個人健康資料暴露。病歷、檢驗數值、影像與可回推身分的案例描述,都可能是敏感資料。測試宜使用虛構、去識別化或公開資料,並由機構規範決定可用工具。
第四是語氣造成誤用。「可考慮」可能被寫成「應該」,「可能相關」可能被寫成「就是原因」。標題、摘要、圖片文字與 FAQ 也要一併檢查。
世界衛生組織指出,AI 用於健康時,倫理與人權必須放在設計、部署和使用的核心;治理也要讓相關利害關係人對受影響的個人與社群負起責任。—世界衛生組織《人工智慧健康倫理與治理》指引
世界衛生組織也提醒,大型多模態模型能處理多種輸入與輸出,但不能只由通用定位推定其能勝任所有任務。對醫療文章而言,「能處理很多內容」與「每項主張都可靠」必須分開評估。
四、從 GPT-5.6 Luna 轉用 GPT-6 Luna,先做一輪可重現的驗證
不要用一篇示範稿決定是否遷移,應用同一批醫療寫作任務做盲測,評估事實、引用、完整性、風險措辭、成本與人工修改時間。
- 建立測試集:挑選已完成查核的衛教、研究解讀、政策與藥物資訊題目,保留來源與人工審查結果。
- 固定條件:記錄兩個模型的完整 ID、日期、推理強度、工具權限、提示與來源檔案,避免把流程差異誤認成模型差異。
- 拆分指標:記錄主張正確率、引用相符率、條件遺漏數、風險措辭數、人工修改時間與每篇成本。
- 安排反向檢查:要求模型列出可查證主張、不確定句子與需要專業判斷的段落,再由人工核對。
- 分階段上線:先處理格式整理、摘要初稿與來源欄位抽取;診斷、治療、用藥、急症與個人病例仍保留專業審閱。
- 保存版本:每次更新後重新抽樣測試,保留失敗案例、修正原因與最後採用的版本。
OpenAI 也特別說明,研究環境或 API 的評估結果,可能因系統提示與可用工具不同,而和產品環境的輸出不同。這個限制對醫療文章很重要:團隊在 API 測試中得到的結果,不能直接推論到一般聊天介面、企業工作區或另一套內容管線。
OpenAI 說明,模型評估若來自研究環境或 API,可能因系統提示與工具不同,而與生產版產品的輸出有所差異;因此,評估結果必須連同使用環境一起記錄。—OpenAI《Introducing GPT-6 Sol and Luna》
五、對醫療內容團隊而言,最穩妥的分工是讓模型處理可驗證的部分
適合交給 GPT-6 Luna 的,是格式明確、可以回溯來源、錯誤容易檢查的工作;需要判斷證據強度、處理例外族群或承擔對外責任的工作,仍應由人員掌握最後決定。
個人創作者可以把模型放在資料整理與初稿階段,要求重要句子連回來源,區分「來源直接支持」「合理推論」與「尚待確認」。完成後逐條打開連結,再重寫標題與行動建議。
醫療機構、健康媒體或內容平台要管理角色與資料:編輯負責讀者風險,研究人員負責來源,專業人員負責臨床措辭,資訊安全人員負責資料與工具,發布者負責版本。模型不能成為責任歸屬的終點。
若文章涉及台灣讀者,還要補上在地可用性。外國指引可能和台灣制度不同;法規與服務資訊應回到衛生福利部、食品藥物管理署、中央健康保險署或專業學會的現行頁面查核。
- GPT-6 Luna 的主要變化在效率、成本與可擴大的工作流,不能直接等同醫療正確性提升。
- GPT-5.6 是家族名稱,包含 Sol、Terra、Luna;比較 GPT-5.6 Luna 時應保留完整模型 ID 與環境設定。
- 醫療文章的核心品質指標是主張、來源、適用條件與責任是否對得上,不是文章是否一次生成。
- 遷移應從低風險、可回溯的任務開始,並保留人工審閱與可回退的舊流程。
常見問題
GPT-6 Luna 可以協助資料整理、結構規劃、初稿與檢查清單,但不適合在沒有來源核對與專業審閱的情況下直接發布醫療結論。
常見問題
Q1: GPT-6 Luna 是否一定比 GPT-5.6 Luna 更適合醫療文章?
不一定。官方資料顯示 GPT-6 Luna 著重效率與高量工作,醫療文章仍要評估引用、條件完整性與人工修訂成本。應用相同題目與來源盲測即可。
Q2: 文章中寫「GPT-5.6」會有問題嗎?
可能讓讀者無法判斷指的是哪個型號。GPT-5.6 是包含 Sol、Terra、Luna 的家族名稱;正式紀錄應寫明具體型號、API 文件列出的完整 model ID、產品入口與測試日期。
Q3: 可以把病人的真實案例貼給模型改寫嗎?
未經授權不應直接使用。病歷、影像、檢驗數值與可回推身分的細節都可能涉及敏感健康資料,應依機構個資與資訊安全規範,改用去識別化或虛構案例。
參考來源
- OpenAI (2026). *Introducing GPT-6 Sol and Luna*. OpenAI
- OpenAI (2026). *GPT-6 Luna Model*. OpenAI API Documentation
- OpenAI (2026). *GPT-5.6 and GPT-6 Pro in ChatGPT*. OpenAI Help Center
- World Health Organization (2025). *Ethics and governance of artificial intelligence for health: Guidance on large multi-modal models
- World Health Organization (2021). *Ethics and governance of artificial intelligence for health: WHO guidance
- National Institute of Standards and Technology (2024). *Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile*. NIST AI 600-1
- Simson L. Garfinkel (2015). *De-Identification of Personal Information*. NISTIR 8053, National Institute of Standards and Technology


