
ForTy 研究團隊在中國案例中發現,地圖低估了人工林;團隊透過主動學習找出易錯區域並補充判讀。這項修正說明,全球森林地圖仍須檢視目標地區的分類表現。論文以 8,190 個專家共識地點驗證六分類地圖,整體準確率為 90.2%;原始林 F1 為 82.9%,人工造林為 58.2%。想了解森林地圖與衛星嵌入,可讀ForTy 與 OlmoEarth 的資料差異;判斷資料是否適用,還要核對分類、地區和決策需求。
Google DeepMind、Google Research、世界資源研究所(WRI)及國際應用系統分析研究所(IIASA)等團隊共同開發這份資料,以 2020 年為基準,將全球陸地分成六類,提供名目 10 公尺網格信心分數。它適合全球比較或初篩;特定地塊、合規或資源配置仍須當地查核。論文驗證結果能否回答這個地區、這種用途的分析需求?
ForTy 的 90.2% 準確率,能回答你的地圖問題嗎?
90.2% 是六分類方案在全球分層抽樣驗證點上的整體準確率,不代表任一地區或任一類別都達到同樣表現。判斷適用性時,還要看目標類別的錯誤型態、地區樣本與實際誤判成本。
論文抽取 9,100 個全球分層隨機地點,8,190 個完成兩位專家判讀與共識整理。這是獨立驗證,仍不能代表每個國家、類型和用途。「其他土地」F1 為 96.4%,原始林 82.9%,自然再生林 72.6%,人工造林 58.2%。若關心人工林或農林複合系統,整體數字會掩蓋分類難度。
整體準確率統整所有類別;F1 綜合精確率與召回率,反映誤判和漏判。研究另報告自然林與非自然類別準確率 94.8%,森林與非森林二分準確率 95.5%。粗分類不能替代六分類。先決定要回答「有沒有森林」「自然林比例」或「人工林與樹木作物分布」,再選指標。
Neumann 等人在 ForTy 論文中指出,輸出分數未經事後校準,應視為相對信心分數,不能直接解讀為已校準的後驗機率。
ForTy 把全球土地分成哪六類?
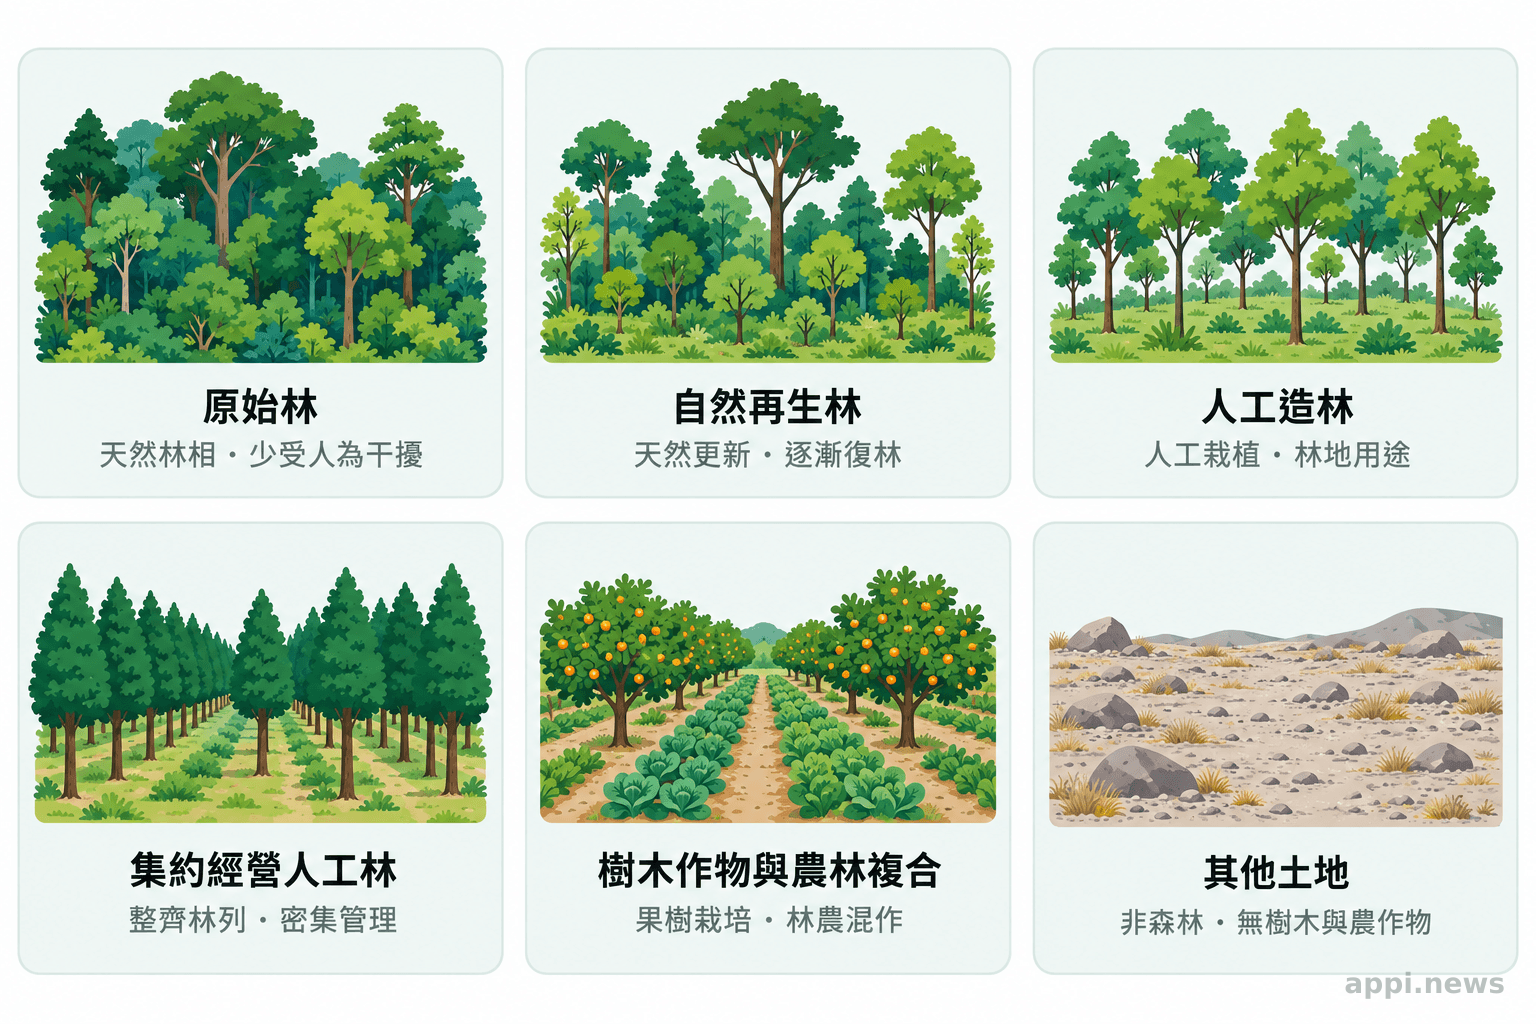
ForTy 區分原始林、自然再生林、人工造林、集約經營人工林、樹木作物與農林複合系統,以及其他土地,分類涉及地表、用途和管理方式。
原始林指以本地樹種為主、沒有可見人為擾動的自然林;自然擾動後恢復的森林仍可能歸入此類。自然再生林則主要由人為擾動後自然更新形成,包括休耕地或砍伐後的再生林。成熟次生林的光譜與冠層可能接近原始林,影像未必能呈現完整管理史。
人工造林主要透過種植或播種建立;論文以 40 年輪伐期作為它與集約經營人工林的操作性門檻。後者通常樹種少、林齡相近、排列規則,輪伐期不超過 40 年。這是研究工作定義,非衛星直接觀測到的管理紀錄。
樹木作物與農林複合系統包括油棕、橡膠、果園等非木材商品作物;其他土地包括非樹木地表、稀疏植被和未達森林門檻的小樹叢。研究依 FAO 與歐盟相關定義整理類別,實務使用前仍須核對專案定義。
| ForTy 類別 | 主要判讀概念 | 容易混淆之處 |
|---|---|---|
| 原始林 | 本地樹種自然林,無可見人為擾動 | 成熟次生林可能外觀相近 |
| 自然再生林 | 人為擾動後以自然更新為主 | 林齡與擾動歷史差異大 |
| 人工造林 | 以種植或播種建立,輪伐期超過研究門檻 | 與自然再生林、集約人工林交界模糊 |
| 集約經營人工林 | 少數樹種、同齡、規則排列,輪伐期不超過 40 年 | 與其他人工林在影像上可能相似 |
| 樹木作物與農林複合 | 油棕、橡膠、果園及農林系統 | 遮蔭農林可能像自然林 |
| 其他土地 | 非樹木地表、稀疏植被及不達森林門檻的樹叢 | 稀疏林地可能落在門檻邊緣 |
衛星資料與 AI 怎麼形成森林分類地圖?
ForTy 將多來源、多年份的衛星觀測整理成地理嵌入,再以三階段深度學習模型結合不同精度的標註資料、弱監督學習和主動學習,輸出各類別的相對信心分數。
地理嵌入是把衛星觀測轉成模型可比較的數值表徵。三階段流程先用參考樣本建立分類,再以初步預測和其他資料擴大訓練,最後加入 2019 至 2024 年脈絡改善年度一致性。目標地圖仍是 2020 年基準,並非即時地圖。
標註資料在全球分布不均,也不全是逐像元標記。團隊用主動學習找出錯誤集中或資料不足區域,再補充判讀。論文記錄,印度西孟加拉的香蕉園曾被過度分成樹木作物,歐洲葡萄園也出現類似錯分;研究團隊據此檢視分類與標註。東南亞、西非和南美的樹木作物辨識亦經修正。這些地區案例顯示,作物與森林交錯的地景容易混淆,目標區域仍須用當地參考資料驗證。論文區域案例
各類分數不能直接解讀為「有 80% 機率屬於某類」。提高門檻可篩除低信心像元,也會改變精確率與召回率;應以在地獨立資料驗證,按錯誤代價決定。例如供應鏈風險分析與探索性製圖,能接受的誤差不同。
Neumann 等人在論文中說明,使用者可依地區情境與應用需求調整分類門檻,在精確率和召回率之間取捨。
解析度、年份與地區差異會如何影響判讀?
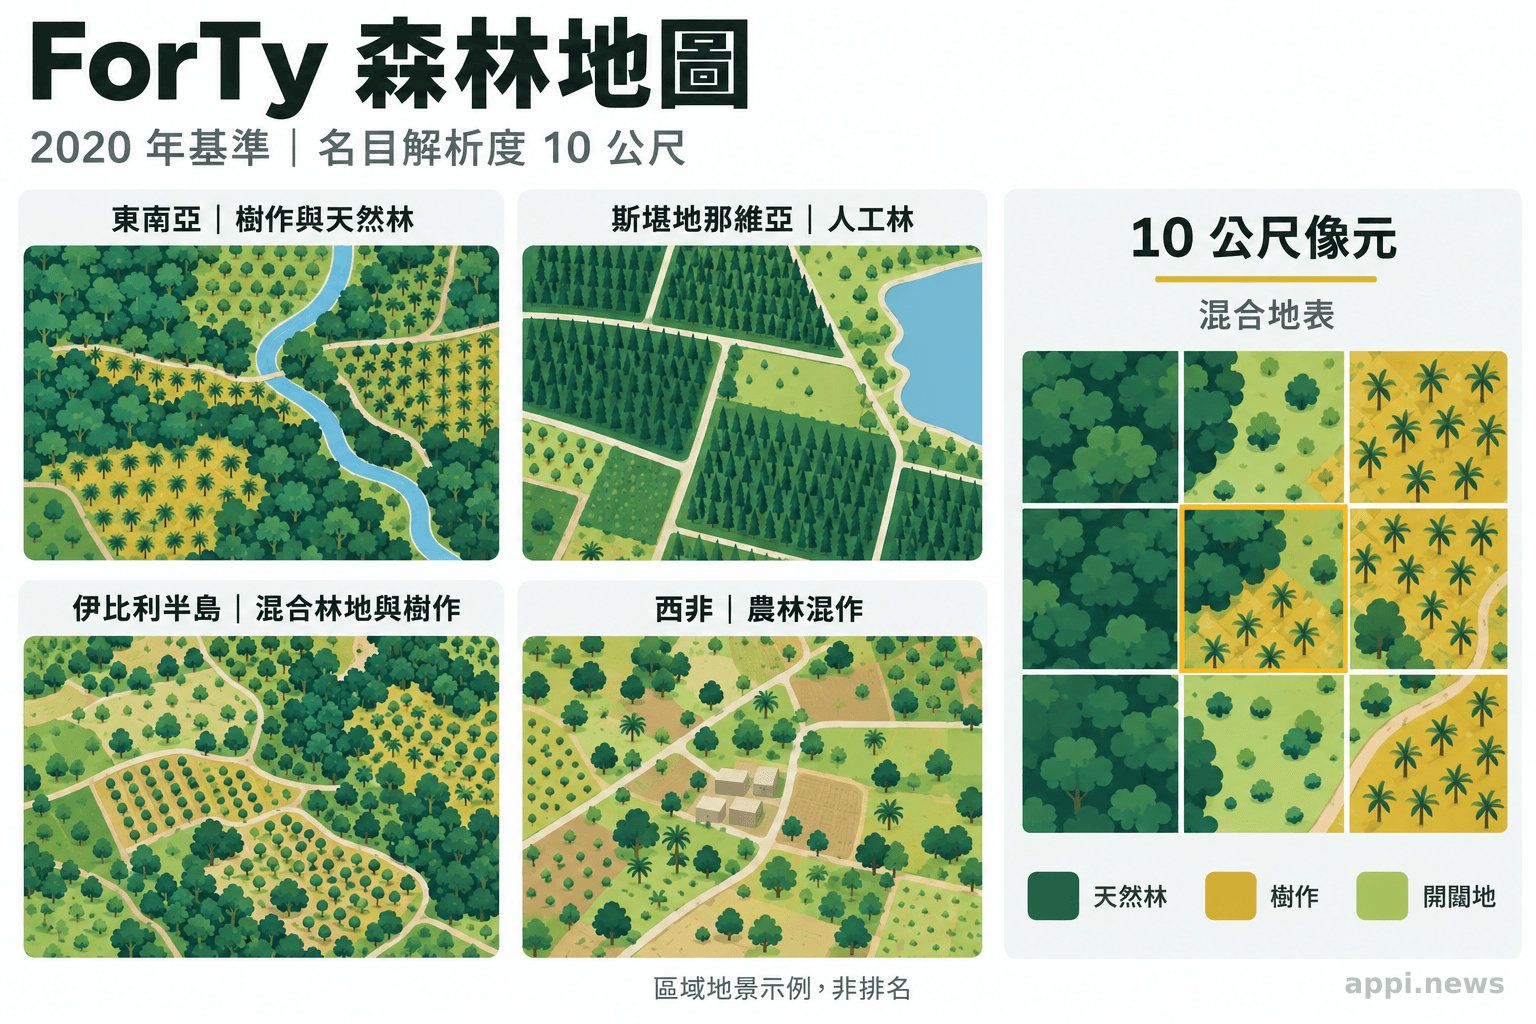
10 公尺是資料網格的名目像元大小,輸入資料的有效解析度可能更粗;小地塊、林地邊界和混合像元會降低判讀能力。地圖描述的是 2020 年基準,不能直接當作當前森林狀態。
研究指出,森林類型交界處可能同時包含多種覆蓋,小農地景中特別容易出現像元混合;小於 0.5 公頃的孤立樹叢或接近 10% 樹冠覆蓋門檻的地點,也可能難以穩定分類。把像元縮放到地籍邊界或單一地塊尺度,不會自動增加影像本身沒有的細節。若問題涉及地界、林地權利或法規判定,應回到原始影像、地籍資料和現地查核。
論文區域圖展示東南亞樹木作物與自然林交錯、斯堪地那維亞人工林、伊比利半島多種經營地景及西非農林複合系統。這些示圖不代表每區都有同規模獨立驗證。
瑞典案例則呈現森林組成的差異:論文估計,該國森林面積約三分之二屬人工造林或集約人工林,自然林約占國土五分之一。這項研究結果顯示,只看總樹木覆蓋會掩蓋類型差異;政策使用前仍須檢視驗證點數、區間和分類定義。論文中的瑞典估計
把 ForTy 接入既有地理分析前,先完成哪些檢查?
先把問題、類別定義、年份、研究範圍和可接受錯誤寫清楚,再用獨立在地樣本驗證門檻;最後核對資料格式、座標、授權與版本,才決定是否納入工作流程。
- 寫下分析問題。 要估森林總量、區分自然林和人工林,還是定位樹木作物?問題不同,應合併或保留的類別也不同。
- 對齊定義和年份。 檢查專案、法規或客戶採用的森林定義,並確認 2020 年基準是否符合分析期間;若要看變化,另外準備可比較年份的資料。
- 抽取在地驗證樣本。 在目標地區分生態區、土地用途與類別抽樣,記錄參考資料日期和判讀者;不要只挑高信心像元檢查。
- 按誤判代價設定門檻。 對每一類分別查看精確率與召回率。提高信心門檻可能減少錯納,也可能漏掉真實目標;用獨立樣本量化這項取捨。
- 核對接入細節。 確認 GeoTIFF 或雲端資料集版本、UTM 座標帶與專案座標系統、NoData 和分數欄位、授權條款、下載日期及處理紀錄。保存原始分數,不要只留轉成類別後的結果。
ForTy v1 可從 Figshare 和 Google Earth Engine 取得,採 CC BY 4.0 授權,提供分類層及相對信心分數層。接入 GIS 時,座標轉換、遮罩、重採樣與門檻都會影響結果;先小範圍試跑,記下版本和參數以利重現。
哪些分析適合使用 ForTy,哪些需要額外查核?
ForTy 可作為全球尺度研究、跨區比較和初步篩查的資料來源之一;單一地點判定、法規合規、投資或資源配置等高後果用途,應補上當地資料、獨立驗證與人工查核。
全球一致分類可作為森林類型比較的起點。監測近年變化須搭配更新資料;碳盤查或生物多樣性分析也須確認類別是否對應指標,不能把分類相同視為生態功能相同。若要從土地與生活脈絡延伸森林議題,可讀森林邊緣的資本與生活選擇。
資料定義與用途不匹配是常見風險:衛星可呈現冠層、光譜和空間脈絡,無法直接讀出完整管理史。供應鏈或地籍決策可用地圖定位待查區域,不能單獨作為地塊法律狀態證明。Google DeepMind 的ForTy 資料集文件列有分類層、格式和示範程式;專案仍須留下驗證紀錄。
正式納入前,以已知地區比對地面調查或可信區域圖層,記錄錯分與漏分,再決定門檻和覆核比例。對外報告應交代年份、版本、定義與不確定範圍。
- ForTy 是 2020 年全球森林類型基準圖,名目解析度為 10 公尺,分數是相對信心值。
- 六分類整體準確率 90.2%,但類別、地區和用途的表現並不相同。
- 先對齊分類與年份,再用在地獨立樣本設定門檻;高後果決策須增加資料和人工查核。
常見問題
ForTy v1 以 2020 年為基準,不是即時或當前狀況圖;解析度標示也不代表每處地景都能呈現相同細節。
常見問題
Q1:ForTy 地圖代表目前森林狀況嗎?
不代表。它描述 2020 年基準狀態,若要分析近年變化,需搭配其他年份影像或更新資料,並確保分類方法可比較。
Q2:10 公尺解析度是否代表每個分類都能精確到 10 公尺?
不是。10 公尺是像元網格大小,輸入資料有效解析度、混合地表、林地邊界和小型樹叢都會影響實際辨識。
Q3:可以直接用整體準確率決定是否採用嗎?
不建議。要先看目標類別和地區的驗證表現,並用獨立樣本測試門檻;整體數字無法說明每種錯誤對專案的影響。
參考來源
- Neumann M, et al. (2026). Global forest typology at 10-meter resolution for forest and land-use monitoring. *Scientific Data*, 13, 1434
- Google DeepMind (2026). Not All Forests Are Equal: Mapping the World’s Forests — Google DeepMind
- Google DeepMind. ForTy (v1): A Benchmark Dataset for Global Forest Types Mapping


