
很多人看到全球地圖,會先問解析度有多細、模型準不準。但要評估 Google DeepMind 的 ForTy 森林類型地圖與 OlmoEarth v1.3 是否能拿來用,得先問更前面的問題:眼前的是已經判好類別的地圖,還是供後續分析使用的模型表徵?兩種產品都整理地球觀測資料,交付內容與使用者還要完成的工作卻不一樣。
ForTy 2020 將全球地表整理成六類森林與土地利用結果;OlmoEarth v1.3 則為每個 10 公尺像元提供衛星觀測的數值嵌入,讓使用者建立自己的分類或變化分析。判讀時不能只看格網大小或發布方報告的評測成績,還要看分類定義、參照資料、年份、地區與具體任務能否對上。
一、先分清楚森林分類圖與地球觀測嵌入
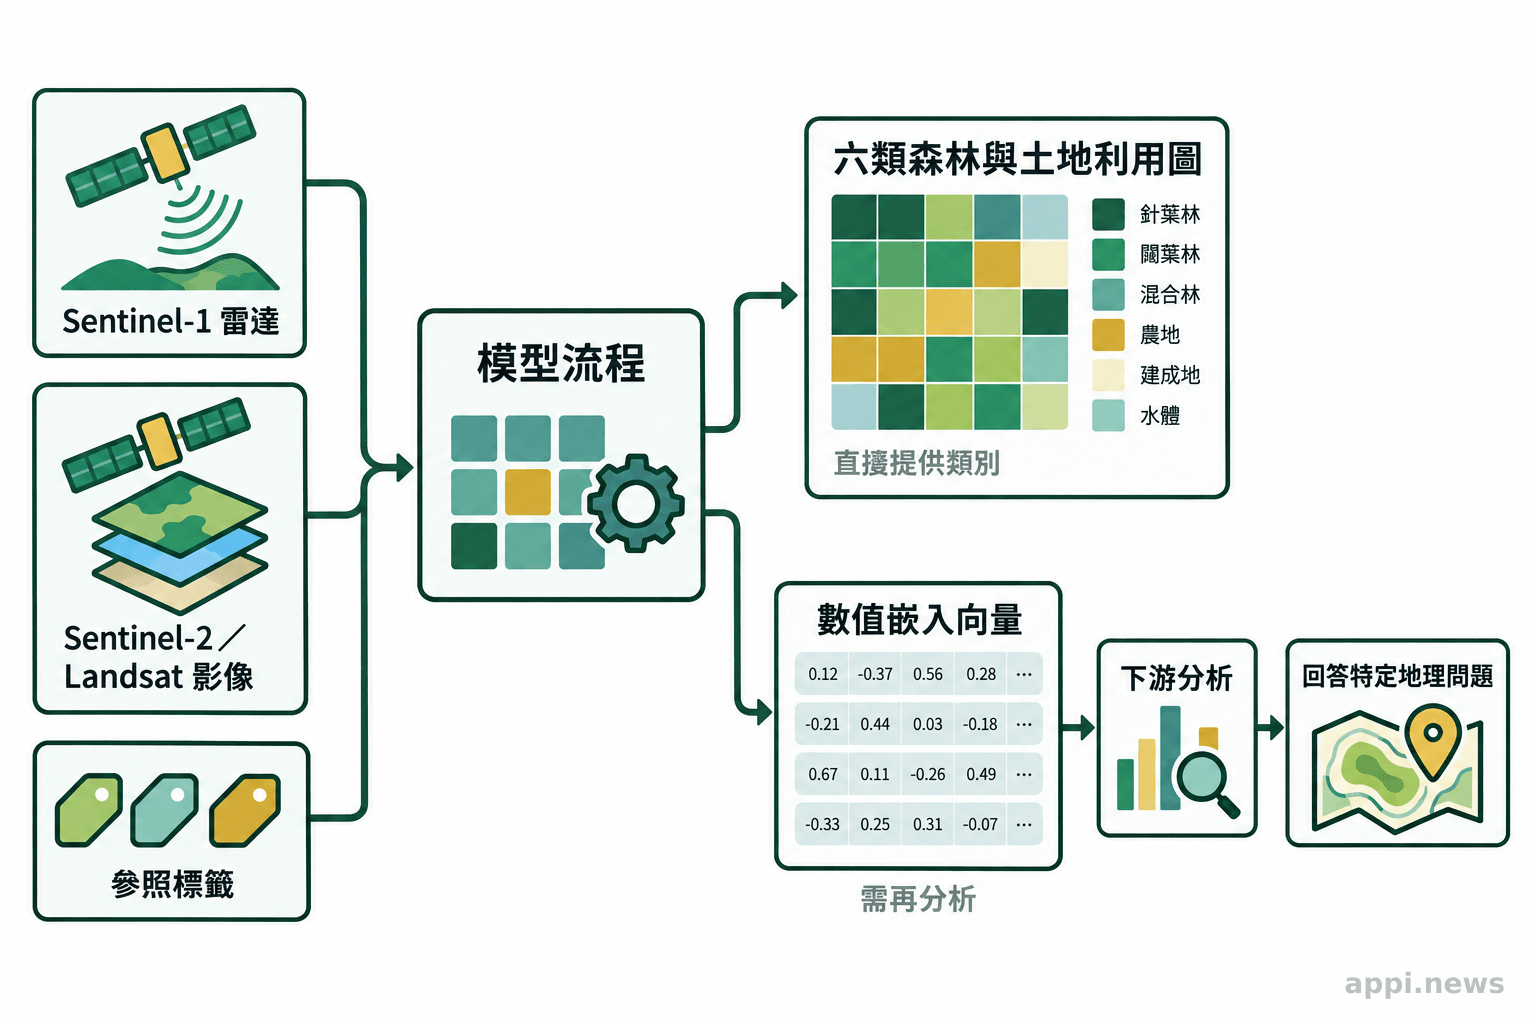
ForTy 直接提供森林與土地利用類別,OlmoEarth v1.3 提供可供其他任務使用的數值表徵。前者回答「這格被分到哪一類」,後者仍要經過分析或分類,才會回答特定地理問題。
ForTy 是 Forest Typology(森林類型分類)資料集,2020 年全球基準地圖將地表分為原始森林、自然更新森林、人工種植森林、人工林、樹木作物與農林複合,以及其他土地六類。它補足樹冠覆蓋圖的限制,區分森林、經營林地與油棕、橡膠等農作區,支援森林監測或供應鏈檢查。
OlmoEarth v1.3 的嵌入(embedding,將資料轉成模型可比較的數值向量)則不是一張現成的森林類別圖。它把雷達與多光譜衛星時間序列整理成每個像元的向量。相似的地表狀況,在向量空間中較接近;研究者或資料團隊可再用已標註樣本,訓練分類器產生任務專用地圖,也可比較不同年份的向量變化。
使用自有標籤辨認某類土地或比較年度變化時,嵌入表徵可作為分析起點;最後結果仍取決於標籤品質與驗證設計。
ForTy 研究團隊在論文中說明,資料集提供 2020 年、10 公尺尺度的全球基準圖,並把土地分成六類。這項描述界定了資料產品的範圍,閱讀地圖時仍需留意各地驗證資料與分類信心的差異。
地圖輸出的類別也會影響下游的判斷方式。若工作只是初步圈選可能的森林區,六類標籤可以協助縮小檢視範圍;若要估算某一類林地面積,就必須先確認「森林」、「人工林」與「樹木作物」等類別是否符合計畫採用的定義。類別名稱看似接近日常用語,背後卻可能連動不同的管理方式、統計口徑與責任判斷。把這些定義直接當成普遍共識,後續比較就可能失去基準。
嵌入資料的使用者則要多做一段建模工作。向量的相似性可以拿來找相近的地表特徵,但「相近」本身不會自動變成森林類型、土地利用或變化原因。使用者要先決定要分類什麼,再整理標註資料,選擇分類方法,最後檢查結果是否在目標地區成立。這讓嵌入更像可重用的輸入層,而不是已完成的地理答案;若手上沒有可靠標籤或驗證資料,模型表徵再完整也難以支撐正式判斷。
二、全球資料如何從觀測走到模型輸出?
它們都依賴衛星觀測與參照資料,但模型如何把觀測轉成標籤或向量,決定了輸出能回答什麼問題。檢查時間範圍、感測器、分類定義及訓練資料,才知道資料的適用邊界。
ForTy 論文指出,分類流程使用約 170 萬個全球標註樣本,結合弱監督與主動學習產生各類別信心圖。標籤來自專家調查、國家或區域資料集及難判地點檢視;多年衛星嵌入協助辨認種植與採伐特徵。
大量標註樣本能提供全球尺度的訓練訊號,但樣本數不能單獨說明地圖品質。不同地區的資料來源、標註年份和採用定義可能不一,某些地貌或經營方式也較難取得一致判讀。弱監督可整合不完全一致的標籤,主動學習則能把需要專家判斷的案例集中處理;這些方法改善資料形成效率,仍不能代替獨立驗證。讀者若要將結果用於特定地區,應追問驗證樣點是否涵蓋該地類型,以及容易混淆的類別是否被分開檢視。
模型類別依賴定義。原始森林、自然更新森林、人工種植森林與人工林涉及不同經營脈絡,光看影像未必能分清。ForTy 對齊聯合國糧農組織(FAO)及歐盟規範;本地定義不同需先對照。
OlmoEarth v1.3 將一年期 Sentinel-1 雷達、Sentinel-2 多光譜與 Landsat 資料整理成每格向量,提供 128 維及較小的 64 維版本。向量沒有森林類別標籤;分類工作仍需標註、分類器及未參與訓練的檢驗資料。
這種處理方式把原始衛星影像轉成較容易供下游模型使用的表徵,但也把部分設計選擇藏進資料生成流程。感測器的觀測條件、時間窗口、雲遮蔽處理和嵌入版本都會影響輸入特徵。兩個地點的向量若相似,只能表示模型整理出的觀測表徵接近,不能直接推論土地用途相同,也不能單靠向量差異判定變化由何種因素造成。分析者需要把向量接回原始影像、時間記錄與場域知識,檢視模型注意到的差異是否符合研究問題。
若團隊打算跨年度比較,也要先確認每年資料是否採用一致的感測器組合、生成流程與版本。版本更新可能改善表示能力,也可能造成特徵分布變化;若將不同版本的向量直接串接,分類器可能把版本差異當成地表變化。建立資料目錄時,至少記下地區、日期範圍、嵌入版本、來源影像與前處理方式,日後才能重現比較結果。這些紀錄不是行政附註,而是釐清結果來源、排查異常的重要線索。
三、10 公尺解析度代表什麼,又不代表什麼?
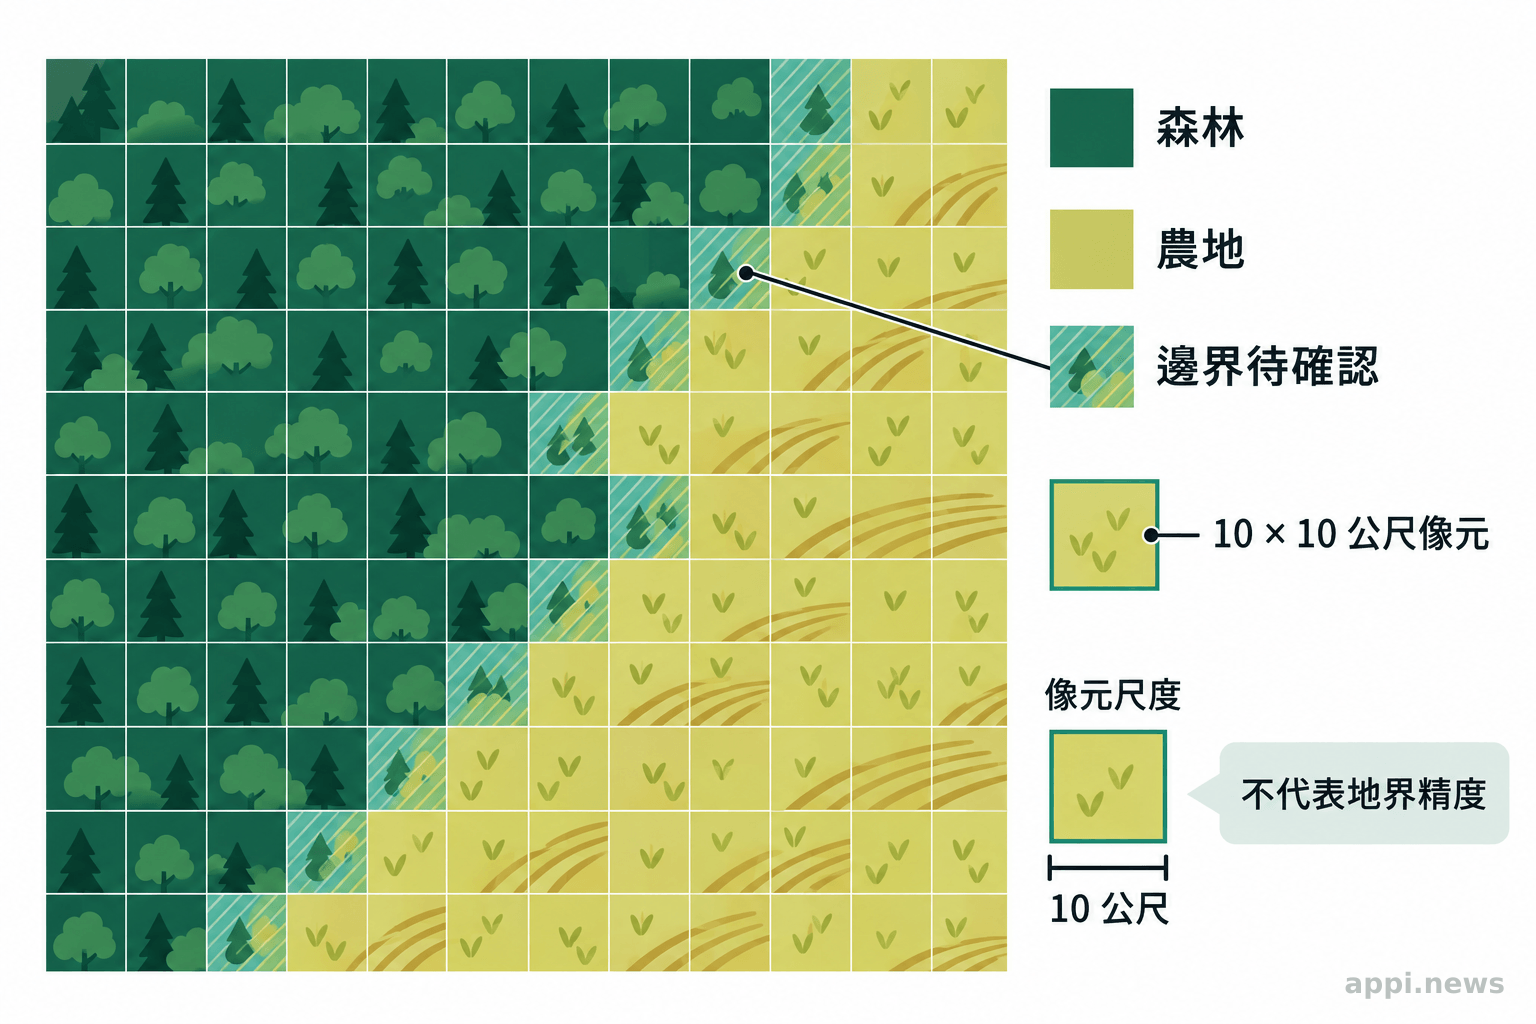
10 公尺描述網格的空間尺度,不等同於分類正確率、林地邊界精度或現地測量結果。正確率要看獨立驗證資料,邊界是否適用則要依用途與當地參照另行判斷。
10 公尺像元是約 10 乘 10 公尺的網格,不保證格內地表一致,也不代表模型能精準畫出地籍或林班界線。森林與農地交錯時,單一標籤會壓縮複雜狀態;較小像元也不會自動消除觀測誤差或定義差異。
ForTy 論文抽取 9,100 個分層隨機樣點,其中 8,190 個完成專家共識並納入準確度估計。六類整體正確率為 90.2%;自然森林分類為 94.8%;森林與非森林區分為 95.5%。數字對應不同任務,不能互換或視為每個地點的個別把握;應一併看樣點分布、類別比例及研究區差異。
論文也提供各類別的相對信心圖,可挑出需人工覆核的像元;若本地樣本稀少,仍應檢查分數是否校準得當。
抽樣設計與整體分數的解讀同樣重要。分層隨機抽樣可以讓不同類別納入評估,但全球總體數字仍會受到樣本配置和類別占比影響。若某類在研究區內很少見,即使整體正確率高,該類的漏判或誤判仍可能足以改變小區域的結論。實務報告應同時呈現各類別的混淆情形、樣本數與不確定性,避免只挑一個最高的百分比當作所有用途的品質保證。若資料將支援政策或稽核,還要記錄錯分可能造成的後果,決定哪些情況必須交由人工覆核。
空間解析度也會和製圖目的互相牽動。全球產品需要使用可跨區域一致處理的流程,地方專案則可能需要更細的影像、地籍或林班資料。把全球圖層疊在地方底圖上,容易讓格網邊緣看起來像精確界線;顯示比例尺、像元網格和資料年份,有助使用者辨認這只是特定尺度的分類結果。若決策單位需要地界等級的資訊,應回到主管機關圖資與現地測量,不能將全球網格當作法律或管理邊界。
OlmoEarth v1.3 的評測也要依任務解讀。發布方報告 128 維嵌入在 27 項評估中的 20 項取得最高分,這只代表特定基準與設定的比較,不代表所有地區的實地效能;換了時段、感測器或標籤,結果也可能不同。
比較基準時,應查看評估任務、訓練資料和測試資料如何切分,以及被比較的方法是否使用相同資訊。若測試樣本與訓練區域高度相近,分數反映的可能是熟悉區域內的辨識能力;若實際工作是跨地區部署,更需要留出不同地區或年份檢查遷移表現。發布方評測可以幫忙判斷是否值得進一步試用,卻不能替代目標使用者的驗收。先以代表性小區域做概念驗證,找出錯誤類型與必要標註成本,再決定是否擴大範圍,通常比直接套用全球結果更容易控制風險。
四、模型表徵如何接進實際地理工作流?
要快速查看既定類別,可從 ForTy 這類分類圖開始;要建立特定地區或任務的圖層,可從 OlmoEarth 嵌入搭配本地標註開始。兩條路都需要確認年份、來源及驗證方式,差別在於前者要評估現成標籤是否適用,後者還要承擔模型訓練與維護。
使用 ForTy 時,確認需求是否對應 2020 年基準、六類定義與資料涵蓋範圍。要回答後續變化,需比對其他年份資料及其涵蓋地點、版本;政策或稽核用途還須確認適用規範。
OlmoEarth 的流程是選研究區、年份或月份、衛星來源及嵌入版本,再用已確認的標註訓練分類器,並以保留樣本或地面資料驗證。探索階段可先用少量標籤試看;正式決策則要讓驗證樣本涵蓋實際地形、季節與類別。
這兩種資料接入既有工作流時,應先指定輸出負責回答哪一個環節的問題。森林盤點可把全球分類圖當成候選區域清單,交給熟悉地方資料的人員核對;土地變化監測則需固定比較期間與變化定義,避免把季節差異、影像缺漏或分類器更新誤當成土地轉變。若工作流程會將結果交給不同角色使用,地圖圖層應附上類別說明、資料日期和信心資訊,並清楚標示需要人工確認的位置。如此可減少讀者把模型產物當成無條件成立的現況紀錄。
維運上還要考慮資料更新與責任分工。全球基準圖的更新頻率可能和地方專案的決策週期不同;團隊若自行訓練分類器,就需安排標籤更新、模型重訓與品質追蹤。資料來源改版、雲端儲存成本或授權條款變更,也會影響長期重現。正式採用前可以先指定一位資料負責人管理版本與來源,一位領域人員審查分類定義,再由使用單位確認錯誤的可接受程度。把這些角色放進流程,能讓結果出現差異時找到可追溯的處理路徑。
| 評估面向 | ForTy 2020 分類圖 | OlmoEarth v1.3 嵌入 |
|---|---|---|
| 直接輸出 | 六類森林與土地利用標籤及信心資訊 | 每個像元的數值向量 |
| 適合先回答 | 2020 基準圖層將地表分成哪些類別? | 哪些地點相似,或自有標籤能否形成任務圖層? |
| 後續工作 | 檢查定義、信心、地區和基準年份適配 | 準備標註、訓練分類器並驗證結果 |
| 主要限制 | 類別規則及基準年份未必符合本地需求 | 向量本身不是可讀類別,需下游分析 |
Allen Institute for AI 的發布資料說明,OlmoEarth v1.3 以一年的雷達與多光譜衛星時間序列,為全球 10 公尺像元產生 128 維向量。這是嵌入資料的規格;要轉成森林或其他地表類別,仍需下游模型或分析。
五、評估可重用性時要檢查哪些條件?
先確認任務、地區與年份,再核對分類定義、參照資料、獨立驗證、取得方式和授權。若資料要影響在地管理或合規判斷,應以當地資料做適配性檢查,並留下資料版本與人工覆核紀錄。
第一步是把決策問題寫成可檢驗的句子,例如要辨認森林類型、估算地表變化,或找出與某種地貌相似的位置。問題不同,所需輸出也不同。分類圖不一定適合每一種變化偵測;嵌入向量雖可重用,仍可能需要額外標註才能回答目標問題。
第二步核對空間與時間範圍。ForTy 2020 是基準年份地圖;官方另提及 2017 至 2025 年的早期年度序列,但發布狀態與可用涵蓋不必然等同於每個地區都已齊全。OlmoEarth v1.3 公布的全球預先計算嵌入,發布時 2023、2024、2025 年為全球資料,2017 至 2022 年則只涵蓋部分國家。使用者應看特定地區、年份的資料記錄,避免把版本介紹中的「全球」理解為每個時間切片都有完整覆蓋。
第三步檢查來源與治理:追溯感測器、日期、標註規則、模型版本與授權。OlmoEarth v1.3 附來源影像清單,但仍要固定版本、記錄轉換,確認商用、再散布及保存條款。
資料治理還包括輸出如何被解讀與保存。若分析結果會被匯入地理資訊系統或提供給合作單位,欄位名稱、類別代碼、座標系統與缺值處理都要先對齊;否則圖層即使成功載入,也可能在重投影或欄位轉換時產生錯誤。保留原始輸入、轉換程式版本、模型版本與輸出摘要,可協助日後重算或比較。對外分享時則需分清資料集授權、來源影像條款和衍生產品的使用條件,不能只憑「可以下載」就推定可任意再散布。
在地驗證不只是在地圖上抽幾個點看起來合理。樣本要涵蓋預期使用的季節、地形、土地經營型態和容易混淆的邊界;抽樣位置也應獨立於模型信心值,避免只挑模型有把握的像元。若人力有限,可先列出錯誤代價最高的類別與區域,再優先收集參照資料。每次驗證都記下日期、判讀依據、判讀者和不確定案例,後續才看得出模型品質改變,究竟源自新資料、分類定義還是標註方式。
最後建立驗證方案:依地區、年份與類別分層抽樣,保留未參與訓練的資料,人工覆核高風險或不確定區。風險篩查採保守門檻;面積估算要檢查分類偏差。
重用前的檢查順序
- 寫明要回答的問題、使用地區與目標年份。
- 核對分類定義、衛星來源、標註或參照資料,以及版本紀錄。
- 以未參與建模的在地樣本驗證,分開查看各類別表現與不確定區。
- 確認資料授權、取得方式、儲存成本與後續更新責任。
- ForTy 2020 是六類森林與土地利用基準地圖;OlmoEarth v1.3 提供下游可用的嵌入向量。
- 10 公尺是像元尺度,不代表地面邊界精度或每個地點的分類正確率。
- 重用前要對齊地區、年份、類別定義、在地驗證與授權條款。
常見問題
Q1:ForTy 的 10 公尺地圖可以直接用來判斷地籍界線嗎?
不宜。10 公尺是格網尺度,界線仍須以權威圖資及現場資料確認。
Q2:OlmoEarth v1.3 的嵌入資料是森林類型地圖嗎?
不是。它以數值向量表示衛星觀測特徵,需要搭配分類器、標註或其他分析流程,才能產生森林類型等特定主題圖層。
Q3:兩項資料都有全球覆蓋,是否適合台灣各縣市直接採用?
不能直接推定。先查看實際涵蓋範圍與分類定義,再用台灣在地資料檢查。
參考來源
- Neumann M, Raichuk A, Potapov P, Lesiv M, Overlan M, Rey M, Rajakumar R, Conserva M, Stanimirova R, Sims M, Carter S, Goldman E, Jiang Y, Scheibenreif L, Georgieva I, Shchepashchenko M, Fritz S, Clinton N, Stanton C, Morris D, Purves D. (2026). Global forest typology at 10-meter resolution for forest and land-use monitoring. *Scientific Data
- Allen Institute for AI. (2026). OlmoEarth v1.3: State-of-the-art embeddings for the whole planet. Hugging Face


