評估 RAG(檢索增強生成)時,常先比較模型參數量或排行榜名次;但真正影響答案是否找對資料的,是查詢能不能在自家知識庫裡找到相關段落。Google 新推出的 EmbeddingGemma 2 將文字、程式碼、圖片、影片和音訊映射到共同的向量空間,完整版本共 740M 參數。這讓它成為值得測試的新選項,卻不能單憑模型規格判定它適合每個繁體中文知識庫。
參數量不是 RAG 選型答案,先看檢索要解決什麼問題
先看使用者會問什麼,以及系統需要從哪些資料中找出答案依據。模型大小和公開分數可協助篩選候選者,實際檢索品質仍要用代表自家工作的查詢測試。
嵌入模型(embedding model)會把文字或其他內容轉成一串數值,也就是向量。語意相近的查詢與文件通常會在向量空間裡較接近,檢索系統便能依相似度排序,再把找到的段落交給生成模型回答。它負責「找資料」,生成模型負責「整理回答」;回答品質會受到兩個環節以及資料內容影響。
例如員工查「育嬰留停期間保險怎麼算」,知識庫可能把相關規定分散在法規頁、內部人資說明和表單指引。若文件切得太碎、標題未併入內文,或查詢帶有模型不熟悉的台灣用語,即使嵌入模型規模更大,也未必能把正確段落排到前面。這時應先查錯誤來自資料更新、切塊方式、檢索設定,還是模型語意理解,再決定要更換哪個環節。
公開排行榜回答的是模型在指定資料集與任務上的相對表現。它適合初步縮小候選範圍,不能直接推算企業內部文件的命中率。團隊若只看一個總分,很容易忽略查詢是精確找條文、跨語搜尋產品規格,或從長篇紀錄定位單一事件,這幾種需求的失敗型態並不相同。
EmbeddingGemma 2 的規格與比較主張要分開讀
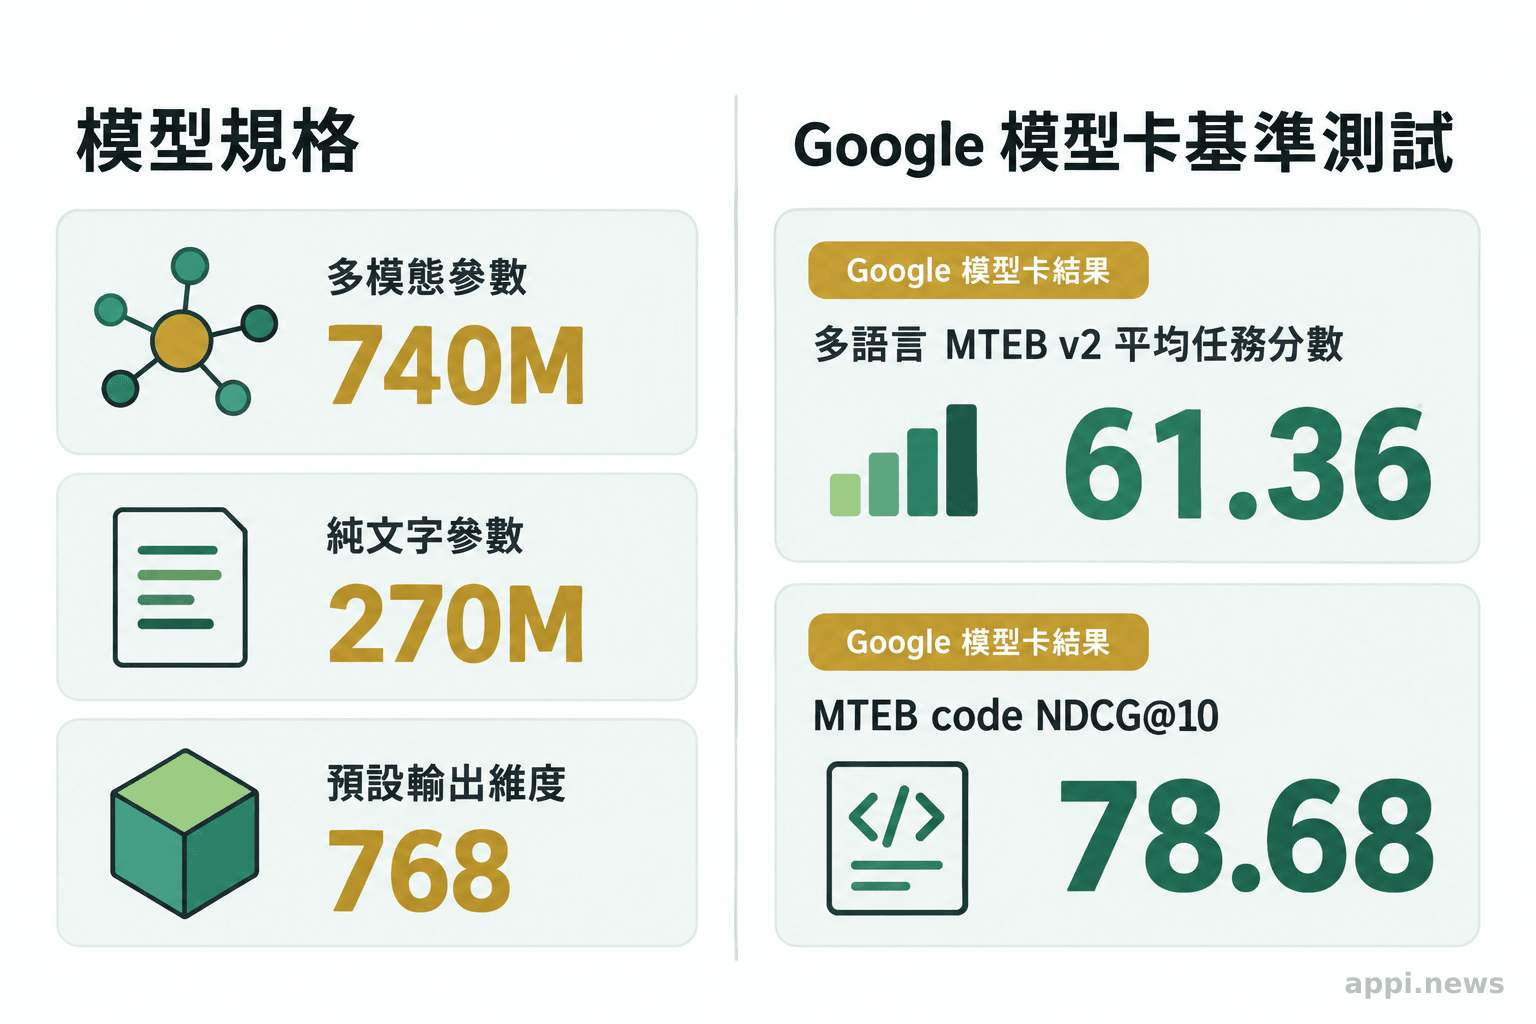
740M 是包含文字、視覺與音訊組件的完整多模態模型規模;官方列出的純文字配置為 270M。模型卡提供特定 benchmark 的結果,這些數字仍需和自有資料測試分開解讀。
EmbeddingGemma 2 的輸入涵蓋文字、程式碼、圖片、影片與音訊,輸出預設為 768 維向量。模型卡指出,文字骨幹與嵌入組件共 270M 參數,視覺編碼器 170M、音訊編碼器 300M,可視用途選擇載入組件。這個模組化設計對只做文字檢索的團隊有實際意義:部署規劃應確認使用的推論套件能否略過不需要的模組,並實測載入後的記憶體和速度。
Google 的模型卡列出 MTEB multilingual v2 平均任務分數 61.36,EmbeddingGemma 前代為 61.15;MTEB code 的 NDCG@10 則從 68.76 提升至 78.68。官方也列出影像、影片和音訊等不同基準的數據。這些結果證明模型在對應測試設定中的表現,沒有直接回答台灣公司內部 FAQ、合約或客服紀錄能否更容易被找回。官方資料亦提醒,支援 100 多種語言不代表各語言表現相同。
「模型可能無法在所有語言中展現相同的效能。」這是 Google DeepMind 在 EmbeddingGemma 2 模型卡列出的限制,繁體中文表現仍應由目標資料驗證。
Google 將 EmbeddingGemma 2 描述為適合裝置端多模態嵌入的開放模型,並以大型模型比較、低延遲和較少資源需求作為主要特色。這是發布方的產品定位。The Decoder 的報導補充了發布資訊與官方比較主張,但也註明來源為 Google,不能視為對所有模型、語言和 RAG 流程的獨立評測。採購或遷移決策應追到基準資料集、評分方式、比較對象和硬體條件。
大型與小型嵌入模型要在同條件下比較
用相同文件、查詢、切塊策略、檢索參數與硬體比較候選模型,並同時記錄命中品質、延遲、記憶體和索引空間。參數較少可能減輕部分推論負擔,整體成本仍由整套服務的使用方式決定。
繁體中文測試集應包含常見問法、同義改寫、台灣慣用詞、英文縮寫、產品型號、人名或法規名稱,也要放入容易混淆的近似文件。像「健保自付額」和「商業保險理賠」字面相似,正確答案卻可能來自完全不同的文件。讓熟悉業務的人標註哪些段落可回答每個問題,才能分辨模型是找到了相關內容,還是只找出表面上相似的句子。
硬體評估不能只抄模型參數。要在預期的併發量、批次大小、文件長度和更新頻率下測量每次嵌入的延遲、吞吐量、記憶體用量和耗電或雲端費用。向量維度也會影響資料庫儲存和相似度搜尋成本。EmbeddingGemma 2 支援 768、512、256、128 維輸出,官方模型卡指出縮短向量可節省儲存,但維度降低可能犧牲品質,尤其 128 維的多模態表現下滑較明顯。若採用截斷向量,查詢端和文件端維度必須一致,並依官方指引重新正規化,再以資料集確認檢索排序有沒有變化。
授權與部署同樣需要實際盤點。Google 模型卡標示 Apache 2.0 授權,但團隊仍應核對使用的權重版本、相依套件及部署方式是否符合組織的商用與資訊治理要求。本地執行能控制資料處理位置,並不會自動處理帳號權限、日誌、備份和存取稽核。若資料含客戶或機密資訊,應把這些項目列入上線條件,也要確認模型和向量資料庫的更新責任由誰承擔。
比較方案時可用一張表固定檢查面向,避免某個亮眼分數蓋過了其他限制:
| 評估面向 | 要記錄的內容 | 對選型的意義 |
|---|---|---|
| 檢索品質 | Recall@k、MRR、nDCG、錯誤案例 | 看相關段落是否排在可用位置 |
| 效能與資源 | 延遲、吞吐量、記憶體、硬體型號 | 評估尖峰流量和維運負擔 |
| 向量與索引 | 維度、索引大小、重建時間 | 估算儲存需求與遷移成本 |
| 語言與資料 | 繁體中文、領域詞、跨語查詢 | 確認結果符合實際使用情境 |
| 部署與治理 | 授權、資料位置、權限、日誌、備份 | 檢查能否符合組織要求 |
台灣團隊如何用自己的資料做 RAG 評測
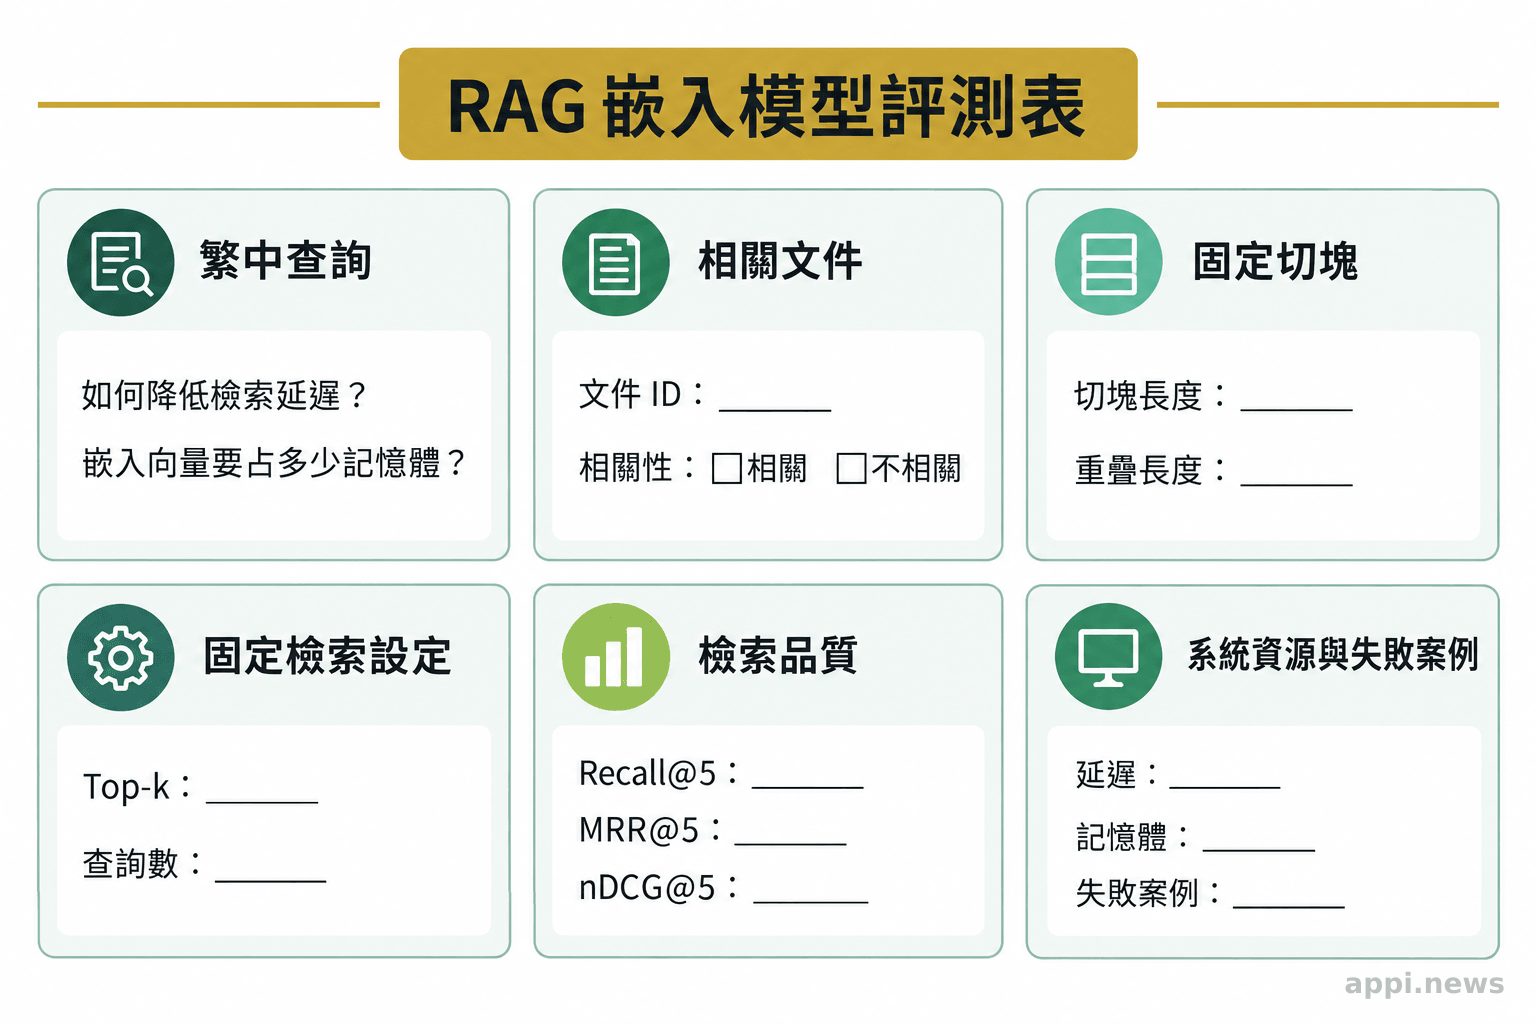
準備一份代表真實工作的繁體中文測試集,固定文件處理和檢索設定,讓現有模型與候選模型跑相同流程。除了總分,還要保存個別失敗案例與系統資源數據,才能知道差異是否值得導入。
先從使用紀錄、客服問題或內部需求整理一批代表性查詢,並排除敏感個資或依規定去識別。每個問題都標出可接受的答案來源;若有多份文件都能回答,需一併標註。測試集涵蓋不同難度:精確詞句、口語改寫、縮寫、跨語查詢、文件版本差異和根本無法回答的問題。後者可檢查系統會不會把不相關內容硬當答案依據。
接著固定文件清理、標題處理、切塊長度與重疊比例、查詢前綴、向量維度、相似度算法和取回數量。一次只改嵌入模型,其他條件保持一致,才看得出模型差異。EmbeddingGemma 2 的模型卡說明文字檢索可分別使用查詢與文件提示格式;若漏掉或混用,測試可能量到的是設定錯誤。每項設定都應記錄在版本控制或實驗紀錄,讓下一次評測可重跑。
指標要能反映使用者看到的結果。Recall@k(前 k 筆召回率)看正確段落有沒有出現在前幾筆;MRR(平均倒數排名)看第一筆正確結果排得多前;nDCG(正規化折損累積增益)可處理相關程度不同的多筆結果。指標不必全部採用,應配合「使用者需要幾筆上下文」和「錯過正確段落的代價」來選。除了整體平均,也要按查詢類型、部門、文件來源拆分,否則少數容易題目可能遮住特定類型的明顯退步。
結果表同時記錄執行硬體、批次、索引參數和模型精度,並保存未命中的查詢、檢索到的錯誤文件、延遲分布與記憶體峰值。當排序分數改善卻回答沒有變好,問題可能落在切塊、重排序(reranking,對初步結果再排序)或生成模型如何使用上下文。這些失敗案例能幫團隊判斷該優先修資料管線,還是值得再試另一個嵌入模型。
「省略建議的任務前綴可能使嵌入品質降低。」Google DeepMind 模型卡將查詢與文件使用正確任務提示列為文字檢索的實作建議。
- 挑選能代表實際工作的一組繁體中文文件與查詢,為每題標註相關段落。
- 固定切塊、任務提示、維度、檢索設定和測試硬體,再執行現有模型與候選模型。
- 一起檢查 Recall@k、MRR 或 nDCG、延遲、記憶體、索引大小及未命中案例。
- 選定候選方案後先小範圍試用,追蹤錯誤、權限與資源使用,再決定是否擴大。
評測結果如何轉成選型與上線判斷
評測結果應先用來判斷是否進入小範圍試用,不能單憑公開分數或概念驗證就推定全面適用。上線前還需確認檢索穩定度、硬體容量、資料治理和遷移方案。
若 EmbeddingGemma 2 在代表性查詢上維持或提升命中品質,且資源與延遲符合服務目標,可安排灰度試用,先讓一小部分流量或使用者採用。觀察內容包括錯誤答案的來源、未找到資料的比例、延遲變化、系統負載,以及使用者是否需要改變查詢方式。若新舊模型結果差異集中在特定領域,可先針對該類文件改善標題、切塊或術語整理,再重跑同一測試。
更換嵌入模型會改變向量空間。舊模型產生的文件向量與新模型產生的查詢向量通常不能直接混用,遷移時要評估是否需要重算文件向量、重建索引,並保留回復舊版的方式。可以先建立新索引,在影子流量中比較新舊結果,再按批次切換;遷移紀錄應涵蓋模型版本、維度、正規化方式和索引建立時間。這些安排能把資料重建失敗或檢索退化控制在可觀察範圍。
生成端仍會影響最終答案。更好的嵌入模型未必能補上知識庫本來缺少的內容,也無法保證生成模型忠實引用取回段落。若測試看到檢索已找對資料、回答仍出錯,應檢查上下文排序、提示設計和回答引用機制。選型最後要回到團隊的實際使用情境:檢索品質是否達標、服務能否負擔、資料如何受控,以及日後如何監測和回歸測試。
- EmbeddingGemma 2 完整版本有 740M 參數,純文字配置為 270M;不同配置不能只用總參數量比較。
- Google 公布的 benchmark 是特定測試設定下的結果,繁體中文自有資料仍須同條件實測。
- 比較時同步記錄命中品質、延遲、記憶體、向量維度、授權和資料治理要求。
- 更換模型通常涉及重建文件向量與索引,應先小範圍試用並保留回歸測試。
常見問題:EmbeddingGemma 2 能直接取代現有模型嗎?
是否取代要由自有資料和服務條件決定。先用同一測試集比較,再計算索引遷移、硬體和維運成本。
Q1:參數較少是否一定比較省成本?
不一定。純文字配置的參數規模較小,可能降低模型載入或推論的部分負擔;實際成本還包括硬體、併發、向量資料庫、索引儲存、耗電與維運時間,需在目標環境量測。
Q2:公開排行榜高分代表自家知識庫效果好嗎?
不代表。benchmark 使用指定語言、資料和評分方式,自家文件的領域詞彙、格式與查詢分布可能不同。排行榜可用於候選篩選,最終仍要以代表性查詢和相關段落標註測試。
Q3:更換嵌入模型後,舊向量索引還能沿用嗎?
通常需要評估重建。不同模型的向量空間未必相容,文件向量與查詢向量須使用相同模型、維度及處理設定。建議建立新索引並平行驗證後再切換。
Q4:本地部署就能確保資料安全嗎?
本地部署可控制資料處理位置,但仍須設計存取權限、日誌保存、備份、更新和稽核流程。若資料包含個人、客戶或機密資訊,應依組織規範確認誰能存取及資料如何保存。
參考來源
- Google DeepMind (2026). *EmbeddingGemma 2 model card*. Google AI for Developers
- Dua S, Schechter Vera H (2026). *EmbeddingGemma 2: an open, lightweight multimodal embedding model*. Google
- Grootendorst M, Ballantyne I (2026). *EmbeddingGemma 2: The Developer Guide*. Google Developers Blog
- Bastian M (2026). *Google claims EmbeddingGemma 2 outperforms rival embedding models twice its size*. The Decoder