
很多人會先問 AI 語音能不能笑、能不能耳語。更重要的是,提示能否轉成合適表演,重生後是否仍像同一個角色?ElevenLabs 於 2026 年 9 月 28 日發布 Eleven v4 與低延遲版 v4 Turbo,主打情緒、節奏與笑聲、耳語等音訊標籤。
是否適合交付,仍須檢查提示命中、跨段一致與後製工時。模型介紹不能取代實際聽審。ElevenLabs 官方發布說明
Eleven v4 新增的表演控制,解決的是哪個問題?
Eleven v4 把語音表演提示納入文字轉語音流程,並主打更自然的情緒與說話者一致性。它提供新的控制選項,實際能否減少重錄與修整,仍要用團隊自己的腳本驗收。
既有流程常靠切句或補錄調整情緒。文字轉語音(TTS)把文字和聲音設定轉成音訊,仍需聽審。Eleven v4 可加入 [whispers]、[laughs] 等標籤及多說話者提示。
提示只是控制訊號之一。輸入稿應交代說話者、對象和情緒,否則標籤可能產生突兀表演。試用時保存稿件、聲線與模型設定,方便重現結果。
ElevenLabs 稱模型能理解語氣、節奏、情緒與上下文。發布文所列盲測偏好與 Artificial Analysis 排名未交代足以判讀的測試範圍,因此不宜據此推論不同語言或製作條件下的表現。
ElevenLabs 提示指南提醒,音訊標籤的遵循仍在改進,生成結果需保留人工聽審。官方提示指南
笑聲、耳語等提示如何進入生成流程?
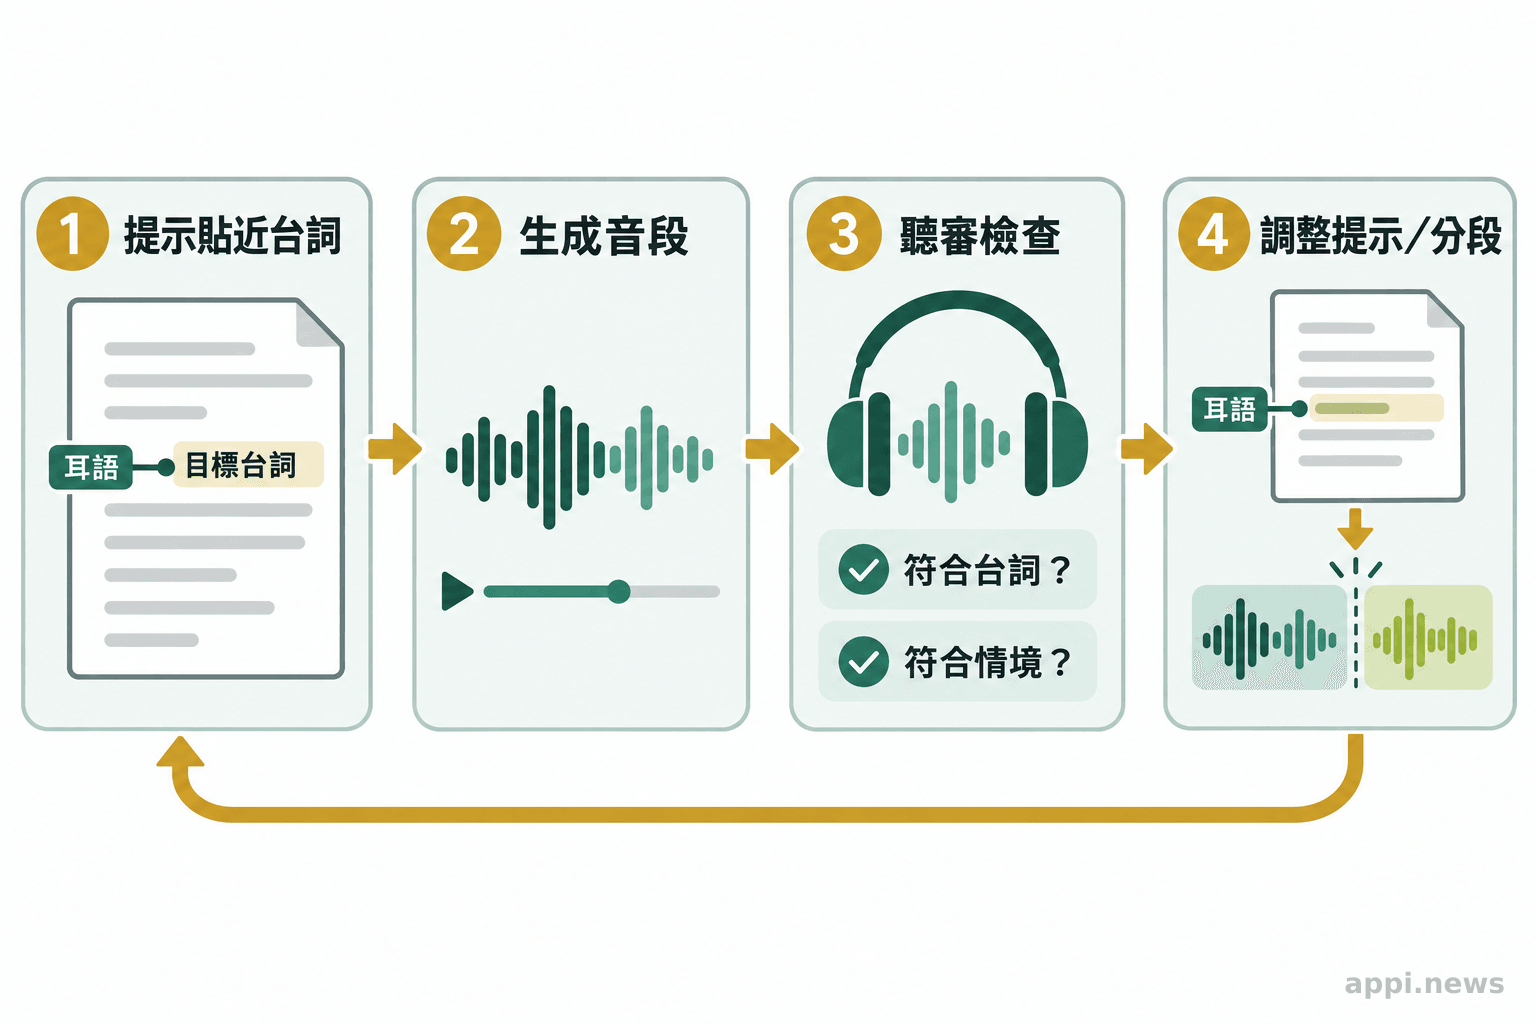
把簡短的音訊標籤放在需要改變表演的位置,再用完整句意和上下文限制它的作用範圍。標籤是生成指示,不是逐字逐秒的演出保證。
官方文件列有 [laughs]、[whispers]、[sighs]、[curious] 等標籤,應放在目標台詞附近,避免同段混用衝突情緒。
產品旁白若要先停頓再耳語,可拆成兩個片段加提示,並檢查接點是否自然。
標籤需符合角色設定,並留意情緒幅度和音色。官方指南指出,訓練資料包含相似表演時,標籤較容易奏效;新聲線仍應先用短句試聽,檢查重音、速度和情緒。若效果不符,調整標籤位置、措辭或分段,再測一次。
ElevenLabs 音訊標籤文件說明,v3、v4 的相關介面不支援 SSML break。依賴停頓標籤的流程,切換前應按實際模型與介面確認相容性,並測試字幕和音檔對齊。官方音訊標籤文件
試用只需保留原稿、角色設定、標籤、所用模型和採用音檔,並標記問題時間碼,方便定位差異。API 或網頁介面的功能、帳戶權限可能不同,正式導入前須用實際帳戶確認。
為什麼長段落與多角色製作容易失去一致性?
聲音一致性受聲線、文本和提示影響;切段與版本管理則是製作流程的控制項。長篇作品需要逐段確認角色聲音和表演幅度。
長篇旁白、遊戲對話或有聲書若混用聲線、模型、提示或不同版本的台詞,片段間可能出現音色、語速和情緒落差。這是製作時需檢查的變因,不能據此推論 v4 在所有長篇作品中的表現。
將腳本切成可驗收片段,台詞改動時只重生受影響部分;保留角色參考音檔,對照音色、語速、情緒和剪接點。記下模型、聲線和退回原因,協助定位問題與估算工時。
官方提示指南指出,訓練資料中已有的表演較容易重現。Eleven v4 提示建議
Eleven v4、v4 Turbo 與既有模型怎麼選?
先核對官方功能和帳戶權限,再以繁體中文素材試聽;旁白或角色表演可評估 v4,即時流程可比較 v4 Turbo 的延遲。兩者皆支援音訊標籤,實際功能依帳戶與介面而異。
ElevenLabs 將 v4 定位為高表現力合成模型,支援多說話者對話;v4 Turbo 主打低延遲。官方數據不等於各地區與 API 設定下的實測結果。
官方模型總覽將 Multilingual v2 定位為長篇生成較穩定,使用前仍應以自有長文試聽驗收。官方模型總覽
| 比較項目 | Eleven v4 | Eleven v4 Turbo | 既有模型,例如 Multilingual v2 |
|---|---|---|---|
| 官方定位 | 高品質、情緒表現與多角色 | 即時應用、較低延遲 | 官方將其定位為長篇生成較穩定,仍須用自有長文試聽驗收 |
| 表演標籤 | 支援 | 支援 | 不可假設有相同標籤功能 |
| 候選場景 | 旁白、角色配音、有聲內容 | 支援介面下的即時語音/對話流程 | 需以自有長文測試 |
| 試用要點 | 聲線及情緒能否持續一致 | 延遲是否符合互動節奏 | 音質是否滿足交付要求、舊提示能否沿用 |
上述為官方定位,並非獨立測評。繁體中文試用檢查發音、專有名詞、語調、成本、延遲與授權,並比較短句和長段落。若結果難以重現,可整理提示範本。
由腳本、剪輯和核准人員共同檢查表演意圖、片段可用性與品牌語氣;意見不一致時,標出句子或時間碼重測。另確認聲音複製、下載和分享權限,以及不可上傳的素材。
哪些旁白、配音或產品語音流程值得先試?
優先挑有明確表演落差、可取得現行模型對照音檔的短段落,並讓實際剪輯和審核人員參與評分。試用結果應同時記錄品質、工時、延遲與使用權限。
旁白可挑含情緒轉折和專有名詞的腳本,檢查停頓、耳語及修音需求。角色配音則比較同一角色不同場景的聲線一致性與接話連貫度。
產品語音要檢查延遲、中斷恢復和品牌語氣,也要確認資料傳送、錯誤提示及轉交人工的方式。模型生成音檔仍須通過產品驗收。
- 選定腳本:包含情緒轉折和表演提示。
- 建立對照:固定聲音、文字和輸出設定,記錄模型、標籤與生成次數。
- 盲聽評分:檢查提示命中、聲音連續、發音、情緒及可剪接性。
- 記錄成本:比較重生次數、修整工時、等待時間與整合工作量。
- 檢查權利與資料:核對聲音授權及本人同意;依平台規範、合約和適用規定確認標示義務。涉及個資時檢查資料存取設定。
試用時先訂出通過條件:專有名詞讀音、角色輪替、表演提示和片段接合是否符合要求。比較多次生成的平均修整工時、延遲與費用,也確認失敗後能否重現或回退。達標再擴大素材範圍試用。
ElevenLabs 要求複製聲音前確認權利及本人同意;使用演員、員工或客戶聲音時,也要核對同意範圍。官方即時聲音複製說明
未公開素材上傳前,應確認服務條款並限制存取。
- Eleven v4 把笑聲、耳語和情緒提示納入語音合成控制,官方主張更能理解表演意圖與保留聲音特徵。
- 提示效果仍受聲線訓練素材、文本、標籤寫法和生成介面影響,示範結果不能當成普遍性能保證。
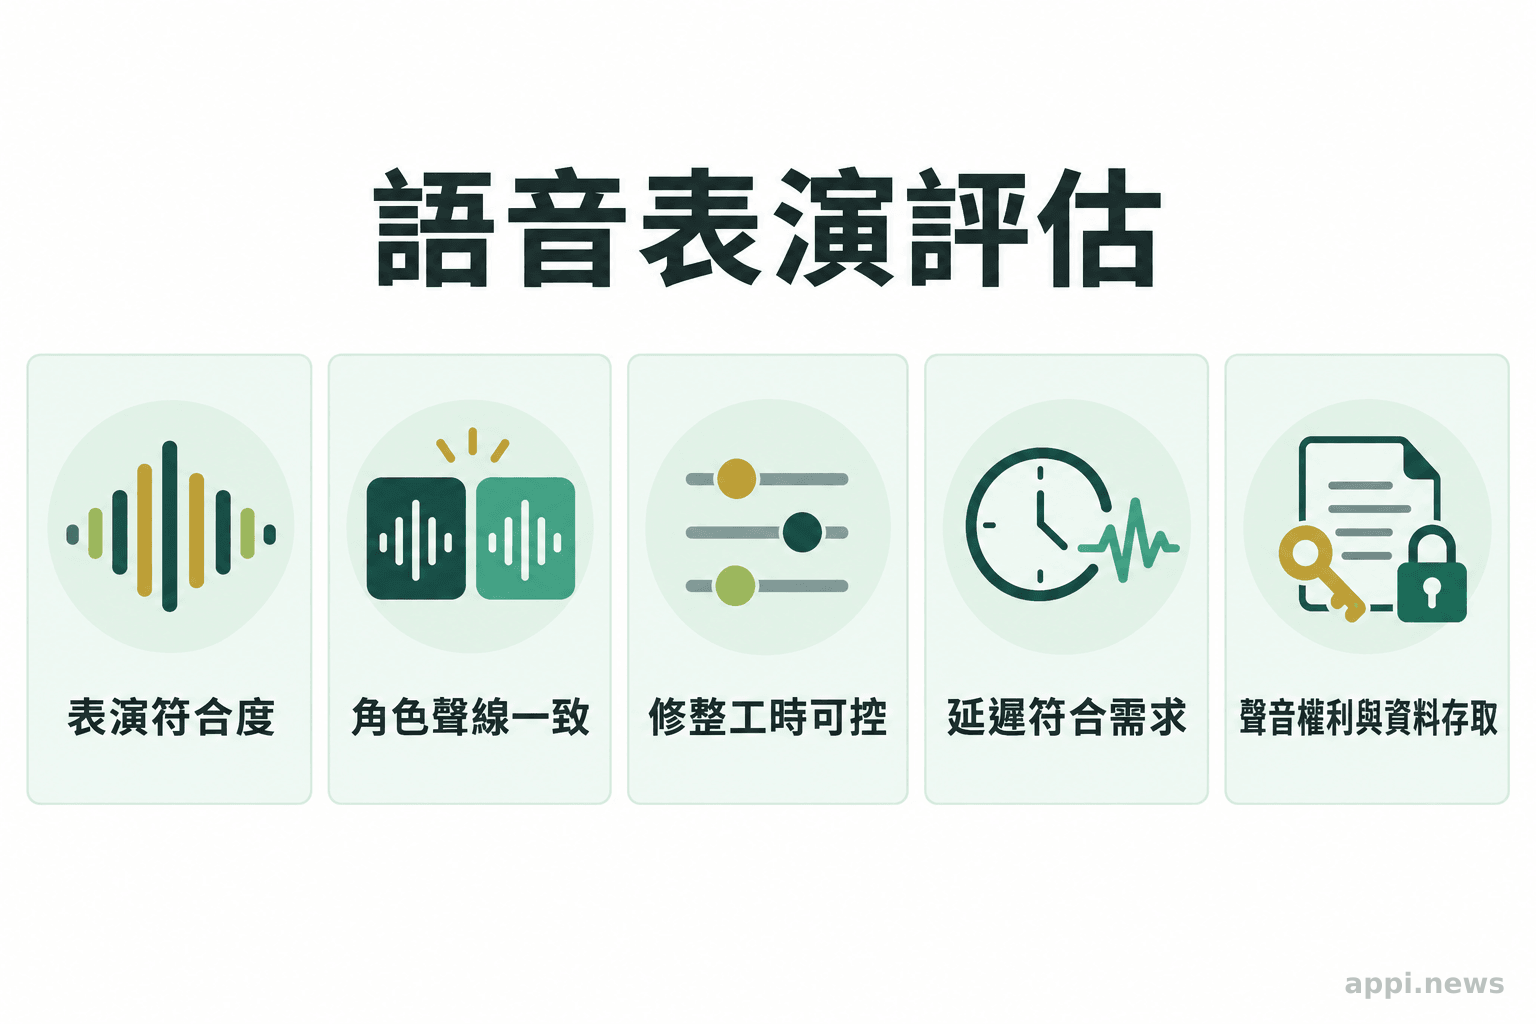
- 以現行模型對照測試提示命中、角色一致、修整工時、延遲、整合需求及聲音授權,再決定是否擴大使用。
常見問題
Q1:Eleven v4 能穩定生成笑聲與耳語嗎?
Eleven v4 支援以音訊標籤指示笑聲、耳語等表演,但官方文件也提醒標籤遵循仍非完美。聲線、文字與提示都會影響結果,應以實際腳本多次試聽。
Q2:使用 v4 是否還需要人工聽審?
需要。人工仍要檢查發音、情緒是否合宜、前後聲線是否一致、剪接點是否自然,以及成品是否符合品牌和授權要求。
Q3:應該先用 v4 還是 v4 Turbo?
旁白或角色配音可先以 v4 測試表演品質;即時互動再比較 v4 Turbo 的延遲和對話需求。最後依帳戶可用功能、實測音檔與整合條件決定。
參考來源
- ElevenLabs (2026). *Eleven v4: nuestro modelo de IA de texto a voz más expresivo hasta la fecha
- ElevenLabs (2026,查閱). *Best practices
- ElevenLabs (2026,查閱). *How do audio tags work with Eleven v3 and v4?
- ElevenLabs (2026,查閱). *Models
- ElevenLabs (2026,查閱). *Instant Voice Cloning
- W3C (2010). *Speech Synthesis Markup Language (SSML) Version 1.1
- NIST (2024). *Reducing Risks Posed by Synthetic Content: An Overview of Technical Approaches to Digital Content Transparency


