Claude Code 2.1.293 加入 Claude Haiku 5.5,並將它列為 Anthropic API 的預設 Haiku 模型。團隊要判斷這次更新能否降低程式任務總成本,除了單價,也要看任務完成率、重試次數與人工檢查時間。
一、Claude Code 2.1.293 帶來什麼模型更新?
Claude Code 2.1.293 的 release note 將 Haiku 5.5 列為 Anthropic API 的預設 Haiku 模型。這是模型選項與預設值的更新,不代表所有程式任務都會改由 Haiku 完成;各帳務方案的計價也不同。
版本說明列出模型識別字 claude-haiku-5-5,並標明 1M token 上下文窗口,代表單次工作可納入處理的文字與資料量上限。
官方 API 定價另依提示長度分級:提示不超過 100,000 tokens 時,輸入每百萬 tokens 為 0.10 美元、輸出為 0.50 美元;超過門檻後,分別為 0.50 美元與 2.50 美元。這些是 API 標價,實際帳單仍要依使用的平台、快取與方案條件查看。
版本說明也列出子代理資訊與上下文壓縮等修正;判斷升級價值時,應先確認團隊使用 API、Claude Code 訂閱或雲端平台,API 單價不等於所有方案的實付費用。
Anthropic 將摘要、分類、路由、上下文壓縮和子代理工作列為 Haiku 5.5 的應用例子。程式團隊可先挑大量、界線清楚且容易核對的步驟試跑。
「Haiku 5.5 較適合範圍較明確的任務,例如上下文壓縮、摘要或子代理工作。」來源:Anthropic 官方發布說明(原文意譯)。https://www.anthropic.com/claude-haiku-5-5
二、基準提升能說明哪些能力,不能代表什麼?
不能。基準分數只描述模型在指定資料、工具、提示與評分規則下的表現。它能協助辨認能力變化與候選用途,不能直接換算成團隊專案的成功率、交付時間或節省金額。
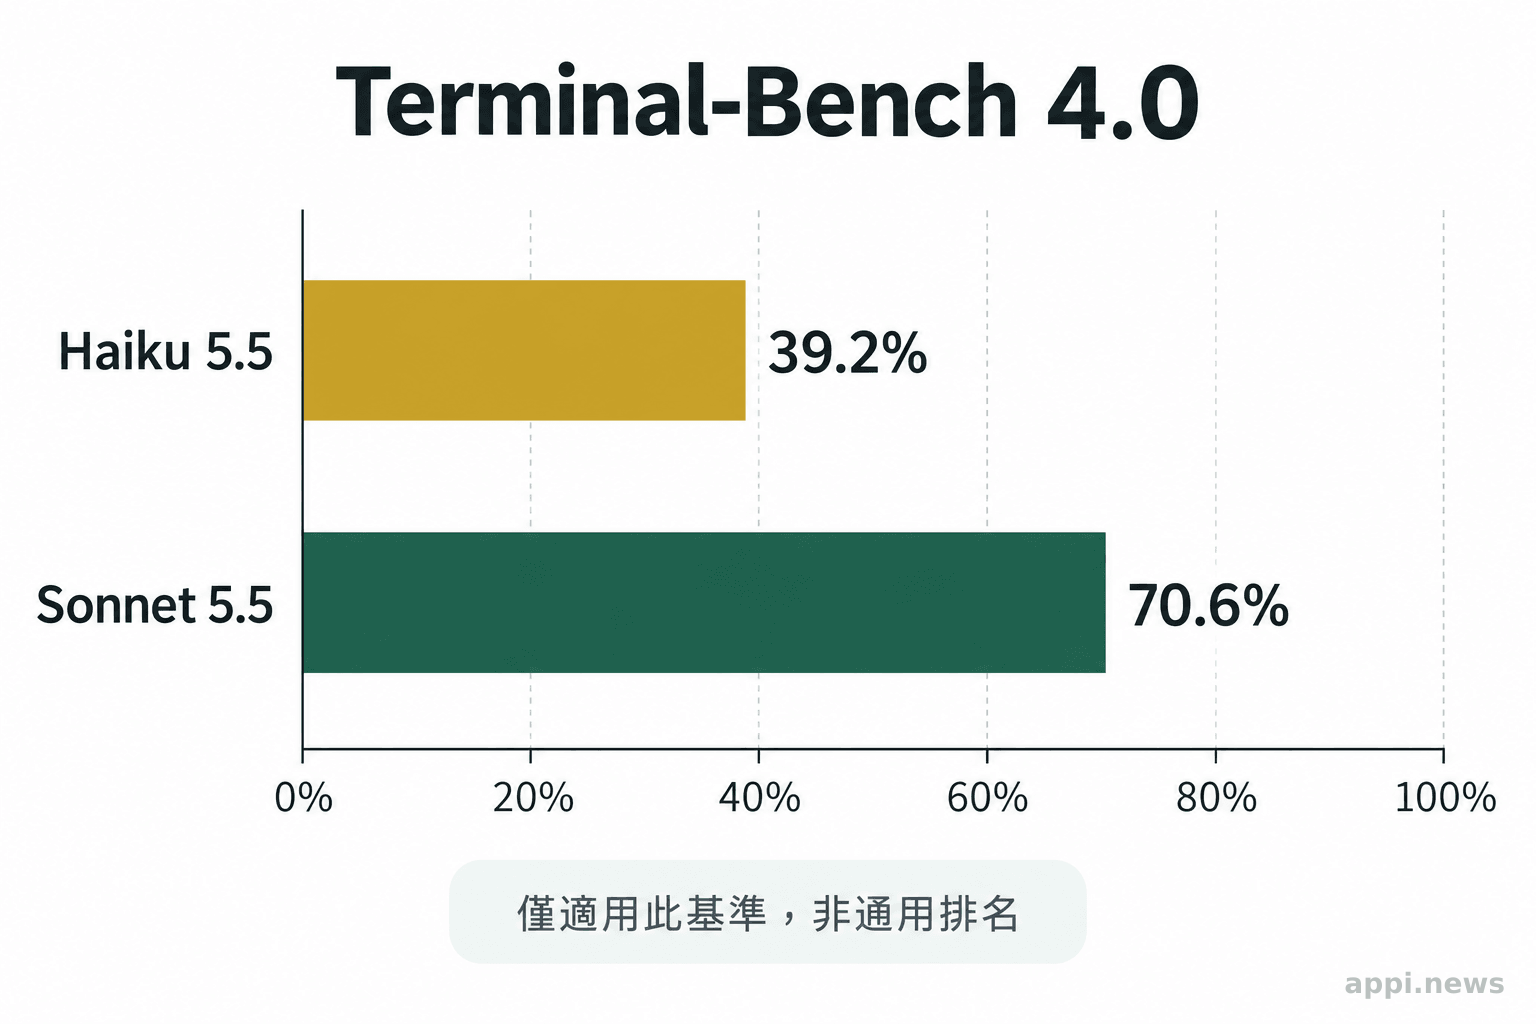
Anthropic 公布的測試涵蓋不同任務:Terminal-Bench 4.0 測命令列多步驟工作,Haiku 5.5 得分 39.2%;OSWorld 2.1 離線子集測電腦操作,得分 72.4%;GDPval-AA v2.1 評估 44 種職業的實務工作。各測試衡量不同,不能排成通用能力名次。
Terminal-Bench 4.0 中,Sonnet 5.5 得分 70.6%,Haiku 5.5 為 39.2%;Anthropic 指出較複雜的代理任務仍較適合較大型模型。團隊可先讓 Haiku 處理摘要、測試失敗整理或依規則修改小範圍檔案,再評估跨模組設計等複雜工作。
基準與實際專案的工具及環境不同,團隊程式庫也可能有內部慣例、未記錄相依關係或不穩定測試。Anthropic 建議用明確任務、穩定環境和足夠測試,並檢查輸出與執行過程。
比較分數時要確認任務、工具、試驗次數與評分項目是否相同。條件不同的數字只能各自解讀,不能直接當成產品差距。
三、模型定價下降後,任務成本如何計算?
不一定。每百萬 token 的價格只是帳單的一部分,任務總成本還包括提示與輸出用量、快取、重試、測試等待和人工修正。要比較的是「一件合格工作完成的總成本」,而不是只比較兩個模型的輸入單價。
官方 API 標價依提示長度分級,Haiku 5.5 與 Haiku 4.5 的每百萬 tokens 價格如下。長提示適用不同級距,估大型程式庫或長對話時不能只看最低單價。
| API 提示長度 | Haiku 5.5 輸入/輸出 | Haiku 4.5 輸入/輸出 |
|---|---|---|
| ≤100K tokens | 0.10/0.50 美元 | 1/5 美元 |
| >100K tokens | 0.50/2.50 美元 | 1/5 美元 |
以上均為每百萬 tokens 的 API 標價,實際費用仍依平台與帳務條件而異。
試算時分開記錄輸入、輸出、快取讀寫與提示長度;快取首次寫入仍有費用。不同平台可能另有計價或折扣,應以實際帳務頁面核對。
任務失敗後的重試、較長輸出與人工補救也要計入。若小模型能穩定完成重複步驟,再把較昂貴模型留給難題,才可能降低平均費用與等待時間。
「以每項任務完成成本評估候選模型,並把失敗後的重試成本納入比較。」來源:Anthropic Claude Platform 成本與能力指南(原文意譯)。https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence
先把比較單位定為完成任務
帳本可記錄模型、token 用量、快取費、執行時間、重試、測試結果與人工修正時間,並分開呈現模型費用和工時估算。
例如小型修補若測試未過,重寫提示、重跑與人工補救可能抵銷低價;固定格式的測試摘要若能快速核對,低單價才可能轉成效益。兩者都須用團隊資料驗證。
四、哪些程式工作流適合先用 Haiku 5.5 試跑?
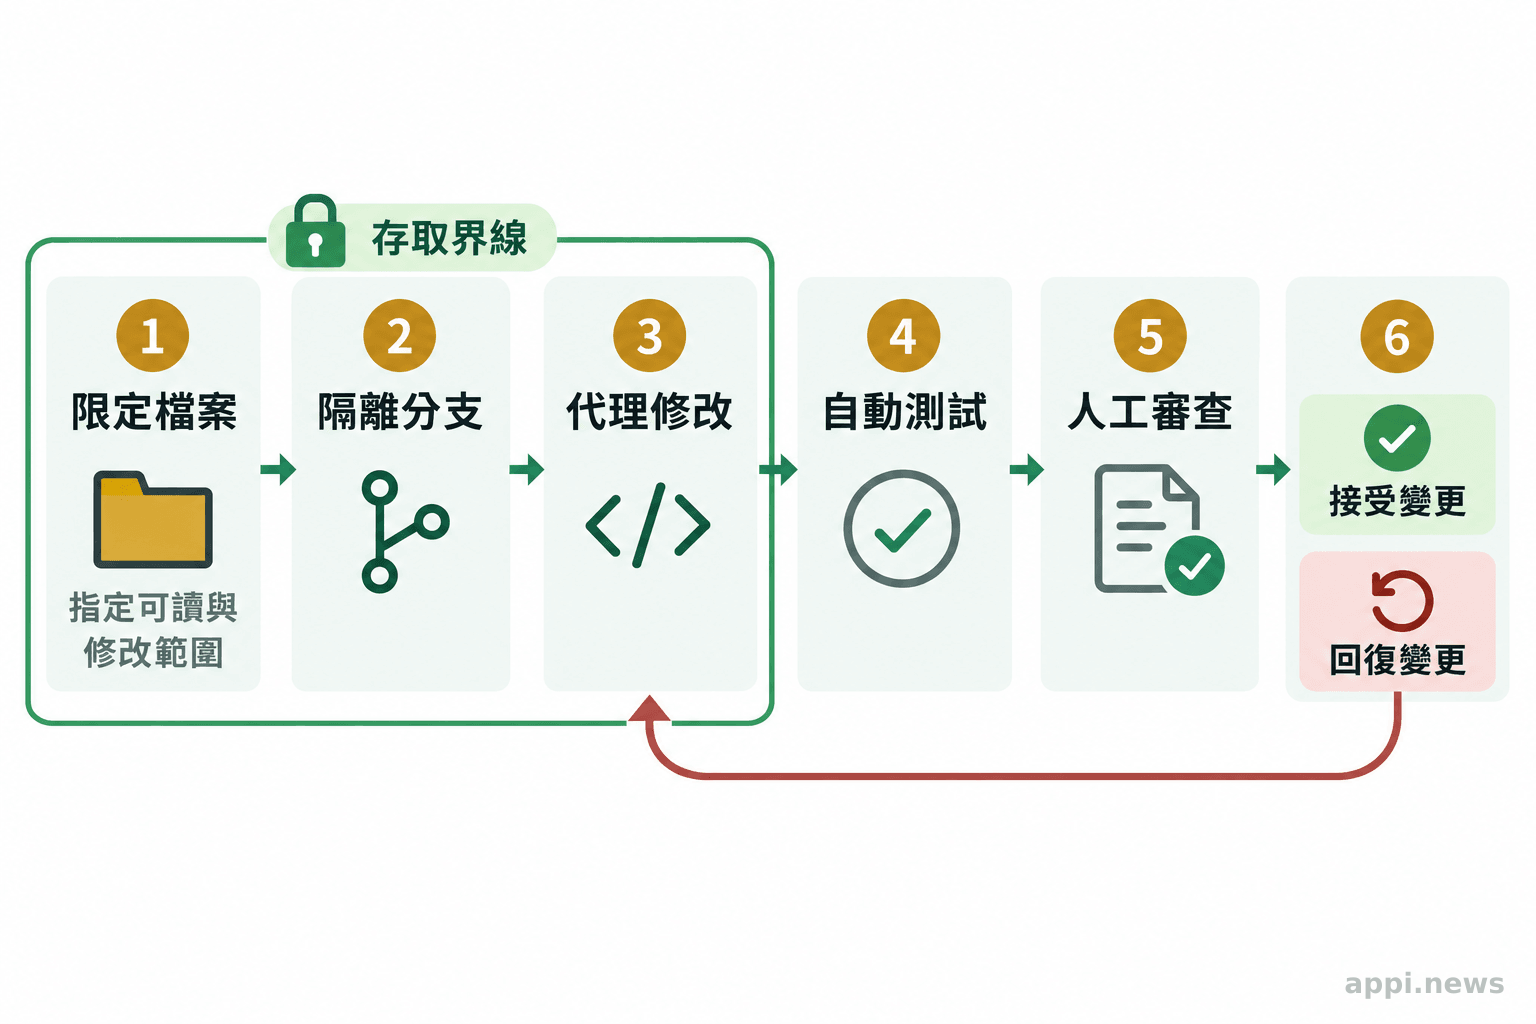
先從範圍明確、輸入資料受控、結果可測試且容易復原的工作開始。任務越依賴跨檔案判斷、未知背景與高風險決策,越需要提高測試和人工審查強度,必要時再交給更適合的模型或工程師處理。
可先測試 CI 錯誤摘要、依規則產生測試案例、為指定函式補文件、有限檔案格式轉換,或從指定資料擷取資訊。這些任務輸入輸出明確,可用測試、型別檢查或人工抽查驗收。
「把整個系統整理得更好」需要模型自行定義目標、改動範圍並處理相依性,可能衍生更多探索輪次。先拆成可驗證步驟,才能定位錯誤。
部署設定、資料庫遷移、憑證、客戶資料或安全控制等高風險任務,應限制權限並保留隔離分支、人工審查與回復方式。也要依資料政策限制模型可讀取的檔案、命令及工具。
若 Haiku 擔任子代理,任務定義、上下文與回報格式都會影響交接;評估應涵蓋觸發、執行、驗證到人工核准的完整流程。
五、如何判斷低成本模型是否適合現有工作流?
用一組既有任務建立可重複的比較,並同時檢查品質、完成時間、重試次數、人工修正量與費用。先小範圍試跑,再依任務類型決定模型分工;不要從單一成功案例推論整個團隊都適用。
建立可重複的任務樣本
挑選結果可判定的既有任務,如修正測試失敗或補測試,納入一般與易錯案例。記錄輸入、版本、工具、提示和結果,讓兩模型使用相同任務與近似設定。
每項任務記錄驗收、總耗時、重試、人工修改量與模型帳單;涉及品質時,再評估維護性、安全性及專案慣例。測試未涵蓋的需求仍須人工檢視。
Anthropic 建議依任務組合程式測試、靜態分析、執行紀錄與人工評估;團隊可先整理現有測試及審查紀錄作為比較基準。
依任務結果安排模型分工
若 Haiku 5.5 在明確任務中維持通過率,且重試與審查時間未增加,可逐步擴大使用;複雜案例若常返工,則交由更強模型或熟悉程式庫的工程師處理。
樣本也要包含跨檔案、測試不穩或需求不完整的難題,並與常見任務分開報告,找出返工集中處及是否需要加強提示、縮小權限或轉交處理。
- 從既有工作挑選一批範圍明確、可重複驗收的程式任務,並在隔離分支執行。
- 以相同輸入比較 Haiku 5.5 與目前使用的模型,記錄測試結果、總耗時、token 用量、重試與人工修正時間。
- 先檢查失敗案例與資料權限,再依每類任務的完成成本決定是否擴大使用或調整模型分工。
- Claude Code 2.1.293 加入 Haiku 5.5,Anthropic API 的提示超過 100K tokens 時適用較高價格級距。
- 基準分數反映特定測試條件,不能直接預測團隊程式庫的完成率或節省金額。
- 評估模型時,將重試、人工檢查、測試時間與資料權限一併納入工作流。
常見問題
Q1:Claude Haiku 5.5 是 Claude Code 的預設模型嗎?
Claude Code 2.1.293 的說明寫明 Haiku 5.5 是 Anthropic API 的預設 Haiku 模型。這項設定不等於 Claude Code 所有任務都固定使用 Haiku;實際選擇仍依使用方式、設定和工作流程而定。
Q2:Claude Haiku 5.5 的 API 價格是多少?
Anthropic 官方列出的價格是提示在 100K tokens 以內,輸入每百萬 tokens 0.10 美元、輸出 0.50 美元;提示超過 100K 時,輸入 0.50 美元、輸出 2.50 美元。快取、批次處理和雲端平台計價另有條件,使用前應核對實際帳務頁面。
Q3:Haiku 5.5 適合處理複雜的程式代理任務嗎?
要看任務。官方基準顯示它能處理多類工作,但在 Terminal-Bench 4.0 的得分低於 Sonnet 5.5。可以先測試範圍清楚、結果容易驗證的任務;跨模組架構變更或涉及高風險資料與權限的工作,應安排更完整的測試和人工審查。
Q4:團隊怎麼確認低價模型真的省錢?
使用同一批任務比較品質、總耗時、重試次數、人工修正時間與模型帳單。若模型單價較低,但失敗和返工增加,總成本仍可能上升;應依任務類型持續記錄結果。
參考來源
- Anthropic (2026). *Release v2.1.293 · anthropics/claude-code · GitHub
- Anthropic (2026). *Introducing Claude Haiku 5.5
- Anthropic (2026). *Claude Haiku 5.5, Claude Platform Docs
- Anthropic (2026). *Pricing, Claude Platform Docs
- Grace M, Hadfield J, Olivares R, De Jonghe J (2026). *Demystifying evals for AI agents*. Anthropic Engineering
- Anthropic (2026). *Optimizing for cost and intelligence, Claude Platform Docs