
Hugging Face 上 Dharma-AI 展示一張 SROIE 收據,Dharma Field Extractor 將收據中的 18 個欄位逐一輸出,兩個空白欄位回傳 null,數字也與原圖相符。這是該團隊公布的單張示例,能說明它想處理的工作:把文件影像中的資訊整理成其他系統可讀的欄位。它還不能回答模型遇到自家收據、不同語言或模糊影像時表現如何。
每天處理發票、收據、表單或身分文件的團隊,常需要把固定資料送進資料庫、排程器或財務系統。這時要先問清楚卡點在哪:影像上的字辨識不出來、辨識後不知道哪個值對應哪個欄位,還是結果沒有符合下游系統的格式?Dharma Field Extractor 主打第二步的欄位判讀與結構化輸出,不能只因為它產出 JSON,就假定整條文件流程都已解決。
Dharma Field Extractor 解決的是哪一步文件工作?
OCR(光學文字辨識)把頁面上的文字轉成可讀文字;欄位抽取則進一步判斷內容的意義與位置,將值放進具名欄位。Dharma-AI 將 Field Extractor 定位為從文件影像輸出結構化 JSON 的欄位抽取工具。
一張發票經 OCR 處理後,可能得到「統一編號、日期、金額」等一串文字,但程式仍得判斷哪個數字是含稅總額、哪個是發票號碼。欄位抽取多做了這層對應,讓下游程式可以依欄位名稱讀值。若原始影像模糊、文字漏辨或表格線交錯,欄位模型也可能把錯誤文字放進格式正確的 JSON;格式合法不等於資料正確。
處理醫療需求單時,病患姓名、檢查項目與日期即使成功抽出,仍涉及個人資料的權限、保存期限和操作紀錄。孕婦、兒童、慢性病患者或長期服藥者的相關文件,也不該因為工具能辨識欄位,就跳過資料保護與人工核對。
想比較 OCR、抽取與資料交接,可延伸閱讀文件抽取模型如何評估準確度與流程成本;若主要問題在輸出格式,也可參考結構化輸出與型別安全的導入評估。
兩種抽取模式,適合不同的資料流程
Hugging Face 文章描述兩種請求方式:開放式抽取讓模型從文件判斷有哪些欄位;指定結構抽取則由使用者提供欄位名稱與型別。前者適合探索文件內容,後者較接近既有系統的輸入格式。
開放式請求不先給欄位表,模型依文件上的標籤、版面和表格找出可辨認的鍵值。這可用於初步盤點資料,但不同文件可能用了不同欄名,同一概念也可能出現多種寫法。若要直接進資料庫,還得設計欄位正規化和例外處理。
指定結構請求則列出需要的欄位與型別,例如供應商名稱、發票號碼、到期日和總額。官方文章指出,可指定字串、數字或布林值;表格可以按列、欄整理,文件沒有某個欄位時預期回傳 null。對資料流程來說,這種模式較容易接到既有 schema(資料欄位結構),但團隊仍須確認介面與實際模型版本確實支援所需型別、巢狀資料和表格形狀。
| 作法 | 先提供什麼 | 適用的起點 | 導入前要驗證 |
|---|---|---|---|
| OCR | 文件影像 | 需要全文文字或搜尋 | 文字漏辨、閱讀順序、表格區域 |
| 開放式抽取 | 文件影像 | 尚未確定欄位清單 | 欄名一致性、多餘或遺漏欄位 |
| 指定結構抽取 | 影像、欄位名稱與型別 | 下游系統已有資料格式 | 型別、空值、錯誤值與表格列對應 |
Hugging Face 文章另以 FUNSD 表單呈現勾選框與手寫文字:十二個布林欄位中,模型把唯一勾選項標為 true,辨識手寫的 Bates 編號,並對兩個空白欄位輸出 null。這是公開資料集中的一個示例,不代表它對各種掃描品質、手寫方式或表單語言都有相同表現。FUNSD 原始資料集聚焦於表單理解,適合作為測試情境之一,卻不能替代團隊自己的文件樣本。
「OCR 給出頁面文字;欄位抽取要回答的是哪個值屬於哪個欄位。」這是依 Dharma-AI 對兩種工作的區分所作整理;官方文章也提醒,單有 OCR 文字,後續仍需把值映射至資料欄位。
官方測試能說明什麼,還不能說明什麼?
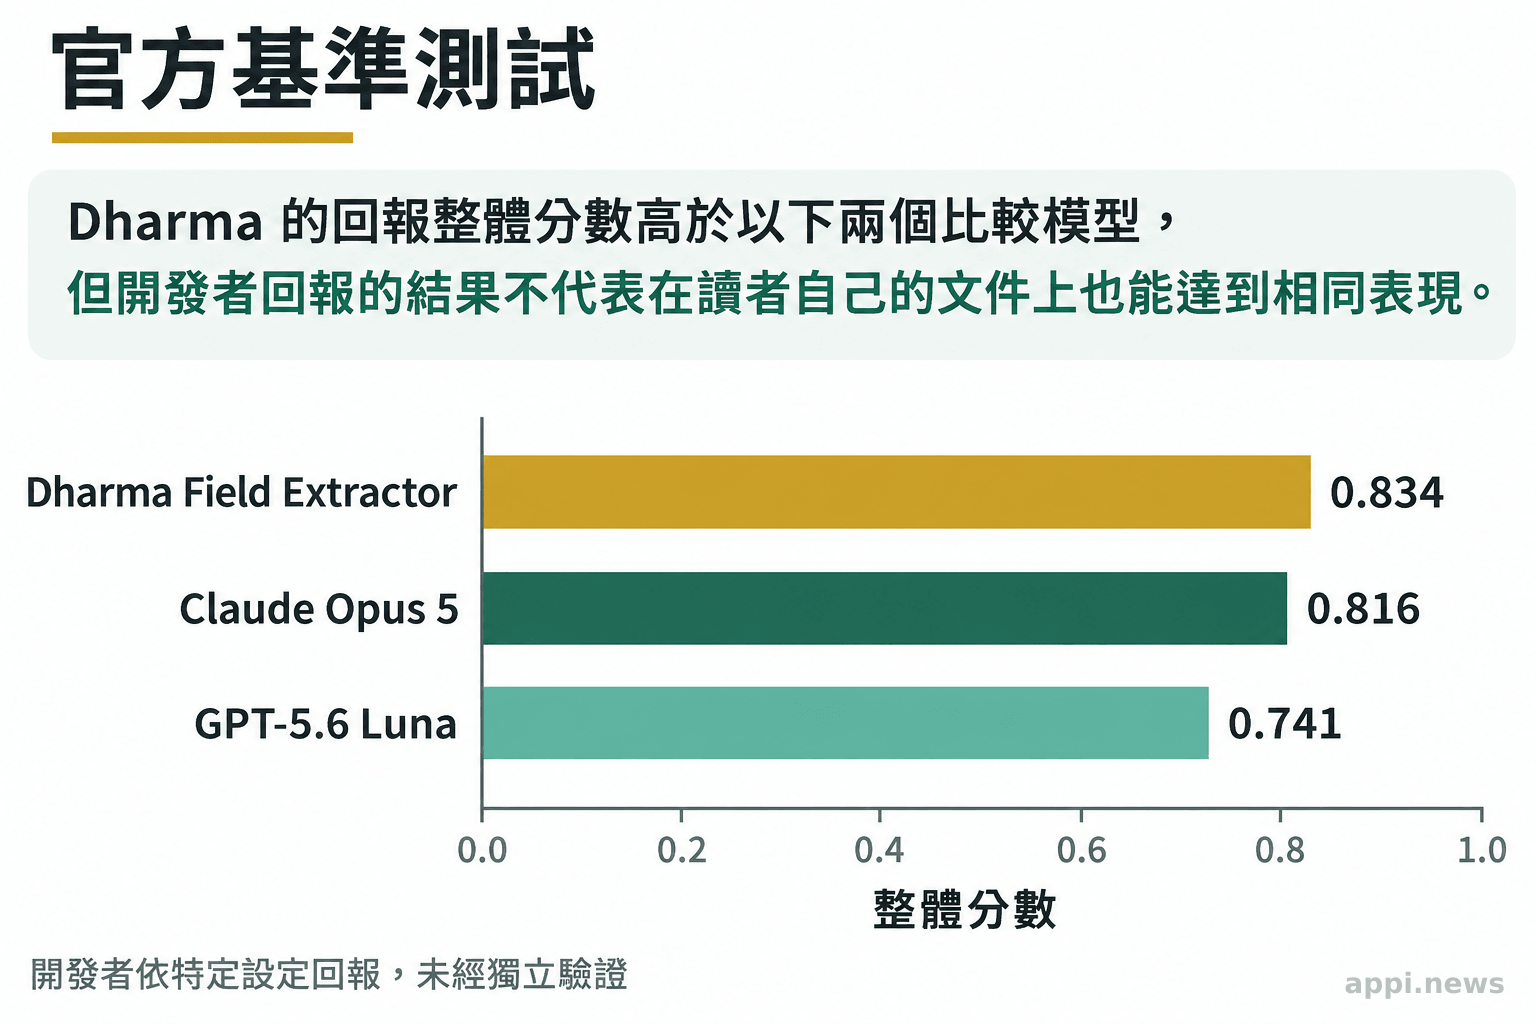
Dharma-AI 公布的測試涵蓋 546 份文件、三種請求情境,共 1,638 個案例,整體分數為 0.834。這是開發團隊自行執行與發布的基準測試,應視為特定設定下的結果,不能當成獨立驗證或自家文件的效能保證。
三種情境分別是不提供 schema、只列出文件確實存在的部分欄位,以及要求模型填入文件中不存在的欄位。官方分數結合欄位層級 F1、正確欄位值的字串相似度,以及有效 JSON 的比例;整體分數仍看不出各類文件和欄位的錯誤分布。
Dharma-AI 報告的 0.834 高於其比較的四種通用模型設定;文章列出的對照包括 Claude Opus 5 的 0.816,以及 GPT-5.6 Luna 的 0.741。成本比較則估計約低 6 至 147 倍,但兩邊算法不同:通用模型依每頁平均輸入、輸出 token 和公開牌價估算,Dharma-AI 以單張 L40S GPU、每小時 2.24 美元估算自架運算時間。這些數字沒有涵蓋所有整合、人工覆核、硬體折舊、維護與延遲需求,也不等於採用者的總成本。
測試資料中的 SROIE 與 FUNSD 被描述為未參與訓練,文章各展示一個案例。這些示範不等於資料集整體正確率。訓練使用 43,384 個例子,涵蓋英文多領域、巴西葡萄牙文文件,以及較小比例的其他語言資料;仍不足以判斷繁體中文、台灣發票或特定機構表格的準確度。
另一個相關案例來自 Cardoso 等人於 2026 年提交的 DharmaOCR 研究稿。作者提出 7B 的 Full 與 3B 的 Lite 模型,並在涵蓋印刷、手寫及法律與行政文件的 DharmaOCR-Benchmark 報告 0.925 與 0.911 的分數;研究也報告 AWQ 量化後每頁成本最多降低 22%。這是另一組專門 OCR 模型的研究結果,不能視為 Dharma Field Extractor 的獨立驗證,也無法直接推論台灣文件的表現。
Dharma-AI 將成本比較描述為「不是銷售價格」:自架費用會隨硬體、處理量與延遲要求改變。這是理解官方成本數字時的重要條件,採用者仍需以自身工作負載重算。
接進既有系統前,先算清楚整合與維護成本
先確認文件品質、語言與版型是否接近已測資料,再定義錯誤的處理流程、資料權限和總成本。官方測試結果可用來決定是否值得試跑,不能取代這些現場檢查。
第一,整理輸入差異。文件可能是手機拍照、掃描 PDF 或原生 PDF,欄位位置也會隨供應商、院所、語言和版本改變。若版型每季更新,團隊需要知道如何發現欄位漂移,並重新驗證,而不是等錯誤資料進入帳務或排程後才追查。
第二,為不同錯誤設定不同處理方式。金額、日期、身分識別碼等關鍵欄位可設合理範圍和格式檢查;低信心或缺值時應轉人工覆核,並保留原始影像、抽取值、修正紀錄和模型版本,方便追蹤。若模型輸出會直接觸發付款、排程或病患資料更新,應先把自動寫入改成待確認狀態,等錯誤率與責任分工經過驗證再調整。
第三,核對模型取得方式和條件。Hugging Face 文章介紹功能與基準測試,但若要部署,仍須找到實際模型頁面、確認權重和程式的授權、商用範圍、依賴套件,以及文件是否送往第三方服務。文章的成本估算不能代替授權條款,也沒有說明所有部署方式的隱私條件。涉及個人資料時,至少要盤點資料流向、存取權限、保存期限和刪除機制;醫療需求單更須依適用規範處理。
若正在比較文件抽取產品,也可參考Clairic 與大型語言模型的文件抽取差異;比較重點應放在自己的錯誤成本、資料流程和維護方式,而非只挑單一總分最高的工具。
用小規模試跑判斷是否適合
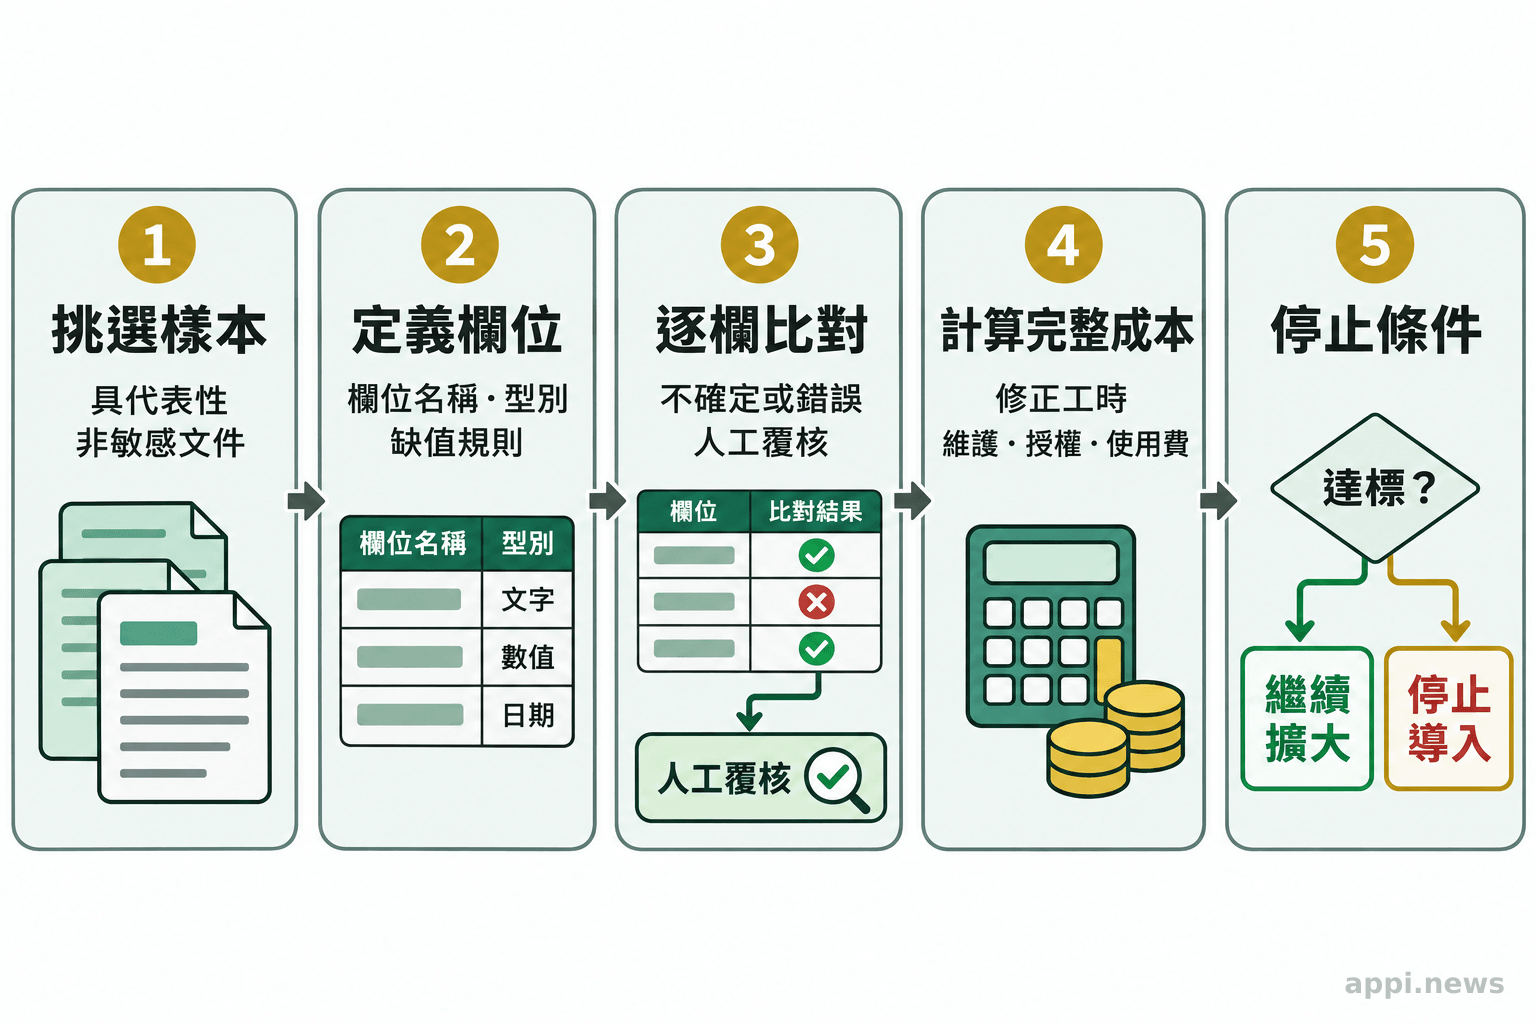
從不含敏感個資、但能代表實際格式的文件開始,先固定欄位定義與可接受錯誤,再記錄模型輸出、人工修正和處理時間。只有在代表性樣本中通過驗證,才有理由擴大試用。
- 挑樣本:納入常見與例外版型、清晰與模糊影像、不同語言文件,並確認資料可用於測試。
- 定義欄位:寫清楚欄位型別、格式、必要性,以及文件缺欄時應為
null還是轉人工處理。 - 逐欄比對:記錄漏欄、錯值、欄位放錯、表格列錯位和無效 JSON,不只看整體分數。
- 計入人工:統計覆核比例、每份修正時間、例外文件處理和錯誤回報所需的人力。
- 估總成本:納入推論硬體或 API、系統串接、資料保護、監控、版型變更後維護與使用者訓練。
- 設定停損條件:先定義哪些欄位錯誤不可接受、哪些情況必須人工確認,再決定是否擴大使用。
如此才能回答真正的採用問題:欄位抽取是否減少了整體作業負擔,錯誤是否能被及時發現,維護成本是否符合團隊能力。Dharma Field Extractor 的公開結果提供一個值得驗證的方向;是否適用,仍取決於目標文件、系統接口和治理安排。
- OCR 將文字讀出來,欄位抽取還要判斷每個值應放在哪個欄位。
- Dharma-AI 的 546 份文件、1,638 個案例與成本數字屬官方自行公布的特定測試,不代表各地文件的實際表現。
- 試跑時逐欄記錄錯誤、人工覆核和整合維護成本,並先確認授權與個資處理方式。
常見問題
Dharma Field Extractor 可以處理哪些文件?
Hugging Face 文章列出收據、商業發票、表單、銀行對帳單與身分文件等訓練資料類型,也展示 SROIE 收據與 FUNSD 表單案例。這不代表每種文件和語言都有相同準確度,仍應使用目標樣本測試。
文件缺少指定欄位時會怎麼輸出?
官方文章表示,指定結構模式遇到文件沒有的欄位時會回傳 null。實際部署仍要測試空白、模糊、被遮住或無法判讀的內容,並確認下游系統把 null 當成缺值而非有效資料。
可以直接商用或把病患文件交給它處理嗎?
先核對實際模型權重、程式與服務的授權及資料處理條款。處理病患或其他個人資料前,也須評估權限、保存期限、資料流向和適用規範;官方功能介紹本身不能代替這些確認。
參考來源
- Dharma-AI (2026). [Dharma Field Extractor: Any Document In, Structured Fields in JSON Out](). Hugging Face Blog
- Jaume, G., et al. (2019). [FUNSD: A Dataset for Form Understanding in Noisy Scanned Documents](). ICDAR 2019
- Huang, Z., et al. (2019). [ICDAR2019 Competition on Scanned Receipt OCR and Information Extraction](). ICDAR 2019
- Cardoso, G. P. de F., et al. (2026). [DharmaOCR: Specialized Small Language Models for Structured OCR that outperform Open-Source and Commercial Baselines](). arXiv


