
AI 文字轉語音的選擇方式正在增加。過去常見做法,是從既有音色清單挑選聲線,再調整語速或停頓;Google 在 2026 年 9 月推出 Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS,加入「Voice design」聲音設計,可用自然語言描述角色的音色、口音與基本表現,再把生成的聲音用於朗讀。表演方式也能依逐句指示調整情緒、節奏與語氣。是否導入,仍得看目標語言的聽感、修改成本、價格和使用權利。
這是將輸入文字轉成音訊的文字轉語音(Text-to-Speech,TTS)。可先把稿件轉成旁白或對話,再由人員校對與剪輯;若需求是即時聽取使用者語音並對答,則應另外比較 Gemini Live 等即時音訊產品。兩種模型目前可透過 Google AI Studio 試聽,也能用 Gemini API 串入軟體流程。現有資料以官方產品文件和有限第三方試用資訊為主,尚無獨立性能研究足以比較所有語言、稿型與製作環境;繁體中文、台灣口音、專有名詞和長篇穩定度都應以實際測試為準。
Gemini 3.8 Flash TTS 是什麼?
Gemini 3.8 TTS 除了把文字轉成語音,也能讓使用者描述自訂聲音角色,再為每句文字設定表達方式;實際效果仍要試聽確認。
用文字描述聲音與表達方式
「自訂聲音」和「逐句表演」是兩種不同控制。前者用 Voice design 建立可重複使用的聲音身分,例如描述「溫和、略帶沙啞、語速從容的科普旁白」,再依服務回傳的聲音識別碼進行合成。後者是在台詞上設定這一段要呈現的方式,例如平靜說明、興奮提問或放慢速度。把穩定特徵和情境表現分開,有助於同一角色在不同句子間維持一致,同時保留局部變化。
這個控制方式也會影響稿件整理。Google 的 Gemini API 說明指出,TTS 的文字欄位是要照讀的逐字稿,長時間適用的情緒、語速或表達方式應放在語音中繼資料(speech metadata);短暫的嘆氣或停頓等聲音事件,才放進台詞標記。若把「用很開心的口氣說」直接寫在台詞前方,系統可能照樣把它唸出來,後製便得重做。先將台詞、角色、情緒指示分欄管理,能讓測試比較容易重現,也減少修改時誤改到正文的機會。
Voice design 產生的聲音可以保存並重複呼叫,AI Studio 也能先試聽,再將設定帶進程式。對內容團隊來說,角色語氣因此能成為可管理的素材。保存聲音識別碼不代表取得聲音所有權,也不代表它適用所有商業用途;仍須確認角色設計、聲音來源與使用範圍。
Flash TTS 和 Flash-Lite TTS 的定位
Google 將 Flash TTS 描述為重視聲音細節、表演控制與長篇穩定性的型號,Flash-Lite TTS 則著重大量生成、低延遲與成本效率。這些是供應商對產品定位的說明,不能直接推導出某一款在所有測試中都較自然、較快或較省錢。團隊應以相同的文字、聲音描述、音訊輸出條件和重試規則測試兩款,再按實際使用情境決定。
| 比較面向 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 官方定位 | 聲音細節、表演控制、長篇內容 | 大量生成、低延遲、成本效率 |
| 可測試情境 | 角色旁白、情緒轉折、多角色片段 | 大批短音檔、產品朗讀、語音助理回應 |
| 導入前要核對 | 長稿前後音色、專有名詞與細節指示 | 批次錯誤率、延遲、單位產出成本 |
| 比較方式 | 使用同一份代表性腳本盲聽 | 使用同一份代表性腳本盲聽 |
不宜只截取幾句示範音檔下結論。品牌旁白重視音色和情緒;大量客服回覆則關心速度、單位費用、失敗重試與聽感穩定性。帳單也受輸入長度、輸出音訊、批次模式、快取、呼叫量和重製次數影響。
第三方試用也提醒,短片段自然不代表輸出毫無瑕疵。《The Decoder》記者以兩段試音觀察到背景高頻噪音,其中一段尾端聲線也有變化。樣本數很少,無法推論整體表現,但正式素材仍需完整聽校,不能只採用展示片段。 The Decoder 試用報導
「Gemini 3.8 Flash Text-to-Speech audio model」著重聲音保真度、表演表現與長篇穩定性。這是 Google 對 Flash 型號的產品定位。 Google Gemini API 模型文件
哪些語音工作流程值得試用?
旁白、Podcast 試聽稿、多角色短對話和語音產品都可列入試用;是否節省時間,要把校對、重錄與後製一起計算。
旁白、Podcast 與長篇朗讀
長篇內容的工作難點,通常不只在產出一段聽起來自然的音訊。書籍、課程或 Podcast 可能橫跨數十分鐘,角色音色、專有名詞、段落節奏與檔案切分都要能維持一致。可以先選一段包含數字、英文縮寫、人名、轉折語氣和長句的稿件,測試生成後再檢查每一項;若每次修正都要重生整個章節,原先省下的錄音時間可能會被編輯和重製抵銷。
較穩健的試行方式,是先按章節或語意段落拆分音訊,建立固定的聲音描述和檔名規則,並留存稿件版本、模型名稱、語音識別碼及生成日期。人工聽校時要同時對照原文,注意漏字、重複、句尾吞音、英文縮寫、數字唸法和段落銜接。若內容要公開或作為學習材料,還要讓編輯確認停頓不會改變原意,避免把模型讀得流暢誤認為內容正確。
Podcast 可分別測試單人旁白與訪談對話。主持人引言適合先做短稿評估;來賓互動則要聽角色辨識、輪替節奏和接話自然度。若節目仰賴真實主持人的辨識度,還要評估聽眾能否辨識合成內容,以及主持人是否同意相關用途。
多角色對話與語音產品
Gemini TTS 可生成單人音訊,也提供多角色文字轉語音的 API 用法。適合測試的片段包括教學對話、情境短劇、遊戲角色語音或引導式客服回覆。這些使用情境要看的重點不只是兩個聲線能否區分,也包括每段台詞是否分配給正確角色、情緒轉折是否恰當,以及對話聽起來會不會像輪流朗讀。
官方文件目前說明,單次多角色生成支援最多兩名使用預設音色的說話者;若要把自訂聲音或複製聲音用在多角色對話,需逐位合成後再串接音訊。這會帶來額外的剪輯、音量平衡和輪替處理,也可能讓對話節奏變得不連貫。設計語音助理時還要特別區分文字轉語音與即時語音對話:前者主要負責把已準備好的文字轉成聲音,後者需連接輸入辨識、模型回覆、延遲管理和打斷處理,架構與風險並不相同。
語音產品若用模型即時組合回應,應測試錯誤資訊、斷線、超時和不完整句子的處理方式。像醫療、金融、客服或公共服務的語音介面,文字內容仍要經過相應領域的審核,不能把發音自然當成資訊可信的指標。若使用者可能誤以為正在和真人通話,介面也應評估如何清楚揭露 AI 生成或 AI 參與的部分。
從 Google AI Studio 試聽到 API 串接
先用 AI Studio 對同一段代表性短稿試聽,再以 Gemini API 測試輸出格式、重複呼叫和實際費用;結果通過內容與工程檢查後,才擴大使用範圍。
先用短腳本測音色、發音與情緒
Google AI Studio 可用來試聽模型並調整聲音設計;Gemini API 則提供程式串接方式,方便把生成音訊納入既有內容或產品流程。小規模測試最好先固定一份短稿,涵蓋日常句子、數字、英文詞、地名、縮寫、標點停頓和至少一處情緒變化。兩款模型應採相同指示與輸出設定,將檔案隨機編號後交給幾位預定使用者盲聽,避免大家先知道型號而產生期待差異。
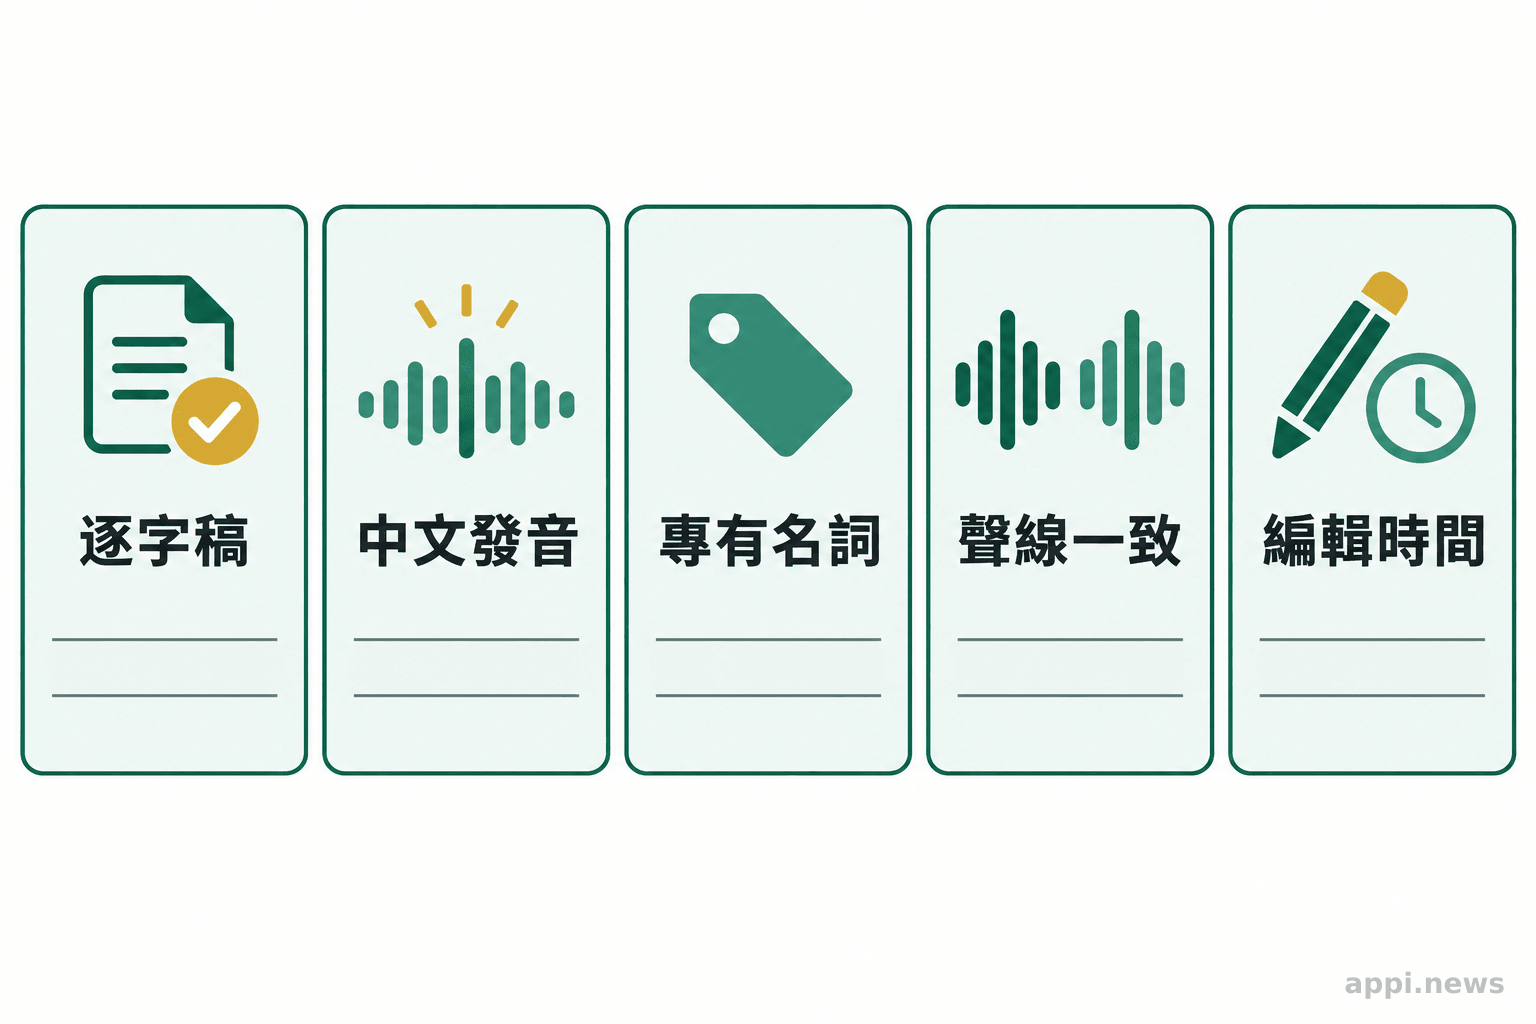
聽感檢查可以分成五項:文字是否完整照讀、繁體中文發音是否符合預期、專有詞是否唸對、前後音色是否一致、語氣是否適合內容。測試表記下錯誤位置、修正方式、重生次數和人工編輯分鐘數。若內容會持續更新,還要測試同一個角色在不同日期生成時是否仍像同一個人;若只用單次短音檔,便無法推估長期的語音一致性。
API 整合時,要確認稿件標點、角色標籤和逐句指示正確,並處理回傳音訊格式。官方文件指出,非串流請求預設回傳 WAV 音訊,串流模式則回傳分段 PCM。若播放器或剪輯系統有固定規格,應先驗證相容性,並保留請求狀態、錯誤紀錄和重試上限,避免重複計費或播出。
估算費用並檢查輸出格式
以 2026 年 9 月 23 日查核的 Google API 定價頁為例,標準模式的 Flash TTS 與 Flash-Lite TTS 都列有免費層級;付費標準模式的文字輸入單價相同,音訊輸出則按音訊 token 計費,Flash-Lite 的列示輸出單價較低。官方列出的當期音訊輸出費率分別是每百萬音訊 token 9 美元與 6 美元,且頁面預告 2027 年 1 月起費率將調整。Google 同時註明每秒音訊約對應 25 個 token。實際費用仍取決於稿長、生成次數與模式,費率、免費額度及資料使用方式可能變動,採購前應再次查看官方價格頁並核對自己的計費方案。
「Text-to-speech generation is tailored for scenarios that require exact text recitation with fine-grained control over style and sound.」此為 Google 對 Gemini API TTS 的適用情境說明。 Google Gemini API 語音生成文件
估算時,應把一次生成費用和「可交付的一分鐘音訊」成本分開。後者要納入失敗重試、人工聽校、局部重生、剪輯和儲存。免費方案也需確認資料使用條件;定價頁會分別列出免費與付費層級的資料用途。記錄平均修改次數、每分鐘校對時間和重做率,才能比較真人錄音或其他服務的總成本。
台灣使用前要確認哪些條件?
先確認 AI Studio 或 API 對目前帳戶與所在地可用,再用台灣實際稿件檢查語言表現、授權、告知和資料處理方式。
地區、帳戶與產品入口
Google 的 Gemini API 與 AI Studio 可用地區清單列有台灣,但這只能說明產品入口的地區支援,無法保證所有功能、個別帳戶或第三方整合都能使用。產品通常分階段推出,語音複製、建立自訂聲音、API 配額與企業方案可能有不同條件。實際操作前應登入預計使用的帳戶,確認功能入口、模型清單、付款資格和當下條款;若 API 可用但 AI Studio 介面尚未出現,也應先查明所需的產品權限,而非將介面差異解讀為模型性能問題。
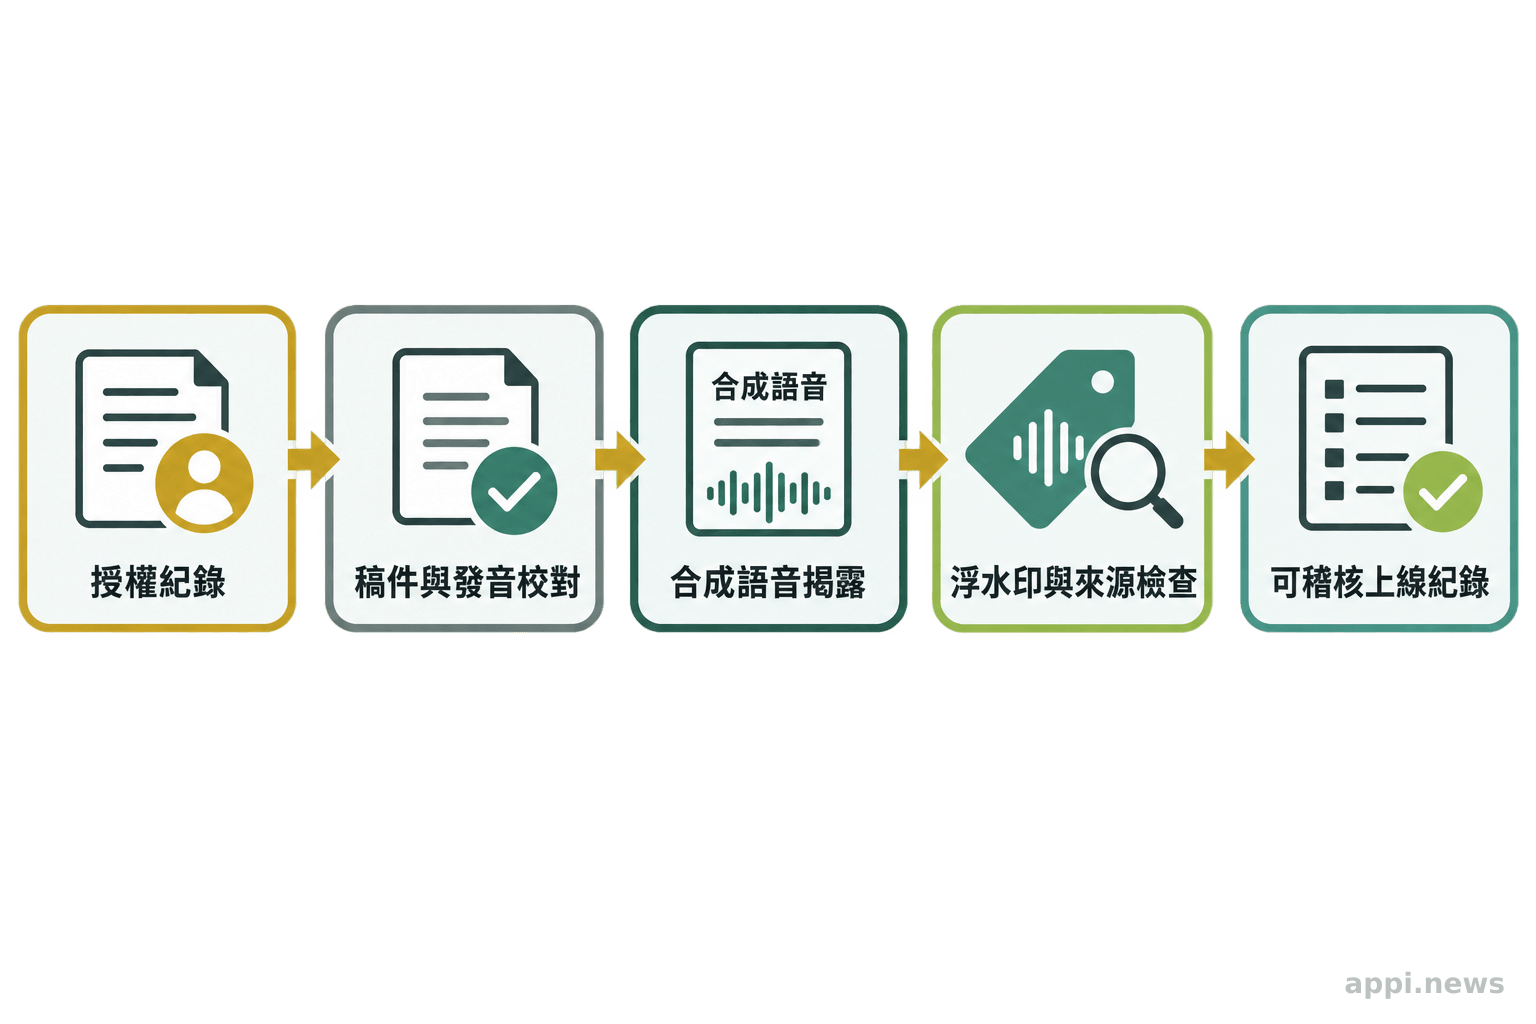
若流程涉及公司或客戶資料,先確認哪些文字可送往雲端、誰能存取音訊、保存多久,以及供應商如何處理資料。自訂聲音識別碼、生成音訊和原始錄音應集中管理,並記錄建立人、用途、權利依據、到期日和停用方式。
繁體中文發音、授權與告知
即使服務支援中文,也不表示它已符合台灣所有聽眾對語調和用詞的期待。繁體字可能轉成不同地區慣用的詞彙或讀音,中文與英文混讀、縣市名稱、人名、品牌、醫療名詞和數字格式尤其需要檢查。先選出會出現在正式流程的代表性內容,再邀請熟悉台灣語感的人員聽校。若聽感不理想,試著改寫容易誤讀的句子、拆分數字格式,或將專有詞納入人工錄音與校正清單,不宜假設更長的聲音描述就能解決所有發音問題。
聲音複製涉及可識別個人的聲音特徵。Google 說明提供聲音複製功能及相關安全措施,但使用前仍須取得聲音本人明確授權,核對平台條款與所在地適用規範,並限定聲音用途、保存期間和撤回方式。若要使用藝人、員工、客戶或合作夥伴的聲音,需釐清授權是否包括生成式合成、商業利用、再製和轉交第三方。取得一段錄音檔不等於取得複製和公開散布的權利。
對外提供合成語音時,應評估如何揭露 AI 生成,並檢查平台是否加入浮水印或來源標記。新聞、廣告、教育或公共服務資訊尤其需要避免聽眾誤認為真人發言。取得同意之外,也要保留生成紀錄、指定審核責任,並準備下架或停用聲音的方式。
- Gemini 3.8 Flash TTS 偏重聲音細節與表演控制,Flash-Lite TTS 偏重大量生成;兩者差異應以相同腳本實測。
- 試聽不能取代正式評估,稿件正確性、繁體中文語感、重製時間與每分鐘音訊成本都要計入。
- 使用聲音複製前取得本人明確授權,商用前核對平台條款、告知需求與資料保存方式。
先試用,再依實測決定是否導入
先選一段會真正投入使用的短稿,分別試做 Flash 與 Flash-Lite,再依聽感、修改時間、輸出相容性和費用決定下一步。
對創作者而言,可先測一段旁白或兩人對話;對產品團隊而言,則應選一組真實使用者會聽到的提示語或常見回覆。測試樣本要包含繁體中文、台灣地名、英文詞彙、數字和情緒轉折,並保留相同稿件作為兩款模型的比較依據。試聽者應知道評估標準,但在評分前不先看到模型名稱,以免把品牌印象當成聽感差異。
- 確認測試內容的授權、產品入口、帳戶資格和預計用途。
- 準備一段含專有名詞、數字、停頓及情緒轉折的短稿,固定角色描述與生成設定。
- 用 Flash 和 Flash-Lite 各生成音訊,記錄逐字稿錯誤、發音問題、重試次數與人工修改時間。
- 核對音訊格式、資料使用條款、告知方式及聲音授權紀錄。
- 按「可交付音訊成本」與品質門檻判斷是否擴大測試;未達標就調整稿件或維持原有製作流程。
這樣的試行能回答更實際的問題:在目前人力、稿件和產品條件下,哪個環節可以改善,新增的品質檢查由誰負責。若繁體中文發音仍需大量修正、長篇聲線不穩,或聲音權利與揭露安排未確定,就先縮小使用範圍。正式導入須同時滿足技術、流程和治理條件。
常見問題
Q1:Gemini 3.8 Flash TTS 如何用文字設計 AI 聲音?
可在 Google AI Studio 或 Gemini API 的 Voice design 功能中描述聲音角色的音色、口音與基本表現,先試聽,再將生成的聲音識別碼用於 TTS。每句台詞的情緒或語速可另外設定,最後仍要用正式稿件確認輸出。
Q2:Gemini Flash TTS 和 Flash-Lite TTS 差在哪裡?
Google 將 Flash 定位於聲音細節、表演控制與長篇穩定性,將 Flash-Lite 定位於大量生成、低延遲與成本效率。這是產品定位,不代表所有稿件都會得到相同排序,建議以實際流程比較。
Q3:Gemini 3.8 TTS 在台灣能不能用?
Google 的 Gemini API 與 AI Studio 可用地區頁面列有台灣,但個別模型或功能仍可能受帳戶和推出條件影響。確認實際帳戶的介面、API、付款及功能條款;繁體中文發音需用台灣稿件測試。
Q4:Google AI Studio TTS 試用與 API 費用怎麼查?
AI Studio 可先試聽模型,API 費用則依模型、標準或批次等模式、文字輸入與音訊輸出計算。價格頁會更新費率與免費層級條件,商用前應重新確認並以實際生成量估算總成本。
Q5:可以用 Gemini TTS 複製別人的聲音嗎?
使用聲音複製前,應取得本人明確授權,確認涵蓋生成、公開與商業用途。上線前檢查服務條款、AI 內容告知及資料保存方式。
參考來源
- Google DeepMind (2026). [Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS](). Google 官方產品公告
- Google AI for Developers (2026). [Text-to-speech generation (TTS)](). Gemini API 文件
- Google AI for Developers (2026). [Models](). Gemini API 模型文件,含 Voice design 支援與模型定位
- Google AI for Developers (2026). [Gemini Developer API pricing](). Gemini API 定價頁,費用依查閱日期與帳戶方案為準
- Google AI for Developers (2026). [Available regions for Google AI Studio and Gemini API](). 地區可用性文件
- Matthias Bastian (2026). [Google's new Flash TTS models let you design AI voices from scratch using text descriptions](). *The Decoder
- 中華民國法務部 (2025). [個人資料保護法](). 全國法規資料庫,第 2 條將「特徵」及其他得以直接或間接識別個人之資料列為個人資料
- Coalition for Content Provenance and Authenticity (2026). [C2PA | Verifying Media Content Sources](). 數位內容來源與編修紀錄的開放技術標準(Content Credentials)


