
2026 年 10 月 31 日,OpenAI 的 ChatGPT 資料控制說明列出個人帳戶的 Daybreak Blue 規則:使用者即使關閉「為所有人改善模型」,在 Daybreak 工作階段中提供的互動內容仍可能用於模型改善。OpenAI 說明這是為了強化對網路濫用的防護。
The Decoder 報導指出,OpenAI 通知 Trusted Access 計畫成員,預計自 11 月 29 日起使用 Daybreak Blue 工作階段資料訓練模型,後續另寄信表示會提供單獨退出方式;該報導提及的日期與退出安排,應以使用者收到的最新通知及官方介面為準。團隊要問:哪些資料會進入哪個工作階段、誰有權使用,以及一般帳戶設定是否涵蓋該工作階段?
一、Daybreak Blue 的資料使用邊界改在哪裡?
OpenAI 現行說明指出,個人帳戶的 Daybreak 工作階段內容可能用於模型改善,即使一般模型改善選項已關閉。一般開關仍適用於非 Trusted Access 工作階段的其他活動。
OpenAI 將 Daybreak 列為 Trusted Access 資安計畫,Daybreak Blue 供經核准的漏洞分流、安全程式碼檢視、惡意程式分析與事件應變。規則限定特定工作階段,關閉一般選項不能解讀為所有帳戶互動均不會用於模型改善。
企業工作區的一般資料條款可參考AI 資料授權核對指南,但不能直接套用到個人帳戶的 Daybreak 工作階段。
官方說明僅指出個人帳戶 Daybreak 工作階段「可能」用於模型改善,沒有表示相同規則適用所有使用者、企業工作區與 API。The Decoder 根據成員收到的電子郵件報導 11 月 29 日的變更與後續退出安排,但官方說明頁與電子郵件細節仍須分開核對。個人帳戶使用者應查看收到的通知、Daybreak 工作階段設定及最新官方說明;團隊管理者則應記錄核對日期與規則版本。
「在個人帳戶的 Daybreak 工作階段中,即使『為所有人改善模型』已關閉,我們仍可能使用互動內容改善模型。」(譯自 OpenAI Help Center)
二、一般模型改善設定涵蓋哪些資料路徑?
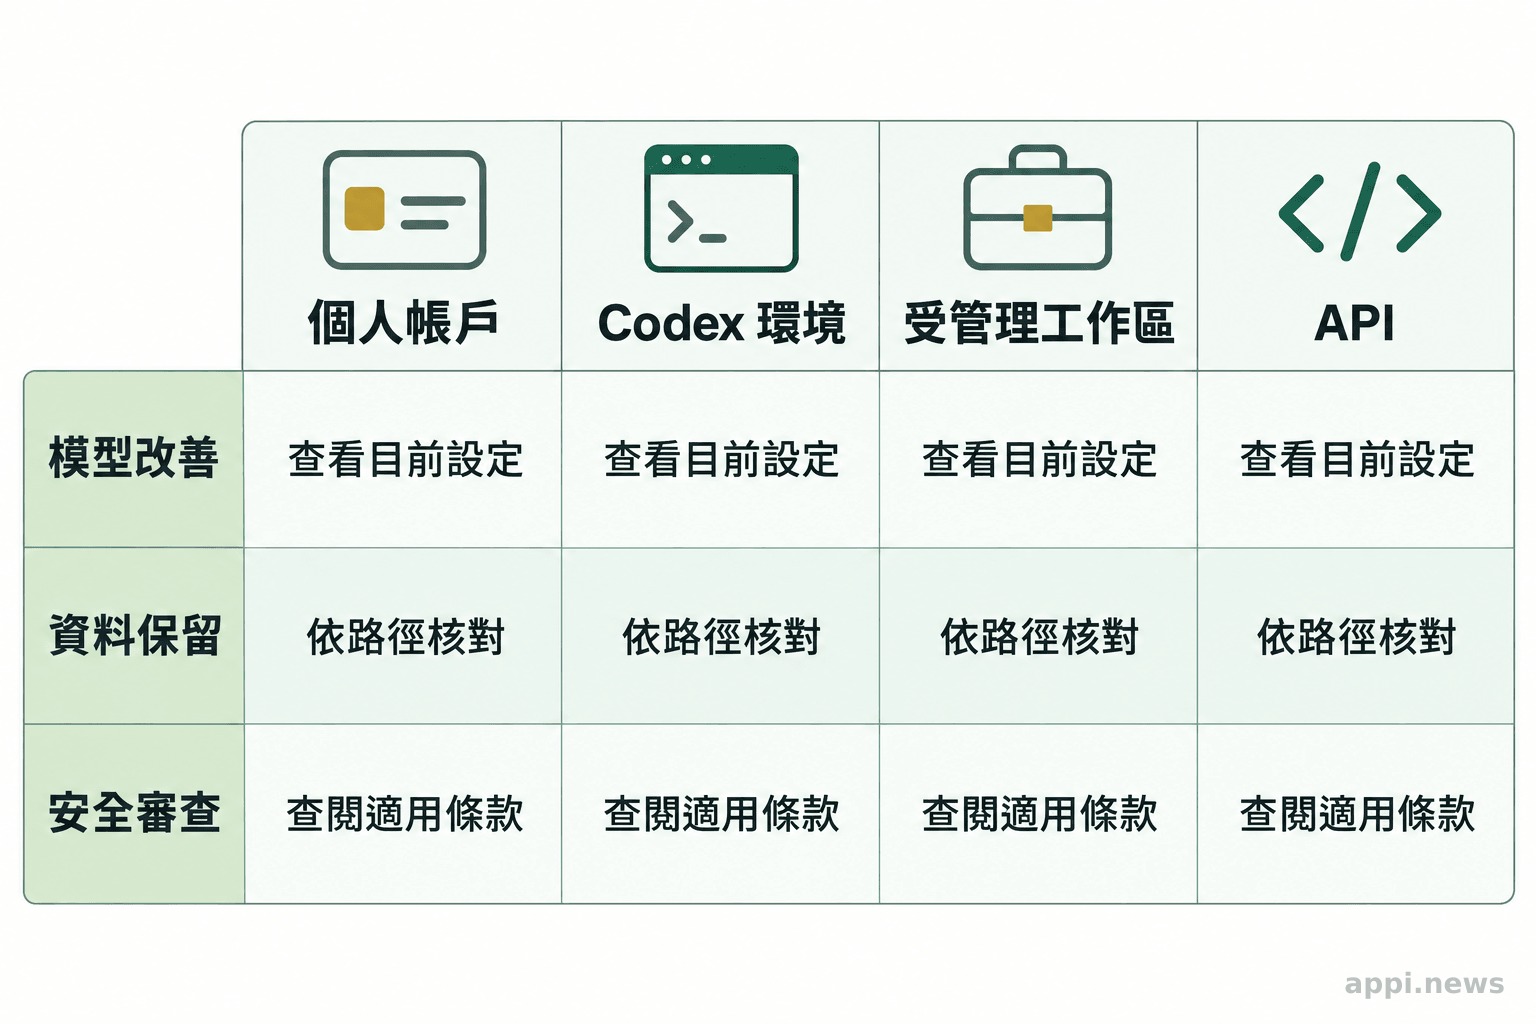
不相同。OpenAI 對個人帳戶的 Daybreak 工作階段、受管理工作區與 API 分別說明資料使用方式;不能從其中一條路徑推定另一條。
個人 ChatGPT 帳戶的「為所有人改善模型」設定,控制一般活動是否用於模型改善;但 OpenAI 現行說明把個人帳戶的 Daybreak 工作階段列為特別情況。另一個容易漏掉的例子是 Codex:Help Center 說明,Codex 工作的「Include environments」有獨立設定,改動 ChatGPT 一般設定或使用 Privacy Portal 退出,不會同步改變該設定。同一帳戶內也可能有不同的資料控制入口。
| 資料路徑 | 模型改善規則 | 另外要確認 |
|---|---|---|
| 個人帳戶 Daybreak | 工作階段內容可能用於模型改善,即使一般選項關閉 | 專屬通知與退出方式 |
| Codex 環境 | 有獨立的環境資料設定 | Include environments 選項 |
| 受管理工作區 | 預設不供模型訓練 | 工作區政策、保留期限與權限 |
| API | 預設不供模型訓練 | 端點保留、濫用監控與 ZDR 資格 |
企業工作區與 API 的預設又不同。OpenAI 的商務資料政策表示,ChatGPT Business、Enterprise、Edu、Healthcare 等受管理工作區,以及 API 平台的輸入與輸出,預設不會用於模型訓練;企業管理者仍須確認自身工作區政策、保留設定與權限配置。API 資料控制文件另說明,濫用監控紀錄與應用程式狀態各有保存規則,保留期限依端點與設定而異。Daybreak 的核准本身也不等於取得零資料保留(Zero Data Retention,ZDR),OpenAI 的Daybreak 說明將 Trusted Access 與 ZDR 列為不同項目。
「模型訓練」涉及內容是否可能用來調整模型;資料保留指資料保存多久;濫用監控與安全審查則屬服務營運與風險控管。只記錄「已關閉訓練」,仍無法確認保存情況、存取者或安全審查用途。
若團隊要比較企業條款與資料控制,可參考AI 隱私與企業資料控制的差異,並核對實際方案與服務條款。
三、敏感研究內容為什麼會引發信任疑慮?
這起事件說明,研究者把未公開草稿交給 AI 工具協助工作時,會關心資料是否被存取、如何進入模型改善,以及公司能否說明資料路徑;它沒有證明草稿已被用於訓練。
紐約大學數學家 Tristan Buckmaster 與 Levent Alpöge 合作研究流體方程,並使用 Claude、Codex 等大型語言模型協助推進與整理工作。Buckmaster 在個人聲明中寫道,兩人使用了多種模型,並提及 Codex;相關報導指出,他們在研究期間把草稿放進 Codex。OpenAI 隨後公開相關數學成果,引發外界對研究進度、資料存取與模型訓練的疑問。
紐約大學 Courant 研究所公告,Buckmaster 與 Alpöge 公布三項結果,分別涉及不可壓縮多孔介質方程、Boussinesq 方程與三維不可壓縮 Euler 方程,並以 Lean 形式化驗證。這些成果不表示資料遭到外洩;它們呈現研究者把模型帶入未公開工作後,供應商資料規則如何影響信任判斷。
事件中的關鍵區分是「資料是否被直接查看」與「去識別化使用資料是否可能影響模型改善」並非同一件事。OpenAI 在回應報導中表示,研究人員與代理在論文公開前沒有看到兩人的研究資料,且沒有為解題存取特定使用者資料;公司同時表示,雖然可能性低,仍無法排除產品使用所衍生的去識別資料曾協助改善模型。兩種說法應一併呈現,不能簡化成「草稿已被訓練」或「資料絕不可能影響模型」。
「我們在整個過程中使用了幾種大型語言模型,包括 Anthropic 的 Claude、OpenAI 的 Codex。」(譯自 Tristan Buckmaster 個人聲明)
研究事件不等於 Daybreak Blue 政策的直接證據,卻具體呈現敏感資料治理的根因:工作者可能把草稿、漏洞線索、客戶環境資訊或尚未公開的分析輸入工具,組織卻未先確認個人帳戶與機構帳戶的控制差異、資料保留和存取責任。對處理客戶委託、未公開漏洞、事件應變資料、商業機密、個人資料或憑證的資安研究者與團隊,這些工作內容應先依敏感程度分類,再決定是否能輸入服務。
若組織的工作方式橫跨本機工具、雲端代理與 API,也要把權限與網路邊界一併盤點。可參考AI 代理部署前的資料與網路邊界檢查,把使用者身分、資料來源、外部連線和日誌留存納入同一張流程圖,而非只檢查模型供應商的訓練政策。
四、團隊要先分清哪些角色與資料責任?
先指定資料負責人、服務管理者、核准者與實際使用者,再明定哪些資料可輸入、誰能開啟工作階段、誰檢查供應商條款,以及誰負責通知規則變更。
資料負責人區分公開資訊、程式碼、客戶與個人資料、憑證及未公開漏洞。服務管理者確認核准帳戶、工作區、API 專案及 Daybreak 功能,並列出禁止使用個人帳戶的情境。資安或法務/隱私負責人審查資料條款、保留期間、退出機制與使用者告知。
權責不清時,容易把「已關閉模型改善」當成整個資料生命周期的保證,或把企業方案預設套用到個人帳戶的特定工作階段。若內部指引只有設定截圖,沒有產品、帳戶類型、工作階段、檢查日期與負責人,政策更新後舊指引仍可能誤導員工。
為降低誤用,團隊可將核准流程分成兩層:先判定資料是否允許進入外部 AI 服務,再判定核准服務的哪個產品介面與帳戶類型可以處理它。若規則沒有明確涵蓋某類資料或工作階段,就先遮蔽識別資訊、改用合成資料,或走既有的內部工具與人工流程,待條款確認後再調整。這樣做不能保證資料不被處理,但能把輸入內容限制在團隊可接受的範圍。
五、導入或續用前的 5 項檢查
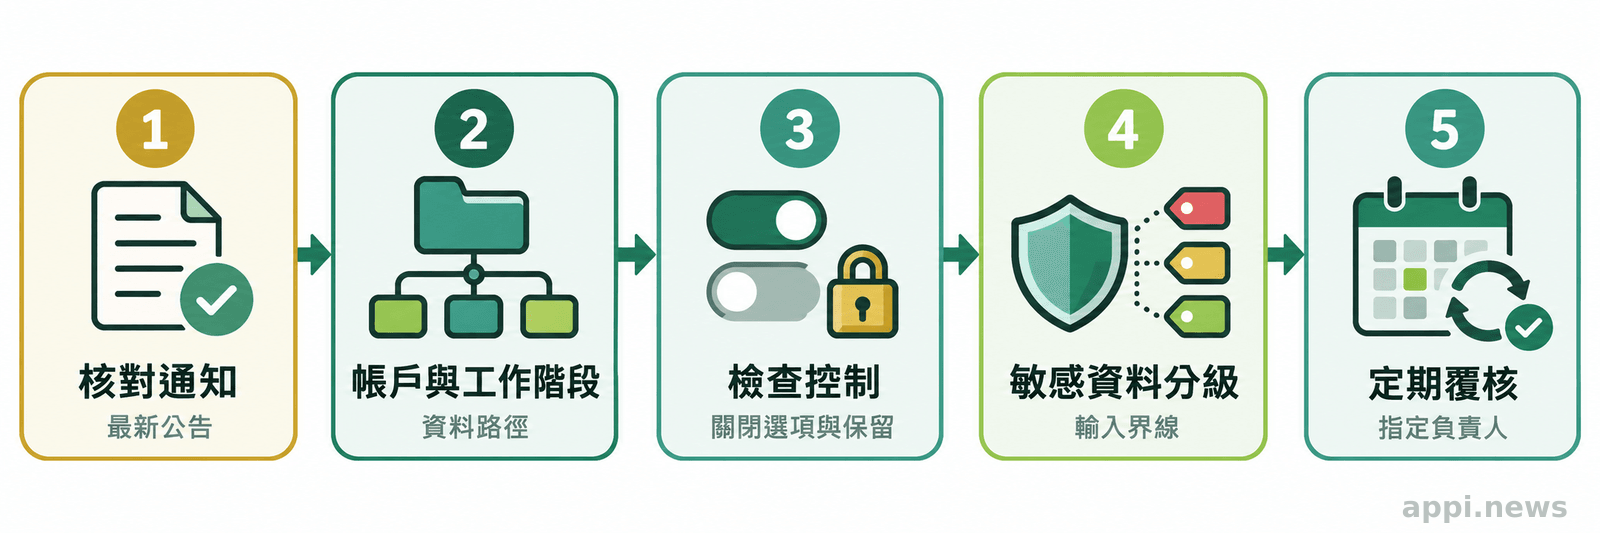
逐項確認官方通知、帳戶與工作階段、退出控制、敏感資料範圍及內部責任紀錄,並為每項結果指定覆核者與日期。
- 核對通知版本: 由服務管理者查看 OpenAI 最新 Help Center 說明、帳戶收到的通知與服務條款,記錄頁面日期、適用方案及已知變更。若媒體報導提到新安排,而官方頁面尚未說明細節,先標為待確認,不把報導當成已落實的產品控制。
- 確認資料路徑: 列出使用者登入的是個人帳戶、受管理工作區還是 API 專案;再標示是否為 Daybreak 工作階段、Codex 任務或一般聊天。不要用一個帳戶設定推論所有介面。
- 逐個檢查退出與保留: 分別檢查模型改善選項、Codex 環境資料控制、資料保留期限,以及安全審查或濫用監控用途。記錄哪些控制已確認,哪些需向 OpenAI 或合約窗口詢問。
- 設定輸入資料分級: 明確禁止輸入密碼、存取權杖、可識別客戶資料和未公開漏洞細節,除非組織完成核准並有適用的資料處理依據。建立遮蔽、去識別化或替代測試資料的做法。
- 告知使用者並定期複核: 在內部指引寫清楚允許用途、禁止資料、核准帳戶、退出步驟、資料保存規則與回報管道;指定負責人,在產品說明或帳戶設定更新時重新檢查。
記錄產品介面、帳戶/工作區、資料類型、改善設定、保留與安全用途、核准人及檢查日期。資安、法務/隱私與服務管理者確認後,再開放使用;無法辨認帳戶或工作階段時,先不要輸入敏感資料。
- 個人帳戶的 Daybreak 工作階段,OpenAI 現行說明稱內容可能用於模型改善,即使一般改善設定關閉。
- 受管理工作區、API 與 Codex 環境設定各有不同控制,模型改善、資料保留及安全審查也應分開檢查。
- 導入前先核對帳戶、工作階段、資料類別、退出選項與責任人,並保留政策版本與檢查日期。
常見問題
Q1:關閉「為所有人改善模型」後,Daybreak Blue 對話還可能用於模型改善嗎?
依 OpenAI 現行說明,個人帳戶的 Daybreak 工作階段內容仍可能用於模型改善;一般設定適用於其他非 Trusted Access 活動。後續若收到專屬通知或退出選項,以最新設定及官方說明為準。
Q2:OpenAI 會用所有企業工作區與 API 對話訓練模型嗎?
OpenAI 說明,受管理工作區與 API 資料預設不供模型訓練;仍須核對合約、管理設定及特定工作階段規則。
Q3:Buckmaster 與 Alpöge 的研究草稿已被用於訓練嗎?
沒有證據顯示草稿已被用於訓練。OpenAI 表示未在論文公開前查看兩人的特定資料,但無法排除去識別化使用資料曾協助模型改善。
參考來源
- OpenAI Help Center. (2026). *Data controls in ChatGPT
- Matthias Bastian. (2026). *OpenAI plans to train models on Daybreak Blue cybersecurity session data that was previously off-limits*. The Decoder
- OpenAI. (2026). *Business data privacy, security, and compliance
- OpenAI. (2026). *Data controls in the OpenAI platform
- Tristan Buckmaster. (2026). *Statement* [個人聲明 PDF]
- Matthias Bastian. (2026). *OpenAI researcher allegedly pressured mathematician to drop Anthropic co-author from math breakthrough paper*. The Decoder
- OpenAI Help Center. (2026). *OpenAI Daybreak: Trusted Access for Cyber overview
- NYU Courant Institute. (2026). *News | NYU Courant


