
換一台裝置,AI 還能接續先前看過的資料或討論過的任務,使用上確實方便;但要做到跨裝置延續,資訊就必須在任務結束後繼續存在某處。Google DeepMind 於 2026 年 9 月 23 日公布 Private AI Compute 的伺服器端記憶設計,說明如何在雲端保存個人脈絡,並透過裝置金鑰、加密通道與安全隔離區處理資料。公告描述的是架構與設計目標,不能直接當成所有產品已提供此功能,或所有風險都已排除。
Private AI Compute 如何從無狀態處理走向伺服器端記憶
Google DeepMind 表示,這項設計讓雲端 AI 能在不同裝置與不同工作階段間保留所需上下文。資訊會存放在雲端的專屬加密儲存空間,讓助理有機會接續先前的任務。
過去的 Private AI Compute 被描述為無狀態處理,任務結束後便清除上下文。這有利於縮短資料留存時間,卻不適合需要長期脈絡的助理,例如在手機上查看過的說明,稍後希望在筆電繼續使用。伺服器端記憶增加了持續保存這一層,因此系統設計必須同時處理「如何延續」和「如何限制存取」。
這個改變不代表 AI 會完整保存每段對話,也不代表使用者可以控制所有記憶細節。哪些內容會被選入記憶、如何更新、何時清除、使用者能否逐項檢視,仍須以實際產品介面和政策為準。官方公告提出的是 Private AI Compute 的技術能力與方向,並未在公告中逐一交代所有產品層級的操作選項。
記憶資料如何經過裝置、加密通道與安全隔離區
依 Google DeepMind 的說明,裝置透過經驗證的端對端加密通道連到雲端安全隔離環境;環境會在隔離記憶體中暫時解密所需資料、處理請求,再保存新脈絡並重新加密。
官方架構可分成幾個責任不同的部分:個別使用者的資料庫負責持續保存加密記憶;裝置持有或衍生出用來保護記憶的密鑰;安全隔離區則負責在受保護的雲端環境中完成推論所需的暫時處理。加密通道保護資料傳輸,隔離執行環境限制處理期間的存取,儲存加密則保護靜置資料。這些控制措施互相補充,不能彼此取代。
「裝置持有金鑰」描述的是密鑰控制設計,不宜簡化成資料完全留在裝置。記憶本身仍存放在雲端,服務請求也會在雲端隔離環境處理。隔離環境需要在處理期間取得可用資料,如何驗證該環境、何種軟體可以執行,以及密鑰如何交付,都是理解安全邊界的重要細節。
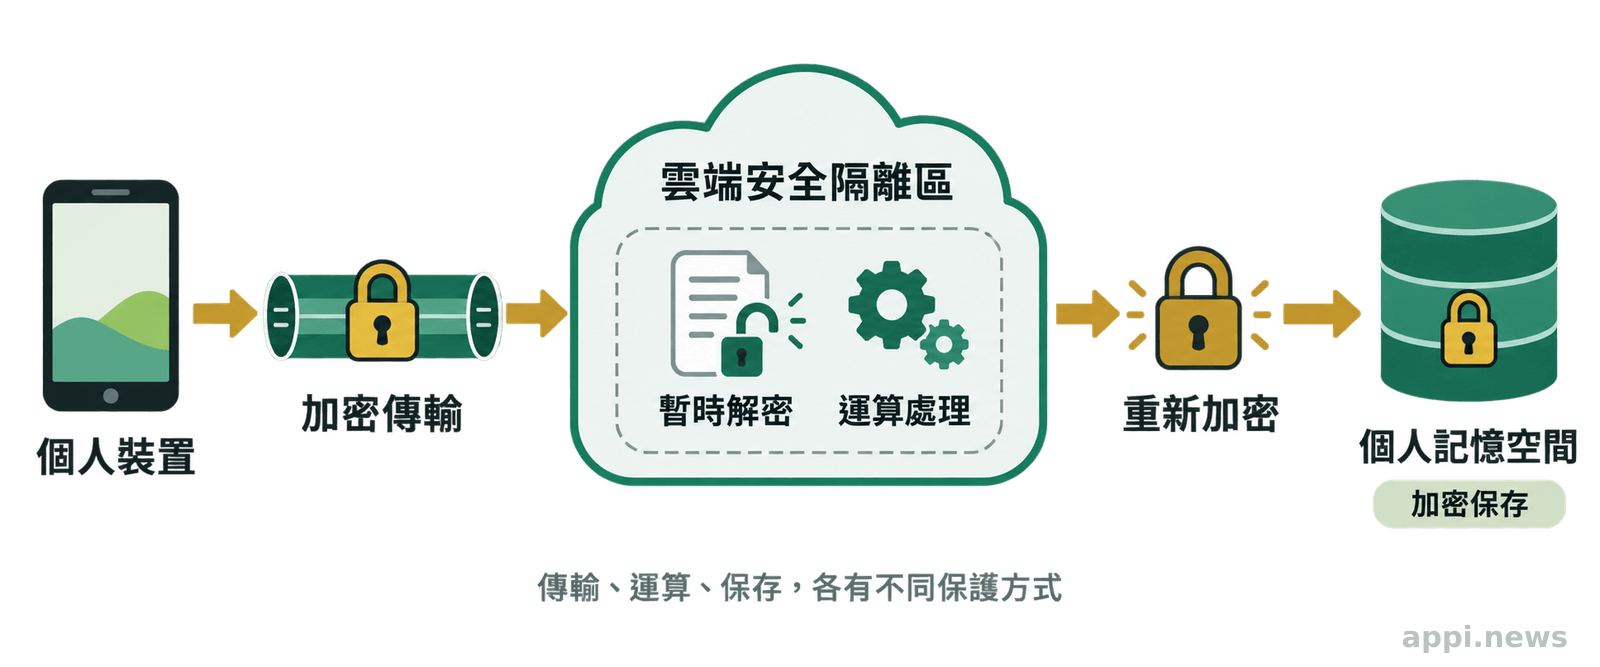
雲端保存與隔離環境各自負責什麼
雲端儲存讓不同裝置有機會讀取同一份長期脈絡,隔離環境則限制伺服器處理資料時的執行條件。兩者解決不同問題:前者涉及保存位置、存取期限與刪除;後者涉及處理期間的機密性、軟體完整性與驗證方式。只知道「有加密」仍不足以回答資料會保存多久,或使用者如何刪除一項錯誤記憶。
同樣地,端對端加密也需要說明端點在哪裡。公告描述資料從個人裝置通往雲端安全隔離環境,並於隔離記憶體中暫時解密。讀者應把傳輸中的保護、儲存時的保護、運算中的隔離分開理解,再依技術文件確認各階段如何實作與驗證。
暫時解密與重新加密能說明哪些限制
加密資料要供 AI 使用,就必須在某個受信任的運算環境中以可處理的形式出現。Google DeepMind 說明資料會在安全隔離區的記憶體中暫時解密,完成請求後再保存新脈絡並立即加密。這是官方對設計流程的描述,不等於外部研究者已證明所有程式、硬體與部署情境均沒有弱點。
重新加密也不等於刪除。若記憶已不再需要,刪除政策必須說明主要儲存、備份、同步副本與復原流程如何處理;停用記憶功能則要確認既有內容會保留、封存或清除。這些問題需要由服務政策和操作介面回答,不能只從加密機制推論。
跨裝置個人化帶來便利,也增加資料治理問題
記憶可減少重複交代偏好或任務背景的時間,但也可能保存錯誤、過時或不適合長期保留的資訊。使用者需要掌握記憶內容、修正方式、刪除期限與帳號復原條件。
Google DeepMind 用在智慧眼鏡查看裝配說明、之後在筆電接續,以及手機與網頁間延續複雜對話作為可能情境。這類延續性可減少重複輸入,對多步驟任務尤其有用。相對地,若系統把暫時需求當成長期偏好,之後的回答可能持續受到錯誤脈絡影響;若記憶涵蓋工作、家庭或健康資訊,保存範圍與分享設定也會變得更重要。
裝置遺失、換機或帳號復原是另一個實際考驗。裝置持有金鑰的設計不會自動回答金鑰如何備份、舊裝置如何撤銷、遺失後能否取回記憶,或復原流程會要求哪些身分驗證。便利性取決於服務是否能安全復原;資料控制則取決於復原過程是否清楚、可選擇且有適當防護。
- 伺服器端記憶把上下文持續保存於雲端,與純本機處理不同。
- 加密、隔離執行、刪除與帳號復原是不同控制項目,應分別確認。
- 廠商公布的架構是評估起點,仍須搭配技術驗證、獨立審查與產品政策。
隱私主張應如何用技術文件與審查資料驗證
先查可公開檢視的伺服器軟體紀錄、技術簡報、系統架構、安全證明、驗證協定與獨立審查範圍,並確認它們對應的版本和部署條件。
Google DeepMind 表示,將提供伺服器軟體的防竄改公開紀錄,讓裝置在傳送個人資料前驗證軟體是否真實且未遭修改;公告也提到更新技術文件與資安公司的獨立稽核。這些是值得追蹤的透明度措施。要評估其證明力,仍應閱讀文件本身,確認審查者、測試範圍、排除項目、測試版本、發現事項及修補狀態,而不是只看「已稽核」或「可驗證」等摘要字眼。
軟體紀錄能協助比對程式版本與發布資訊,不能單獨證明產品政策符合使用者期待;安全證明能檢視特定假設和協定,也不表示所有操作情境都已覆蓋。獨立審查的結論同樣有適用範圍。Google DeepMind 的公告主要描述設計與預定能力,實際保障程度仍取決於實作、驗證結果、更新方式,以及使用者所在服務的資料政策。
「Building that trust starts with transparency.」這是 Google Private AI Compute 團隊對信任建立方式的說明;能否形成可查證的信任,仍要看公開資料是否足以讓外部檢視其範圍與限制。
啟用雲端 AI 記憶前,先確認五項控制條件
確認保存內容與期限、逐項檢視和刪除方式、停用後的處理、金鑰與帳號復原流程,以及技術驗證和獨立審查的實際範圍。
- 看清保存範圍:服務會記住哪些資訊,敏感資料是否會被排除,記憶是否同步到其他裝置或功能。
- 確認檢視與刪除:能否查看、修改單筆記憶,刪除後何時生效,備份和同步副本如何處理。
- 確認停用效果:關閉記憶後,是停止新增、停止讀取,還是連既有記憶一併刪除;不要把這幾種結果視為相同。
- 查明復原方式:換機、裝置遺失或帳號復原時,密鑰如何處理,舊裝置如何撤銷,復原失敗會失去哪些資料。
- 核對證據與適用條款:查看技術文件及獨立審查的版本和範圍,並依實際服務條款與適用地區確認個人資料處理方式,不以通用架構推定法律結論。
若產品沒有交代保存、刪除與復原細節,使用者便難以衡量長期記憶的代價。對工作資料、財務紀錄或健康資訊等敏感內容,可先檢查是否能關閉記憶或排除特定對話,再決定是否交由雲端服務處理。評估重點是服務能否提供可理解、可操作的控制,而非只比較功能是否方便。
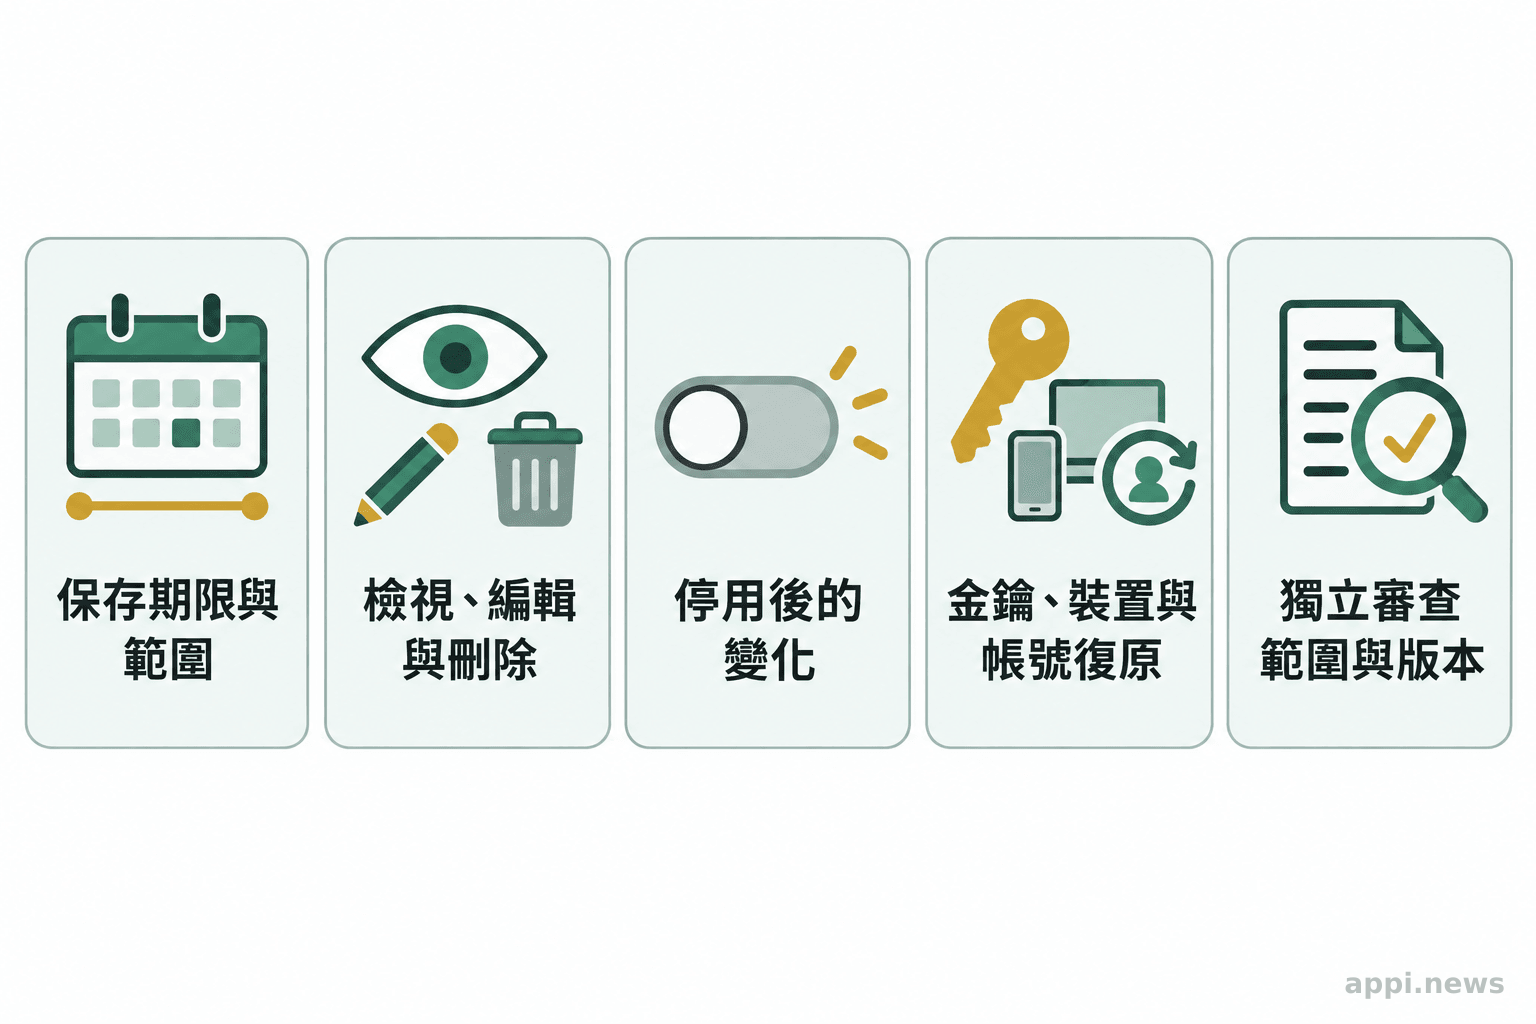
依資料敏感度與可控程度衡量雲端記憶的便利
當跨裝置延續任務帶來的便利足以抵銷保存風險,而且服務提供明確的檢視、刪除、停用與復原控制,雲端記憶才較容易納入日常使用。
Private AI Compute 的伺服器端記憶呈現一種產品設計方向:把長期脈絡放在雲端,同時透過裝置金鑰、加密通道和安全隔離區限制資料處理方式。對使用者而言,關鍵在於從技術設計一路核對到實際服務設定。啟用前先查保存、刪除、停用及金鑰復原說明,再依資料敏感度選擇是否交由服務處理;若控制方式不清楚,就先不要放入不易更換或難以承受外流的資料。
常見問題
Q1:伺服器端記憶是不是本機 AI?
不是。依 Google DeepMind 公布的設計,記憶存於雲端加密儲存空間,請求也會在雲端安全隔離區暫時處理;本機處理與伺服器端記憶的資料位置和運算方式不同。
Q2:裝置持有金鑰是否代表 Google 無法接觸資料?
這是 Google DeepMind 對其架構的主張。評估時仍要檢視密鑰如何產生與使用、隔離環境如何驗證,以及獨立審查涵蓋哪些版本和情境,不能只憑一句摘要推論沒有任何存取風險。
Q3:關閉記憶功能就會刪除既有資料嗎?
不一定。停用可能只阻止新增或讀取,也可能觸發刪除,實際效果須查該服務的設定說明與資料政策。
Q4:忘記金鑰或遺失裝置後,記憶可以復原嗎?
僅從「裝置持有金鑰」無法判斷。應先確認服務提供的換機、帳號復原、裝置撤銷和備份流程,以及復原失敗時資料是否會永久無法讀取。
參考來源
- Google Private AI Compute Team. (2026). *Advancing Private AI Compute with secure, server-side memory*. Google DeepMind
- Google. *Private AI Compute Technical Brief
- Birkholz H., Thaler D., Richardson M., Smith N., Pan W. (2023). *RFC 9334: Remote ATtestation procedureS (RATS) Architecture*. RFC Editor
- Barker E. (2020). *Recommendation for Key Management: Part 1 – General*. NIST SP 800-57 Part 1 Rev. 5, National Institute of Standards and Technology


