本地AI和雲端AI的比較,已從單機推理延伸到Windows電腦、代理工作流與結構化輸出;選擇仍要回到資料流、即時資訊、硬體與維護條件。
一、為什麼現在要重新比較本地AI與雲端AI?
這三項更新讓本地AI的比較涉及硬體、代理工作流與開發工具,仍不代表所有電腦結果相同。
NVIDIA 官方於 2026 年 9 月 3 日公告,RTX Spark Windows PC 預計於 10 月推出。產品方向包含最高128GB統一記憶體、20核心Grace CPU與Blackwell GPU;公告規格不能直接當成每款機型的實際效能。
「RTX Spark marks a real breakthrough towards that vision.」— Microsoft董事長兼執行長Satya Nadella,NVIDIA Newsroom
NVIDIA、Perplexity與Windows本地AI電腦的新進展
NVIDIA將Perplexity Portable Computer列為本地代理方案,可在支援硬體執行部分工作,再把需要網路搜尋或更強推理的步驟升級到雲端;Windows支援仍以後續推出為前提。Linux上的一種條件是RTX GPU至少24GB顯存,這不是通用門檻。
llama.cpp v0.4.1更新了什麼
llama.cpp v0.4.1新增Maple 20B-A1B、Tencent Hy 4預覽架構與Spark2.5支援,並改進JSON Schema處理;格式符合仍要驗證與人工覆核。
二、本地AI與雲端助理的能力差異怎麼看?
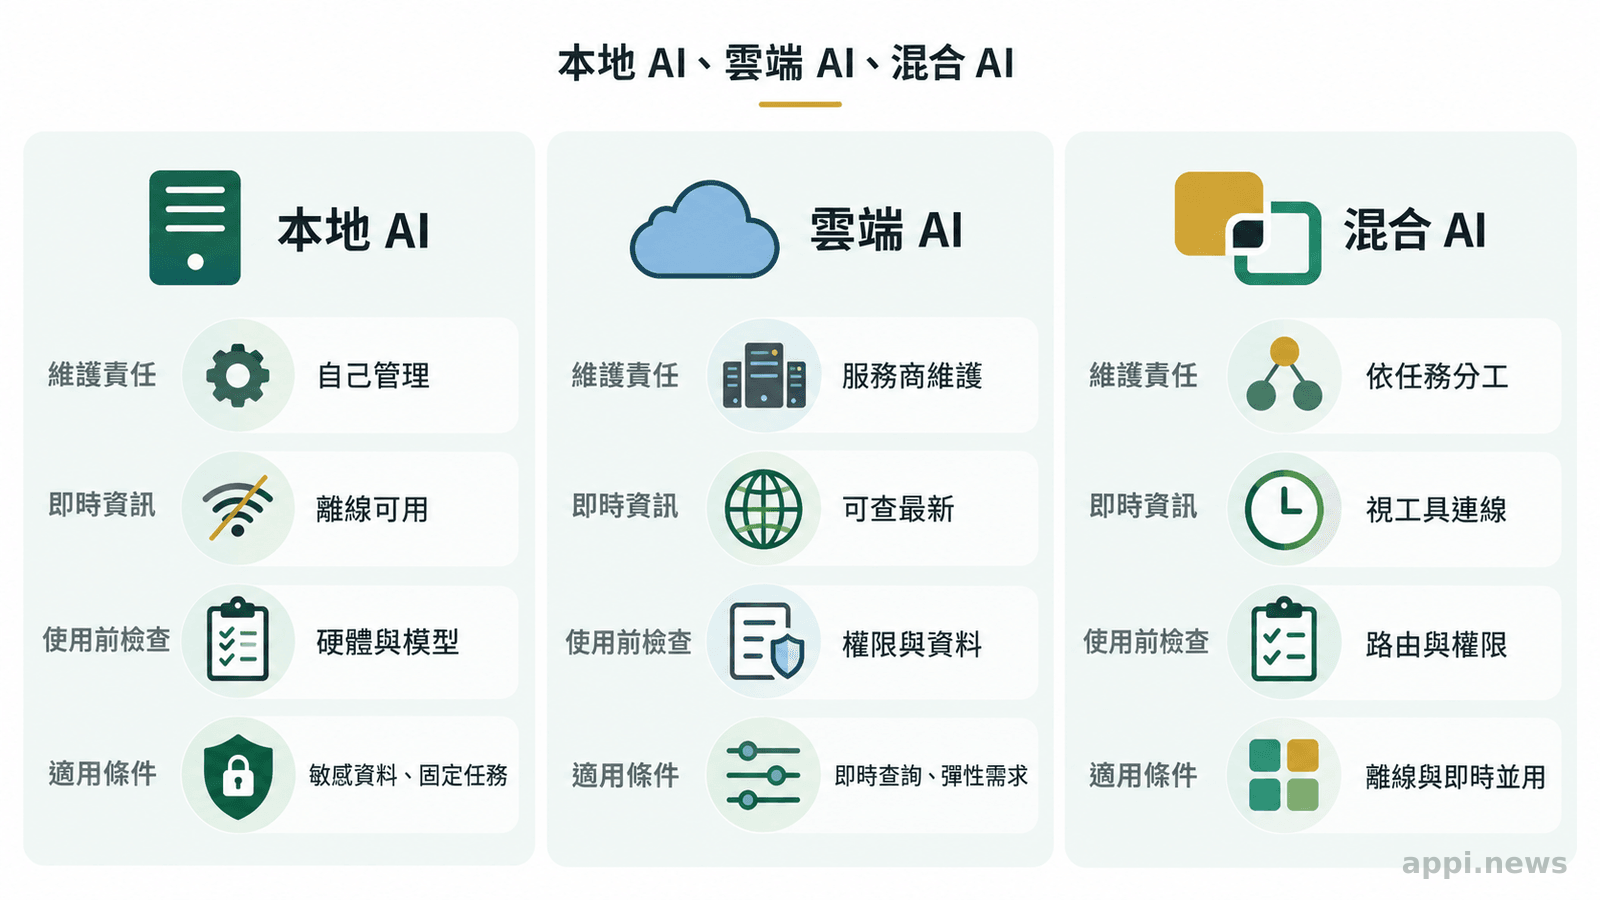
本地AI偏向資料留置、離線與流程控制;雲端助理偏向即時資訊、多工具與少維護。
模型推理、即時資訊與多工具協作
本地模型離線時,只有在資料與工具均已本地化且支援離線時,才能使用裝置內資源;最新消息與法規查證仍要另建搜尋機制。雲端較易接上即時搜尋,但要理解保存期限與帳號權限。
JSON結構化輸出對工作自動化的價值
結構化輸出適合分類信件、擷取期限和整理測試結果;即使格式正確,內容仍可能錯誤,高風險流程須檢查欄位與業務規則。
| 比較面向 | 本地AI | 雲端AI | 混合AI |
|---|---|---|---|
| 資料位置 | 可留在裝置 | 部分輸入送到遠端 | 依設定分流 |
| 資料治理條件 | 檢查外掛、權限與同步 | 確認保存期限與帳號權限 | 確認應用程式、工具與雲端轉送設定 |
| 即時資訊 | 需自行接資料來源 | 較易取得網路服務 | 雲端查詢,本地處理內部資料 |
| 成本與維護 | 使用者管理硬體與模型 | 主要管理帳號與用量 | 兩端都要管理 |
| 離線能力 | 相容環境可離線 | 通常需要網路 | 本地步驟可離線 |
「Highly optimized models running locally through llama.cpp with RTX Spark’s AI performance will unleash the next wave of personal, private agents.」— llama.cpp創辦人Georgi Gerganov,NVIDIA Newsroom
三、硬體門檻與使用成本怎麼算?
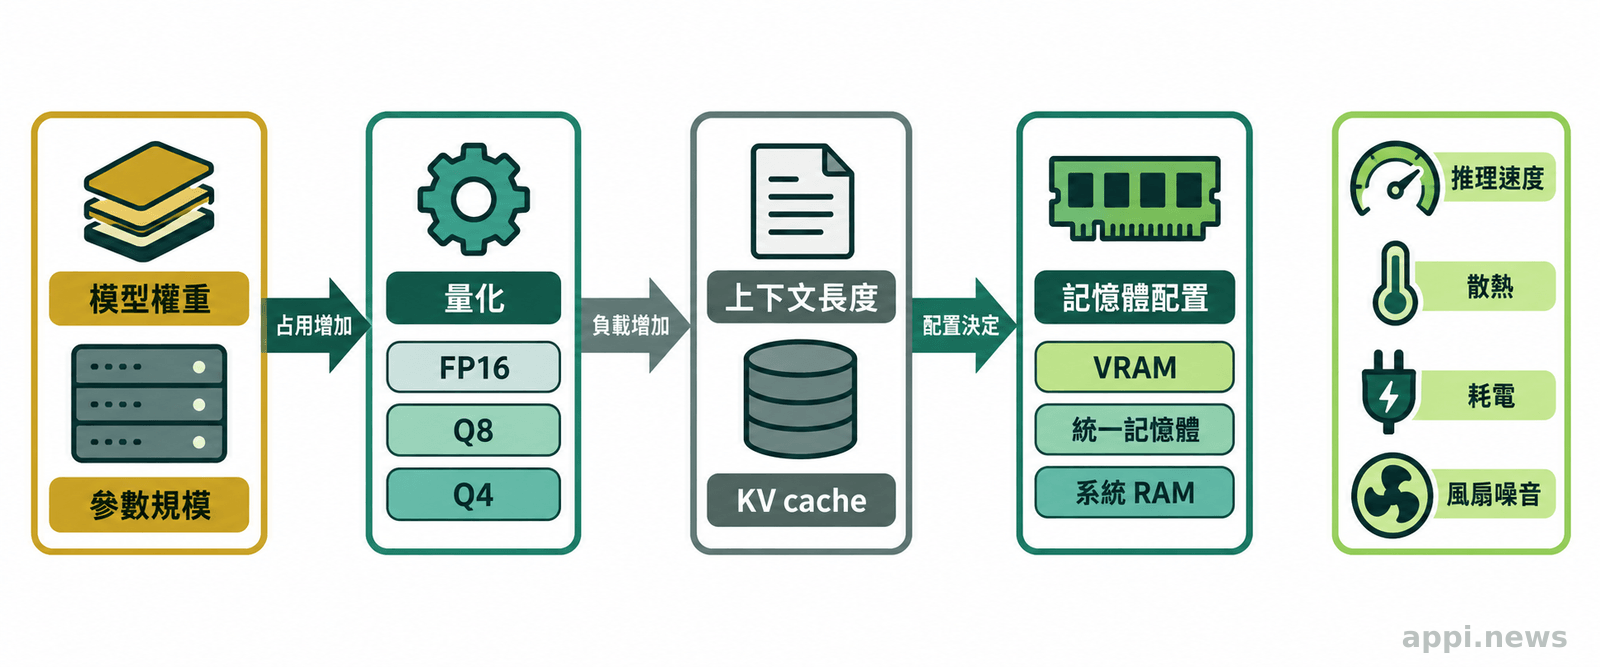
本地AI的門檻取決於模型大小、量化、上下文長度與速度要求,不能只看顯卡名稱。
GPU顯存、系統記憶體與模型量化
模型權重與推理中間資料可能由顯存、統一記憶體或系統記憶體共同承擔,配置取決於後端與卸載方式;長文件還會增加上下文與KV cache。量化可降低占用,也牽涉精度、速度和相容性。
一次性硬體支出與雲端訂閱成本
本地AI還有儲存、電費、散熱、驅動與故障排除成本,團隊也要管理權限與版本;雲端省下硬體支出,但訂閱、用量和資料治理仍有成本。
四、本地AI真的比較保密嗎?
本地執行有機會降低部分資料外傳,但隱私仍取決於應用程式、Windows權限、第三方工具、遙測與雲端升級。
資料留在裝置上的優勢與限制
模型與索引本地執行時,合約、程式碼或財務資料有機會不離開裝置;同步服務和外掛仍可能形成其他資料流。
模型、應用程式、外掛與作業系統仍可能接觸資料
本地模型與Perplexity應用程式各自有資料處理責任;Windows權限與第三方工具可能改變資料流,需確認模型來源、資料夾、指令、網域與人工核准。
五、台灣使用者要注意哪些可用性問題?
台灣使用者要分開確認官方支援時程、上市與保固、繁體中文表現、軟體下載、付款方式和服務區域,不能只看海外發布會或規格表。
Windows支援時程、產品上市與區域供應
NVIDIA於2026年9月3日公告,RTX Spark Windows電腦預計在2026年10月推出;Perplexity Portable Computer的Windows支援仍待後續推出。台灣通路與售後以實際上市資訊為準。
繁體中文、台灣服務與付款方式
繁體中文表現要測試專有名詞、台灣地址、日期格式、表格和中英文件;雲端付款、帳號地區與資料保存地點可能受限,本地模型則要另建台灣資料來源。
六、四種使用情境怎麼分流?
一般查資料和需要即時網路的工作可優先考慮雲端,敏感文件與固定流程可評估本地或混合架構,開發與自動化則要依團隊維護能力決定。
一般文書與查資料:雲端優先
摘要公開文件、整理網路資料和處理跨格式內容,通常重視速度與少維護;雲端助理較易整合搜尋,涉及機密或個資時先匿名化。
敏感文件與固定流程:評估本地或混合架構
公司內規、客戶文件、程式碼和個人財務資料,可先盤點欄位,再決定是否讓模型本地讀取;固定分類與摘要適合本地,匿名化問題再送往雲端。
開發、自動化與實驗:llama.cpp適合進階使用者
需要選模型、調整量化、串接API和測試Schema的人,較能利用llama.cpp v0.4.1;代價是自行處理版本相容與監控。
即時研究與團隊協作:雲端或混合
市場資訊、政策變更和多人協作需要瀏覽器或共用文件,雲端較易整合;混合方案可讓內部文件留本地,把篩選後的問題送往雲端。
- 列出工作中不能上傳的資料,標記可匿名化的欄位。
- 記錄每日即時資訊需求、離線時間與可接受等待時間。
- 估算硬體、電費、訂閱、維護和人工覆核的總成本。
- 先用低風險流程試跑,檢查繁體中文、資料流、錯誤率和權限紀錄。
七、結論:按資料敏感度與工作需求分流
選擇順序應是資料敏感度、即時資訊需求、硬體與維護能力,再看模型和產品名稱。
- 本地執行可控、可離線且有機會降低部分資料外傳,但應用程式、外掛、Windows權限與雲端升級仍要分別檢查。
- 雲端AI適合即時搜尋、多工具協作與少維護;本地AI適合敏感文件、固定流程與開發實驗。
- llama.cpp v0.4.1強化模型架構與JSON Schema處理,但結構符合格式不等於內容正確。
- 台灣購買前要重新核對上市、保固、繁體中文、支援時程、付款方式與服務區域。
常見問題
選擇前最值得確認的是資料流、硬體條件、結構化輸出的驗證方式,以及台灣實際供應狀態。
Q1:本地AI一定比雲端AI安全嗎?
不一定。本地執行可減少部分傳輸,但同步服務、外掛、Windows權限和雲端升級都可能接觸資料,要先確認資料流與權限。
Q2:有24GB顯存就能使用所有本地AI嗎?
不能。24GB是特定工具與環境的支援條件,不是所有模型的通用門檻。模型大小、量化、上下文長度和推理速度都會改變需求。
Q3:llama.cpp的JSON結構化輸出能直接接上自動化流程嗎?
可以作為接口的一部分,但仍要檢查欄位、型別、業務規則和內容真實性。寄信、刪檔或對外發布前,應加入錯誤處理與人工覆核。
Q4:台灣現在適合直接購買RTX Spark嗎?
先確認台灣正式上市、價格、保固、供應商和軟體支援。官方已公布產品方向與預計時程,實際可用性仍要以台灣通路和服務條件為準。