很多人第一個會先想到,AI 模型就是拿來生成文字。但一套 AI 系統裡,真正需要長篇回答的步驟可能只有少數;更多環節只需判斷請求屬於哪個類別、交給哪個模型,或是否符合往下執行的條件。Microsoft 於 2026 年 10 月 9 日發布 Microsoft-Decision-1,讓這類固定選項判斷有了專門的模型元件。Decision-1 以 Qwen3.5-9B 為基礎,由 Microsoft 後訓練,輸出選項分數而非自由文字。要評估它,應從流程是否有明確選項、分數能否改善實際工作,以及錯誤時如何退回人工開始。 Microsoft 官方發布
一、Decision-1 發表後,AI 系統多了一種決策元件
Decision-1 接收情境與事先定義的答案選項,再回傳各選項的機率分數,供程式選擇後續動作。 Microsoft 將它定位於分類、路由、排序、驗證與工作流程控制,並非用來撰寫或摘要內容。
Microsoft 公布的模型基礎與任務定位
Microsoft Foundry 模型目錄列出的版本為 1,基礎模型是 Alibaba 的開放權重模型 Qwen3.5-9B,Microsoft 在其上進行後訓練。這裡的「開放權重」指基礎模型的權重可取得,不代表 Decision-1 本身也能下載或自行部署;目前 Foundry 提供的是代管模型服務。Microsoft 表示未來版本可能改用 MAI 或 OpenAI 模型重新建立,因此採用者仍需留意版本和底層模型變化。 Foundry 模型目錄
第三方媒體 The Decoder 也報導了 Decision-1 的推出,並將它放在新興決策模型競爭脈絡中。該報導轉述 Microsoft 公布的測試結果,也指出比較沒有納入 Cloudflare 的 Clef 模型。這類報導有助於了解市場背景,效能數字仍應回到原始發布,辨明測試由誰執行、測了哪些任務、比較對象有哪些。 The Decoder 報導
Microsoft 公布 Decision-1 在 36 項基準測試(benchmark,模型能力的標準化測試)、近 15 萬題的比較中取得最高準確度,並描述其延遲優於參照模型。這些數據是廠商評測,不是獨立研究,也不能直接預測台灣團隊的資料、語言、流量和網路環境會有相同結果。尤其測試集的任務分布、選項設計與實際應用是否相符,會左右結果的參考價值。閱讀跑分時,應將它當成值得自己測試的線索,而非採用決策的保證。
先分清楚生成文字與輸出選項分數
一般生成模型可以回答開放式問題、改寫或摘要,但程式要把回答轉成下一步動作時,還得解析自然語言,處理格式錯誤或答案含糊等狀況。決策模型把判斷範圍縮成一道封閉問題,例如「這則訊息要交給帳務、技術或帳戶團隊?」再回傳選項與分數,整合程式便能依門檻路由。
這樣的輸出不會自動代表推理正確,也不會附上可供人理解的理由。Foundry 文件指出,Decision-1 回傳數值判斷而沒有文字解釋,應用程式必須自行決定何時自動處理、另請模型評估或交由人員覆核。若使用情境需要向使用者解釋原因、協商需求或生成內容,仍要由生成模型或人員負責。 Microsoft Foundry 使用文件
二、固定選項判斷適合放在哪些流程?
當輸入、問題和候選答案能事先界定時,可用 Decision-1 做分類、模型路由、優先排序、條件檢查或 AI 回答評分。 若需要從未知資訊中找答案、開放式推理或直接產生文字,這類模型就不適合獨立承擔。
| 做法 | 適合的任務 | 主要限制 |
|---|---|---|
| 固定規則 | 條件明確、答案穩定且可用程式判斷 | 遇到語意變化時需持續補規則 |
| 生成模型 | 開放式回答、摘要、改寫與解釋 | 輸出需解析,格式和延遲可能增加整合成本 |
| Decision-1 | 從預設選項中分類、評分或分流 | 需要先定義選項,且不產生文字理由 |
分類、路由與優先排序
客服信件、錯誤回報或使用者意圖,都能先定義成有限分類。例如把工單分為帳務、帳號、技術問題,讓程式將結果送到負責團隊;也可評估請求適合交給哪一種模型,讓成本較高的生成模型集中處理真正需要長回答的任務。這些做法的前提,是分類規則彼此可分辨,且存在「其他」或「無法判定」等出口。
若工作佇列需要排序,可將事件嚴重程度定義為低、中、高、緊急等級。分數能協助把待處理項目排出先後,但它不會替管理者設定「誰應先獲得服務」的政策。標準、例外和升級條件仍需由流程負責人確認,並檢查不同類型案件是否被系統性低估。
回答評分、條件驗證與工作流程控制
生成模型完成回答後,決策模型可以依明確量表檢查是否有回答問題、是否符合格式或是否與輸入證據一致,再將結果分類為通過、重試或人工檢查。這形成生成與判斷分工:前者產生候選文字,後者依設定的條件篩選。評分標準若寫得模糊,模型回傳的數字也只會製造精確的表象。
同樣的設計也能放在工作流程的關卡,例如檢查工具呼叫是否涉及正式資料、內容是否符合規則,或下一步該繼續、停止、重試或轉交。模型輸出只是一項控制訊號,執行程式仍須驗證回傳格式、權限和動作範圍,避免單一錯誤分數直接觸發不可逆操作。
選項沒有定義清楚時,模型也無法替流程補答案
問題設計的品質會限制模型表現。若「高優先」沒有明確界定,或「技術問題」和「帳戶問題」經常重疊,模型只能在含糊選項裡選一個。若選項漏掉常見狀況,系統可能把新型態輸入硬塞進不合適的類別。即使 API 回傳了看似精確的分數,分類架構本身的缺陷仍存在。
導入前先整理真實案例,檢查類別是否互斥、是否涵蓋常見例外,並保留拒答或轉交選項。再由實際使用流程的人員確認標籤含義一致。這個步驟通常比先微調模型更能找出根因,因為不少錯誤源自需求和資料定義,而非模型算力不足。
三、從輸入到下一步:Decision-1 如何接入既有系統
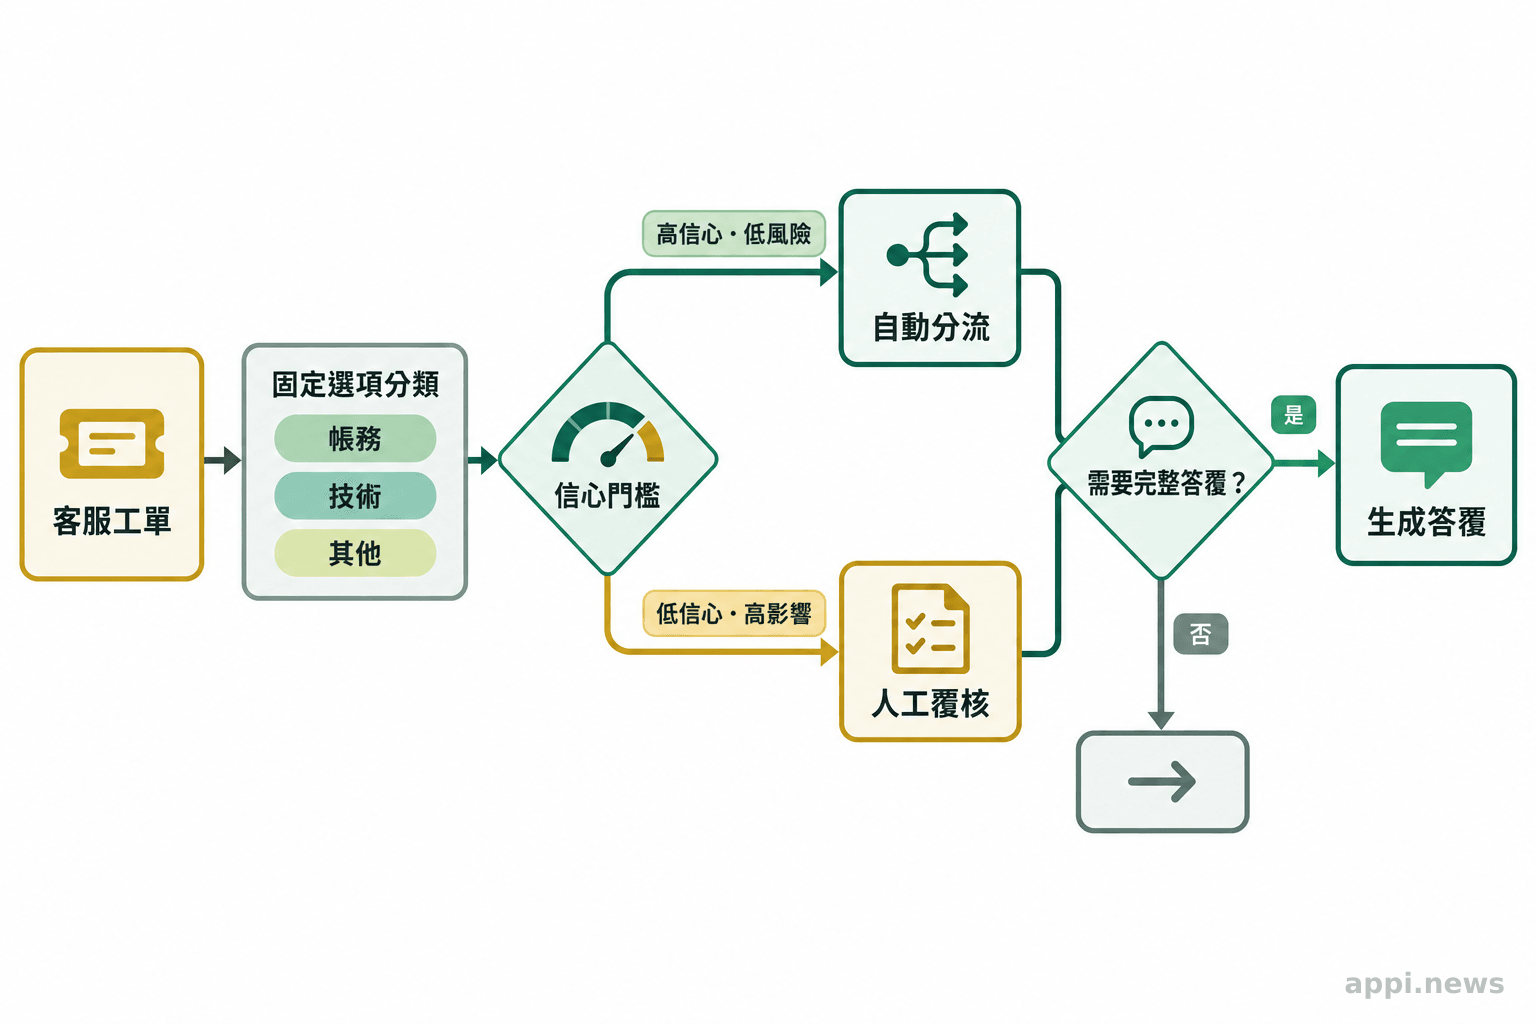
應用程式提供情境資料、判斷指示和定義好的選項,Decision-1 回傳結構化結果,再由程式按照門檻決定路由或覆核。 模型回傳的分數不會自行執行動作,整合端仍要處理驗證、例外和紀錄。
情境、判斷問題與選項如何組成請求
Foundry 文件將請求分成情境(state)和一個或多個問題(questions)。情境可以是文字或 JSON(常見的資料交換格式);問題可設定是非判斷、單選分類或有序評分,並附上指示與選項定義。比如輸入「API(應用程式介面)每次呼叫都回傳 500」,問題可以是「由哪個團隊處理?」選項再說清楚帳務、工程和客戶支援各自負責的範圍。
選項描述應使用中性且可操作的文字,避免以價值判斷暗示答案。若需要先判斷資料是否足以選擇,也應納入「無法判定」等選項。多個問題若共用同一份情境,可在同一請求中評估路由、嚴重程度和重複聯繫等項目,降低重複呼叫並讓判斷依據一致。 Microsoft Foundry API 使用說明
分數如何交給程式、人工覆核或其他模型
應用收到回應後,先確認 JSON(常見的資料交換格式)結構正確、答案名稱屬於允許的選項、必要欄位存在,再計算是否達到預先設定的門檻。高信心且低風險的分類可以自動路由;分數接近門檻、輸入異常或後果較大的案件,則交給人工或第二種模型處理。分數不足不該被默認為最接近的選項。
這個安排也可以節省生成模型的呼叫:先用決策模型分類,一般查詢走規則或小型流程,只有需要解釋、摘要或完整答覆的輸入才轉交生成模型。成本是否下降,要把請求 token、重試、延遲、模型費用和人工覆核一併計算。若為了讓分數可信而增加大量人工檢查,單看每次 API 報價便會低估總成本。
“Equivalent inputs should produce equivalent decisions.”(相同的輸入應得到一致的判斷。)— Microsoft Decision-1 發布文件,中文翻譯
四、導入前要驗收哪些能力與成本?
用自有標註資料測準確度、錯誤成本、延遲、費用和輸入變動下的一致性,再確認區域、權限、服務條款及人工接手機制。 廠商基準測試只能提供比較起點,不能取代自己工作負載的驗收。
用自有資料檢查準確度、延遲與信心分數
先挑選一批涵蓋常見狀況和邊界案例的代表資料,由熟悉流程的人員標記正確結果。比較 Decision-1、目前使用的規則或生成模型,以及人工判斷。除了整體準確率,也要看各類別的誤判、漏判和無法判定比例;把高風險錯誤單獨列出,不能讓大量容易案例掩蓋少數但代價很高的失誤。
接著改寫問題、調換選項順序、加入常見格式差異,觀察答案是否大幅改變。延遲至少要量中位數與較慢請求的表現,並在接近實際流量時測試。分數校準也要用標註資料檢查:若系統把某些案例標成高信心,這批判斷是否真的大多正確?只有在自己的資料上驗證後,門檻才適合接上自動動作。
成本測算應加入輸入 token(模型處理文字的計量單位)數、呼叫次數、重試、網路延遲、資料清理和人工覆核。Microsoft 在發布時列出每百萬輸入 token 0.042 美元、輸出 token 免費,但實際帳單、部署方式與價格可能隨產品條件變動;Foundry 模型目錄和部署流程顯示的報價才是下單前應核對的資訊。單價低並不代表整體系統成本一定較低。
檢查部署條件、權限、計費與服務可用性
Microsoft Foundry 目前提供 Decision-1,模型目錄列為一般可用(GA),型號版本為 1。官方部署文件列出 Global Standard,以及部分區域可用的 Data Zone Standard。台灣讀者仍應在自己的 Azure 訂用帳戶與專案中確認可部署區域、資料處理位置、配額與延遲;區域能力會變動,全球部署也不保證請求固定在特定地點處理。API 需要 Foundry 專案、可部署模型的權限,以及 Microsoft Entra ID 或 API key 認證。 部署與接入文件
資料送出前,確認請求會包含哪些個人資料、客戶內容或商業機密,並核對 Microsoft 服務條款、資料處理與保留方式、存取權限和網路設定。若系統使用其他供應商轉接服務,也要分別看清楚各方如何處理資料。模型可在 Foundry 取得,不等於任何帳戶、區域和付款條件都能直接使用。
設定不確定結果、錯誤輸入與人工接手流程
在上線前寫清楚低分數、選項以外的回應、逾時、限流和服務故障要怎麼處理。必要時重試,但要設次數上限;重試仍失敗就採安全預設或進人工佇列,並留下可追蹤的輸入版本、模型版本、選項定義和處理結果。這些紀錄可協助查出問題來自資料、提示、類別定義或模型更新。
若用途牽涉醫療、金融、人事、教育、住房或法律權益等重大個人影響,Microsoft 的模型目錄明確表示,不應讓 Decision-1 成為唯一自動決策者。團隊需另行評估適用法規、偏誤、可解釋性和責任歸屬,安排有實質權限的人員覆核;不能因為模型提供機率分數,就推定它已獲得特定產業認證或足以取代專業判斷。這點對健康科技尤其重要,模型分數不能直接變成診斷或照護決定。
“Choose a probability threshold based on your workload, and validate it against labeled examples before you automate a gate.”(依工作負載設定機率門檻,並先用標註案例驗證,再自動化關卡。)— Microsoft Foundry 使用文件,中文翻譯
五、Decision-1 的適用邊界與後續觀察
開放式問答、翻譯、摘要、需要生成解釋,或答案選項尚未定義的任務,不適合由 Decision-1 單獨處理。 對個人權益有重大影響的決策也不能只依模型輸出,應保留具權責的人員判斷和可追溯的覆核程序。
廠商基準測試與實際工作負載的差距
Microsoft 公布的基準涵蓋多種任務,仍不能代表每個組織的語言、輸入品質、業務定義和失誤代價。尤其模型不提供文字理由,日後查錯可能需要回看原始輸入、選項設定和資料分布;若流程要求可稽核的說明,就得由整合端另外建立決策紀錄與人工解釋機制。模型只需分類而且錯誤可逆時,它較容易成為有用元件;若每個判斷都要證明理由,則需比較其他技術或加上人工流程。
觀察模型版本、接入方式與可取得性變化
Decision-1 目前在 Foundry 目錄列為 GA,並透過代管服務提供;Microsoft 表示後續版本可能改用其他基礎模型。這代表企業需要把模型版本、資料處理條款、服務區域和價格納入變更管理,不能假設同一 API 名稱永遠代表同樣效能。每次升版都應重新跑驗收資料,確認分類錯誤、門檻校準和延遲是否仍符合原本要求。
實際評估時,可以先挑一個目前靠規則或生成模型處理的明確判斷步驟,整理代表輸入、候選答案和錯誤成本,再用同一批案例比較 Decision-1、既有方案與人工結果。預先約定準確度、延遲、費用及覆核比例的門檻,達標後以小範圍試用觀察真實例外。系統能否落地,關鍵不只在模型,而在問題定義、資料品質和出錯後由誰接手。
- 選定一個可明確列出答案選項的判斷步驟,整理常見與邊界案例。
- 由流程負責人標註正確答案,並定義漏判、誤判及不確定時的處理方式。
- 用同一批案例比較 Decision-1、現有規則或模型,以及人工結果。
- 設定準確度、延遲、費用和覆核比例門檻,達標後再小範圍試用。
- Decision-1 面向固定選項評分,可做分類、路由、排序、驗證和回答評估,不負責生成解釋或開放式內容。
- 導入前以自有標註資料檢驗品質和錯誤代價,並核對 Foundry 區域、權限、費用與資料條款。
- 低信心、資料不足、服務異常及高影響決策都要有人工覆核或安全退回流程。
常見問題
Q1:Decision-1 是生成式 AI 嗎?
它屬於 AI 模型,但產品設計目標是對固定選項打分並回傳結構化結果,不是生成文章、翻譯、摘要或開放式對話。若工作需要說明理由,可把它和生成模型或人工流程搭配。
Q2:Decision-1 可以本地部署嗎?
目前 Microsoft Foundry 提供的是代管服務。雖然它以開放權重的 Qwen3.5-9B 為基礎,這不代表 Decision-1 的後訓練權重已公開下載;部署前應以官方模型目錄和授權資訊為準。
Q3:Decision-1 的分數可以直接當信心保證嗎?
不可以。機率分數需要用符合實際情境的標註資料檢查校準程度,並測試問題措辭、選項次序和資料分布變化。低分或不確定結果應設計為轉交、重試或人工覆核。
Q4:可以用 Decision-1 自動做醫療或人事決定嗎?
Microsoft 不建議將模型用作信貸、就業、住房、教育、醫療或法律權利等重大個人決策的唯一決定者。應依場景評估法規、公平性與責任,並保留有實質權限的人員覆核。
參考來源
- Microsoft (2026). *Introducing Microsoft-Decision-1, our model for fast decision-making
- Microsoft Learn (2026). *Deploy and use Microsoft-Decision-1 in Microsoft Foundry
- Microsoft Foundry (2026). *Microsoft-Decision-1 | Model Catalog
- Matthias Bastian (2026). *Microsoft's Decision-1 model enters the fast-growing AI decision model race*. The Decoder