很多人第一個會先想到,AI 是否已能設計生物武器。但要評估生物風險,得先問模型在什麼任務上增加了哪些能力,以及能力能否轉化成可觀察的風險。回答生物知識題、協助整理資料,和讓缺乏經驗的人跨過實務門檻,是不同層次的證據。
生物風險也受使用者、資源、工作場所管理和供應鏈檢查影響。單看排行榜分數或最壞情境,都不足以支持決策。評估應把能力、情境、資源與防護放在一起,說清楚證據和待驗證之處。
一、AI 生物風險評估,先定義要判斷的問題
先界定特定模型在特定使用情境中可能增加的能力,再判斷這種增量是否改變既有風險。模型答對生物學問題,只能說明它在該題型有表現,不能直接證明它能在現實世界造成危害。
同樣稱作「生物能力」,可能分別指知識回答、文獻整理、提升專業人員效率,或協助新手完成更多任務,涉及知識、研究輔助、專家增益與新手增益。評估若未區分目標,分數就很難連到管理措施。
還要把任務的範圍寫清楚:評估的是純文字對話、能讀取資料的 AI 助理,還是能呼叫外部工具的代理系統?模型是否有網路、檔案或其他服務的存取權?測試時的使用者是否具備領域知識?這些條件一變,模型能做的事也可能改變。若把文字問答的結果外推到能串接工具的系統,結論便超過了測試實際支持的範圍。
情境要涵蓋預期用途與可能的誤用路徑。研究團隊整理公開文獻,和未受管控者透過多種工具服務執行任務,涉及的接觸者、資源與監督都不同。評估文件應列出使用者、系統可接觸的資訊與工具、任務目的、監督、可能傷害及現有防護,才能討論具體風險。
二、哪些證據能說明模型增加了多少能力?
基準測試、專家判讀與情境測試要彼此補充;單一測驗分數不足以推估實際風險。測試問題、模型版本、使用者條件和評分方式都應公開交代,才知道結果可以支持到哪裡。
基準測試(benchmark,固定題目與評分方式的能力測驗)適合用來比較模型在限定題目上的表現,例如檢視它是否理解某類知識或能否處理特定推理題。它的優點是容易重複,也方便觀察不同版本的變化;但題庫可能被訓練資料涵蓋,選擇題表現也不等於完整工作能力。測驗答對率不能直接轉換成事件機率,更不能視為實驗室或現場結果。
專家判讀能檢查答案正確性、關鍵限制,以及是否幫助專業使用者找到可靠資訊。判讀仍受專家背景、題目措辭和評分規則影響,因此應保留評分準則、評審間一致程度與分歧。只呈現平均分數,難以看出答案在哪些條件下失準。
情境測試則把模型放進模擬任務,觀察使用者在有無模型協助時的表現差異。關鍵指標應是「人和模型組成的系統」是否改善了某個結果,而非只看模型能否獨立回答問題。比較組、任務設計、參與者條件與安全限制都會影響結果;在受控環境中看到的能力增量,仍不能直接代表開放環境中的普遍效果。
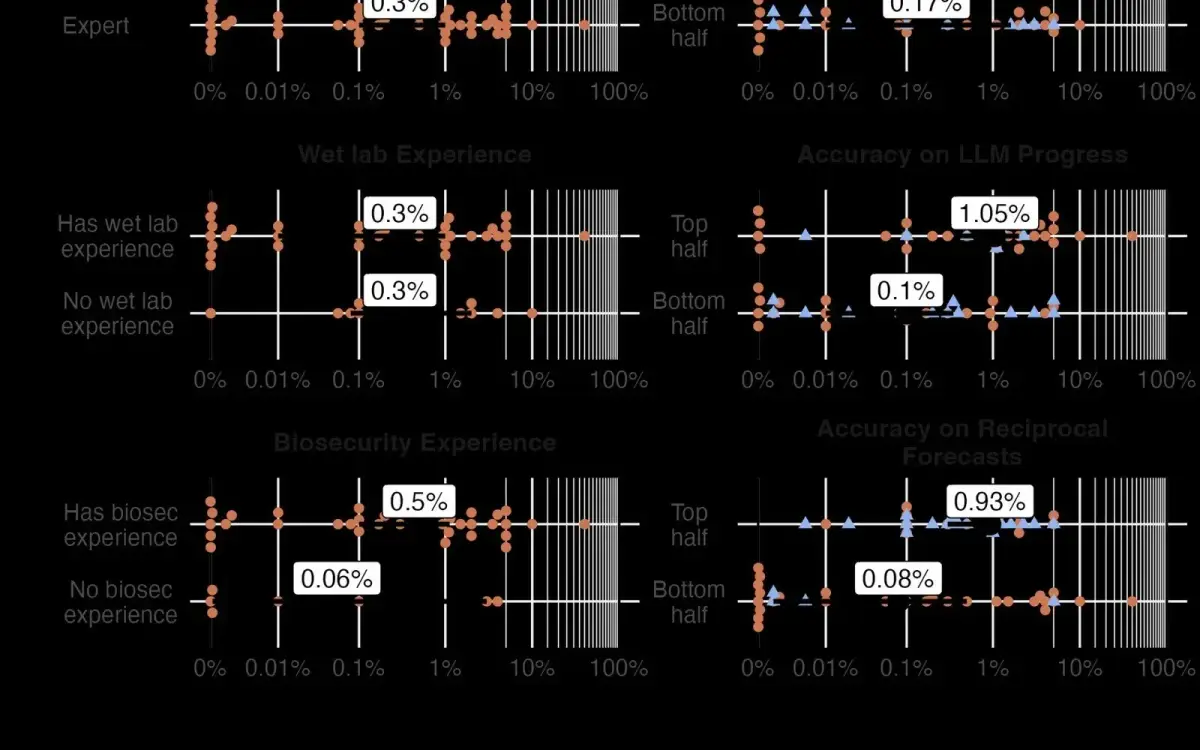
Forecasting Research Institute 彙整生物安全、生物學專家與預測者,詢問他們在不同能力和防護假設下如何調整風險判斷。這是條件式預測,並非事件統計機率。研究也指出受訪者估計差異很大,罕見事件受多重因素影響,不能靠一次問卷定論。這類研究可指出值得檢驗的能力證據與防護假設。
「公開測試結果仍需放回其設計條件與使用脈絡理解。」(依 Forecasting Research Institute 對評估與預測限制的討論意譯)
測試結果還應標示模型版本、工具權限、日期、樣本規模、失敗案例及重複測試情況。模型更新或增加工具後,舊測試不一定仍適用。版本紀錄有助追查差異,避免把前版結果套用到新系統。
三、模型能力之外,工具、資源和使用者也會改變風險
需同步檢視使用者能力、工具與資源是否可取得,以及整體流程是否受專業、組織和安全條件限制。模型提供資訊,不表示使用者已具備完成任務所需的其餘條件。
談「可取得性」時,重點是盤點某項能力能否接觸到必要的資料、服務、設備、專業支援與受監督環境,不是列出取得或使用的方法。這些條件有些容易查證,有些則因地區、機構和法律環境而異。組織可以用高層次的資源盤點確認風險假設,例如哪些資源由合格機構管理、哪些服務有身分審查或合約責任、有哪些環節需要受訓人員監督。
RAND 於 2026 年發布的初步評估,測試了七個大型語言模型代理與生物工具的初步互動能力。報告認為,測試結果顯示代理具備初步互動能力,可能降低部分使用者接觸相關工具的專業門檻,並建議進一步針對設計能力測試。這項研究呈現的是特定系統和測試範圍中的觀察,不能概括成所有模型都能完成整套研究流程,也不能據此推斷事件必然發生。它提示評估者要注意系統從回答走向工具操作時,能力邊界可能如何變化。
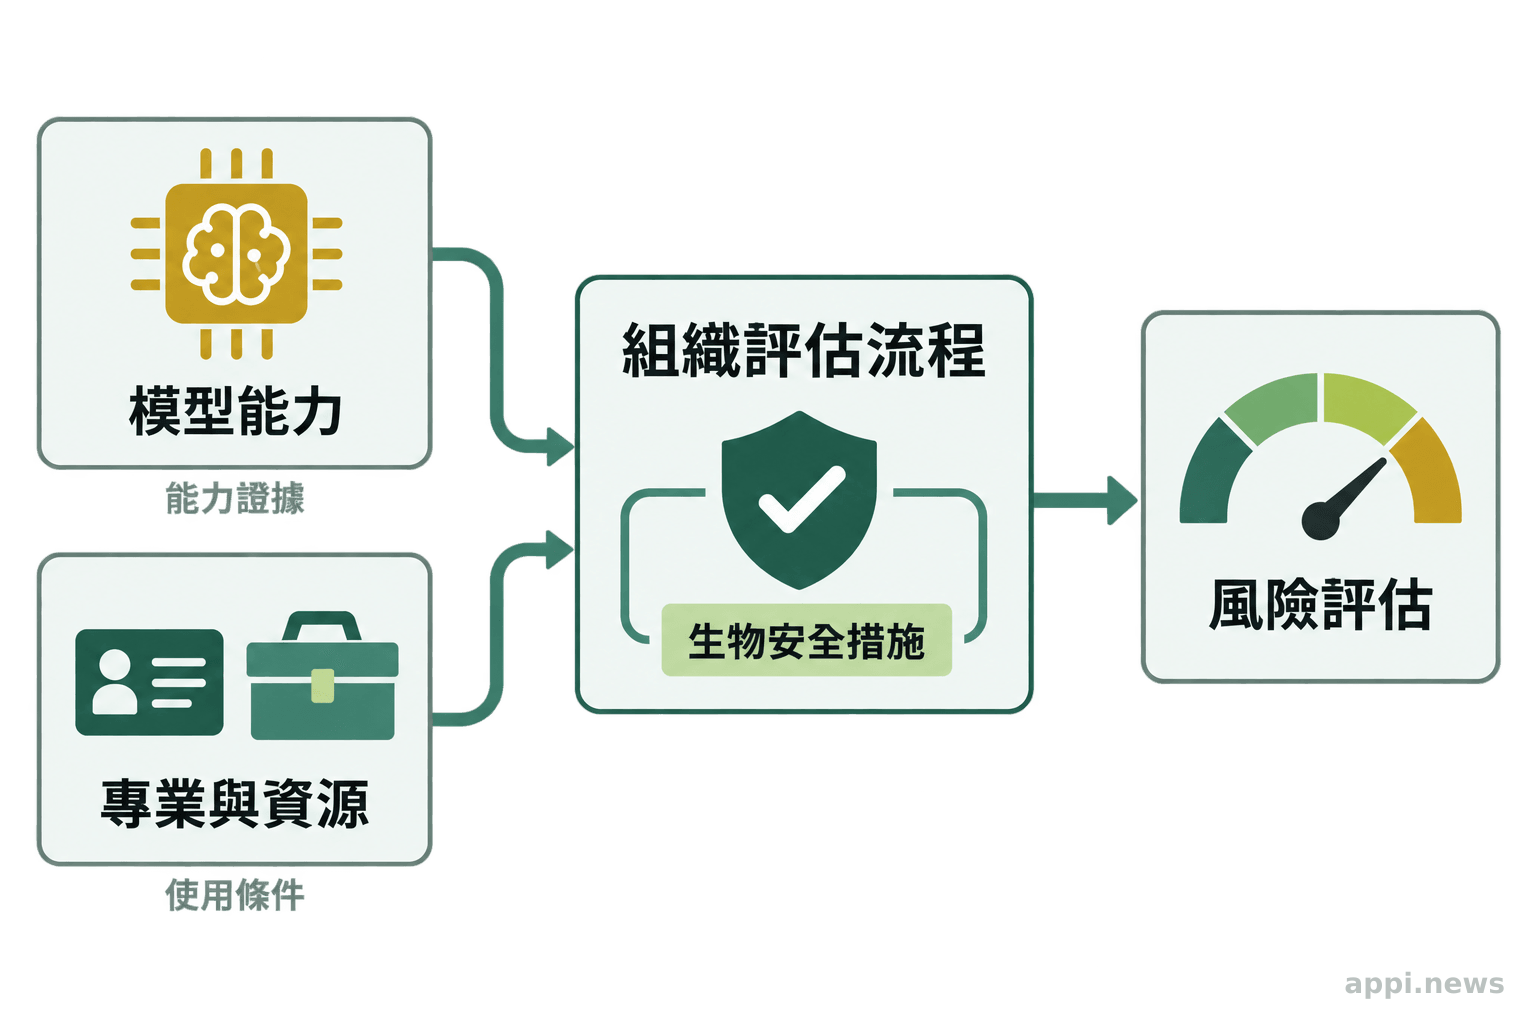
使用者條件不只分「專家」與「新手」。知識、訓練、機構、任務監督和安全文化都影響模型輸出的解讀。研究人員可能用模型整理文獻,管理者則關心權限與責任;同一系統對兩者的風險和效益不同。若主張模型降低門檻,測試須交代門檻定義、比較對象和成功條件。
還要檢查端到端流程:模型輸出是否進入其他軟體、由誰審閱、錯誤如何發現、出了問題由誰停止。多個系統和人員依序接手時,責任空隙可能讓錯誤延續。評估須確認每個環節的負責人、資訊交接方式和升級管道。
四、防護措施要納入同一情境,並檢查彼此的缺口
把存取管理、模型安全測試、監測、事件應變和供應鏈防護放進同一使用情境,檢查它們能降低哪些風險、留下哪些缺口。任何單一措施都不能被當作保證安全的依據。
模型端措施包括使用規則、權限管理、敏感任務測試、濫用監測、漏洞回報和事件應變。這些措施的效果取決於模型如何部署、系統是否連接外部工具、更新是否及時,以及使用者能否轉往其他服務。封閉式服務較能掌握帳號與異常使用狀況;開放權重模型則可能由組織自行控制,也可能無法仰賴原開發者持續監測。評估需按部署方式判斷,而不是把某種發布形式直接等同於安全或危險。
供應鏈端防護可檢視合成核酸供應商如何辨識客戶、處理訂單風險、升級可疑情況,並確認制度與實際作業是否一致。這是系統外的另一道控制,但它只涵蓋特定流程,無法取代模型端風險管理、實驗室生物安全和公共衛生監測。不同國家、供應商與研究機構的規範也不相同,跨境使用時更應確認責任落在哪個組織。
NIST 收錄於《Nature Biotechnology》的短文主張在生成式 AI 工具中內建生物安全防護,並將浮水印、模型對齊、抗越獄和移除特定能力等方向,視為可與治理政策互補的技術。這是研究與政策方向,不能視為已能防住所有規避手法。組織仍需確認防護經過哪些版本和情境測試,以及失效時由誰通報、修補。
「內建的 AI 原生防護可與治理政策互補。」(Wang 等人於《Nature Biotechnology》短文的意譯)
防護要看覆蓋範圍。若拒答後仍可透過其他入口取得相似服務,存取控制可能只移轉使用路徑;若告警無人接手,偵測也不等於降低風險。評估應列出責任人、通知管道、處置權限、恢復方式與檢查安排。
五、與既有生物威脅相比,才能辨識 AI 帶來的增量
與既有病原體威脅及現行生物安全措施比較,才能辨認 AI 是否增加了新的能力、擴大了可接觸人群,或只是改變原有流程中的一個環節。沒有相對基準,風險判斷容易被極端情境主導。
基準可從組織既有的安全評估和事件管理開始:哪些風險源、工作、供應或設施已有訓練、審核、監督與規範?加入 AI 後,哪個環節變快、更容易接觸或更難監督?要將變化歸因於 AI,需有比較證據,不能僅因加入新技術就推定風險上升。
經合組織(OECD)2025 年評估指出,合成生物學與 AI、機器人結合,帶來生物安全、資料供應鏈和人類監督等治理議題;報告建議進一步分析不確定性並持續監測技術發展。此框架將效益與風險放在同一脈絡檢視,組織也需留意安全研究和防禦用途受到的影響。
公開資料目前多以基準題、專家判斷或假設情境作為代理指標,不能直接推估真實使用中的能力增量或事件機率。結果也會受到模型版本、測試設計、使用者條件、資源可取得性和防護措施影響。不同研究測量的對象和方法並不相同;某研究中一項能力通過測試,不表示所有場景都具有同一種風險,也不表示其他研究的結果可以直接合併成單一數值。
因此,組織的風險紀錄應保留不確定性,而不是硬填一個看似精確的總分。可標明每項判斷的證據來源、適用情境、信心水準、未驗證假設和下次複核條件。當模型或政策改變、出現新的測試結果、工具權限擴大,或事件應變演練發現缺口時,再更新原有判斷。這比把一次評估當作永久結論更能反映技術和使用方式的變動。
六、台灣組織可採用的 AI 生物風險檢視步驟
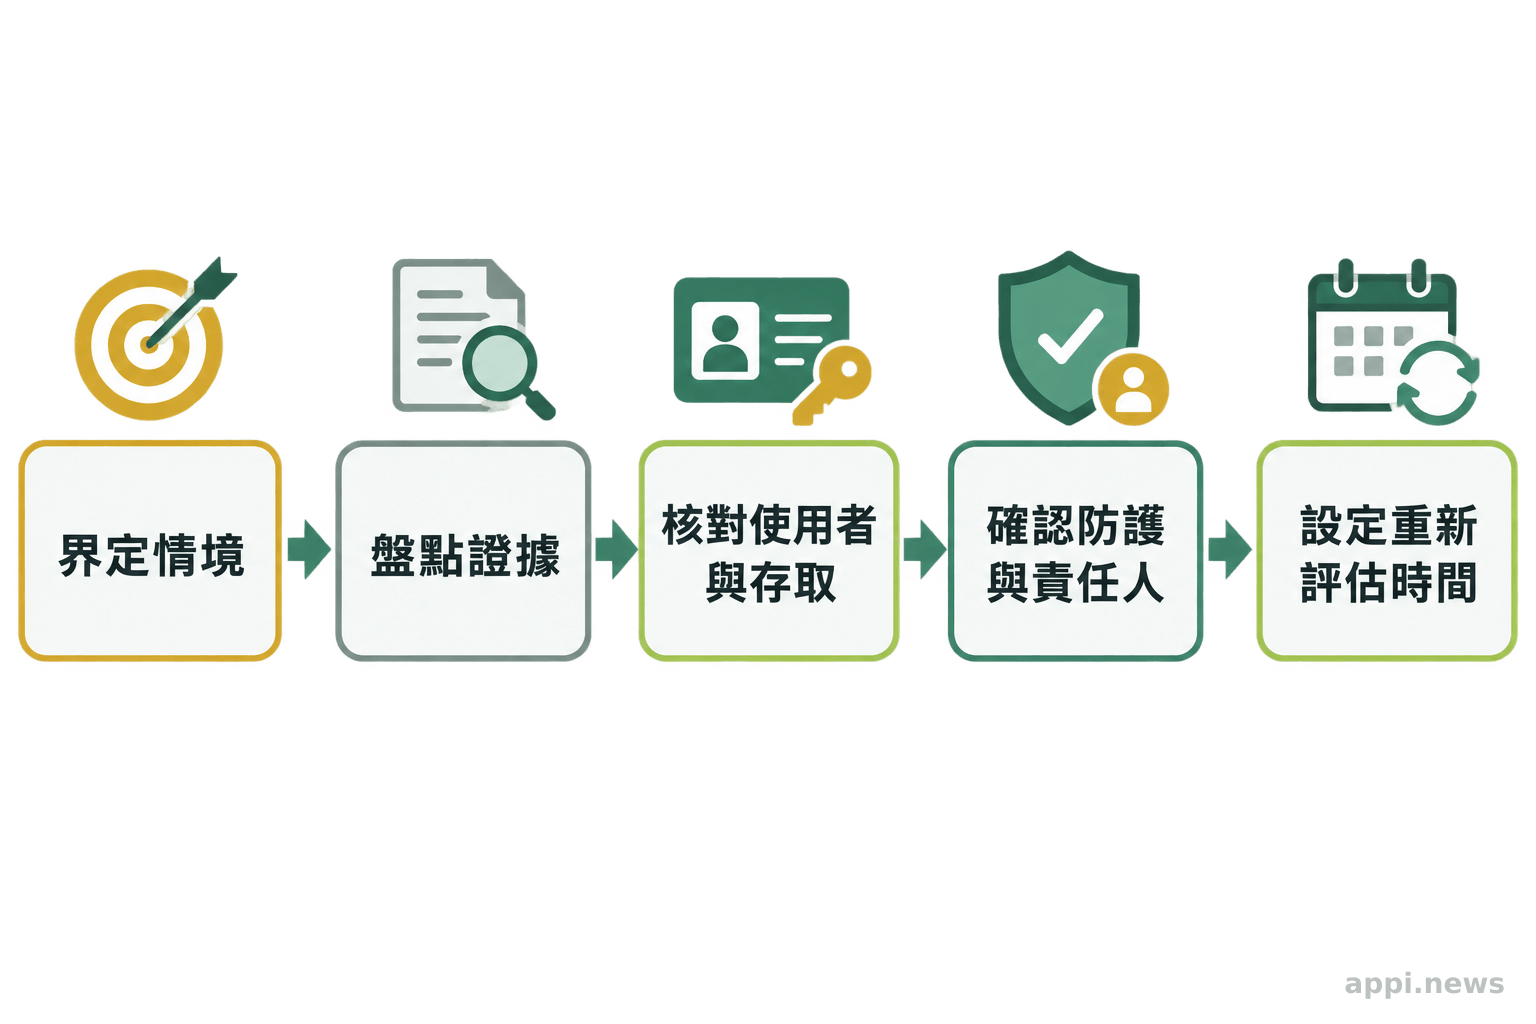
從一個實際使用情境開始,依序記錄模型能力證據、使用者與資源條件、防護責任及待驗證假設,再由相關責任人共同檢視。這份紀錄可用來決定要補測什麼、調整哪些權限,以及何時重新評估。
- 界定情境:記錄模型版本、使用者、任務目的、可連接的資料和工具、監督方式及禁止用途。
- 盤點證據:整理基準測試、專家判讀與情境測試,標示日期、比較組、限制和未驗證假設。
- 核對條件:盤點使用者專業、組織流程、資源管理和外部服務責任,不把測試分數當作現場效果。
- 檢查防護:確認存取、監測、供應端檢查、通報與應變的負責人,並記錄防護缺口。
- 設定複核點:指定會觸發重評的版本變更、能力證據或演練結果,保存判斷依據。
這項工作需要資訊安全、生物安全、研究管理和治理人員共同參與。資訊安全負責人檢視帳號、工具與事件處理;生物安全人員掌握工作場所和研究監督;研究管理者說明正當用途與專業流程。共同核對可避免只從模型表現或制度文件下結論。
AI 生物安全風險評估要回答的,不只是模型能否產生某種答案,還包括它對誰增加了什麼能力、這種增量會經過哪些條件才影響現場,以及現有防護能否及時發現和處理問題。研究測試可以提供重要線索,卻不能單獨代替情境判斷。組織可先選一個實際使用情境,把能力證據、工具與資源的可取得條件、防護措施和待驗證假設寫進同一份紀錄,再由資訊安全、生物安全與治理責任人共同檢視。
- 基準測試說明的是特定題目上的模型表現,不直接代表事件機率或現場能力。
- 風險取決於模型、使用者、資源條件、流程和防護措施,需要放在同一情境判斷。
- 公開研究與框架可協助提出問題,仍須交代方法限制、適用範圍和不確定性。
常見問題
Q1: AI 生物風險能用一個分數判斷嗎?
目前沒有可單獨適用於所有模型、用途與組織的通用分數。評估應呈現測試情境、能力證據、防護條件和不確定性,避免讓總分掩蓋不同風險來源。
Q2: 模型在生物學測驗表現很好,就代表風險升高嗎?
測驗結果只能支持模型在該題型和條件下的表現。要判斷是否增加實際風險,還需檢視使用者增益、可取得資源、完整工作流程與防護措施。
Q3: 哪些變化應觸發重新評估?
模型版本更新、增加外部工具或資料權限、使用者範圍改變、出現新的能力測試結果,或安全演練發現處置缺口,都可列為組織設定的複核條件。
參考來源
- Lee J, et al. (2026). *Can LLM Agents Select and Engage with Biological Tools? An Initial Biosecurity Assessment*. RAND Corporation
- Williams B, et al. (2025, revised 2026). *Forecasting LLM-enabled Biorisk and the Efficacy of Safeguards*. Forecasting Research Institute
- Webster T, et al. (2025). *Global Risk Index for AI-enabled Biological Tools | CLTR*. Centre for Long-Term Resilience and RAND Europe
- Wang M, et al. (2025). A call for built-in biosecurity safeguards for generative AI tools. *Nature Biotechnology*, 43(6), 845–847
- Robinson DKR, Nadal D, Hagimoto S. (2025). *Synthetic Biology, AI and Automation: A Forward-Looking Technology Assessment*. OECD